
ITシステムの監視対応は、導入すれば安心とは限りません。監視を入れたのに障害を防げなかった、委託したのに肝心なときに動いてもらえなかった、という失敗は後を絶ちません。
失敗は、監視の仕組みや契約の条件、見積もりの中身、発注側の役割に潜んでいます。この記事は、そうした失敗・課題・注意点・リスクに絞り、発注企業の視点から掘り下げる失敗特化の内容です。全体像は、ITシステム監視対応の完全ガイドで先に確認できます。
▼全体ガイドの記事
・ITシステム監視対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
クラウド監視のブラックボックス化リスク
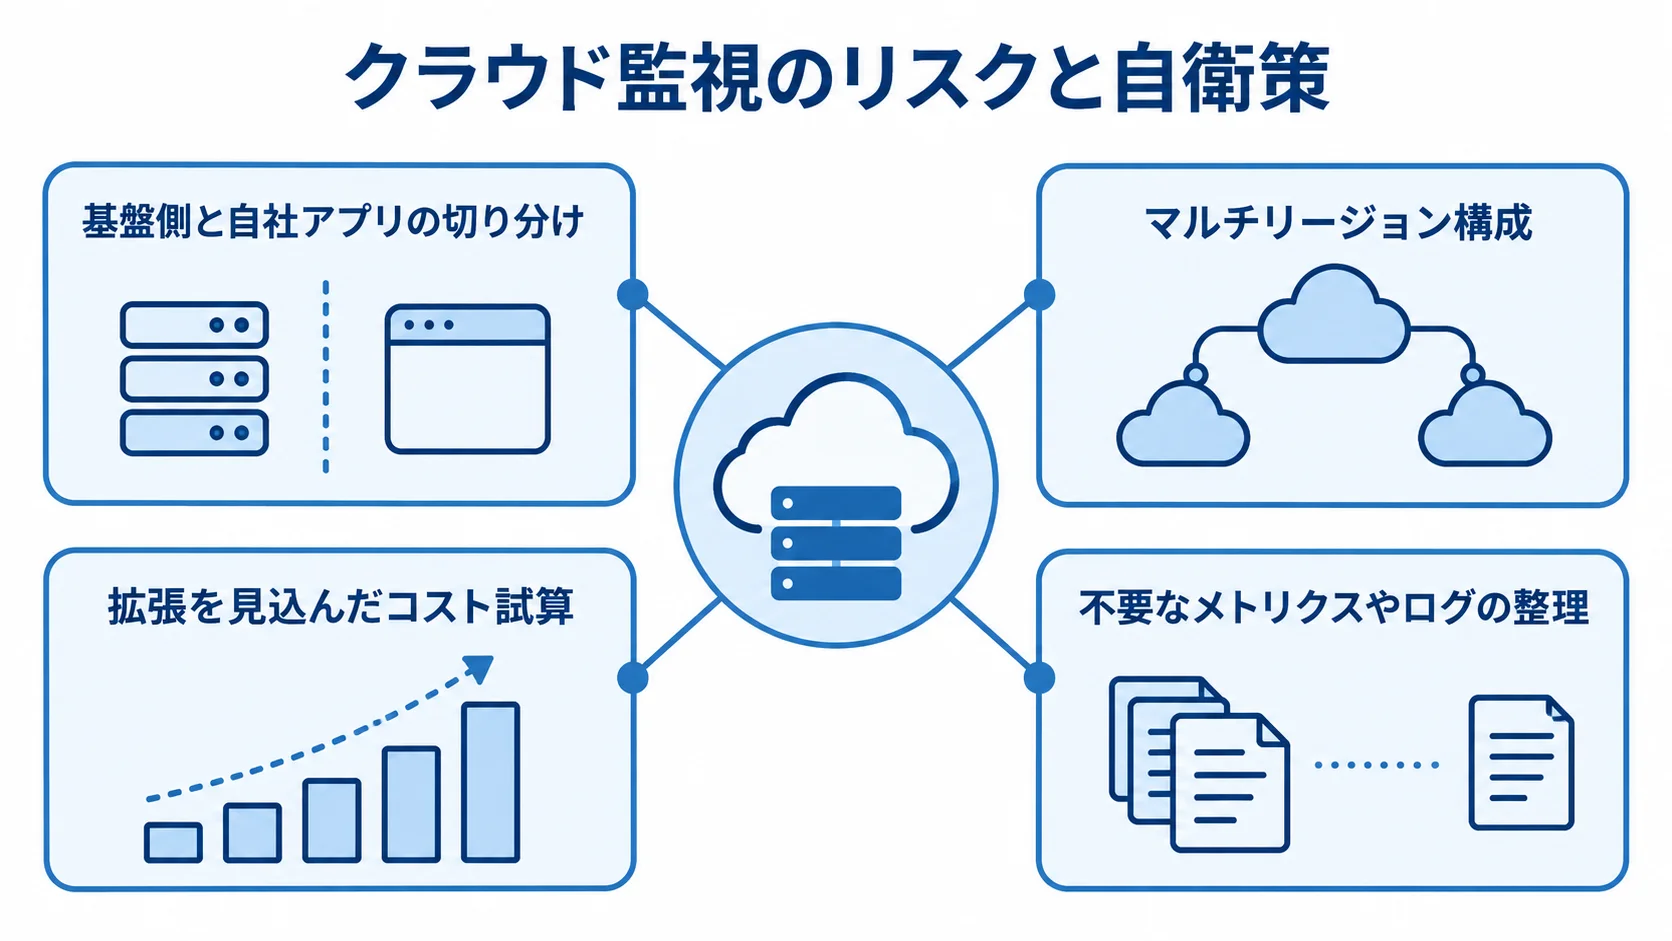
クラウド化が進んだ今、見落とされやすい失敗が、監視の「ブラックボックス化」です。国内エンタープライズ・システム市場のクラウド比率は2022年で約5割(IDC Japan)に達していますが、クラウド基盤の内部は利用者からは見えず、障害が起きても手出しができません。
そのため、基盤側の障害なのか自社アプリの問題なのかを切り分けられず、復旧をただ待つしかない状況になります。この無力感こそが、クラウド時代特有のリスクです。
基盤障害でユーザーが手出しできない課題
クラウド基盤の障害は、利用者側ではどうにもできません。クラウド事業者のデータセンターやネットワークで障害が起きると、その上で動くすべてのシステムが影響を受けるため、利用者にできるのは事業者の復旧を待つことだけです。
さらに、こうした基盤障害で事業に大きな損失が出ても、補償はサービスクレジット(利用料の一部返金)にとどまり、それ以上の損害は補填されないのが一般的です。たとえば、ダウンタイムで1,200万円の機会損失が出ても、戻ってくるのは利用料の一部だけという現実があります。
この課題への自衛策は、アーキテクチャ設計にあります。重要なシステムを複数のリージョン(地理的に離れたデータセンター)に分ける、マルチリージョン構成にしておけば、一つの基盤が落ちても別の基盤で稼働を続けられます。
ただし、これには相応のコストと設計の複雑さが伴うため、すべてのシステムに適用するのは現実的ではありません。事業影響度の高いシステムに絞って冗長化し、それ以外は基盤障害のリスクを受け入れる、というメリハリの判断が求められます。基盤障害そのものは防げなくても、影響を局所化する設計はできます。
- 切り分けの準備:基盤側か自社アプリかを見分けるための監視の仕組み
- 補償の把握:サービスクレジットで戻る額と、想定される損失との差
クラウド監視の隠れコストと自衛策
クラウド監視のもう一つの落とし穴が、隠れコストです。クラウド型の監視ツールは従量課金が多く、監視対象やデータ量が増えると、費用が想定以上に膨らみます。「最初は安かったのに、システムが拡張したら監視費が跳ね上がった」という失敗は、珍しくありません。
また、ログの保存期間やデータ転送量に応じた追加課金もあるため、契約時の見積もりと実際の請求が乖離することがあります。自衛策は、契約時に将来の拡張を見込んだコスト試算をしておくことです。
監視対象が倍になったら費用はいくらになるか、ログ保存を延ばすといくら増えるかを、あらかじめ確認しておけば、想定外の請求を防げます。加えて、本当に監視が必要な対象に絞り込み、不要なメトリクスやログを外すことで、従量コストを小さくできます。二つの自衛策が、ブラックボックス化による影響を最小限に留める備えになります。
- 料金体系:従量単価と、ログ保存やデータ転送に伴う追加料金の条件
- 不要な監視の整理:使っていないメトリクスやログを定期的に洗い出して外すこと
過剰・過少なSLAという両面の失敗
SLA(サービス品質保証)の設定ミスは、両方向の失敗を生みます。高すぎれば過剰なコストに、低すぎれば障害時の損失につながります。どちらも避けたい失敗ですが、適正な水準を見極められず、どちらかに振れてしまう企業は少なくありません。
SLAの失敗は、契約時には気づきにくく、コスト明細を見たときや障害が起きたときに初めて表面化します。だからこそ、両面のリスクを理解しておくことが、適正なSLA設計への第一歩です。
過剰SLAでコストを浪費する失敗
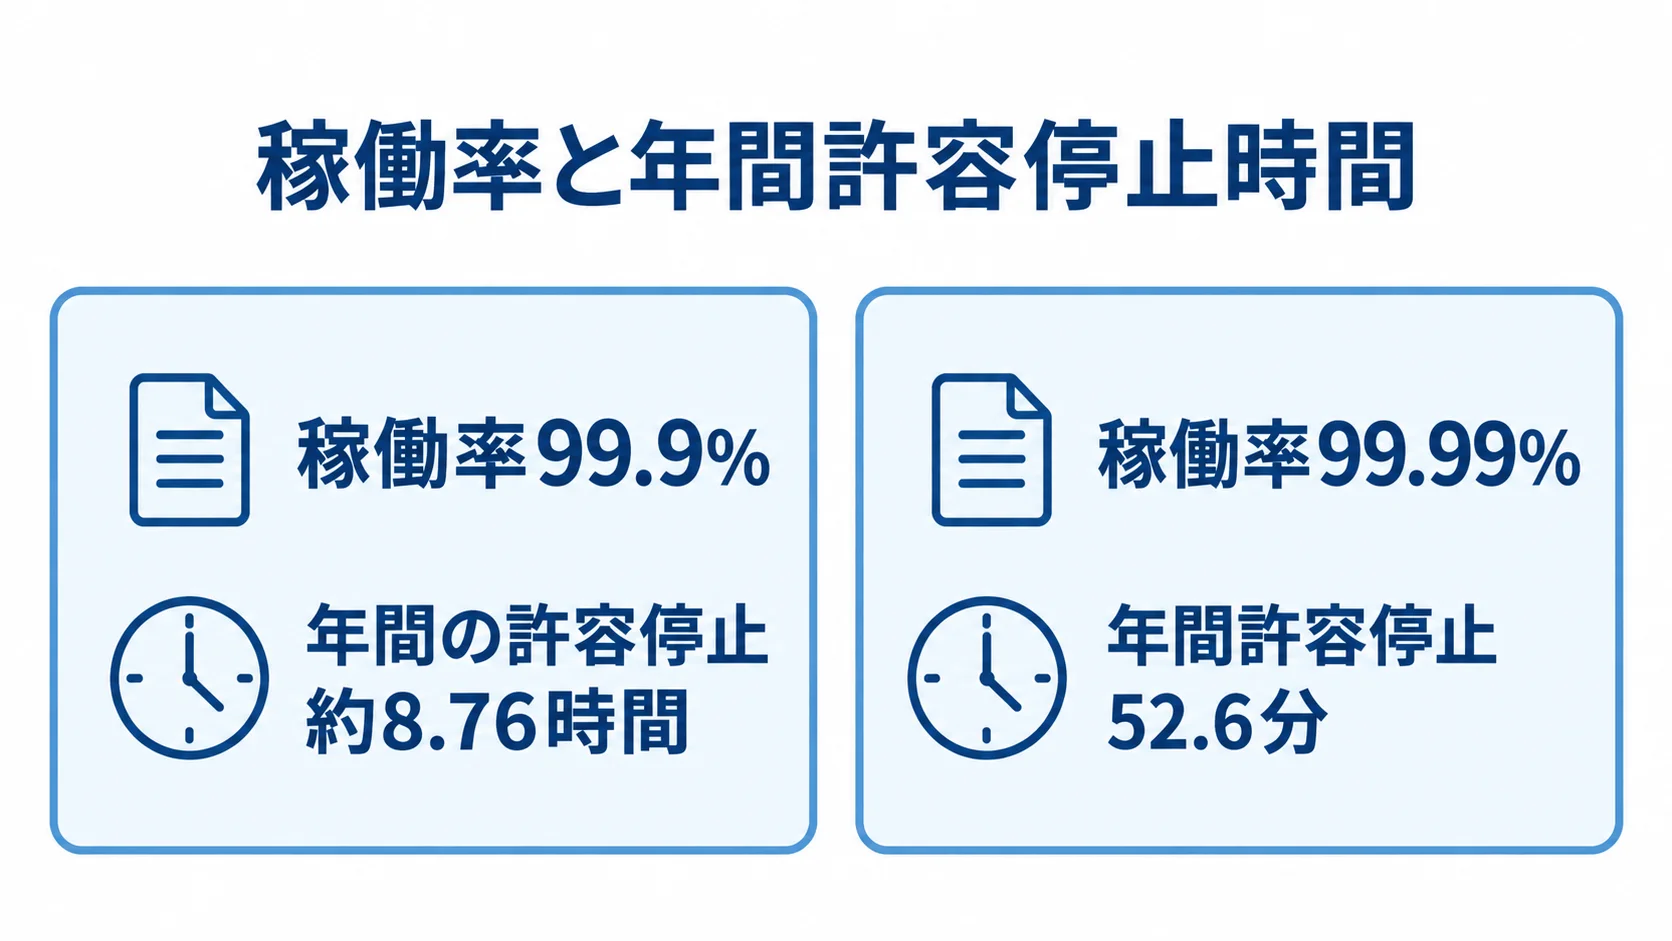
過剰SLAの失敗は、必要以上に高い稼働率や速い復旧を求めて、コストを浪費するパターンです。一次データでは、稼働率99.9%なら年間の許容停止は約8.76時間ですが、99.99%にすると年間52.6分まで厳しくなり、運用コストが段階的に跳ね上がります。
たとえば、社内の情報共有ツールに99.99%を求めるような過剰な設定は、得られる効果に対してコストが見合いません。「念のため高く」という発想が、無駄な出費を生みます。
厄介なのは、過剰なSLAを社内で下げる調整が難しいことです。業務部門が「絶対に止めるな」と要求し、情報システム部門がそのまま受け入れると、過剰な水準で固まってしまいます。
これを是正するには、事業影響度アセスメントで「数分の停止が本当にいくらの損失になるか」を示し、コストとのバランスを業務部門と合意する必要があります。逆に、この社内調整を踏まずにSLAを決めると、過剰なまま固定化され、毎年無駄なコストを払い続けることになります。
- 稼働率の目標:停止が許される時間と、その時間の損失額を並べたうえでの判断
- 復旧時間の水準:速い復旧が本当に必要な範囲を、業務部門と絞り込んだ結果
過少SLAで障害損失を被る失敗
逆方向の失敗が、過少SLAです。コストを惜しんでSLAを低く設定した結果、重要なシステムが長時間止まり、大きな損失を被るパターンです。
一次データでは、金融・医療・EC系のダウンタイムで5分以上止まると、1回あたり平均1,200万円の機会損失が出ています。また、Gartnerの試算では、1分あたり5,600米ドルとされています。これに対し、SLAを低く抑えて節約できる額はわずかで、一度の重大障害で節約分を遥かに上回る損失が出ることがあります。
過少SLAの怖さは、平時には問題が表面化しないことです。障害が起きない間は「安く済んでいる」と見えますが、いざ重大障害が起きると、復旧の遅さから取り返しのつかない損失を被ります。
判断の基準は、システムの事業影響度に応じてSLAを設定することです。損失が大きいシステムには相応のSLAを、小さいシステムには現実的な水準を割り当てます。損失額とコストの均衡点を選ぶことが、過剰にも過少にも偏らないための基本です。
- 損失の見積もり:停止時の損失を金額で示し、業務部門と共有した数字
- 節約額との比較:SLAを下げて浮く費用と、重大障害時の損失を並べた比較
安すぎる見積もりに潜む罠
監視対応の委託で、もっともわかりやすい失敗が「安さに飛びついた」結果のトラブルです。複数社から見積もりを取ると、極端に安い提案が混ざることがあります。
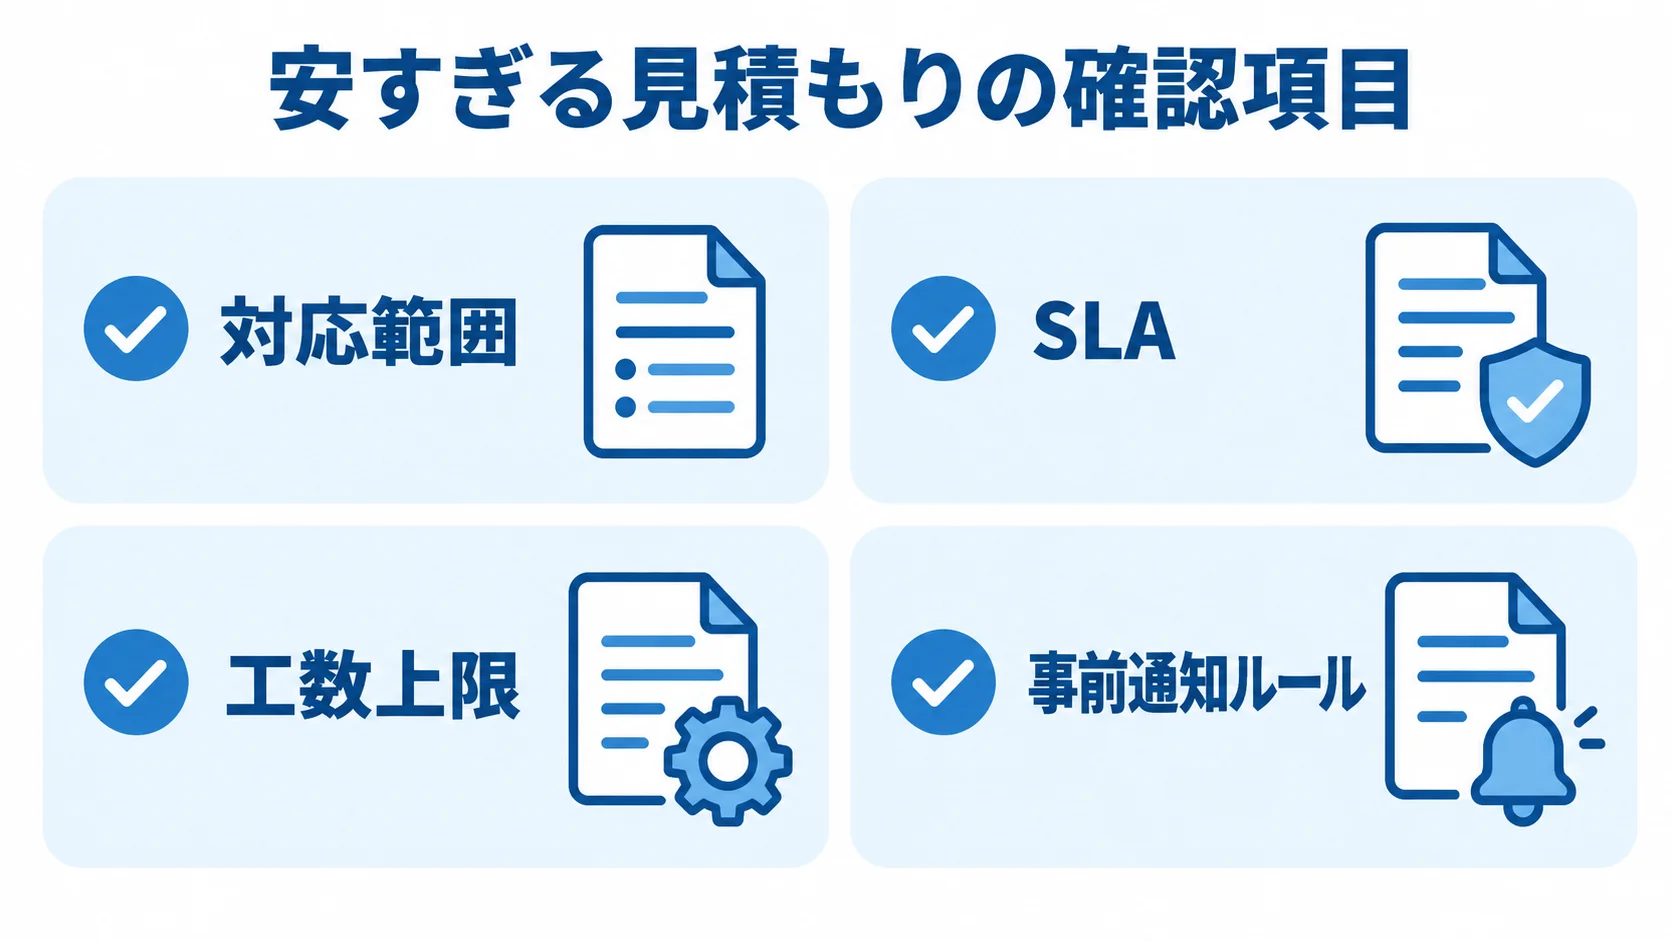
一見お得に見えても、安さには理由があります。対応範囲が狭い、SLAがない、工数上限が低いといった「削られた部分」が、契約後に痛い形で表面化します。だからこそ、見積もりは総額の安さではなく、中身の妥当性で評価すべきです。
対応範囲とSLA欠如という安さの正体
安すぎる見積もりの正体は、多くの場合、対応範囲の狭さとSLAの欠如です。一次データでは、運用・監視は月5万〜20万円、24時間緊急対応は月10万〜20万円が相場ですが、これを下回る見積もりは、監視だけで対応は含まず、営業時間内のみに限られている場合があります。
また、SLAがないといった条件が隠れていることがあります。契約後に障害が起きて初めて「それは対応範囲外です」と言われ、スポット費用や別契約が必要になるため、総額では高くつきます。この罠を避けるには、見積もりを金額だけで比べず、対応範囲・SLA・工数上限をそろえて比較することが不可欠です。
前述のRFP・要件定義書で対応範囲を明確に定義しておけば、各社が同じ前提で見積もるため、不当に安い提案の「削られた部分」が浮かび上がります。見積もりが安い場合は、「なぜ安いのか」「何が含まれていないのか」を必ず問い、答えに納得できなければ避けるのが賢明です。安さの裏にあるリスクを見抜く目が、失敗を防ぎます。
- 見積もりの条件:SLAの有無、対応時間帯、監視のみか対応も含むか
- 削られた部分:契約後に別料金となる範囲を、見積もりの段階で書面にした内容
工数上限超過で膨らむ追加費用の罠
もう一つの隠れた罠が、工数上限の超過です。月額固定型の契約には「月◯時間まで」という上限があることが多く、安い見積もりほど、この上限が低く設定されがちです。
障害が多発した月に上限を超えると、超過分が高い単価で追加請求され、結果として高額になります。一次データの人月単価60万〜150万円という水準を踏まえると、超過時の単価は決して安くなく、想定外の出費になります。
この罠を避けるには、契約前に月の工数上限と超過時の単価、上限に近づいた際の事前通知ルールを確認しておくことです。上限が低い見積もりは、平常時こそ安く見えても、障害が増えた途端にコストが跳ね上がります。
安さに飛びつく前に、総額ではなく中身で判断する姿勢を持つことが、この失敗を防ぎます。そのうえで、自社の障害発生の傾向に対して上限が現実的かを見極めることが大切です。安すぎる見積もりの罠は、対応範囲とSLAの欠如、そして工数上限の低さに集約されます。
- 上限時間:障害が増えた月にも足りるかどうかを、過去の障害発生の状況と照らした数字
- 事前通知の取り決め:上限に近づいた段階で知らせてもらう条件
発注者の初動失敗とベンダー丸投げの危うさ
監視を委託しても、発注者である情報システム部門の責任がゼロになるわけではありません。むしろ、重大障害時の経営層・業務部門への報告や、BCP(事業継続計画)と連動した初動は、ベンダーには代われない発注者の仕事です。
ここを「全部ベンダーがやってくれる」と勘違いして丸投げすると、いざというとき社内が混乱します。対応そのものは進んでいても会社が機能不全に陥る、という失敗が起きます。
報告遅延とBCP不在による初動失敗
発注者側の典型的な失敗が、報告遅延です。障害が起きたとき、ベンダーが技術的な対応を進めていても、経営層や業務部門、そして顧客への状況報告が遅れると、社内外で不信と混乱が広がります。特に「システムが止まっているのに、何が起きているか分からない」という状態は、技術的な障害以上に組織を疲弊させます。
誰に、いつまでに、何を報告するかをあらかじめ決めていないと、現場は報告まで手が回らず、報告が後手に回ります。もう一つの失敗が、BCPの不在です。基幹システムが長時間止まったとき、手作業による代替運用へ切り替える基準や、顧客への告知文の雛形が用意されていないと、復旧を待つ間に事業が完全に止まります。
IBMの2024年の調査では、データ漏洩の検知まで平均204日、平均被害額は445万米ドルとされ、初動の遅れが被害を拡大させることが示されています。そのため、発注者側がエスカレーションルートとBCP連動の初動を設計しておけば、障害を「混乱」ではなく「想定内の対応」として進められます。
- 報告先と期限:経営層、業務部門、顧客それぞれに、伝える内容と期限の取り決め
- 代替運用への切り替え:手作業に移る基準と、顧客向けの告知文の雛形
ベンダー丸投げとロックインのリスク
監視・運用をベンダーに完全に丸投げすると、ロックイン(特定ベンダーへの依存)のリスクが高まります。自社にシステムや運用の知識が残らず、監視設定やドキュメントもベンダーが抱え込んだ状態になると、別のベンダーへ切り替えたくても身動きが取れません。
費用が高くても品質に不満があっても変えられない、この依存状態が、長期的に大きなコストとリスクになります。このリスクを避けるには、委託は「丸投げ」ではなく「協働」と位置づけ、運用知識を自社にも残すことです。
具体的には、契約の段階で切り替えに必要な条件を決めておけば、いざというときに別のベンダーへ移りやすくなります。riplaはフルスクラッチ受託と国内運用保守の立場から、ブラックボックス化を避け、発注者と知識を共有しながら伴走する運用を重視しています。
丸投げの危うさを理解して協働の関係を築くことが、監視対応での大きな失敗を防ぎます。
- 運用ドキュメント:監視設定とあわせて、自社の担当者も読める形で受け取る
- 契約時の取り決め:解約予告期間、引き継ぎ手順、アカウントやソースコードの引き渡し条件
まとめ
ITシステム監視対応の失敗は、いくつかの典型パターンに集約されます。クラウド基盤の障害は冗長化で影響を局所化し、SLAは事業影響度に見合った水準で、過剰も過少も避けます。見積もりは総額ではなく、対応範囲・SLA・工数上限の中身で評価します。
1,200万円/回・5,600米ドル/分といった損失の統計が、リスクの大きさを物語っています。また、発注者はエスカレーションとBCP連動の初動を自ら設計します。これらが、失敗を避けるための実践的な対策です。
失敗から学ぶときは、「ベンダーが悪い」で片付けず、「発注者側で何を設計し、何を残すべきだったか」を考えることが大切です。監視は丸投げではなく協働であり、発注者の初動設計と知識の保持が、失敗を食い止める備えになります。riplaはフルスクラッチ受託と国内運用保守を組み合わせ、ブラックボックス化を避けて、発注者と知識を共有しながら障害に強い体制を築く支援を一貫して行っています。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。