
ITシステム障害対応の事例は、ダウンタイムの削減、夜間体制の立て直し、監視と一次対応の委託、発注者側の初動に分けると読みやすくなります。この記事は、導入事例、開発事例、活用事例、成功事例を、発注者である情報システム部門の視点から掘り下げる、事例特化の解説です。
障害対応は、起きてから慌てて動く「火消し」になりがちで、平常時には費用対効果が見えにくい領域です。だからこそ、自社に近い規模や体制の事例は、どこまでを社内で担い、どこから外部に任せるかという投資判断の精度を高めてくれます。全体像はITシステム障害対応の完全ガイドから確認できます。
▼全体ガイドの記事
・ITシステム障害対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ダウンタイムをBefore/Afterで削減した事例
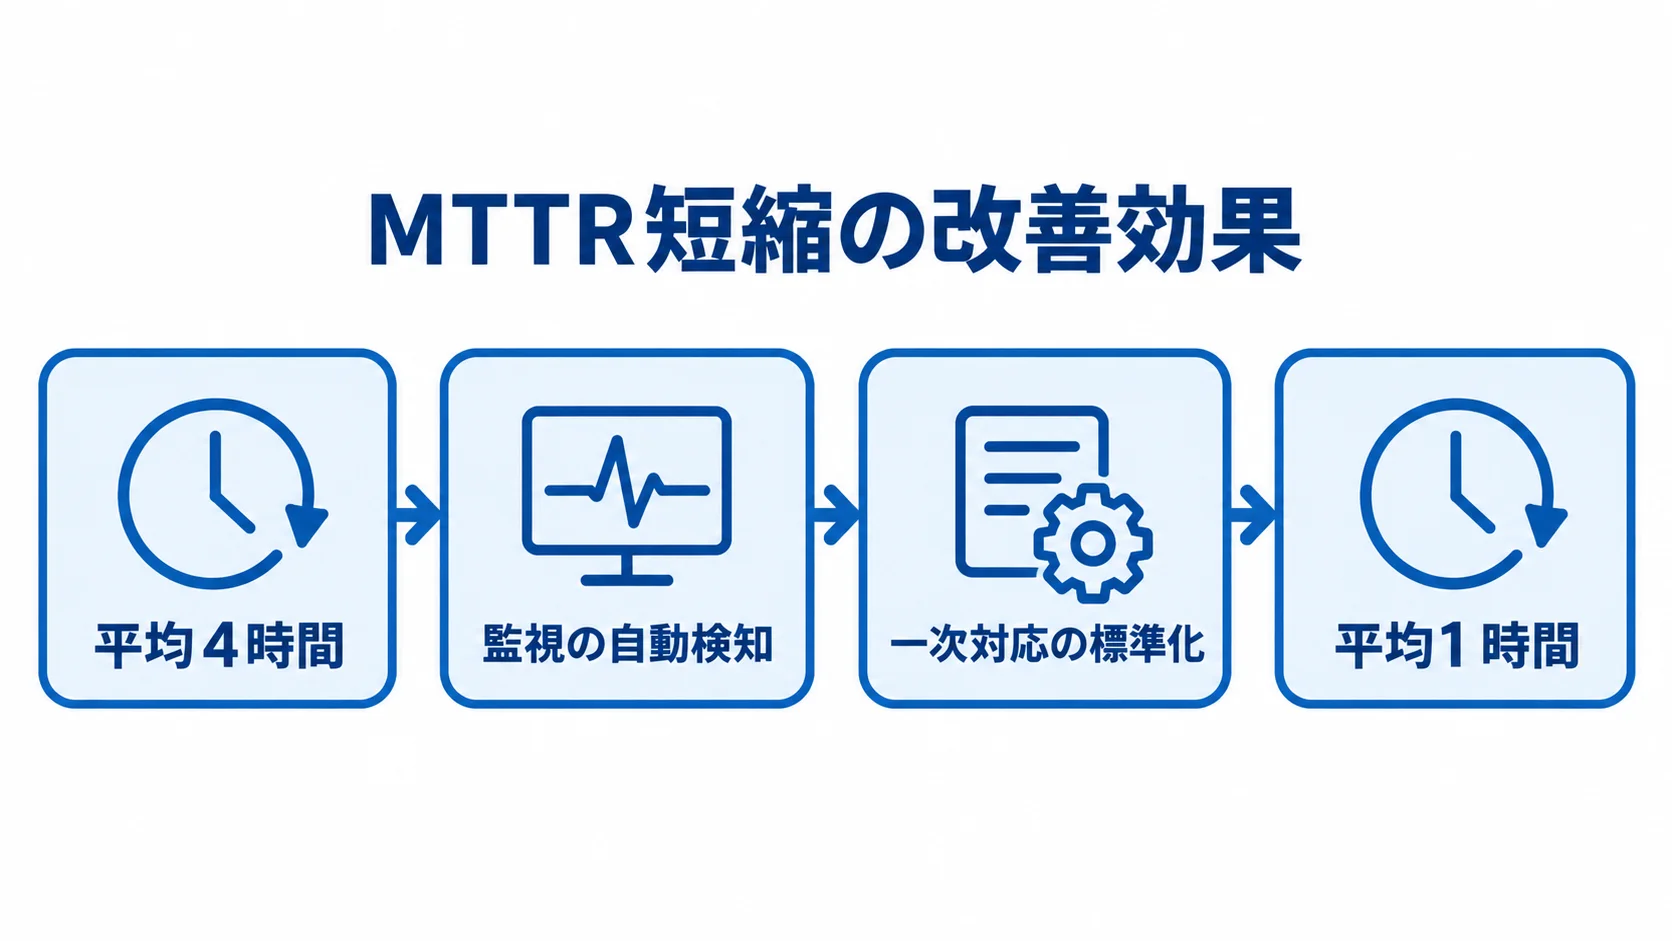
障害対応の事例で経営層に響きやすいのは、ダウンタイム(システム停止時間)の削減を数値で示したケースです。
「起きてから直す」だけでは評価されにくいものですが、停止回数・平均復旧時間・機会損失額をBefore/Afterで並べると、投資効果が一気に見えてきます。
事例を読むときは、自社のシステム停止が事業にいくらの損失を与えているかを、まず金額に置き換えることが出発点になります。
MTTR短縮と停止回数の削減を定量化した事例
障害対応の改善効果は、MTTR(平均修復時間)と停止回数で測ると説得力が出ます。たとえば「障害発生から復旧まで平均4時間かかっていたものが、監視の自動検知と一次対応の標準化によって平均1時間に短縮された」と示せば、改善幅が一目で分かります。
総務省2025年版の調査では、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失が生じるとされています。そのため、停止回数や停止時間が減ること自体が、直接的な損失削減につながります。
この効果を自社に当てはめるには、過去1年の障害ログを洗い出し、停止回数、1回あたりの平均停止時間、その間に止まった売上や業務を概算します。
Gartnerの2024年の試算では、ダウンタイム1分あたり5,600米ドルとされています。この単価を使えば、「年間で何分止まっていたか」を金額に換算できます。
事例の数字は、自社の停止時間に置き換えて初めて、投資を回収できるかを判断する材料になります。
改善の効果は、MTTRと停止回数の2つで追うと、どこが良くなったかが分かります。
- MTTR:障害の発生から復旧までの平均時間
- 停止回数:一定期間に何回止まったか。1回ごとの損失額と掛け合わせて使う
復旧の速さだけでなく、「再発を防げたか」も見落とせない指標です。同じ障害を何度も繰り返していては、いくらMTTRが短くても損失は積み上がります。
改善した事例では、復旧後に必ず原因の振り返り(ポストモーテム)を行っていました。また、暫定対応で終わらせず恒久対策まで踏み込み、同種障害の再発を年単位で抑え込んでいました。
停止回数のグラフが右肩下がりになっているかどうかは、障害対応が機能しているかを示す何よりの証拠です。
事例を見るときは、単発の復旧の武勇伝ではなく、年間を通じた停止回数の推移に注目すると、その企業の対応の質が見えてきます。
監視の自動検知で「気づくのが遅い」を解消した事例
ダウンタイムが長引く最大の原因は、復旧作業そのものより「障害に気づくのが遅い」ことにあります。利用者からのクレームで初めて停止を知るようでは、検知までの空白時間がそのまま損失になります。
改善事例では、死活監視とリソース監視を導入して異常をしきい値で自動検知し、担当者へ即座にアラートを飛ばす仕組みを整えています。これにより、「停止に気づくまで30分」が「停止から数分でアラート」へと短縮され、結果としてMTTR全体が縮みます。
監視ツールには、OSSでライセンス無料のZabbixを自社で構築するケースと、Datadog・New Relic・Mackerelといったクラウド型を従量課金で使うケースがあります。クラウド型は中規模で月数万円から数十万円程度が目安で、構築の工数を抑えながら短期間で監視を立ち上げられます。
この事例では、復旧の速さを語る前に「どれだけ早く正確に異常を検知できるか」が勝負だという点が読み取れます。検知が早いほど、軽微なうちに手を打てて、大規模障害への発展を防げます。
障害の影響を追うには、検知と復旧にかかった時間をそれぞれ記録しておくと役立ちます。
- 検知までの時間:障害の発生から担当者が気づくまでの空白時間
- 復旧までの時間:アラートを受けてから復旧するまでにかかった時間
夜間障害の火消し体制を立て直した事例
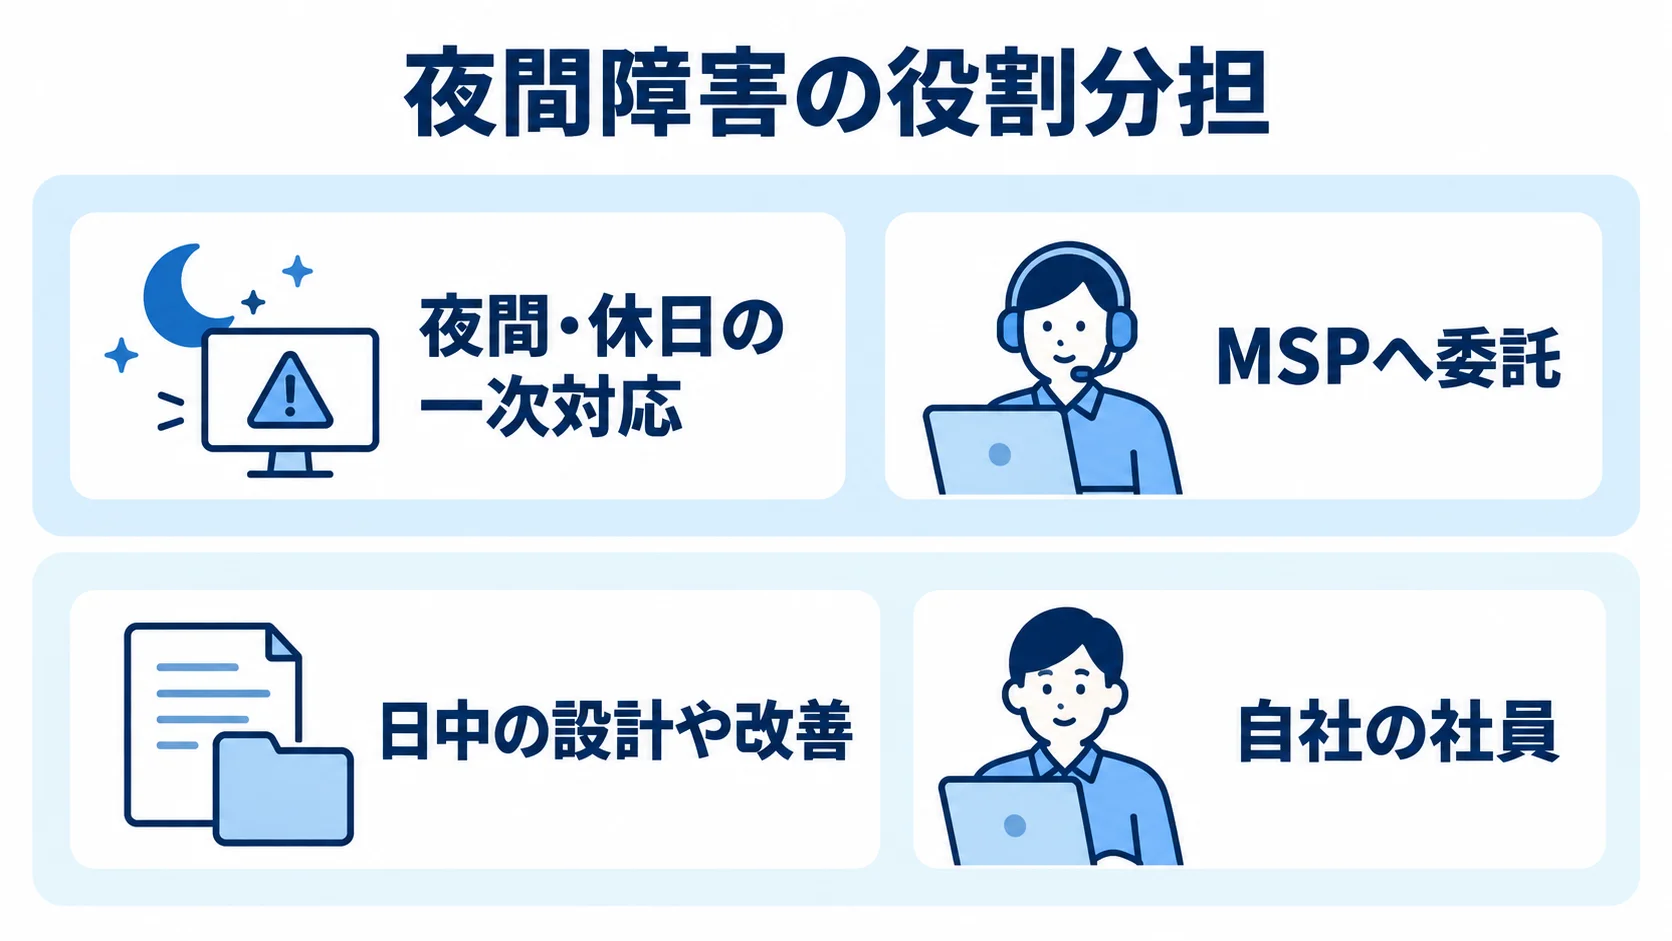
多くの企業がもっとも疲弊するのが、夜間・休日に発生する障害への対応です。担当者が私用の携帯で呼び出され、自宅から手探りで対応し、翌日も通常業務をこなす属人的な火消しは、長続きしません。
障害対応の事例の中でも、この「夜間障害の体制づくり」をどう立て直したかは、現場の疲弊を解消するうえで参考になります。
24時間365日の一次対応を外部委託した事例
夜間障害を自社の社員だけで24時間365日カバーしようとすると、シフトを組むだけで複数名の人件費が必要になります。監視オペレーターの人月単価は60万〜80万円が一般的で、夜勤を含む常時体制を自社で抱えると、年間で数千万円規模の固定費になります。
立て直しに成功した事例では、夜間・休日の一次対応をMSP(マネージドサービスプロバイダー)へ委託し、自社の社員は日中の設計や改善に集中する分業を実現しています。
委託の費用は、どの時間帯まで任せるかで大きく変わります。
- 24時間の緊急対応:月10万〜20万円程度
- 営業時間内の対応:月3万〜8万円程度
フルマネージドのサービス会社では、1台あたり月2万円といった料金例もあります。自社で夜勤要員を抱える固定費と比べれば、委託のほうが圧倒的に安く、しかも担当者が体調を崩しても体制が崩れません。
事例が示すのは、夜間障害は「人を増やす」のではなく、「夜間だけ外部の専門チームに預ける」発想で解くべきだという点です。
委託を成功させた事例には、もう一つ共通点があります。それは、委託先に渡す「対応してほしい範囲」と「自社に連絡してほしい基準」を事前にすり合わせていたことです。
何でもかんでも夜中に電話されても困りますし、逆に重大障害を朝まで放置されても困ります。
軽微なものは委託先が手順書どおりに一次対応して翌朝まとめて報告し、重大障害だけを即時にエスカレーションする線引きを、発注側が契約段階で明文化しておきます。
この合意があるかどうかで委託の満足度は変わります。委託は「丸投げ」ではなく「役割分担の設計」だと捉えることが、夜間体制を続けるうえでの鍵になります。
手順書とエスカレーション設計で属人化を解いた事例
夜間障害の火消しが一部の社員に偏る根本原因は、対応手順がその人の頭の中にしかない「属人化」です。
立て直した事例では、障害の種類ごとに初動の手順書(ランブック)を整備し、誰が見ても同じ初動が取れる状態をつくりました。
典型的なケースは、サーバーが応答しないとき、特定のサービスが落ちたとき、ディスクが逼迫したときです。
あわせて重要なのが、エスカレーション設計です。一次対応で収束しない重大障害をいつ、誰に上げるかを明確にしておかないと、現場が抱え込んで復旧が遅れます。
官公庁の仕様例では「1時間以内に内容と予想作業時間を報告」といった初報のルールが定められており、民間でも参考になります。
事例で確かめられるのは、外部委託を入れるにせよ社内で続けるにせよ、手順書とエスカレーションのルールが整っていなければ属人化は解消しない、という基本です。仕組みで回る体制をつくれば、夜間障害への不安から現場を解放できます。
手順書には、原因を切り分ける確認の流れと、業務を先に戻す暫定復旧の手順を残しておきます。
- 確認手順:障害の原因を切り分けるための確認の流れ
- 暫定復旧手順と連絡先:業務を先に戻す手順と、連絡すべき相手の一覧
ひとり情シスが監視・障害対応を委託した事例
中小企業に多いのが、情報システム担当が実質ひとりという「ひとり情シス」の体制です。日中は社内のIT問い合わせや小さな改善に追われ、そのうえで監視も障害対応も担うことは、現実的に不可能に近いものです。
この状況を委託でどう解いたかは、限られた人員で事業を守りたい企業にとって示唆に富む事例です。
監視だけ低コストで委託しスモールスタートした事例
ひとり情シスがいきなりフルマネージドの委託に踏み切るのは、予算面でハードルが高いものです。そこで現実的な事例として多いのが、小さく始めて効果を見ながら範囲を広げるスモールスタートです。
サービス会社の料金例では、サーバー監視が月3万円、あるいは1台あたり5,000円といった水準から始められます。シーズホスティングのように、専用サーバーの監視・障害対応を月55,000円で提供する例もあり、最小限の固定費で「常に誰かが見ている」状態をつくれます。
段階的な進め方の利点は、初期投資を抑えつつ、障害の「気づき」を外部に肩代わりしてもらえる点にあります。監視で異常が起きやすい時間帯や傾向が見えてくれば、その数字に基づいて次の進め方を判断できます。
事例が教えるのは、ひとり情シスはすべてを抱えるのではなく、「監視という最も自動化しやすい部分」から外に出すのが定石だという点です。
任せる範囲は、段階を追って少しずつ広げられます。
- 第一段階:監視だけを低コストで委託する段階
- 次の段階:一次対応まで広げるか、特定のシステムだけ24時間対応を付ける段階
過剰SLAを適正化して保守費を圧縮した事例
限られた予算でやりくりする企業の事例で見逃せないのが、過剰なSLA(サービス品質保証)を適正化して保守費を圧縮したケースです。
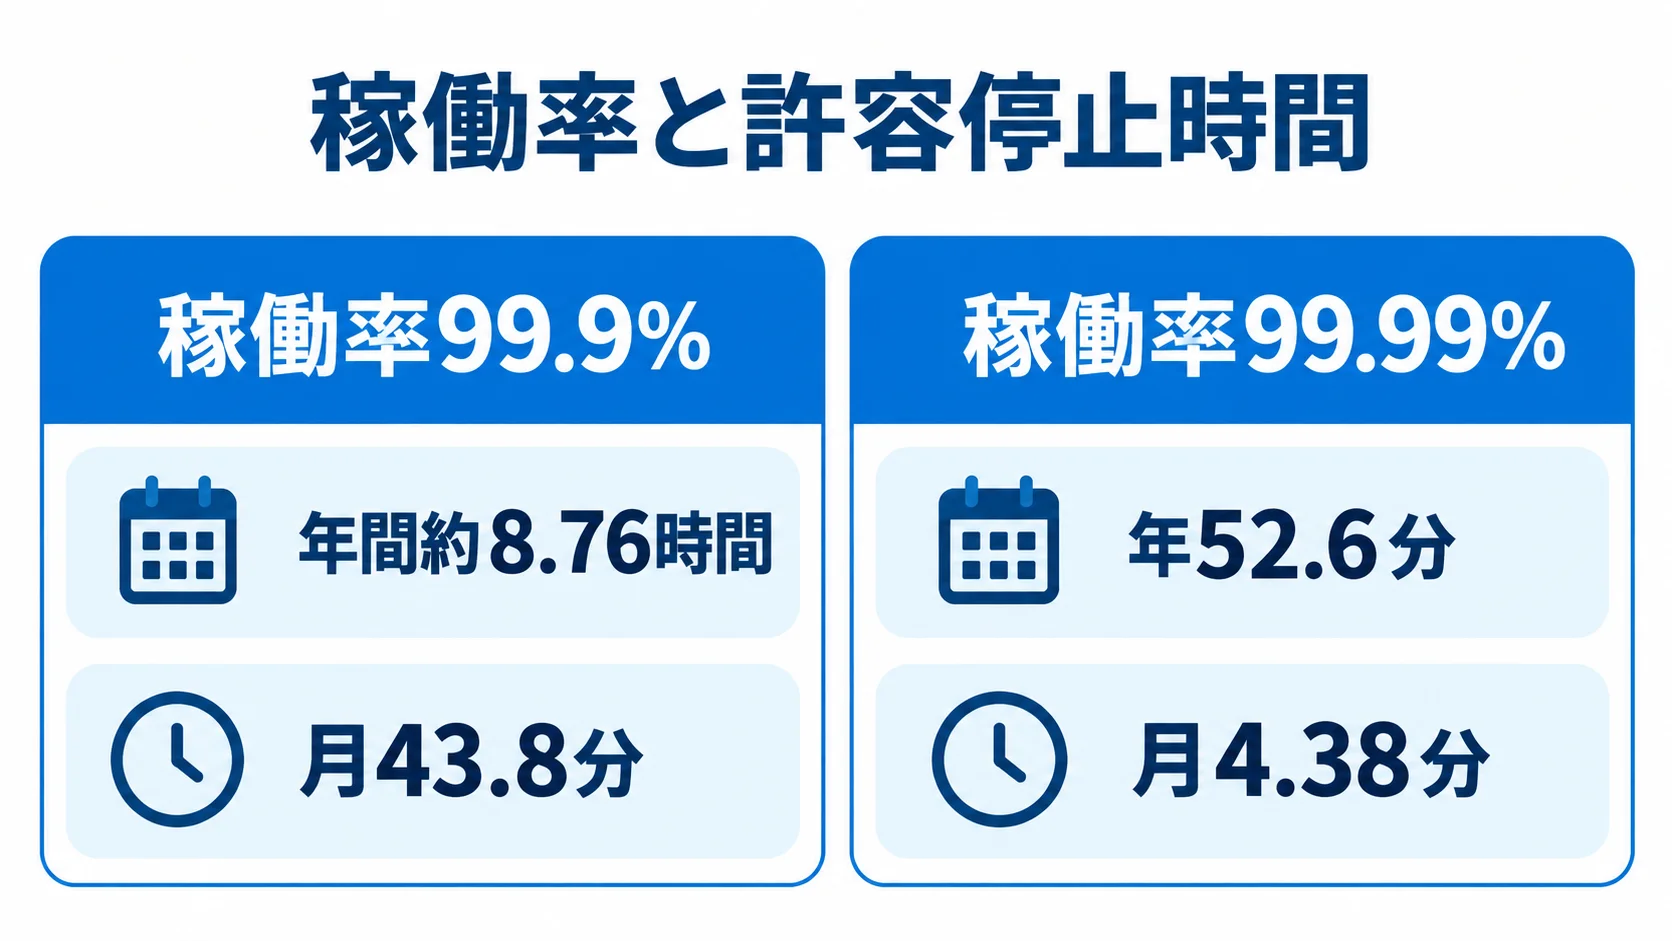
稼働率99.9%は年間で約8.76時間の停止を許容しますが、99.99%にすると許容停止は年52.6分まで縮みます。この「9」が一つ増えるごとに、運用コストは段階的に跳ね上がります。
事例では、社内の業務システムに対して本当に99.99%が必要かを、事業影響度の観点から見直しました。夜間に止まっても翌朝の復旧で支障のないシステムについては、SLAを下げて、その分の保守費を削減しています。
ポイントは、SLAの緩和を情シスの一存で決めるのではなく、業務部門と合意することです。
停止が事業にどれだけ影響するかを一覧にし、「このシステムは半日止まっても損失は限定的」「こちらは数分の停止も許されない」と仕分けたうえで、重要度に応じてSLAと費用にメリハリをつけます。
事例から学べるのは、すべてのシステムに最高水準の障害対応を付けるのは過剰投資だという点です。あわせて、事業影響度に応じて守りの厚みを変えることが、ひとり情シスでも事業を守りきるコツになります。
SLAを見直すには、事業影響度と許容停止時間を並べて見るのが手がかりになります。
- 事業影響度:システムが止まったときの損失の大きさ
- 許容停止時間:稼働率ごとに許される年間や月間の停止時間
この適正化を進めた事例では、業務部門への説明資料として、稼働率99.9%と99.99%の許容停止時間の差を具体的な分数で示しました。
99.9%なら月43.8分、99.99%なら月4.38分という数字を並べると、「そこまでの可用性が本当に必要か」という議論が現実的になります。
感覚論で過剰なSLAを維持し続けるより、数値で事業影響と費用を比べることで、削れる保守費が見えてきます。
SLAの適正化は、障害対応を「やみくもに手厚く」から「必要なところに必要なだけ」へと変える出発点になります。
発注者側の初動とBCP連動で被害を抑えた事例
障害対応というとベンダーや委託先の動きに目が向きがちですが、実は発注者である情報システム部門自身の初動が、被害の大きさを左右します。
ベンダーに丸投げできない場面は、たとえば経営層や業務部門への状況報告、利用者への告知です。また、BCP(事業継続計画)に沿った代替手段の発動なども、発注者側がリードするしかありません。
発注者側の立ち回りを整えた事例は、技術以外の部分で被害を抑える知恵を教えてくれます。
経営層・業務部門への状況報告を型化した事例
大きな障害が起きたとき、現場が復旧作業に追われる一方で、経営層や業務部門は「いつ直るのか」「顧客にどう説明するのか」を強く知りたがります。
報告が遅れたり曖昧だったりすると、現場に問い合わせが殺到し、かえって復旧が遅れる悪循環に陥ります。改善した事例では、報告をテンプレートとして用意していました。
事例では、次の報告予定時刻も併せて示す仕組みを整えました。
官公庁の仕様例では「1時間以内に内容と予想作業時間を報告」と定められており、初報のタイミングを社内ルールに落とし込むだけでも、社内の混乱は減ります。
報告を型にしておくと、復旧の担当者が報告作業に時間を取られず、技術対応に集中できる利点もあります。
事例が教えるのは、障害対応の巧拙は復旧スピードだけでなく、社内コミュニケーションの設計でも決まるという点です。報告が安定していれば、復旧に多少時間がかかっても組織は冷静さを保てます。
報告の型は、次の二つで整えます。
- 段階:初報・中間報・終報の三段階で報告する
- 内容:何が起きているか、影響範囲、復旧見込みを定型で伝える
クラウド障害のブラックボックスに自衛策を講じた事例
近年増えているのが、クラウドやSaaSの基盤側の障害への対応です。国内エンタープライズ・システム市場のクラウド比率は2022年で約5割に達しており(IDC Japan)、自社のサービスがクラウド基盤の障害に巻き込まれるリスクは年々高まっています。
やっかいなのは、クラウド基盤の障害は利用者側から手出しができず、補償もサービスクレジット止まりで、実損をカバーしてくれないことです。
「監視のブラックボックス化」に自衛策を講じた事例は、クラウド時代の障害対応の必須知識になりつつあります。
自衛策の具体例としては、重要なシステムをマルチリージョンやマルチクラウドで冗長化する設計が挙げられます。事例では、クラウド基盤の稼働状況に依存しきらず、自社側でも到達性を監視し、障害時には縮退運転や代替手段に切り替える手順をBCPに組み込んでいました。
クラウドだから安心と任せきるのではなく、ブラックボックスの外側で自衛する設計こそが、クラウド時代の障害対応の要点だと言えます。
自衛策は、次の二つを組み合わせて考えると整理しやすくなります。
- 冗長化:片方の基盤が落ちても切り替えられる構成
- 外形監視:利用者から見たサービスの生死を独自に監視する仕組み
あわせて事例で工夫されていたのが、クラウド基盤側の障害が起きた際の「説明の準備」です。自社に原因がなくても、利用者から見れば「あの会社のサービスが止まった」という事実は変わりません。
基盤障害が疑われる場合に備えて、事例の企業はクラウド事業者のステータスページの確認手順、利用者への一次告知文の雛形、復旧後の経緯説明のテンプレートをあらかじめ用意していました。手出しできない障害だからこそ、技術ではなく説明責任の準備で差がつきます。クラウド移行を進める企業ほど、こうした発注者側の備えを事例から学ぶ価値が大きいと言えるでしょう。
まとめ
ITシステム障害対応の事例で成功に共通するのは、ダウンタイムを停止回数・MTTR・機会損失額で定量化し、監視で早く気づく仕組みを整えたうえで、夜間や常時の体制を外部に委託する流れです。
事業影響度に応じてSLAにメリハリをつける点も、成功した事例で見られます。
総務省の調査が示す1回1,200万円の機会損失や、Gartnerの1分5,600米ドルといった一次データを使えば、障害対応への投資は「コスト」ではなく「損失を防ぐ保険」として説明できます。
夜間障害の属人化は手順書とエスカレーション設計で解け、ひとり情シスは監視からスモールスタートで委託していくのが定石です。
事例を読むときに大切なのは、「どんなツールを入れたか」ではなく、「どの損失を、いくらの投資で、どれだけ減らせたか」という視点です。
まずは自社の障害ログを洗い出し、停止時間を金額に置き換えることから始めてください。
riplaは、フルスクラッチの受託と国内開発を組み合わせ、システムを作ったあとも監視・障害対応で継続的に伴走して、事業を止めない体制づくりを支援しています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。