
ITシステム障害対応とは、障害を検知して復旧し、再発を防ぐ仕組みを整えて、特定の担当者に頼らない体制をつくることです。
障害をゼロにするのは難しいため、被害を抑えて早く戻す流れを前もって用意します。関連テーマは、進め方、会社選び、費用、発注方法の順に個別記事で確認できます。
- ITシステム障害対応の進め方/やり方/流れや方法/手法/工程/手順
- ITシステム障害対応でおすすめの開発会社/ベンダー6選と選び方
- ITシステム障害対応の見積相場や費用/コスト/値段について
- ITシステム障害対応の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム障害対応の全体像
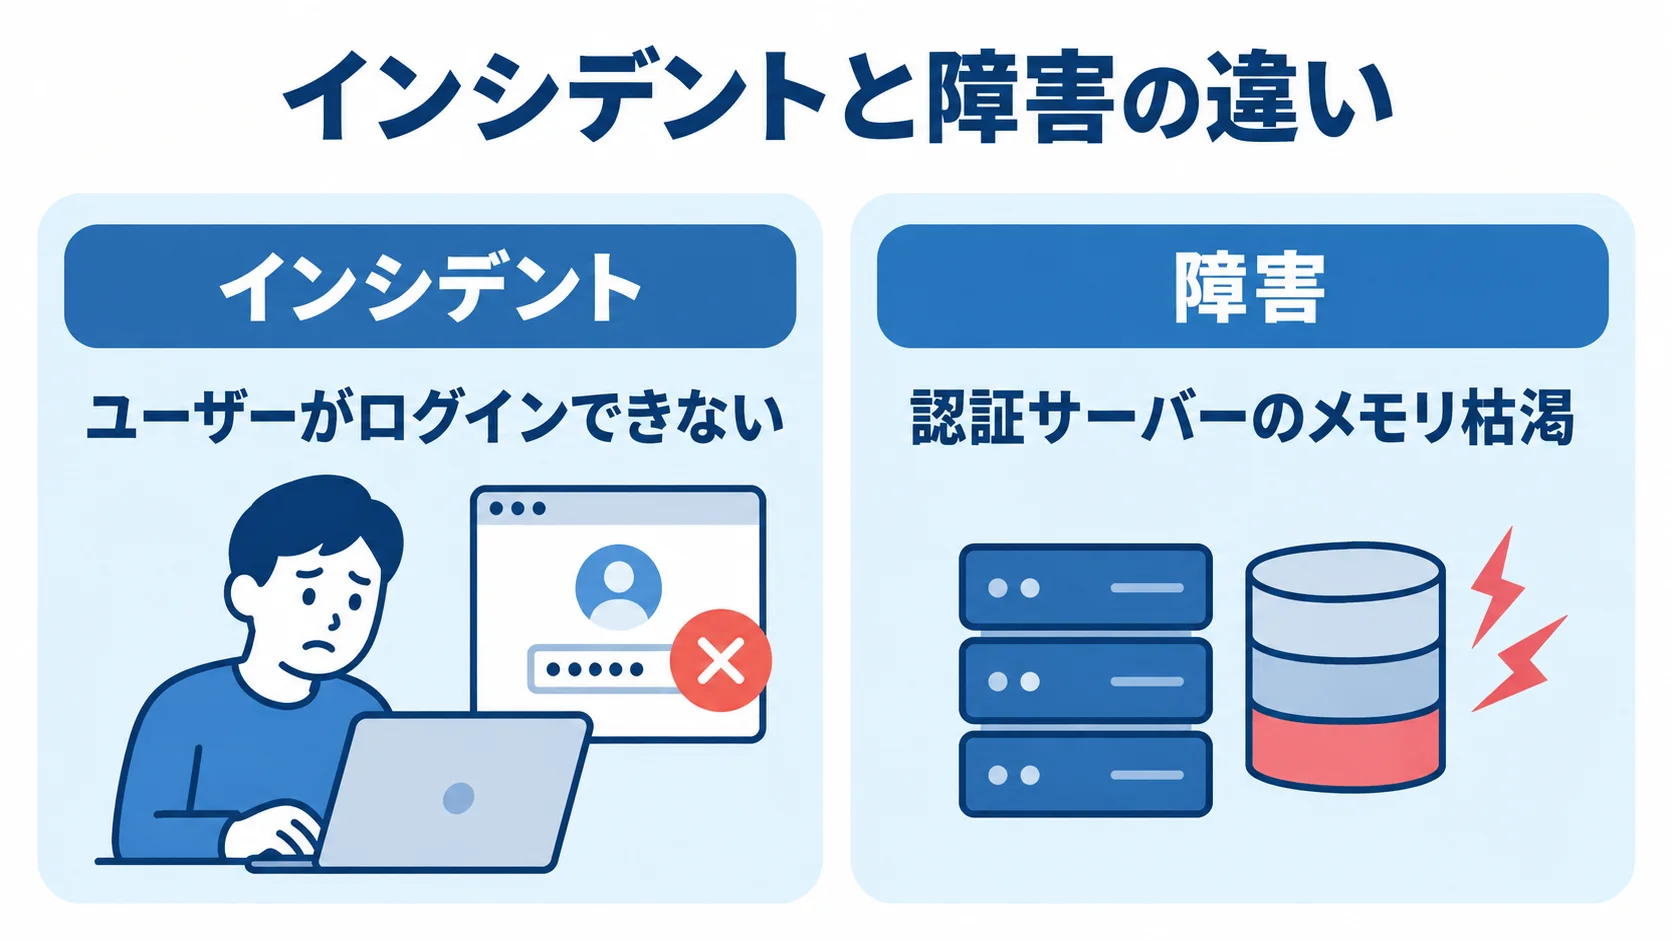
ITシステム障害対応とは、システムが正常に稼働しなくなった状態を迅速に解消し、再発を防ぐための一連の活動を指します。この活動をうまく進めるには、まず「インシデント」と「障害」という言葉の違いを押さえておく必要があります。
両者を混同したまま対応にあたると、復旧と再発防止のどちらに力を注ぐべきかが曖昧になり、対応がちぐはぐになります。そのため、用語の整理から全体像を理解していくのが近道です。
インシデントと障害の違い
インシデントとは、「サービスが本来あるべき状態で稼働していない状態」そのものを指します。一方で障害は、そのインシデントを引き起こしている原因となる事象のことです。たとえば、「ユーザーがログインできない」がインシデントで、その背後にある「認証サーバーのメモリ枯渇」が障害にあたります。
この区別を意識すると、対応の優先順位が明確になります。障害対応では、まず利用者への影響を取り除く「インシデント管理」と、原因を突き止めて再発を防ぐ「問題管理(障害管理)」を分けて考えます。
インシデント管理では、復旧を最優先し、暫定的な手段でも構いません。これに対して問題管理は、時間をかけてでも根本原因を特定し、恒久的な対策を講じます。この二段構えを理解しているかどうかが、障害対応の成熟度を大きく左右します。
障害対応の成果を測るMTTRという指標
障害対応がうまく機能しているかを測る代表的な指標が、MTTR(Mean Time To Repair/平均復旧時間)です。これは障害が発生してから復旧するまでの時間の平均値で、この数値が短いほど、検知・判断・復旧の仕組みが洗練されていることを意味します。
感覚的に「最近よくトラブルが起きる」と語るより、MTTRという共通の物差しで定量的に評価することが改善の出発点になります。障害対応は、属人的な根性論ではなく、指標に基づいて科学的に改善できる領域だという視点を持つことが大切です。
たとえば、本番に近い環境で擬似障害を意図的に起こして回復力を検証する、カオスエンジニアリングを取り入れた事例があります。計47件の実験を通じて12件の致命的な故障モードを特定し、MTTRを65%削減できたと報告されています。詳しい手順は、ITシステム障害対応の進め方/やり方/流れや方法/手法/工程/手順で確認できます。
ITシステム障害対応の進め方とフロー
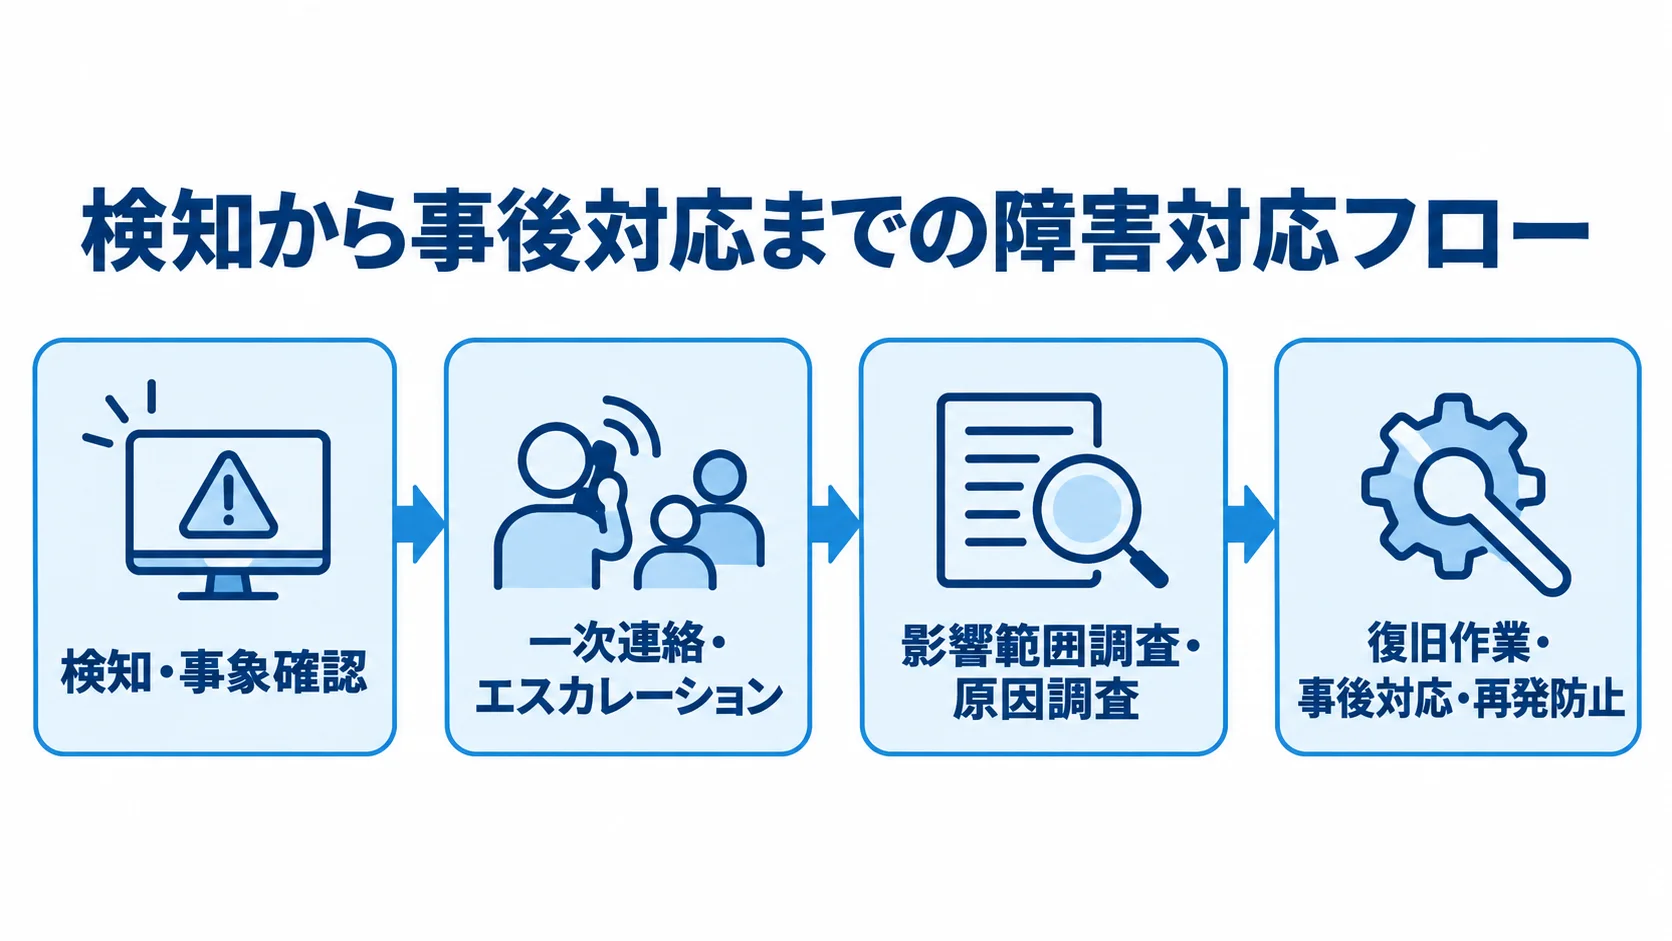
障害対応には標準的なフローがあり、決められた手順に沿って動くことで、混乱を避けて復旧時間を短くできます。場当たりで動かず、流れを先に決めておくことが大切です。
ここでは、検知から事後対応までの大きな流れと、それを支える役割分担が中心になります。各ステップの具体的な手順や判断基準は、進め方の個別記事で詳しく解説しています。
検知から事後対応までの基本ステップ
障害対応の基本フローは、おおむね次の順で進みます。まず監視アラートやユーザーからの問い合わせで異常を「検知・事象確認」し、続いて関係者へ「一次連絡・エスカレーション」を行います。
その後、「影響範囲調査」で被害の広がりを把握し、「原因調査」を経て「復旧作業」に移ります。最後に「事後対応・再発防止」として報告書を作成し、学びを組織に残します。
大切なのは、復旧を優先する暫定対応と、原因を根本から断つ恒久対策を切り分けることです。利用者への影響が出ている最中に根本原因の解明にこだわると、復旧が遅れて被害が拡大します。そのため、まずサービスを正常に戻し、落ち着いてから原因究明と恒久対策に取り組む順序を守ることが、被害最小化の鉄則です。
役割分担とインシデントコマンドの考え方
障害対応を円滑に進めるには、明確な役割分担が欠かせません。一般的には、インシデントコマンダー(指揮官)、オペレーションリード(実施担当)、コミュニケーションリード(社内外への調整役)を立て、さらに書記役を置きます。
指揮官が全体を統括し、実施担当が手を動かし、調整役が経営層や顧客への報告を引き受けることで、現場のエンジニアが連絡対応に追われて疲弊する事態を防げます。ただし、夜間や休日に人員が揃わない中小企業やスタートアップでは、教科書どおりの体制を組めないこともあります。その場合は、役割を兼務する「縮退運転」が現実解になります。
たとえば2名なら、意思決定と実作業を担う対応ラインと、連絡と記録を担うコミュニケーションラインに分け、作業者が外部連絡にリソースを奪われないようにします。人数に応じた柔軟な役割設計が、限られたリソースで障害を乗り切る鍵になります。関連する手順の詳細は、ITシステム障害対応の進め方/やり方/流れや方法/手法/工程/手順で確認できます。
障害対応を支援する会社・サービスの選び方
自社の人員だけで24時間365日の監視と障害対応をまかなうのは、多くの企業にとって負担が大きいものです。そこで、インフラ運用代行や監視サービス、インシデント管理プラットフォームといった外部サービスを使う選択肢があります。
支援先は、どの基準で見極めるかが判断の要になります。具体的なおすすめ企業の比較は、専用の比較記事をご覧ください。
対応範囲とSLAの確認ポイント
支援先を選ぶ際にまず確認したいのは、どこまでの対応範囲をカバーしてくれるかです。死活監視やリソース監視といった一次検知だけなのか、障害発生時の一次切り分けや復旧作業まで担うのかで、サービスごとの守備範囲は大きく異なります。自社に足りない部分を補えるかどうかを、契約前にすり合わせておく必要があります。
あわせて重視したいのが、SLA(サービス品質保証)の中身です。検知から連絡までの時間や、障害の深刻度ごとの対応開始時間、目標復旧時間が、具体的な数値で示されているかを確認しましょう。たとえば、極めて重大な障害では検知から15分以内の連絡と1時間以内の復旧、影響度が大きい障害では30分以内のエスカレーションといった水準が、一つの目安になります。
「最善を尽くす」といった曖昧な表現にとどまる契約には、注意が必要です。
ベンダーコントロールの体制評価
外部サービスに障害対応を任せるなら、いざというときに相手をコントロールできるかどうかも重要になります。ベンダー側で障害が起きた際には、SLA違反時のペナルティ条件が明確か、障害報告書(RCA)の妥当性を自社で評価できる材料が提供されるかを、選定段階で見極めておくべきです。納得できない内容であれば差し戻して再調査を求められるかも、同じく確認しておきたい点です。
「外部に任せたから安心」で終わらせず、提出された原因分析に論理の飛躍がないか、再発防止策が具体的かを問える関係を築くことが、長期的な安定運用につながります。委託先は、料金だけでなく、有事の際に対等に向き合えるパートナーかという視点で選ぶことが大切です。
詳しい内容は、ITシステム障害対応でおすすめの開発会社/ベンダー6選と選び方で確認できます。
ITシステム障害対応の費用相場
障害対応にかかる費用は、求める監視水準や対応範囲によって大きく変わります。費用の考え方の枠組みと、見積もりを左右する主な要因を見ていきます。
実際の金額レンジや内訳の詳細は、費用相場の個別記事で具体的に解説しています。予算を検討する際に、あわせてご確認ください。
監視・対応レベル別の費用目安
障害対応の費用は、大きく「監視」と「対応」の二層に分けると整理できます。死活監視やリソース監視といった基本的な監視だけなら、月額のランニングコストは比較的抑えられます。一方で、24時間365日の有人監視や、障害発生時の一次対応・復旧作業まで含めると、費用は段階的に上がっていきます。
求める安心の度合いと予算のバランスをどこに置くかが、検討の出発点です。また、平時の監視費用とは別に、障害が実際に起きたときのスポット対応費用がかかる契約形態もあります。
見積もりは、初期費用、月額の固定費用、障害発生時の従量費用という三つの構成要素に分けて読み解くと、想定外の請求を避けやすくなります。
費用を左右する主な要因
見積もり金額を左右する代表的な要因は、監視対象となるサーバーやサービスの数と、目標とする復旧時間の厳しさです。対応時間帯(平日日中のみか、夜間・休日も含むか)や、対応窓口の人数体制も金額に響きます。これらの条件が厳しくなるほど、必要な人員と仕組みが増え、費用も上昇します。
費用を適正に抑えるには、自社のシステムにとって本当に守るべき範囲はどこかを見極めることが重要です。すべてを最高水準で守ろうとすると、費用は際限なく膨らみます。
事業への影響度が高い中核システムには手厚い対応を、影響が限られた部分には最小限の監視を充てるといったメリハリをつけることで、コストと安心のバランスを取れます。詳しい内容は、ITシステム障害対応の見積相場や費用/コスト/値段についてで確認できます。
障害対応の発注・外注方法
障害対応を外部に委託する際は、いきなり契約せず、まず自社の現状を整理してから発注先と要件をすり合わせることが、成功の前提になります。
発注先の種類と、依頼前に用意しておきたい情報を見ておきます。委託の具体的な進め方や契約上の注意点は、発注・外注の個別記事で詳しく解説しています。
発注先の種類と特徴
障害対応の委託先には、いくつかのタイプがあります。システムを開発したベンダーに保守と障害対応を任せる方法や、インフラ運用に特化した運用代行会社に監視と対応を任せる方法があります。ほかにも、インシデント管理ツールを提供する事業者に、通知や自動化の基盤づくりを依頼する形もあります。
それぞれ得意領域が異なるため、自社の課題に合う相手を選ぶ必要があります。開発元のベンダーはシステムの内部構造を熟知しているため原因究明に強い一方、運用代行会社は監視と一次対応の体制を効率的に提供できます。
複数のサービスを組み合わせ、検知は監視サービス、復旧は開発ベンダーといった役割分担を設計することも一つの考え方です。それぞれの強みを理解して組み合わせると、過不足のない体制づくりにつながります。
発注前に準備すべき情報
委託先に的確な提案をしてもらうには、自社のシステム構成や運用状況を整理して伝える準備が欠かせません。ネットワーク図やサーバー資産の一覧、過去の障害履歴を事前にまとめておくと、見積もりの精度が上がります。現在の監視体制や、対応してほしい時間帯と目標復旧時間も併せて示せば、認識のずれも防げます。
とりわけ重要なのが、どの障害をどの深刻度として扱うかという基準のすり合わせです。自社にとっての「重大な障害」と委託先が想定する「重大な障害」が食い違うと、有事の際の対応スピードに思わぬギャップが生じます。
そのため、発注前の段階で深刻度の定義と対応水準を文書で合意しておくことが、トラブルを未然に防ぐ最良の準備となります。詳しい内容は、ITシステム障害対応の発注/外注/依頼/委託方法についてで確認できます。
再発防止と組織文化のポイント
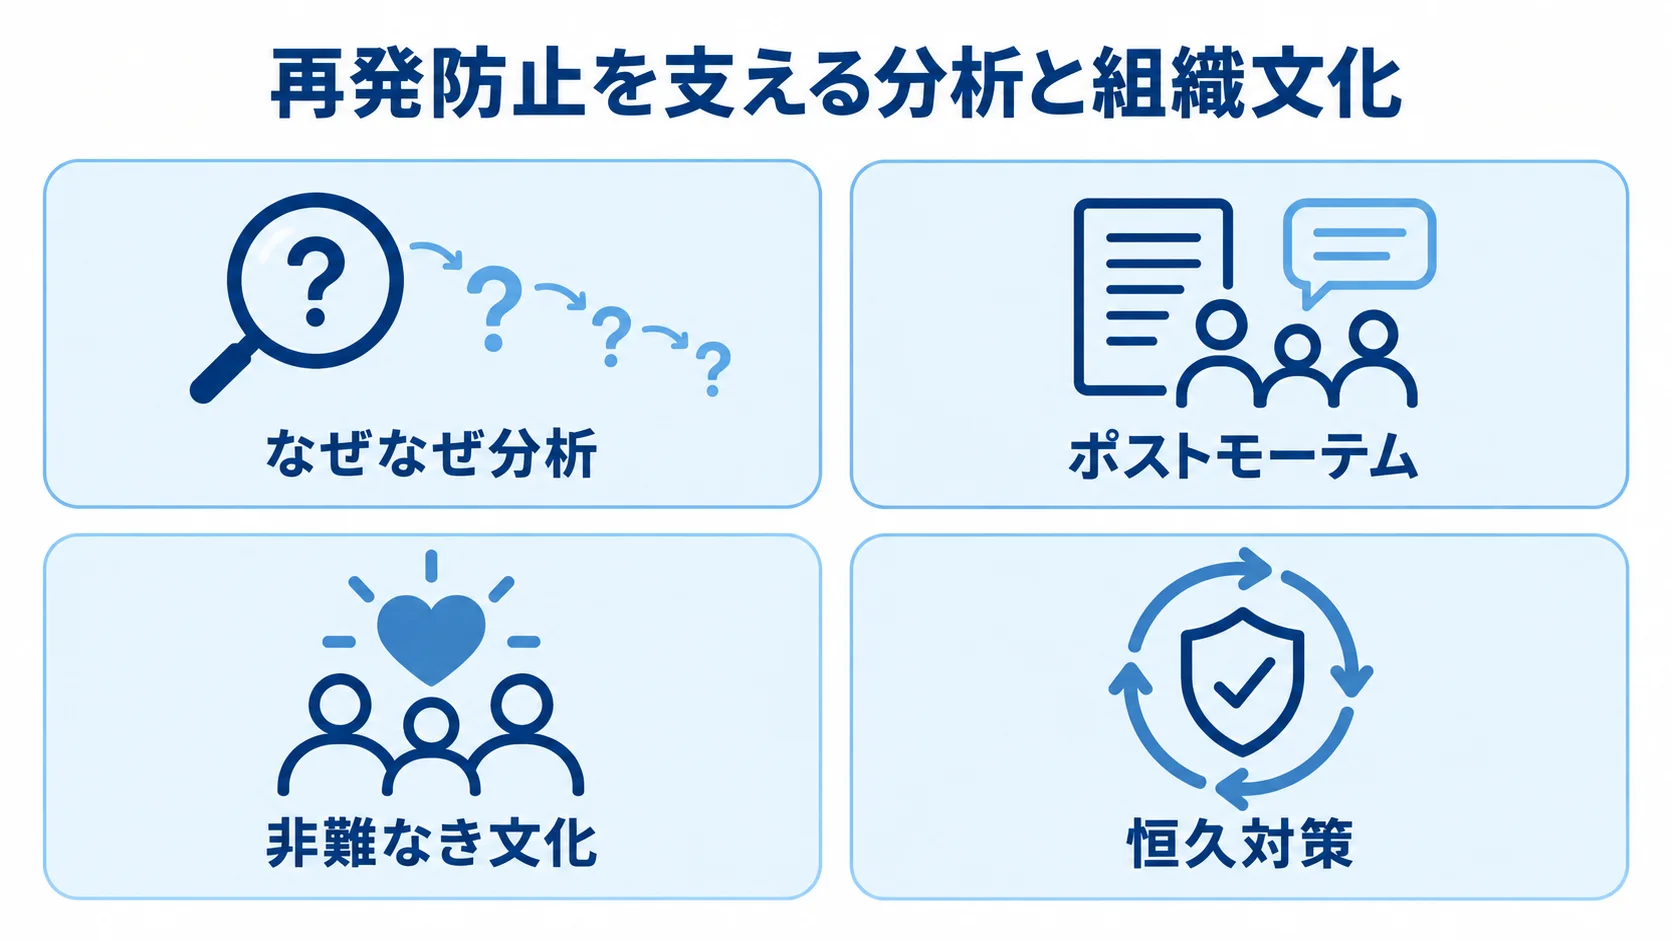
障害対応の真価は、復旧した後にこそ問われます。同じトラブルを二度と起こさないための仕組みと、それを支える組織文化があってはじめて、障害対応は成熟したものになります。
ここでは、根本原因の追究方法と、再発防止を機能させる文化づくりを順に見ていきます。これらは外部に委託できず、自社で育てるべき領域です。
なぜなぜ分析とポストモーテム
根本原因を突き止める代表的な手法が「なぜなぜ分析」です。表面的な事象に対して「なぜ起きたのか」を繰り返し問い、奥に潜む本質的な課題を浮き彫りにします。ただし、「なぜあなたはミスをしたのか」と問うと、個人攻撃になりかねません。
質問を「どのようにしてこの状況が生まれたのか」という仕組みへの問いに変えると、人ではなくプロセスに焦点を当てた建設的な分析になります。そのうえで、障害が解決したら、記憶が新しいうちに、理想的には72時間以内にポストモーテム(事後検証)を実施します。
ポストモーテムは単なる障害報告書とは異なり、概要とタイムラインを整理し、根本原因と再発防止策まで含めて、組織の学習資産として残すものです。さらに、「たまたま早く気づけた」といった運の要素まで洗い出し、なぜ監視アラートより先にユーザーが異常に気づいたのかをシビアに振り返ると、潜在的なリスクが見えてきます。
非難なき文化と恒久対策の守り方
再発防止を機能させる土台となるのが、「非難なき文化(Blameless Culture)」です。たとえるなら、花瓶の水を換えようとして落として割ってしまったとき、その人の不注意を責めるのではなく、水場までの移動経路や割れやすい材質といった環境・仕組みに根本原因を見出す姿勢です。こうした文化があってはじめて、現場は失敗を正直に共有し、本当の原因にたどり着けます。
もう一つの難所は、ポストモーテムで立てた恒久対策が、日々の新機能開発に追いやられて実行されないことです。ビジネス側の「新機能を優先したい」という圧力に押されて技術的負債の解消が後回しになると、同じ障害がいずれ再発します。
恒久対策を開発計画の中に明確なタスクとして組み込み、優先度を確保する交渉を続けることが、再発を本当に断つための実務になります。さらに、経営層に対しては、「障害ゼロは不可能であり、障害を前提に備える文化こそが事業を守る」という認識を粘り強く共有していくことが求められます。
まとめ
ITシステム障害対応は、インシデントと障害の違いを理解するところから始まります。検知から事後対応までの流れを標準化し、人数に応じた役割分担で初動を支えたうえで、復旧後はなぜなぜ分析とポストモーテムで再発を断ちます。こうした一連の流れを、一つの体系として捉えることが大切です。
MTTRという指標で改善を定量化し、外部サービスを適切に組み合わせれば、限られたリソースでも安定した運用は実現できます。
本ガイドで全体像をつかんだら、自社が今もっとも強化したいテーマの個別記事へ進んでください。個別記事では、進め方と会社選び、費用、発注方法を詳しく解説しています。
最後に、障害を前提に備える文化を組織に根づかせ、トラブルに強いシステム運用を目指していきましょう。
実務で必要な論点を深掘りした関連記事も、テーマ別に確認できます。
- ITシステム障害対応の進め方/やり方/流れや方法/手法/工程/手順
- ITシステム障害対応でおすすめの開発会社/ベンダー6選と選び方
- ITシステム障害対応の見積相場や費用/コスト/値段について
- ITシステム障害対応の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。