
ITシステムの障害対応は、異常を検知する監視、一次対応、原因調査、復旧、恒久対策が連なって成り立っています。
どの機能をどこまで備えるかが分かれば、見積もりの妥当性も見えてきます。障害対応・監視の全体像をまだ把握していない方は、まずITシステム障害対応の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム障害対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
異常を検知する監視機能
障害対応の起点になるのは、異常を早く正確に見つける監視機能です。検知が遅れると、復旧スキルがどれだけ高くても被害は広がってしまいます。
監視は、何を見るかによって種類が分かれ、種類ごとに障害対応での役割が異なります。まずは構成要素を押さえておくと、必要な機能に過不足がないかを見極めやすくなります。
死活監視・リソース監視・性能監視の役割分担
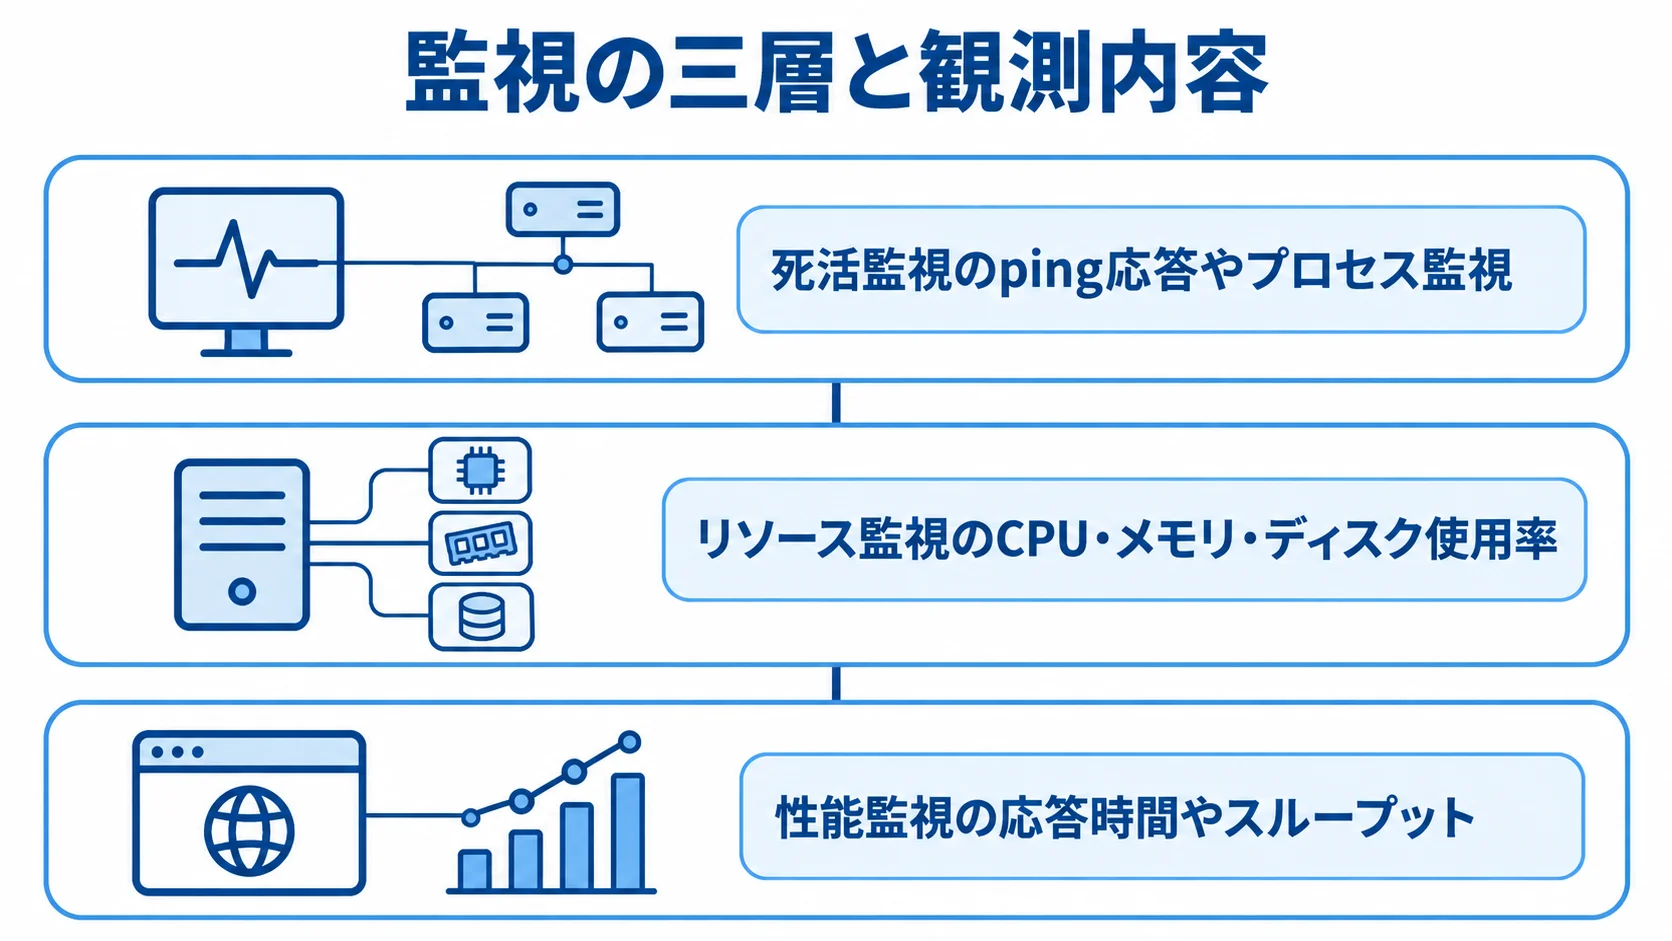
監視の基本は、死活・リソース・性能の三層です。それぞれが見る対象と役割を分けて持ちます。
- 死活監視:ping応答やプロセス監視で、サーバーやサービスが動いているかを見ます。
- リソース監視:CPU・メモリ・ディスク使用率を計測し、枯渇による障害を防ぎます。
- 性能監視:応答時間やスループットから、動いていても遅い状態を捉えます。
三つは役割が違うため、組み合わせて初めて障害の全体像が見えてきます。
監視ツールの選択肢は、OSSでライセンス無料のZabbixを自社で構築する方法と、Datadog・New Relic・Mackerelといったクラウド型を従量課金で使う方法です。Zabbixは初期費用を抑えられる一方で、構築と維持に工数がかかります。クラウド型は、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万円から数十万円が目安です。
サービス会社の料金例では、サーバー監視が1台あたり月5,000円という水準もあります。また、どのツールを選ぶにせよ、予兆から発生までを切れ目なく捉えるには三層をそろえておく必要があります。
ログ監視と外形監視の機能
ログ監視は、アプリやサーバーが出力するログからエラーや異常なパターンを検出し、死活監視では捉えられない「アプリ内部で起きている不具合」を見つけます。大量のログを人手で追うのは現実的でないため、特定のエラーメッセージや急増を自動で拾い、アラートに変換する仕組みが必要になります。SIEMと呼ばれる仕組み(Splunk Cloudなど)も、このログ監視を高度化したものです。
外形監視は、利用者と同じ経路でサービスに実際にアクセスし、「ユーザーから見て使えるか」を確認する機能です。ただし、サーバー単体は生きていても、経路の途中やクラウド基盤の問題でサービスが使えないことはあり得ます。内部の状態を見る監視と外から見た体験を見る監視をそろえることで、検知力は格段に高まります。「内部監視では緑なのに利用者は使えない」という見落としも防げます。
監視機能は、稼働率という数値目標を支える土台であり、どこまで手厚く備えるかは、SLAの稼働率から逆算して決めることが肝心です。たとえば稼働率99.9%を保証するなら、年間の許容停止は8.76時間、月では43.8分しかありません。この目標には、停止に気づくまでの時間を縮める監視が欠かせず、過剰な監視はコストの無駄に、過少な監視はSLA違反のリスクになります。
アラート対応と一次対応の機能
監視で異常を検知したら、それを適切な担当者に届けて初動を取る機能が必要です。これがアラート対応と一次対応にあたります。
検知と復旧の間をつなぐこの部分が弱いと、早く気づいても対応が始まらず、検知の価値が損なわれます。アラートの設計と一次対応の標準化は、障害対応の品質を左右する中核機能です。
アラートの優先度設計とノイズ抑制機能
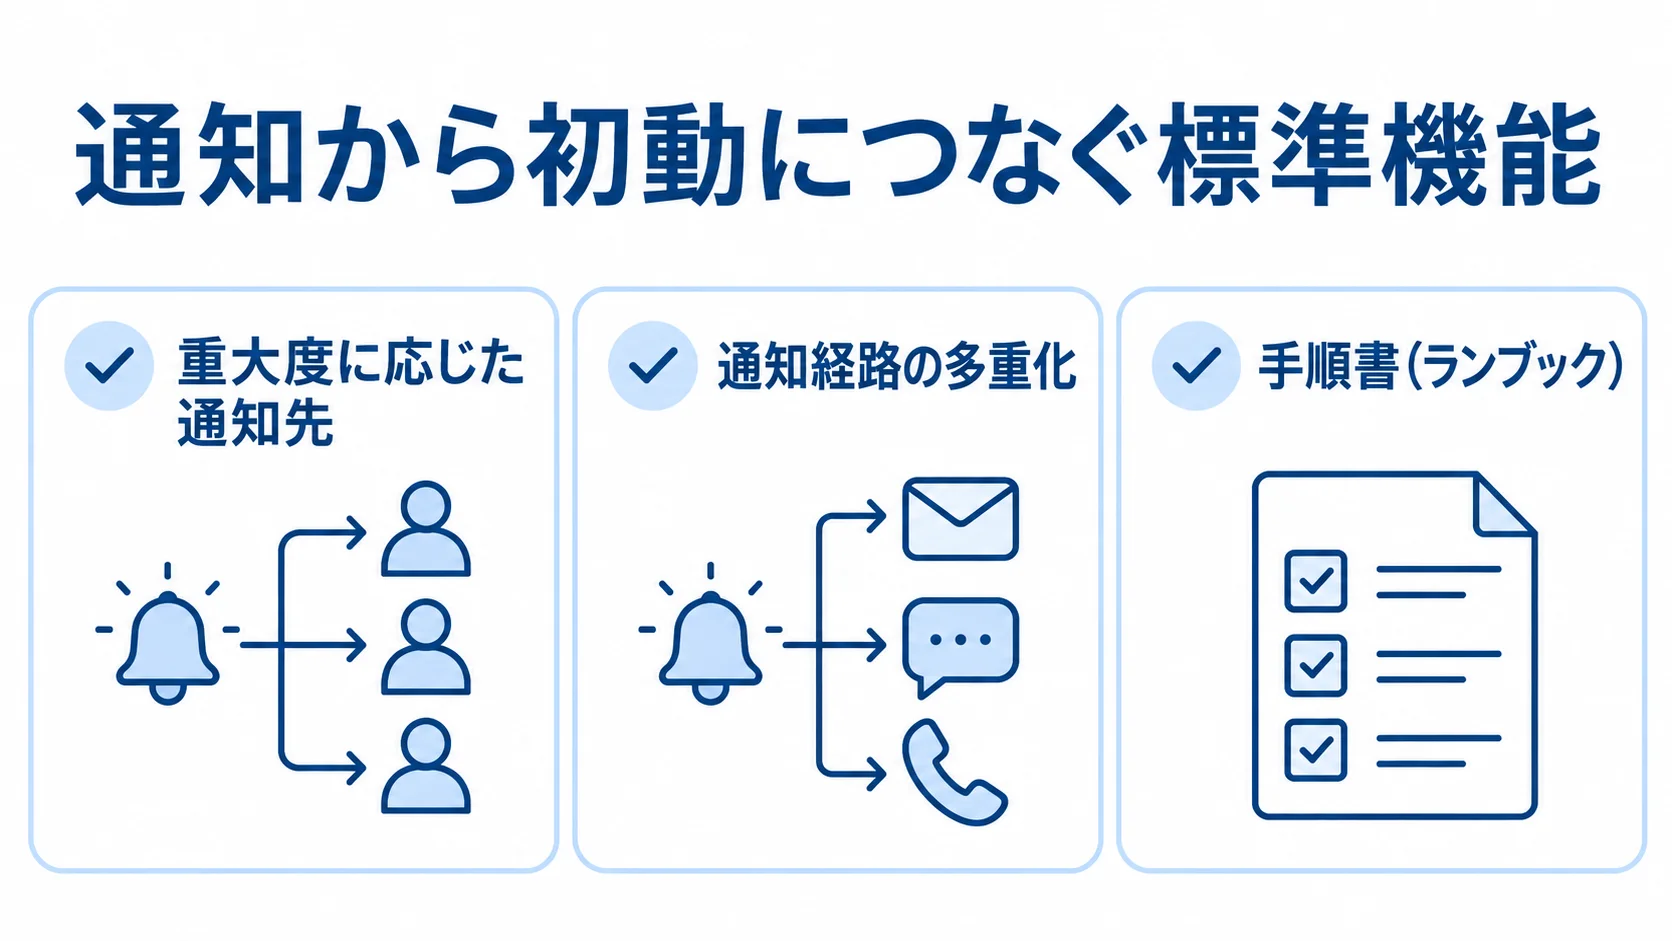
アラート対応で最初に設計すべきは優先度の切り分けで、すべての異常を同じ重みで通知すると、担当者は大量のアラートに埋もれ、本当に重要なものを見逃します。これはアラート疲れと呼ばれる典型的な失敗です。また、通知経路を多重化しておけば、誰も気づかないまま障害が放置される事態を大きく減らせます。
ノイズ抑制としては、重大度に応じて通知先を変え、軽微なものは定期報告にまとめる機能が求められます。メールは深夜に気づきにくいため、チャットツールへの通知や電話の自動架電、当番者を順に呼び出すオンコールを組み合わせれば、確実に誰かが対応に着手できます。たとえば、重大障害は電話やプッシュ通知で即座に知らせ、軽微なものはダッシュボードの確認で足りる、というメリハリが現場を守ります。
加えて、しきい値も重要で、CPU使用率が一瞬高まっただけでアラートが鳴るようでは誤検知が多く、逆に緩すぎると本当の障害を見逃します。一定時間継続したときだけ通知する、複数の指標を組み合わせて判定するといった工夫で、誤報と見逃しのバランスを取ります。アラート対応の質は、何を通知するかと同じくらい「何を通知しないか」で決まります。
一次対応・暫定復旧を標準化する機能
一次対応は、被害を食い止める応急処置で、再起動や一時増強、問題のあるノードの切り離しといった暫定復旧を決められた手順で素早く行います。さらに、障害の種類ごとに手順書(ランブック)を整えると、経験の浅い担当者でも一定品質の初動が取れ、属人化を防げます。暫定復旧で時間を稼ぎ、その間に根本原因の調査へつなぐ受け渡しが、障害対応全体のスピードを決めます。
一次対応には、SLAで定められた応答時間を守る側面もあります。たとえば、Cloud Naviは重大インシデントに15分以内の一次対応を保証し、シーズホスティングは検知から60分以内の通知を掲げています。また、官公庁の仕様例では1時間以内に現地到着・対処開始というルールもあり、一次対応とは、こうした初動の時間目標を組織として守る仕組みそのものです。
一次対応を委託すると、費用は対応時間帯で変わり、営業時間内なら月3万〜8万円、24時間体制の緊急対応なら月10万〜20万円が一つの目安です。一方、スポットで1件だけ依頼するなら、1件3万〜10万円という料金体系もあります。時間帯のカバーを広げるほど費用は段階的に上がるため、業務時間や障害の起きやすい時間帯を踏まえて、必要な時間帯だけを選ぶと費用を抑えられます。
原因調査と復旧の機能
暫定復旧で時間を稼いだら、次は障害の根本原因を突き止めて、恒久的に直す機能が動きます。原因調査と恒久復旧は、障害対応の中でももっとも技術的な専門性が求められる領域です。
ここを疎かにすると、同じ障害が何度も再発し、対応コストが次第に膨らみます。原因にたどり着けるかどうかが、障害対応サービスの実力を測る指標になります。
ログとメトリクスから原因を特定する機能
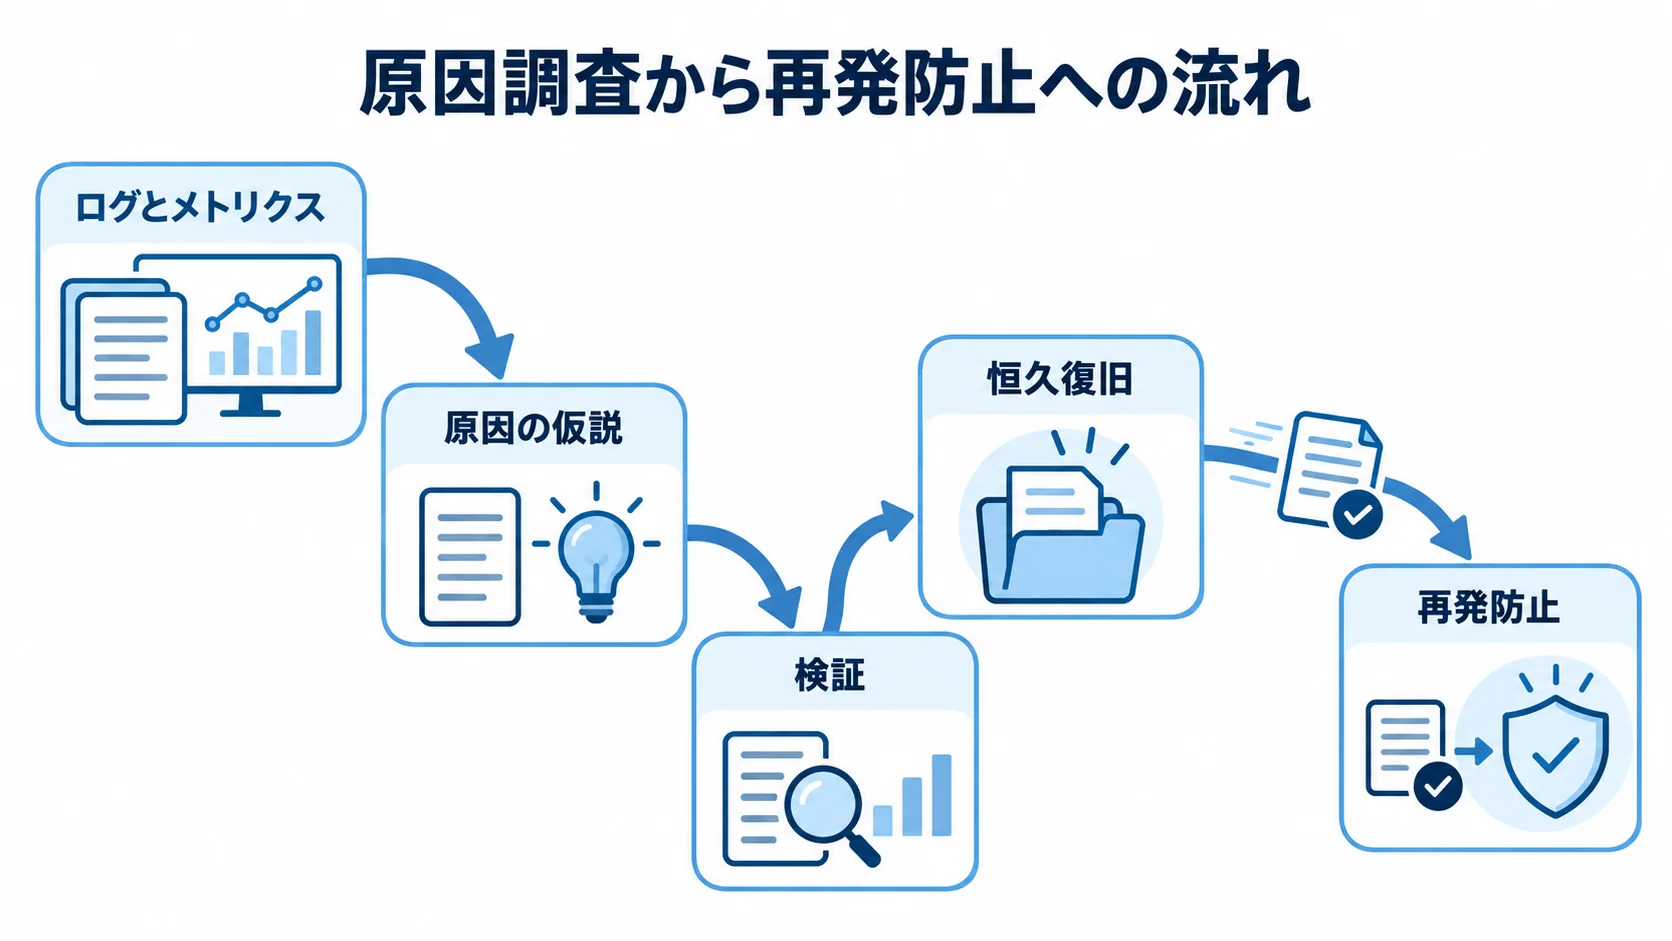
原因調査は、監視で蓄積したログとメトリクスを突き合わせ、障害発生時に何が起きていたかを再構成することから始まります。いつから異常な値が出始めたか、どの変更やデプロイの直後だったか、どのコンポーネントが最初に異常になったかを時系列で追い、原因の仮説を立てて検証します。この調査を支えるのが、監視機能で集めた十分な粒度のデータです。
逆に、監視が貧弱だと、いざ障害が起きても「証拠」がなく、原因究明が手探りになります。また、原因調査を担う人材は、監視オペレーターよりも高度なスキルが求められ、人月単価でいえば運用設計・インシデント分析クラスで80万〜120万円が目安です。
そのため、この専門性をすべて内製で抱えるのは中小企業には重く、原因調査だけを外部の専門家に依頼する形も現実的です。暫定復旧で終わらせず、根本原因まで必ず掘り下げる機能を組織として持つことが求められます。原因が分からないまま再起動でしのぐ運用は、いつか大きな障害として跳ね返ってきます。
恒久復旧と再発防止を担う機能
原因が特定できたら、恒久復旧の機能が動きます。バグなら修正パッチを当て、設定ミスなら構成を正し、容量不足ならリソースを増強するといった根本対策を施します。計画的に進めるには、検証環境で再現とテストを行ってから本番に反映する手順が欠かせません。
一般的な目標として、重大障害は2時間以内に対応を開始し、完全解決まで24時間以内とする例があり、恒久復旧はこの完全解決を担います。恒久復旧とセットの再発防止では、振り返り(ポストモーテム)を行い、しきい値や手順書、構成を見直して同種の障害を防ぎます。原因調査・恒久復旧・再発防止がそろって初めて完結し、「その場しのぎ」から「組織の学習」へ変わります。
再発防止には、障害ごとに記録を残し、過去の事例を組織の資産として蓄積する仕組みも欠かせません。同じ症状が出たときに過去の対応と原因をすぐ参照できれば、二度目以降の復旧は劇的に速くなります。これはインシデント管理と呼ばれ、検知から復旧、振り返りまでを一連の記録として残す機能で、記録が積み上がるほど新しい担当者も知見を引き継げ、原因調査と恒久復旧の価値は何倍にも高まります。
自動化とAIOpsによる検知・対応の機能
障害対応の機能を一段引き上げるのが、自動化とAIOps(AIを活用した運用)です。人手による監視と対応には限界があり、特に大量のメトリクスやログを扱う環境では、人が見きれない兆候をAIが拾う価値が高まります。
一方で、中小企業がいきなり大規模なAIOpsを導入するより、段階的に取り入れる発想のほうが合っています。
自動復旧とランブック自動化の機能
自動化の入り口としてわかりやすいのが、定型的な一次対応の自動実行です。たとえば、特定のプロセスが落ちたら自動で再起動する、ディスクが逼迫したら一時ファイルを自動で削除するといった処理を仕組み化すれば、夜間でも人を起こさずに軽微な障害を収束できます。これはランブックの自動化と呼ばれ、手順書として整理された初動をスクリプトやツールに置き換えるアプローチです。
まず再現性の高い定型対応から自動化するのが、堅実な進め方です。自動化は、夜間対応の負担を減らすだけでなく、人手を介さないぶん対応が速く、深夜でも数秒で復旧が始まるため、ダウンタイムそのものが短くなります。
ただし、自動化は「想定どおりの障害」にしか効かない点に注意が必要です。想定外の障害まで自動で触らせると、かえって状況を悪化させることがあります。自動化する範囲と、人が判断すべき範囲の線引きを明確にしておくことが、自動復旧機能を安全に使う前提になります。
AIOpsを中小企業がスモールスタートする機能
AIOpsは、異常の統計的な検知、アラートの関連づけによる原因の絞り込み、過去の障害パターンからの影響予測といった機能を備えます。これらは大企業向けに語られがちですが、JUASの調査ではAI活用の約78%が検討中・未検討で、中小企業にとっては取り組む余地が大きい領域です。だからこそ、まず一つの課題に絞って試すスモールスタートが現実的です。
たとえば、クラウド型監視ツールの異常検知機能だけを先に使う、アラートの関連づけだけを試すといった部分導入なら、既存のレガシーな運用を維持しながら低コストで効果を確かめられます。重要なのは、AIOpsを「魔法の自動化」と捉えず、人の判断を補助する機能として位置づけることです。検知の精度が上がり原因の当たりが早くつくようになれば、障害対応のスピードは確実に向上します。
AIOpsの導入を稟議に通すには、人手とダウンタイムの削減を金額に換算し、「浮く人件費」と「減る損失」の両面から投資の回収を数字で示すことが有効です。具体的には、人が常時見張っていた監視業務をAIの異常検知に任せれば、その人月分の人件費が浮きます。さらに、検知が早まりダウンタイムが縮めば、停止1分あたり5,600米ドルというGartnerの試算で損失削減額を示せます。
まとめ
ここまで見てきたとおり、ITシステム障害対応は、異常を捉える監視から、初動を取るアラート対応と一次対応、根本を突き止める原因調査と恒久復旧、負担を減らす自動化・AIOpsまで、複数の機能が連なって成立します。それぞれの機能は、SLAの応答・復旧目標を組織として守るために連携しています。
監視は三層にログ監視と外形監視を加えて検知力を高め、アラートは優先度設計とノイズ抑制で現場を守ります。一次対応は手順書で属人化を防ぎ、原因調査は監視で集めたデータをもとに再発を断ちます。
障害対応サービスを選ぶときは、どの機能をどこまでカバーしているかを一つずつ洗い出すのが、見積もりの妥当性を見抜くうえで有効です。具体的には、監視だけか、一次対応まで含むか、原因調査と恒久復旧まで踏み込むかを確かめます。自社に足りない機能を見極めて補うことが、無駄のない障害対応体制につながります。
riplaはフルスクラッチ受託と国内開発を組み合わせ、システムを作った後も監視・障害対応の各機能を一気通貫で支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。