
ITシステムの障害対応を外部に委託するなら、RFP(提案依頼書)や要件定義書に、何を・どこまで・どの品質で対応してほしいかを書き起こします。
ここが曖昧だと提案を比べられず、契約後の追加費用や対応範囲のトラブルにつながります。まだ全体像をつかめていない方は、ITシステム障害対応の完全ガイドを先にお読みください。
▼全体ガイドの記事
・ITシステム障害対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視項目と閾値の要件定義
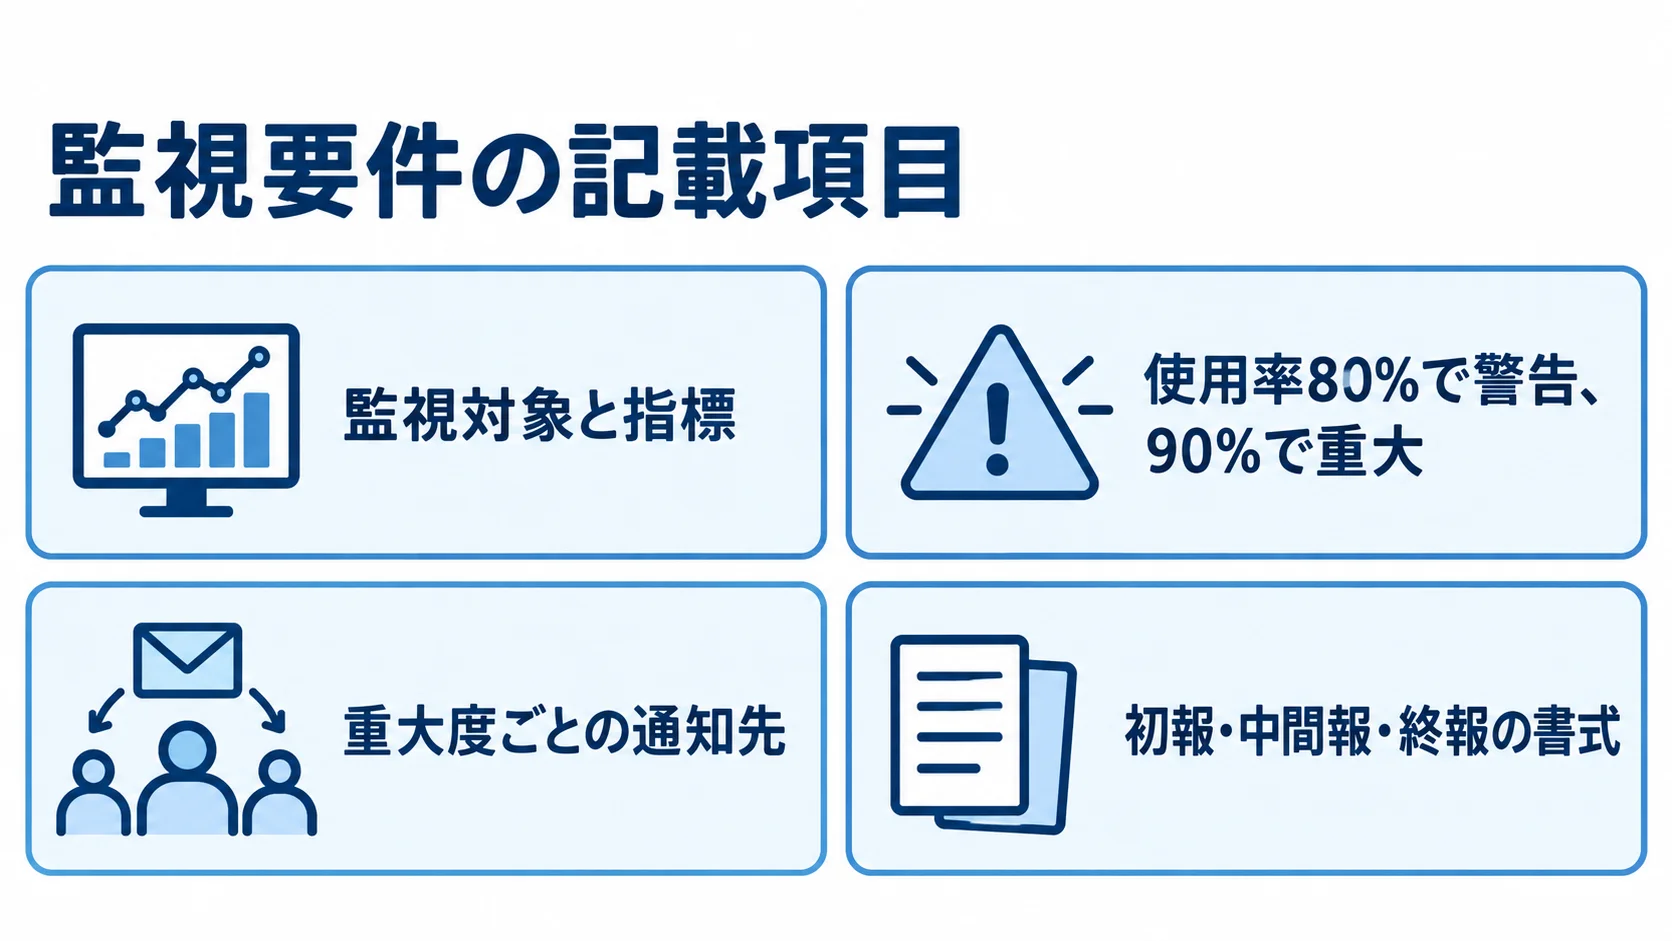
RFPで最初に固めるべきは、「何を、どの閾値で監視するか」という監視項目の要件です。「サーバーを監視してください」とだけ書くと、ベンダーごとに想定する監視の粒度がばらつき、見積もりも品質も揃いません。そこで、監視の対象と指標、閾値、監視間隔まで具体的に書き下しておくと、各社が同じ前提で提案でき、比較が成り立ちます。
監視対象・指標・閾値の具体化
監視項目の要件は、対象ごとに表形式で整理すると漏れがなくなります。この粒度まで書けば、ベンダーは必要な監視ツールの構成や工数を正確に見積もれます。
閾値は、過去の障害の振り返りをもとに決めます。これまでどんな指標がどの水準に達したときに障害が起きたかを洗い出し、その手前で警告が出るように閾値を逆算します。
閾値の根拠が示せると、ベンダーとの認識合わせも円滑になります。要件定義の段階で「なぜこの閾値なのか」まで言語化しておけば、運用開始後に誤検知や見逃しが起きたときも、調整を論理的に進められます。監視項目の精度は、障害対応全体の精度を左右する出発点になります。
- 監視対象と指標:Webサーバーやデータベースなど対象ごとの死活、CPU・メモリ・ディスク使用率、応答時間、エラーログの発生
- 閾値:「使用率80%で警告、90%で重大」のように、重大度を分けた段階的な基準
通知・報告の要件と頻度
監視で異常を検知した後、誰に・どの経路で・どのくらいの速さで通知するかも、要件として明記すべき項目です。通知と報告の要件が曖昧だと、障害が起きても自社に連絡が来ない、あるいは経緯が分からない、という事態になります。コミュニケーションの要件は、後で揉めやすい論点です。
官公庁の仕様例では「1時間以内に内容と予想作業時間を報告」というルールが定められています。こうした初報のタイミングを要件に明示すれば、ベンダーは報告体制を込みで提案してくれます。
定期報告の頻度(月次レポートの有無や内容)も要件に含めておくと、運用の透明性を確保できます。反対に、報告がない委託は、何が起きているか分からないブラックボックスになりがちです。
月次の定期報告には、当月の障害件数と内訳、各障害のMTTR(平均復旧時間)、SLAの達成状況、リソース使用率の推移、改善提案といった項目を入れてもらうとよいでしょう。
定型レポートがあれば、情報システム部門は経営層に運用状況を説明しやすくなり、保守費が妥当であることも社内に示せます。
報告は委託の成果を見える形にし、次の改善へつなげるための要件として位置づけておきたいところです。
- 通知の経路:重大度ごとに通知先を分け、重大障害は電話で即時、軽微なものはメールやチャットで集約
- 報告の様式:障害発生時の初報・中間報・終報の書式
SLAの数値要件の設計
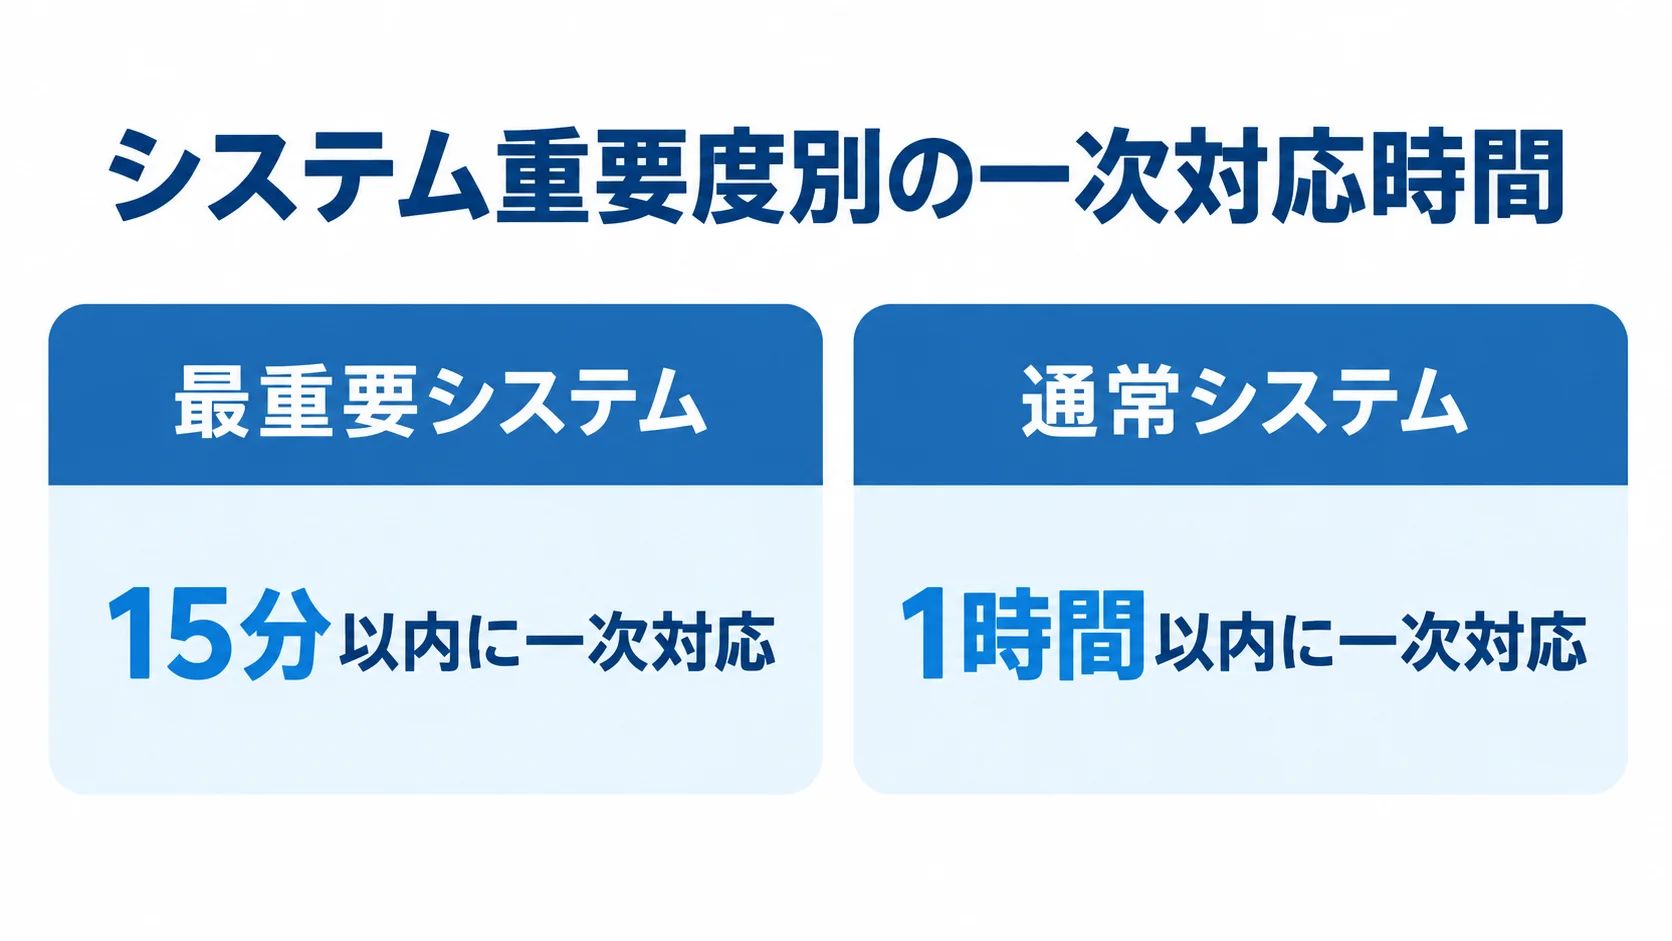
障害対応のRFPでもっとも重要なのが、SLA(サービス品質保証)の数値要件です。稼働率・初報応答時間・復旧目標時間という三つの数値を、感覚ではなく事業影響度から逆算して定めます。
障害対応の品質は、契約前にこの数値をどれだけ固めたかでほぼ決まると言っても過言ではありません。数値は費用に直結するため、過剰投資も過少投資も避けるには、要件として正確に固めることが鍵になります。
事業影響度から逆算する稼働率
稼働率を決めるときは、「9」の数が一つ増えるごとに許容停止時間が桁違いに縮むことを押さえておきたいところです。この差を実現するには、冗長構成や監視体制を一段強化する必要があり、運用コストは段階的に跳ね上がります。そのため、稼働率は、停止が事業にいくらの損失を与えるかから逆算して決めるべきです。
事業影響度の評価には、システムごとに「停止したときに止まる業務・売上・社会的信用」を点数化する方法が有効です。総務省2025年版の調査では、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失が生じるとされています。こうした損失額を基準にすると、どこまでの稼働率に投資する価値があるかが見えてきます。
たとえば、社内の業務システムで半日止まっても支障が小さいものに99.99%を求めるのは過剰投資です。要件定義では、システムを重要度で仕分け、それぞれに見合った稼働率を割り当てることが肝心です。
- 稼働率99.9%:年間8.76時間、月43.8分、日7.3分の停止が許容
- 稼働率99.99%:年52.6分、月4.38分、日4.4秒まで許容時間が縮小
初報応答時間と復旧目標時間の数値
稼働率と並んで定めるべきなのが、初報応答時間(障害連絡から最初の応答までの時間)と復旧目標時間です。
実在する基準を参考にすると、官公庁の仕様例では「1時間以内に現地到着・対処開始」「原則4時間以内に完全復旧」とされています。Cloud Naviでは重大インシデントに15分以内の一次対応を保証し、シーズホスティングでは検知から60分以内の通知と12時間での復旧を示しています。
一般的な目標としては、重大障害で2時間以内の対応開始、24時間以内の完全解決という例もあります。
これらの数値は、重大度のランク分けとセットで要件にすることが大切です。影響度に応じて応答と復旧の目標を変えるのが基本になります。
- 最重要システム:15分以内に一次対応、4時間以内に復旧
- 通常システム:1時間以内に一次対応、翌営業日までに復旧
すべてに最速の数値を求めると費用が跳ね上がるため、重大度によってメリハリをつけることが欠かせません。さらに、これらが「努力目標」なのか「保証」なのかも明記しておきます。
保証型は未達時にサービスクレジット等のペナルティが伴うため費用が上がる一方、実効性は高まります。数値と保証の有無をセットで要件に入れることが、SLA設計の核心です。
SLA未達時の取り扱いも、要件で踏み込んでおきたい論点です。保証型のSLAでは、未達時にサービスクレジット(料金の一部返金)が設定されることが一般的ですが、その算定方法や上限、間接損害が免責される範囲までは見落とされがちです。
「未達時のサービスクレジットの算定基準」「損害賠償の上限」「免責される損害の範囲」を要件で定めておけば、いざというときの認識齟齬を防げます。
SLAは品質の約束であると同時に、約束が守られなかったときの取り決めでもあります。守れたときと守れなかったときの両方を要件に含めることで、契約は実効性を持ちます。
クラウドの責任共有を前提にした範囲定義
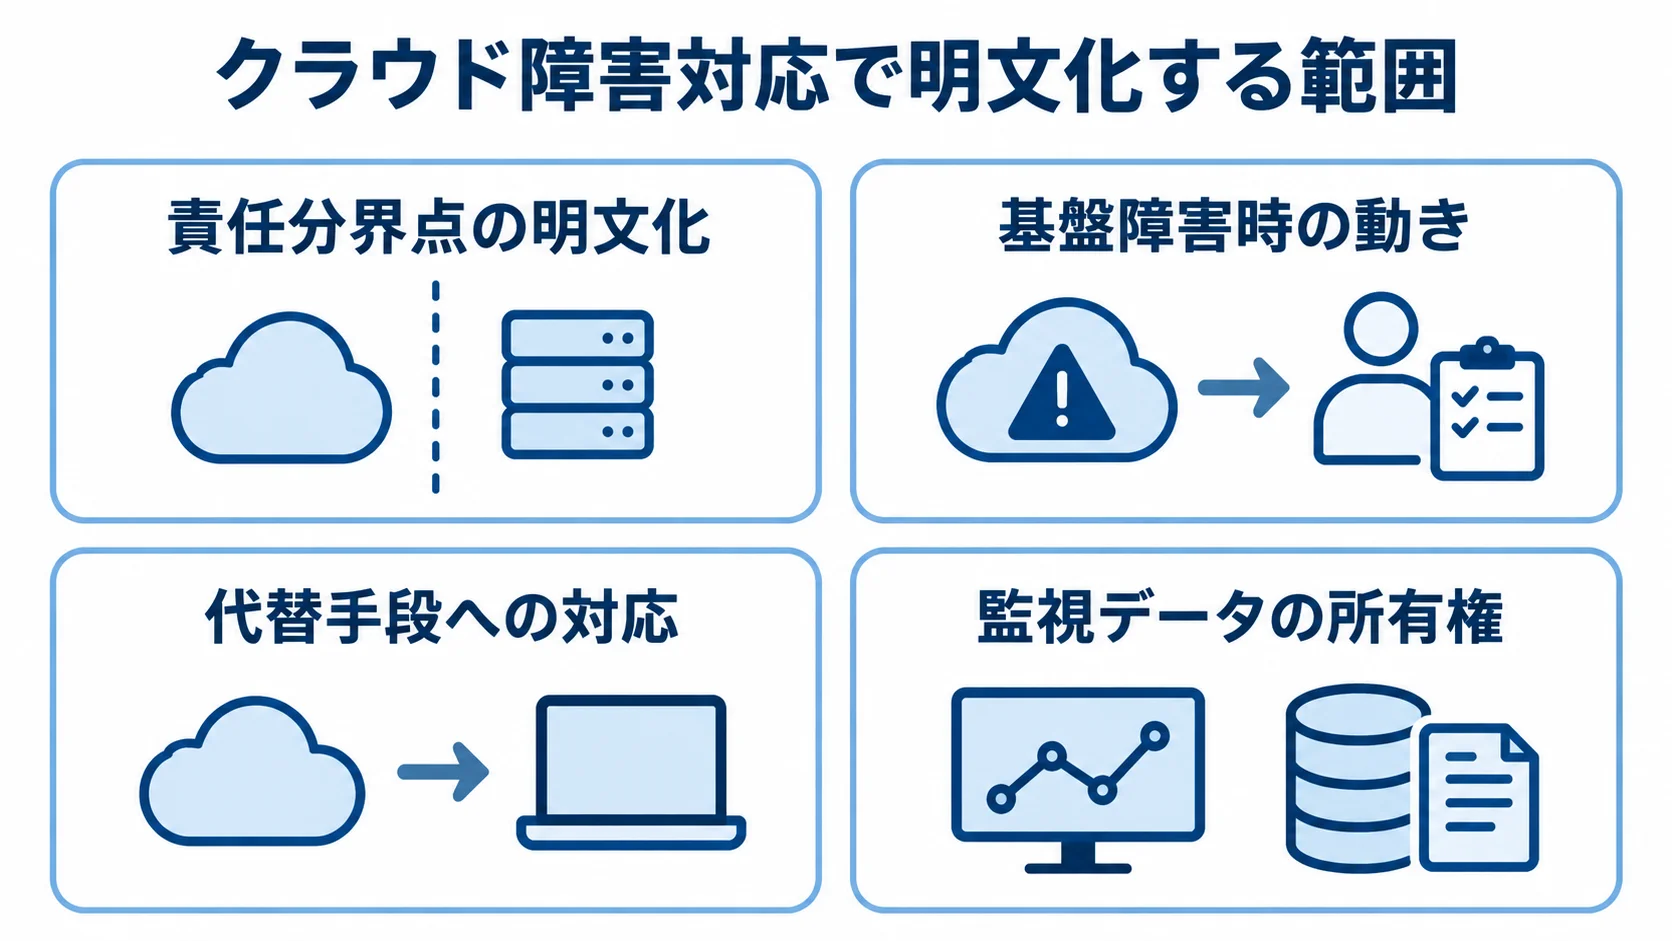
近年のシステムはクラウド上で動くことが多いため、要件定義では「どこまでが委託先の責任で、どこからがクラウド事業者の責任か」を明確にする必要があります。国内エンタープライズ・システム市場のクラウド比率は2022年で約5割(IDC Japan)に達しており、責任共有モデルを前提にしない要件定義は現実離れしています。
この線引きを曖昧にすると、いざ障害が起きたときに責任の押し付け合いが起きます。
責任分界点の明文化
クラウドの責任共有モデルでは、物理基盤やハイパーバイザーまではクラウド事業者が責任を持ち、その上にあるOSからデータまでは利用者側が責任を負います。層ごとに責任が分かれるため、要件定義では、委託先がどの層を監視・対応するのかを明文化します。
たとえば「OSより上のレイヤーの監視・障害対応は委託先が担う」といった形で、責任分界点をはっきりさせます。
クラウド基盤の障害は利用者側から手出しができず、補償もサービスクレジット止まりで実損はカバーされません。だからこそ、基盤障害が疑われる場合の委託先の動きまで要件に含める必要があります。委託先がブラックボックスの外側でできる対応を明確にすることが、クラウド時代の障害対応RFPの肝になります。
- 基盤障害時の動き:クラウド事業者のステータス確認と、自社への報告
- 代替手段への対応:切り替え支援まで範囲に含めるかの判断
監視ツールの選定基準と要件への記載
監視ツールをどうするかも、要件定義で方針を示しておくべき項目です。
OSSのZabbixはライセンスが無料ですが、構築と維持に工数がかかります。一方、Datadog・New Relic・Mackerelといったクラウド型は、ホスト数やメトリクス量に応じた従量課金で、中規模なら月数万円から数十万円が目安です。
要件では、「既存のツールを使うのか、委託先のツールに乗るのか」「ツールのライセンス費用は誰が負担するのか」を明確にします。これを曖昧にすると、後でツール費用が想定外の追加コストになります。
監視ツールは長く使う基盤なので、要件定義の段階で選定基準と費用負担を明確にしておくことが、後悔しない委託につながります。
- 技術スタックとの相性:クラウドネイティブな構成ならクラウド型監視、オンプレミス中心なら柔軟なOSSが適する場合もある
- ロックインの回避:将来の委託先の切り替えに備えて、特定ベンダー専用のツールに過度に依存しない構成
監視データの所有権も、要件で押さえておきたい論点です。委託先のツールで集めた監視ログやメトリクスが、契約終了後に自社へ引き渡されるのか、委託先のものとして消えてしまうのかは、後の運用に影響します。
過去の監視データは、原因調査や傾向分析に使える貴重な資産です。そのため、「監視データは自社に帰属し、契約終了時にエクスポートして引き渡す」といった条項を要件に含めておくと安心です。ツールそのものだけでなく、ツールが生み出すデータの扱いまで要件化することが、長期的な運用の自由度を守ります。
隠れコストを潰す対応範囲の要件
要件定義の最後の仕上げは、「基本料金に何が含まれ、何が追加費用になるか」を明確にすることです。ここが曖昧だと、契約後に「それは範囲外」「それはスポット対応で別料金」と次々に追加請求が発生し、当初の見積もりが意味をなさなくなります。隠れコストを契約前に潰しておくことが、要件定義の最大の防御策です。
基本料金の範囲内・範囲外の線引き
対応範囲の要件では、作業の一つひとつについて、基本料金に含むか追加費用かを明記します。
運用・監視の費用相場は月5万〜20万円が目安です。障害対応は、営業時間内なら月3万〜8万円、24時間緊急なら月10万〜20万円で、スポット1件は3万〜10万円が目安です。
あわせて、月あたりの工数上限を要件に含めることも有効です。基本料金に「月◯時間まで」という上限がある場合、それを超えた分の単価を事前に確認しておかないと、繁忙月に想定外の請求が来ます。
人月単価は、監視オペレーターで60万〜80万円、運用設計・インシデント分析で80万〜120万円が目安です。超過時の時間単価も、この水準から逆算できます。
範囲内・範囲外と超過単価を要件で固めておけば、安すぎる見積もりに潜む「範囲の狭さ」も見抜けます。
- 基本料金に含める例:月次の定常監視と営業時間内の一次対応
- スポット課金の例:深夜の緊急出動と原因調査の工数
安すぎる見積もりには、対応範囲が極端に狭い、SLAが努力目標止まりで保証がない、深夜の対応が含まれていない、といった落とし穴が潜んでいることが少なくありません。要件で範囲・SLA・時間帯を数値化しておけば、各社が同じ条件で見積もるため、極端に安い提案は「何かが抜けている」と判断できます。
逆に、要件が曖昧なまま金額だけで選ぶと、契約後に追加費用が積み上がり、結局は高くつくことになります。要件定義は、見積もりを比べるための基準を自社で作る作業です。
契約終了時の引き継ぎ要件
見落としがちですが、契約終了時の引き継ぎ要件も最初のRFPに入れておくべきです。委託先を将来切り替えるとき、引き渡しが滞れば、移行に多大な時間とコストがかかります。
要件として「解約予告期間」「ドキュメント・設定の引き渡し範囲」「移行支援の有無と費用」を定めておけば、特定ベンダーへのロックインを避けられます。
引き継ぎ要件を盛り込むことは、ベンダーに対する健全な牽制にもなります。出口が明確に設計されていれば、委託先も「囲い込み」ではなく品質で評価される前提に立ち、サービスの質を保ち続ける動機になります。
逆に、入口だけ決めて出口を決めない契約は、いざ不満が生じても乗り換えにくく、足元を見られかねません。要件定義は、契約の始まりだけでなく終わりまでを見据えて書くことで、長期的に主導権を握れます。
- 引き渡しの範囲:監視ツールの設定一式、障害対応の手順書、過去の障害履歴と対応記録、サーバーやアカウントのアクセス情報、構成図など
- 引き渡しの期限と形式:期限、形式、受け取る相手の明記
委託先が変わるたびにゼロから運用を作り直すのは大きな無駄なので、要件定義の段階で引き継ぎの作法を決めておくことが、長く付き合うほど効いてきます。
まとめ
ITシステム障害対応のRFPや要件定義書は、五つの柱で構成されます。中心になるのは、監視項目と閾値、SLAの数値要件、クラウドの責任分界点です。そこに、監視ツールの選定基準と、対応範囲や引き継ぎの明文化が加わります。
監視は対象・指標・閾値まで具体化し、SLAは稼働率・初報応答・復旧時間を事業影響度から逆算して数値で固めます。クラウドは責任共有を前提に、範囲を線引きします。
また、対応範囲は基本料金と追加費用の境界を、一次データの相場とともに明記します。これらを数値で固めると、各社の見積もりが同じ前提で比較でき、安すぎる見積もりの落とし穴も見抜けるようになります。
要件定義の良し悪しは、契約後の障害対応の品質とコストをほぼ決定づけます。曖昧な一行が、後の追加請求や責任の押し付け合いにつながります。逆に、数値と範囲を丁寧に固めたRFPは、ベンダーとの認識齟齬を防ぎ、長期的な主導権を握る助けになります。
riplaはフルスクラッチ受託と国内開発を組み合わせ、システムを作った後の監視・障害対応の要件整理から運用までを一気通貫で支援します。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。