
ITシステム障害復旧の導入事例・成功事例では、夜間の火消し体制、ひとり情シスの外部委託、SLAの適正化、クラウド基盤障害への備えの4つから、復旧体制の作り方と効果が見えてきます。ITシステムの障害復旧を検討するなら、この4つを自社に当てはめて見比べるのが近道です。
取り上げるのは、導入・開発・活用・成功の事例に絞り、発注企業(情シス)の視点で読み解いたものです。全体像はITシステム障害復旧の完全ガイドで先に確認しておくと読みやすくなります。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
夜間障害の火消し体制を立て直した復旧事例
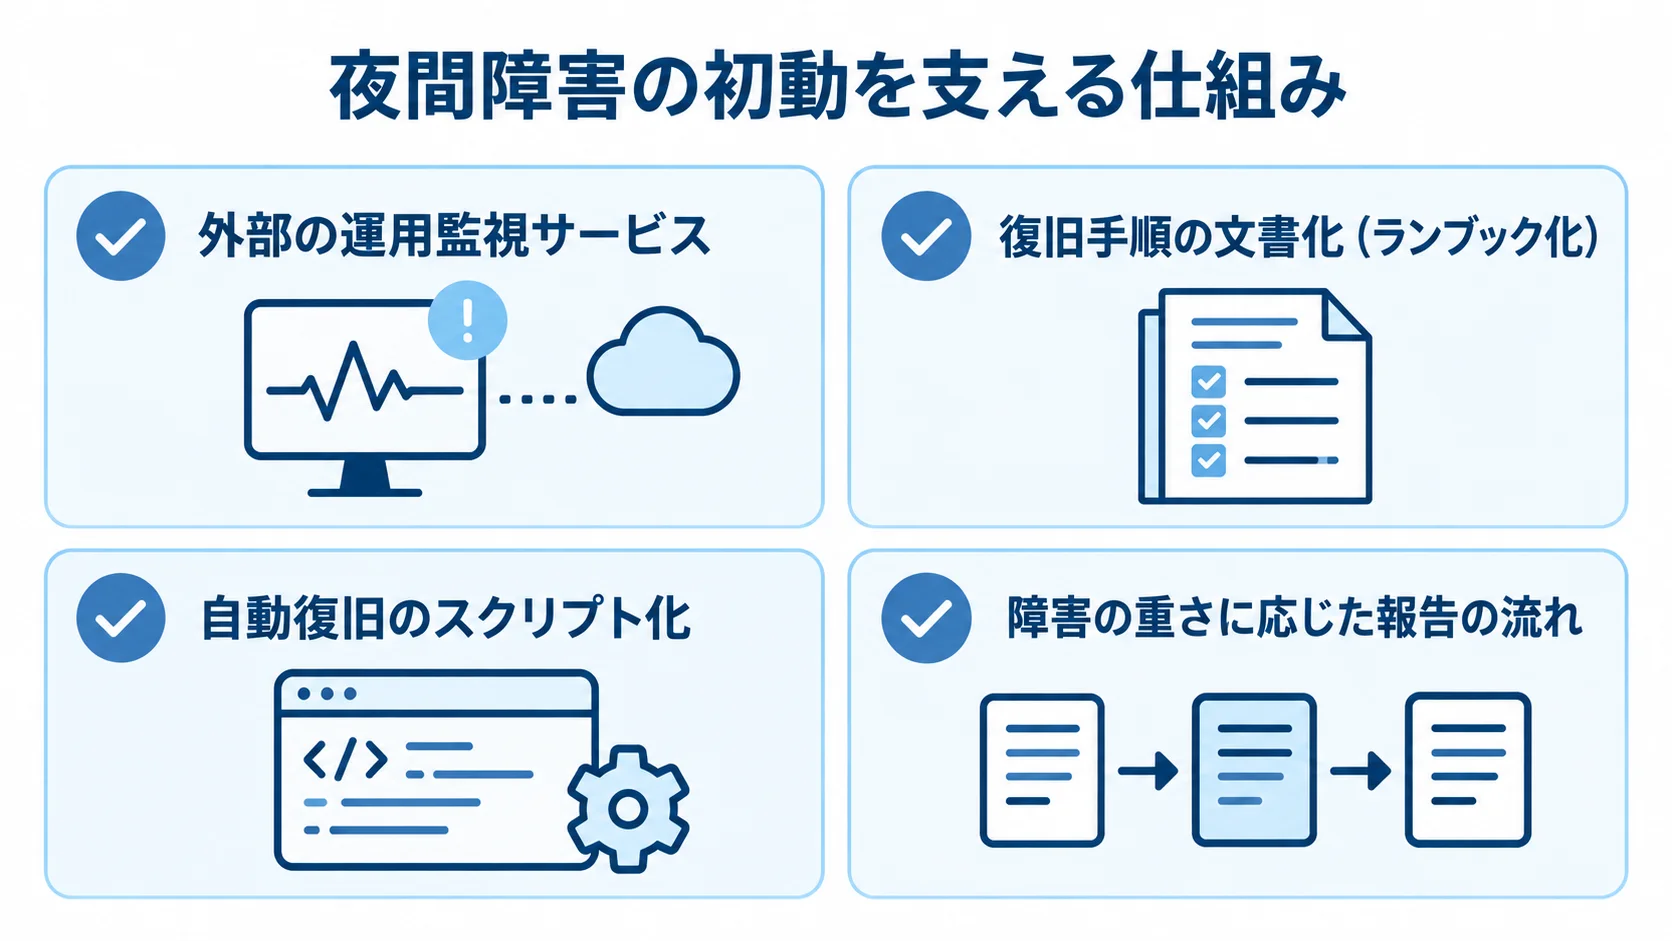
障害復旧の事例でもっとも切実なのは、夜間や休日に起きた障害をどう収束させるかという「火消し体制」の問題です。
平日の日中なら社内の担当者がそろっているため何とか対応できても、深夜にサーバーが落ちると、誰が気づき、誰が判断し、誰が手を動かすのかが定まらない企業は少なくありません。
ここでは、属人化していた夜間対応を仕組みに置き換え、復旧時間を大幅に短縮した事例を取り上げます。
属人化した深夜対応をMTTR短縮につなげた事例
ある中堅企業では、夜間にバッチ処理が異常終了するたびに、特定のベテラン担当者の携帯電話へ連絡が入っていました。その人が自宅からVPNで接続して手作業で復旧するという運用が、常態化していたのです。
この体制では、担当者が電話に出られない、体調を崩している、退職するといった事態が起きると、復旧そのものが止まってしまいます。
実際、検知から復旧までの平均時間(MTTR)は数時間単位に膨らみ、翌朝の業務開始に間に合わないこともありました。
この企業が取り組んだのは、夜間障害の一次対応を外部の運用監視サービスに委託し、復旧手順を文書化(ランブック化)することです。自動復旧できるものはスクリプト化し、誰が対応しても同じ初動が取れるようにしました。
その結果、検知から一次対応の開始までの時間が大幅に縮まりました。夜間のMTTR短縮と担当者の負担軽減を考えれば、十分に投資対効果が見込める事例です。
- 費用の目安:一次データでは、24時間の緊急障害対応を外部委託した場合の費用が月額10万〜20万円とされています
- 呼び出しの範囲:ベテラン担当者への深夜の呼び出しは、重大障害のときに限られるようになりました
エスカレーション経路を整備し報告遅延をなくした事例
夜間障害の立て直しでは、エスカレーション経路の整備も大きな柱でした。復旧作業そのものが進んでいても、経営層や業務部門への状況報告が遅れると、社内の混乱が広がることがあるためです。
この企業は、報告が遅れて社内が混乱しないよう、障害の重さに応じた報告の流れを決めておきました。
一次データでも、官公庁の保守仕様では「1時間以内に障害の内容と予想作業時間を報告する」といった初報の時間要件が定められている例があります。
事例企業も同様に、復旧の見込みが立たない段階でも「いつまでに次の報告をするか」だけは必ず伝えるルールにしました。
業務部門は「いつ復旧するのか分からない」という不安に陥りにくくなり、障害そのものより、報告が途絶えることで信頼を損なう事態を防げました。復旧体制は技術だけでなく、報告とエスカレーションの設計まで含めて初めて機能する、という点を示す事例です。
- 障害レベル:軽微・中・重大の三段階に分け、段階ごとに「誰が・何分以内に・誰に報告するか」を決める
- 重大障害の第一報:一次対応と並行して、情シス責任者から経営層へ入れる流れを固定する
ひとり情シスが復旧を外部委託で支えた事例
中小企業に多いのが、情報システム部門が実質一人という、いわゆる「ひとり情シス」の体制です。この状況では、その一人が休んだり退職したりした瞬間に、障害復旧の知見が会社から消えてしまいます。
ここでは、ひとり情シスが監視と障害復旧を外部に委託し、自社は重要な意思決定に集中できる体制へ移行した事例を取り上げます。
監視と一次復旧の委託で属人化リスクを解消した事例
この企業のひとり情シス担当者は、日中は社内の問い合わせ対応に追われ、夜間や休日もシステムに異常がないか気が休まらない状態が続いていました。
障害が起きれば、原因の調査から復旧まですべて一人で抱えることになります。その手順は本人の頭の中にしかなく、復旧スピードの問題であると同時に、事業継続の観点でも大きなリスクでした。
解決策として採用したのは、24時間365日の死活監視とリソース監視、そして一次復旧対応を運用監視サービスへ委託する形です。
委託によって、ひとり情シスは障害の一次切り分けから解放されました。復旧手順を委託先と共有したことで、属人化も解消されています。
- 料金の目安:相場は月額5万〜20万円。料金例はサーバー監視5,000円/台、障害対応10,000円/台、フルマネージド20,000円/台
- 委託の範囲:重要度の高いサーバーだけを部分委託で始め、効果を見ながら対象を広げる
復旧手順書を委託先と共有し再現性を高めた事例
外部委託を成功させた決め手は、「丸投げ」にしなかった点です。委託先に任せきりにせず、自社システムの構成図、過去の障害履歴、復旧手順書(ランブック)を整えて、委託先と共有しました。
これにより、どの担当者が対応しても同じ品質で初動が取れる再現性が確保されました。委託先が一次対応で復旧できる範囲と、自社のひとり情シスへ戻す範囲の線引きも、事前に明確にしていました。
この線引きが、外部委託の費用と復旧品質のバランスを左右します。基本料金に含まれる対応範囲を曖昧にしたまま契約すると、いざ障害が起きたときに「それは追加費用の作業です」と言われ、復旧が止まりかねません。
事例企業は、契約の段階で一次対応とスポット対応の境目を確認していました。
- スポット対応の費用:1件3万〜10万円が目安とされています
- 境目の確認:どこまでが一次対応で、どこからがスポット対応かを、契約時に文書で残す
過剰SLAを適正化し復旧コストを削減した事例
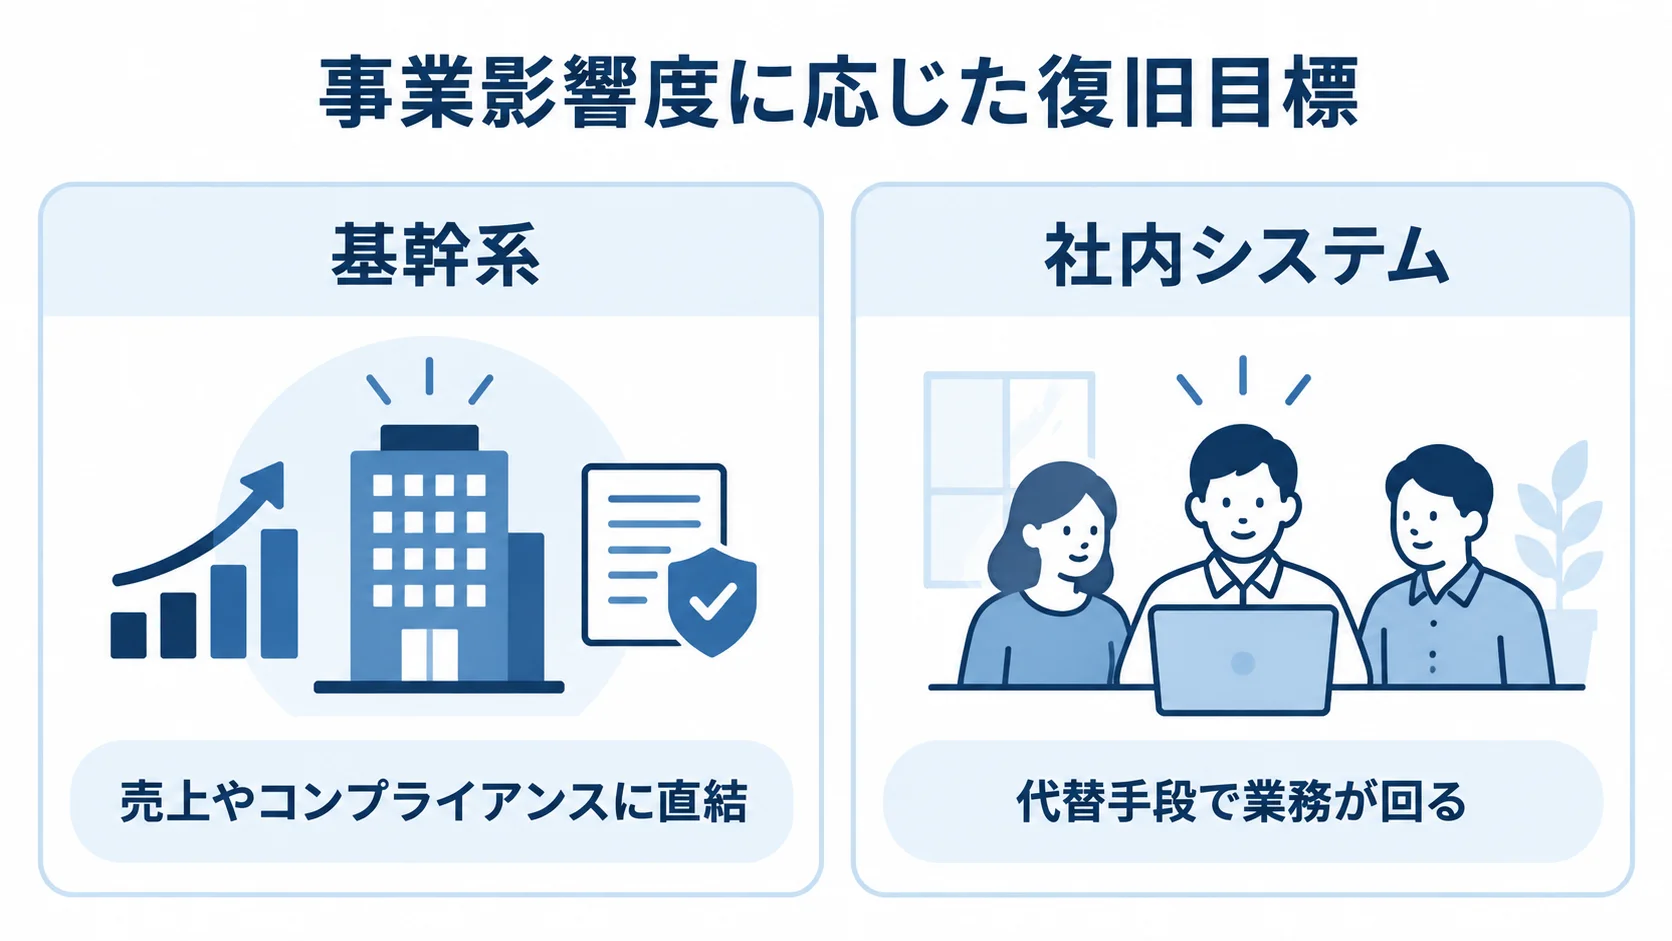
障害復旧の事例では、「とにかく早く、確実に復旧する体制を厚くする」方向だけでなく、「過剰になっていた復旧目標を適正化してコストを下げる」という逆方向の成功もあります。
すべてのシステムに最高水準の復旧時間を求める必要はありません。事業への影響度に応じてメリハリをつけることで、無駄な待機費を削減できます。ここでは、SLAの適正化でコストを削減した事例を取り上げます。
稼働率99.99%を見直して待機費を削減した事例
ある企業では、社内向けの情報系システムにまで稼働率99.99%という高水準の復旧目標を設定し、相応の保守費用を払い続けていました。
一次データで比べると、稼働率99.9%の月あたり許容ダウンタイムは43.8分です。これに対し99.99%は月4.38分と、桁違いに短くなります。
さらに、「9」が一つ増えるごとに運用コストは段階的に跳ね上がります。社内向けで多少の停止が許容できるシステムにまで99.99%を求めるのは、明らかに過剰でした。
この企業は、システムを事業影響度でランク分けし、目標の高さを分けることにしました。
結果として、過剰だった待機費・監視費を削減し、その分を本当に止められない基幹系の復旧体制強化へ振り向けられました。復旧力を一律に高めるのではなく、影響度に応じて配分し直す発想の転換が成果につながった事例です。
- 目標を高く保つ系:売上やコンプライアンスに直結する基幹系
- 目標を緩和する系:停止しても代替手段で業務が回る社内システム
削減分を基幹系の復旧投資へ振り替えた事例
SLA適正化で見落としてはいけないのが、社内の調整です。復旧目標を下げる話は、業務部門からすると「うちのシステムは軽視されるのか」と受け取られかねません。
事例企業は、情シスが各システムの事業影響度を洗い出し、業務部門と合意形成を図りました。
裏づけとして、総務省の2025年版資料には、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失という統計があります。こうした数値は、影響度の議論を客観的にするのに役立ちます。
影響度を金額で示したことで、業務部門も「この社内システムは止まっても直接の損失は小さい」と納得し、復旧目標の緩和に合意できました。
削減できた費用は、止まれば1,200万円規模の損失が出かねない基幹系の冗長化やバックアップ復旧体制へ振り替えられました。障害復旧の投資は、闇雲に厚くするのではなく、影響度に応じて配分し直すことで全体の事業継続性を高められる、という好例です。
コストを「守りの一律支出」から「攻めのメリハリ投資」へ変えた点が、この事例の本質です。
- 影響度の測り方:停止1時間あたりの機会損失を、システムごとに金額で示す
- 削減分の行き先:基幹系の冗長化やバックアップ復旧体制
充填型保守で待機費を改善開発に転換した事例
SLA適正化と並行して、この企業がもう一つ取り組んだのが、保守費を投資に変える工夫です。
障害が起きない月の待機費は、経営層からは「何もしていないのにお金を払っている」ように映りがちで、毎年の予算交渉で削減圧力にさらされていました。
情シスとしては、いざというときの備えは残したい一方で、平常月の費用をどう説明するかに苦慮していました。この板挟みが、障害復旧の予算を毎年不安定にしていたのです。
この企業は、障害対応の余剰工数を新機能開発や改善作業へ振り替える、充填型保守の契約モデルを採用しました。
障害がない月は、確保した工数で改善や小さな機能追加を進めます。待機費が「使われない保険料」から「システムを育てる投資」に変わったことで、経営層への説明も「障害に備えつつ、平常月もシステムを進化させている」という前向きなものになりました。
riplaも、フルスクラッチ受託と国内運用保守の立場から、この余剰工数を改善開発に充てる伴走型を重視しています。障害復旧を単なるコストで終わらせない契約設計が、長期的な費用対効果を高める鍵だと考えています。
- 工数の使い道:障害対応に備えた工数を、平常月の改善に充てる
- 契約の型:障害時の備えと改善開発を一つの保守契約にまとめる
クラウド基盤障害に自衛策で備えた復旧事例
近年の障害復旧事例で増えているのが、クラウド基盤そのものの障害に巻き込まれるケースです。
国内エンタープライズ・システム市場のクラウド比率は2022年で約5割(IDC Japan)に達し、多くの企業がクラウド上でシステムを動かしています。
便利な一方で、基盤側の障害はユーザーが手を出せず、復旧を待つしかないという「監視のブラックボックス化」が新たな課題になっています。
マルチリージョン化で基盤障害からの復旧を実現した事例
あるEC事業者は、過去にクラウドの特定リージョンで大規模障害が起きた際、自社サービスが数時間にわたって停止しました。復旧はクラウド事業者に委ねるしかありませんでした。
サービスクレジット(利用料の一部返金)は受けられたものの、停止中の売上機会損失をまったく補うものではありませんでした。
この経験から同社は、基盤障害でも自社で復旧を主導できるよう、自衛策としてアーキテクチャを見直すことを決断しました。
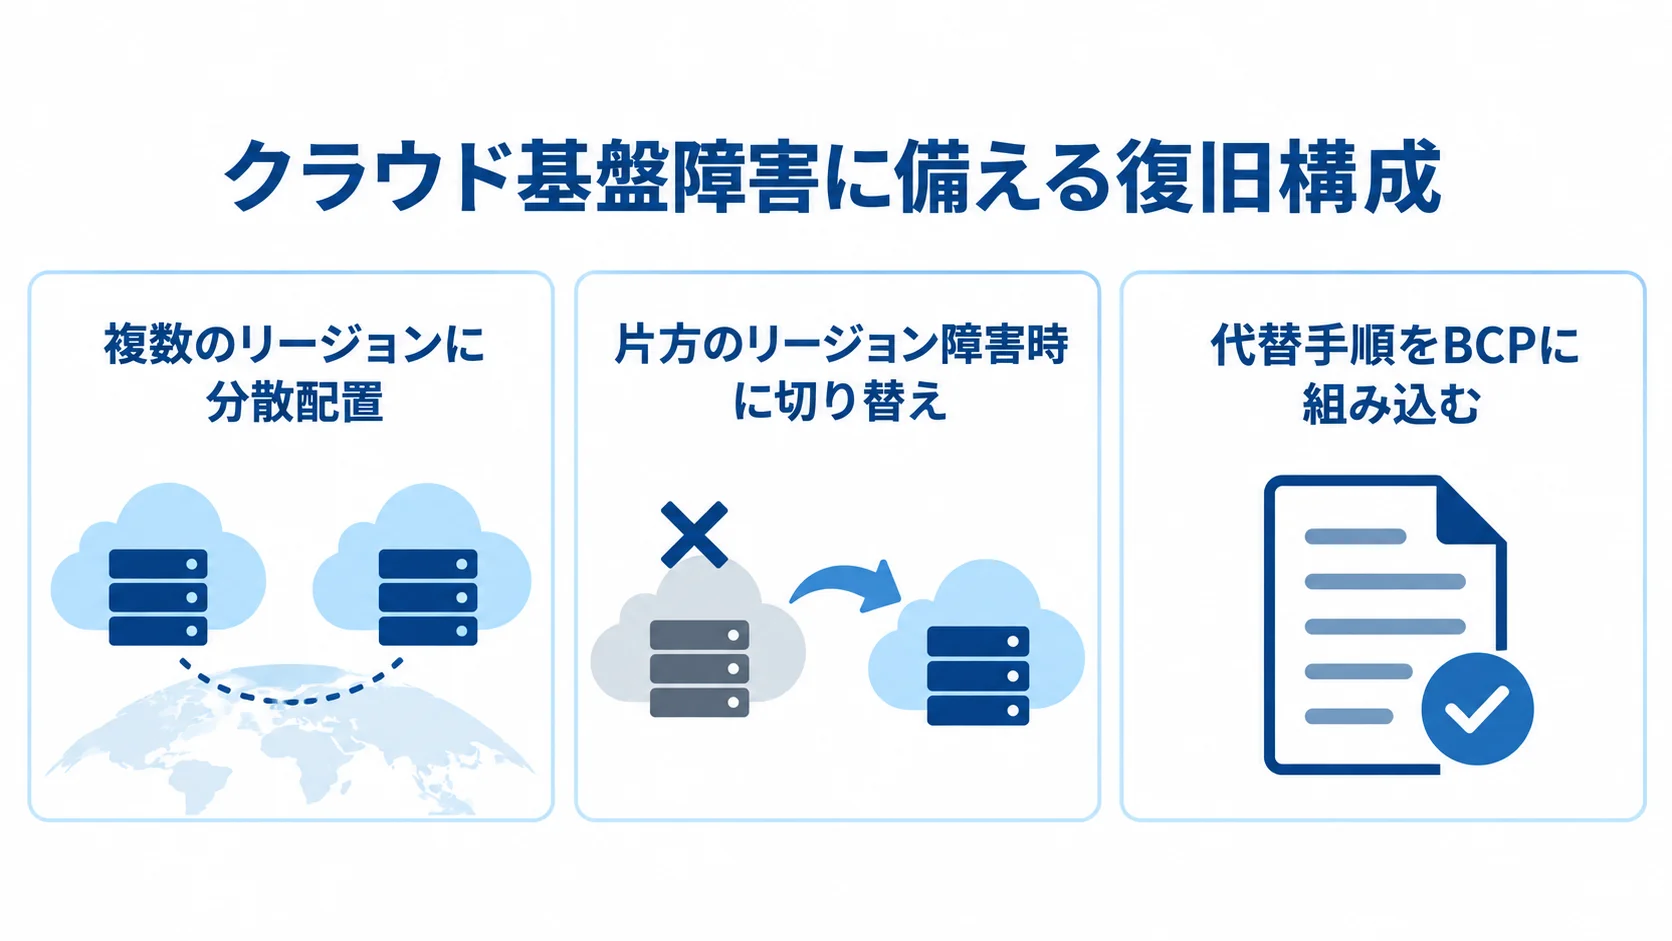
具体的には、重要なシステムを複数のリージョンに分散配置(マルチリージョン化)し、片方のリージョンが障害でダウンしても、もう片方へ切り替えてサービスを継続できる構成に変えました。これにより、基盤障害そのものは防げなくても、その影響からの復旧を自社の判断で行えるようになりました。
EC系では5分以上の停止が1回あたり平均1,200万円の損失につながるという統計を踏まえると、冗長構成の追加コストは、十分に回収可能な保険だったと言えます。
- 切り替えの方式:重要なシステムを複数リージョンに分け、片方の障害時にもう片方で継続する
- コストの位置づけ:冗長構成の追加費用を、停止時の損失に備える保険として捉える
BCPと連動した初動で混乱を防いだ事例
この事業者がもう一つ整えたのが、事業継続計画(BCP)と連動した障害時の初動です。
クラウド基盤障害のように自社で復旧を急げない状況では、「いつまでに復旧しなければ、ビジネスにどんな影響が出るか」を事前に定義しておく必要があります。
発注側は、復旧の見込みが立たない場合に代替運用へ切り替える判断基準も、あらかじめ決めておくことが欠かせません。
事例企業は、代替手順をBCPに組み込みました。
この準備があったため、次にクラウド基盤の障害に直面した際も、現場はパニックにならず、復旧を待つ間も代替運用で最低限のビジネスを回せました。ベンダーやクラウド事業者に復旧を丸投げせず、発注者である情シス側が初動とBCPとの連動を主導したことが、損失を最小化した決め手です。
クラウド時代の障害復旧は、技術的な冗長化と、止まったときの事業判断の両方がそろってこそ機能する、という好例です。
- 代替手順の例:一定時間以上の停止が続く場合の手動受注への切り替え、顧客への告知ページの公開
- 発注者側の役割:ベンダー任せにせず、初動の主導権を自社が握る
まとめ
ITシステム障害復旧の事例を振り返ると、成功に共通するのは、復旧を属人化させず、影響度に応じてメリハリをつけ、発注者側が初動とエスカレーションを主導している点です。
夜間障害の火消し体制は、外部委託とランブック化でMTTRを縮められます。ひとり情シスも、監視と一次復旧を部分的に委託すれば属人化リスクを解消できます。
また、過剰なSLAは事業影響度を金額で示すことで適正化でき、削減分を基幹系へ振り向けられます。さらにクラウド時代には、マルチリージョン化とBCP連動の初動で、基盤障害からの復旧を自社で主導する備えが欠かせません。
事例を読むときに大切なのは、「どれだけ復旧体制にお金をかけたか」ではなく、「止まったときに事業をどう守れる設計になっているか」という視点です。
金融・医療・EC系で5分以上の停止1回あたり平均1,200万円とされる損失規模を、自社に当てはめてみてください。そのうえで、まずは止められないシステムの復旧手順を文書化し、一次対応の体制づくりから着手するとよいでしょう。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、作った後も伴走しながら、障害復旧を「コスト」ではなく「事業継続の投資」として設計する支援を一貫して行っています。
全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。