
ITシステム障害復旧は、サービスを早く戻す暫定復旧と、再発を防ぐ恒久対策を分けて考えることが出発点です。RTO・RPOという数値目標に基づいて、平時から手順と体制を整えておくことで、障害時の復旧スピードは大きく変わります。
- 復旧目標:RTO・RPOで、どの時点までに戻すかを決める数値目標
- 対応フロー:検知から暫定復旧、原因調査、恒久対策までの流れ
- 事前準備:監視、バックアップ、訓練を平時の運用に組み込む取り組み
業務システム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム障害復旧の全体像
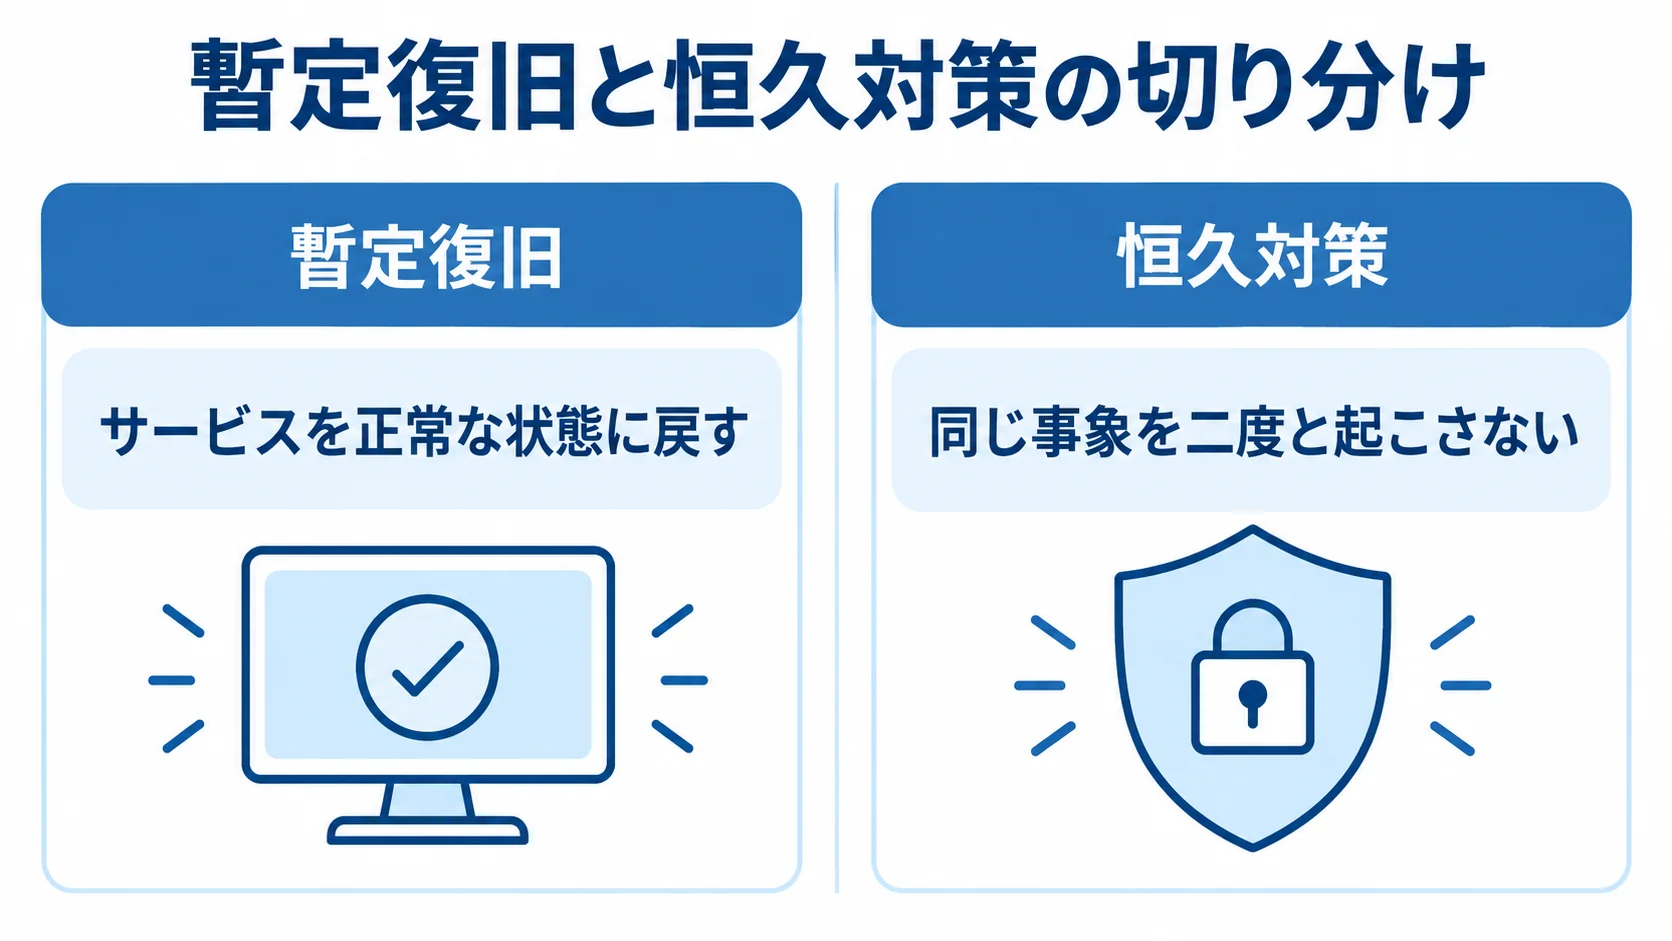
障害復旧を正しく理解するには、まず「インシデント管理」と「問題管理」の違い、そして「暫定復旧」と「恒久対策」の切り分けを押さえる必要があります。この2つを混同すると、目の前のサービス停止を解消することばかりに意識が向き、再発防止が後回しになってしまいます。
また、復旧は、システムを元に戻すだけでなく、事業継続計画(BCP)の一部として「どれだけ早く・どの時点まで戻すか」を設計する営みです。
復旧と原因究明の切り分け
障害が起きたときは、まず「サービスを正常な状態に戻すこと」を最優先します。その役目を担うのがインシデント管理で、原因が完全に分からなくても、予備系への切り替えやバックアップからのリストアで暫定的に復旧させます。暫定復旧の段階では、「正常に見えるが内部に不整合が残っている」状態に陥りやすいため、復旧後の整合性チェックも手順に組み込んでおきます。
一方、なぜ障害が起きたのかを突き止め、同じ事象を二度と起こさないようにする活動は、問題管理(障害管理)と呼ばれます。復旧とは時間軸も目的も異なります。
この切り分けが曖昧だと、原因調査に時間を取られて復旧が遅れることがあります。逆に、復旧だけで満足して根本対策が放置されることもあります。そのため、「まず止血、次に治療」という順序を組織で共有しておくことが、障害復旧の出発点です。
RTO・RPOによる復旧目標の数値化
障害復旧の設計で必ず出てくるのが、RTO(目標復旧時間)とRPO(目標復旧時点)という2つの指標です。RTOは「障害発生からどれだけの時間で復旧させるか」、RPOは「どの時点のデータまで戻せれば許容できるか」を表します。
たとえばRTOを2時間、RPOを15分と定めれば、2時間以内に復旧し、失われるデータは直近15分以内に抑える、という設計目標になります。この2つの数値は、業務の重要度に応じて決めるものです。
基幹システムや決済系のように、ダウンが直接損失につながる領域では、RTO・RPOを短く設定し、その分、冗長構成やリアルタイムバックアップにコストをかけます。反対に、影響の小さい社内ツールは目標を緩めてコストを抑えるという、メリハリが現実的です。RTO・RPOを曖昧にしたまま「とにかく早く」と求めると、過剰投資や不十分な備えにつながります。
▶ 詳細はこちら:ITシステム障害復旧の進め方|暫定復旧と恒久対策の切り分け
障害復旧の進め方と基本フロー
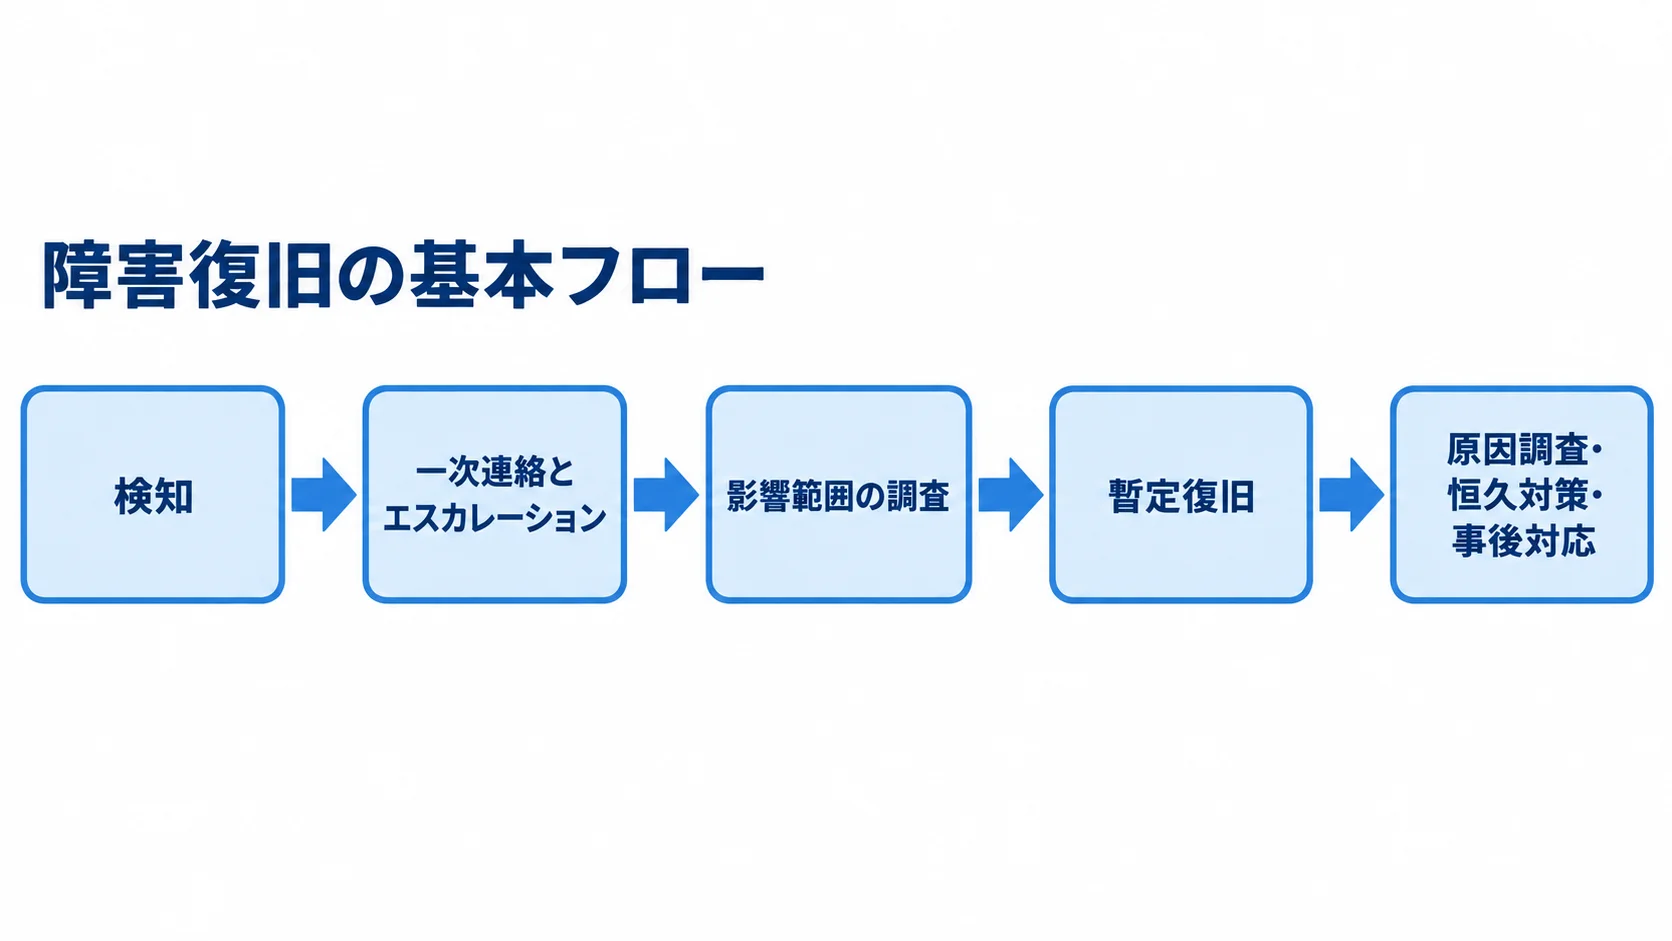
障害復旧には、定型的な流れがあります。検知から始まり、一次連絡とエスカレーション、影響範囲の調査を経て、暫定復旧に入ります。その後は、原因調査、恒久対策と進み、事後対応で締めくくります。
この流れを事前にマニュアル化し、関係者が同じ手順を共有しておくことが、混乱なく復旧を進める鍵になります。とくに連絡経路と役割分担が決まっていないと、初動で時間を浪費してしまいます。
初動と暫定復旧のステップ
障害を検知したら、まず影響範囲を確認し、関係者へ第一報を入れます。対応を迷わず進めるために、SLA(サービスレベル目標)を設けておくと役立ちます。たとえば、影響が極めて大きいCriticalな障害では、検知から15分以内の即時連絡と、1時間以内の復旧を目指す、といったSLAが考えられます。
一報の段階では原因が不明でも、「現在調査中」と明示し、不確定なまま放置しないことが信頼の維持につながります。暫定復旧では、予備サーバーへの切り替え、サービスの再起動、直近のバックアップからのリストアなど、最短でサービスを取り戻す手段を選びます。
復旧操作そのものが新たな障害を生まないよう、手順を事前に検証しておくことが大切です。また、ぶっつけ本番のリストアは、かえってデータを上書きしてしまう危険があります。
少人数でも回す役割分担の工夫
大企業では、インシデントコマンダーを置いたうえで、実務、連絡、記録の役割を分ける体制(インシデント・コマンド・システム)が理想とされます。しかし中小企業やスタートアップでは、夜間に1〜2名しか動けないという現実があります。そうした場合は「縮退運転」の発想が役立ちます。
たとえば1名のときは全役割を兼務しつつ応援を呼ぶことに集中し、2名のときは「対応ライン(指揮兼作業)」と「連絡ライン(外部連絡兼記録)」に完全分割します。こうすることで、作業に集中すべき担当者が外部からの問い合わせ対応に追われて手が止まる事態を防げます。人数が少ないからこそ、誰が何をするかを事前に決めておく価値が高まります。
▶ 詳細はこちら:ITシステム障害復旧の進め方|復旧手順と役割分担を解説
復旧力を高める事前準備
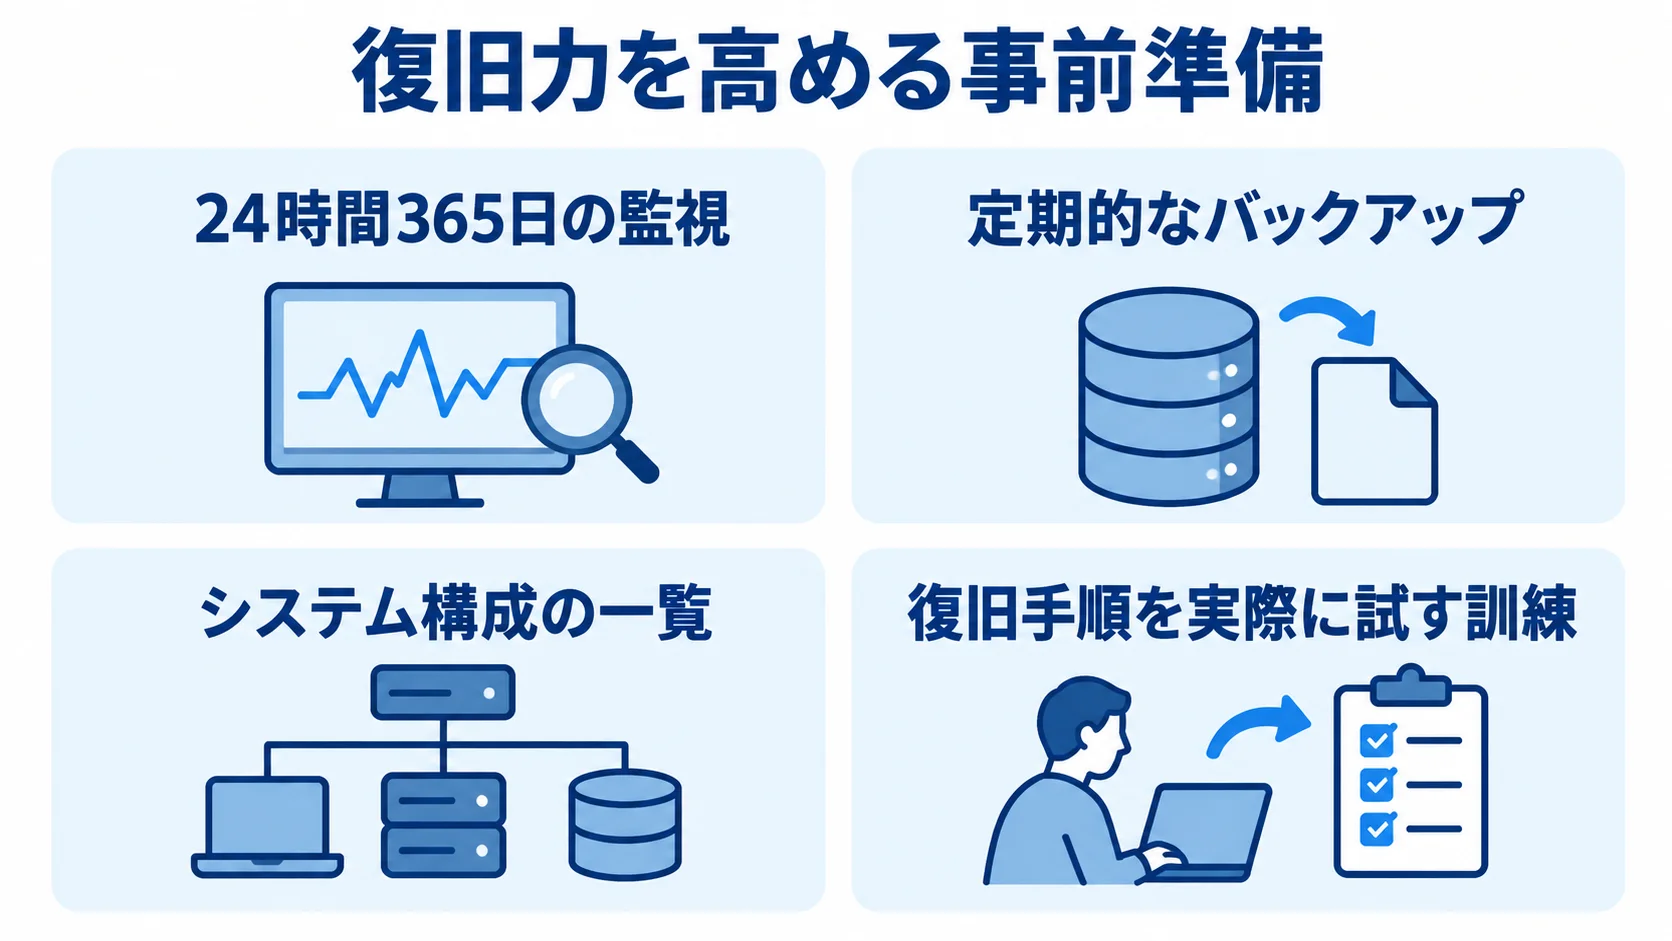
障害復旧のスピードは、障害が起きてからの努力よりも、平時の備えで大きく決まります。「障害ゼロは不可能」という前提に立ち、いざというときに素早く戻せるよう準備しておくことが、現実的な戦略です。
具体的には、24時間365日の監視、定期的なバックアップを整えたうえで、システム構成を一覧にし、復旧手順を実際に試す訓練も行います。
監視とバックアップの設計
監視は障害の早期検知に直結するため、死活監視、リソース監視、ログ監視を組み合わせ、異常をアラートで即座に把握できるようにします。理想は、ユーザーやカスタマーサポートが気づくより先に、システム側が検知することです。逆に、ユーザーから先に指摘されるケースが多い場合は、監視の死角を疑うべきサインといえます。
バックアップの取得頻度は、先述のRPOに合わせて決めます。RPOが15分なら15分ごと、1日でよければ日次というように、業務要件と整合させます。さらに、バックアップは取得するだけでなく、「確実に戻せるか」を定期的に検証しておく必要があります。
たとえば、取得していたはずのバックアップが壊れていて復旧できない、という失敗は現場で珍しくありません。加えて、バックアップの保管先を本番と物理的に分離しておくことも、ランサムウェア対策として有効です。
ゲームデーとカオスエンジニアリング
障害が起きてから手順の穴に気づいても遅いため、復旧手順は平時に擬似障害を起こして試しておく必要があります。そうした手法には、次の2つがあります。
- ゲームデー:本番に近い環境で意図的に擬似障害を発生させるロールプレイです。手順書の不備や役割分担の穴を、被害のない状態で洗い出せます。
- カオスエンジニアリング:専用ツールで意図的に障害を注入し、システムの回復力を科学的に検証する、より高度な手法です。
ある検証では、計47件の実験から12件の致命的な故障モードを特定し、MTTR(平均復旧時間)を65%削減、レジリエンススコアを2.3から4.1へ向上させた事例があります。障害を「起きてから困るもの」から「平時に試して鍛えるもの」へ捉え直す発想が、復旧力を底上げします。
▶ 詳細はこちら:ITシステム障害復旧の外注・委託|監視と運用代行の活用法をご覧ください。
復旧支援会社の選び方
自社だけで24時間365日の監視や障害復旧を担うのは、人員的にも技術的にも負担が大きいものです。そこで、運用代行やDR(災害復旧)構築などを行う外部パートナーの活用が選択肢になります。バックアップやインシデント管理プラットフォームの提供も、その範囲に含まれます。
自社に合うパートナーかどうかは、対応範囲とSLA、ベンダーとの関わり方で見極めます。
対応範囲とSLAの確認
まず確認したいのは、どこまでを任せられるかという対応範囲です。監視だけなのか、障害検知後の一次対応や復旧作業まで含むのか、夜間休日も含めた24時間365日体制なのかで、サービスの性格は大きく変わります。たとえば、「監視はしているが、障害時に誰がどこまで動くのか曖昧」という委託では、いざというときに期待した復旧が得られません。
自社のRTO・RPO目標を満たせる体制かどうかを基準に判断します。あわせて、SLAの内容を具体的に確認します。一次応答までの時間、目標復旧時間、守られなかった場合のペナルティなどが、契約で明記されているかを見ます。
ベンダーコントロールの観点
外部に復旧を委ねる場合でも、丸投げにせず、「ベンダーをコントロールする」視点が欠かせません。障害発生時にベンダーから提出されるRCA(根本原因分析・障害報告書)の妥当性を自社で評価し、内容が不十分であれば差し戻して詳細な開示を求める姿勢が必要です。SLA違反があった場合の交渉も含め、待つだけでない関与が復旧品質を左右します。
パートナーを選ぶ際は、技術力や実績だけでなく、障害時のコミュニケーションの透明性や、報告内容の具体性も評価軸に加えるとよいでしょう。また、コンサルティングから開発・運用まで一気通貫で支援できる体制を持つパートナーであれば、復旧後の恒久対策やシステム改善まで連続的に任せられる利点があります。
▶ 詳細はこちら:ITシステム障害復旧のおすすめ会社・サービス比較
障害復旧にかかる費用相場
障害復旧にかかる費用は、監視のアウトソーシング、DR環境の構築、バックアップの運用など、何にどこまで備えるかによって幅があります。
一概に金額を示すのは難しいものの、コストの構造を理解しておけば、過剰投資も備え不足も避けられます。費用を左右する主な要因と、その考え方の目安を取り上げます。
費用を左右する主な要因
費用に最も影響するのはRTO・RPOの厳しさです。復旧目標を短くするほど、ホットスタンバイの予備系やリアルタイムのデータ同期が必要となり、構成は高度になりコストも上がります。逆に、半日〜1日の復旧で許容できる業務であれば、コールドスタンバイや日次バックアップで済み、費用を抑えられます。
もう一つの要因が、監視・対応の体制です。24時間365日の有人監視と即時対応を求めるほど、人件費に相当する運用費が積み上がります。
対象システムの規模やサーバー台数、データ量も費用に反映されます。これらは初期費用とランニングコストに分かれるため、両方を合算した総コストで比較することが大切です。
投資判断とリスク額の比較
復旧への投資が妥当かどうかは、障害が起きたときに失われる金額と比較して判断します。1時間の停止でどれだけの売上機会や信用を失うかを概算すれば、どこまでコストをかけるべきかの基準が見えてきます。決済や受発注のように停止が直接損失になる領域には手厚く、影響の小さい領域には抑えめに、という配分が合理的です。
見積もりを取る際は、初期構築費、月額運用費、障害発生時のスポット対応費が、それぞれどう設定されているかを確認します。「平時は安いが障害対応で高額になる」契約や、その逆のパターンもあるため、想定する障害頻度を踏まえて総額で比較するとよいでしょう。
▶ 詳細はこちら:ITシステム障害復旧の費用・見積もり相場を解説
障害復旧で失敗しないためのポイント
復旧の仕組みを整えても、運用や文化の面でつまずくと効果が半減します。現場でよく見られる失敗パターンとその対策、そして復旧を学習につなげる考え方を取り上げます。
技術と組織の両面から備えることが、本当に強い復旧体制をつくります。
よくある失敗パターンと対策
代表的な失敗は、バックアップを取っていたつもりが復元できない、復旧手順が属人化していて担当者不在時に動けない、復旧を急ぐあまり原因不明のまま再発を繰り返す、といったものです。いずれも平時の検証と手順の標準化で防げます。バックアップは定期的にリストアテストを行い、手順書は誰が見ても実行できる粒度で整備しておきます。
また、ポストモーテム(事後検証)で立てた恒久対策が、日々の新機能開発に押し出されて実行されないという問題もよく起こります。再発防止策は、技術的負債の解消として優先度を確保し、ビジネス側と合意のうえでリソースを守る必要があります。「後回しにできるタスク」と扱わないことが大切です。
非難なき文化による再発防止
障害を学習資産に変えるには、個人を責めない「非難なき文化(Blameless Culture)」が欠かせません。たとえば、「花瓶の水を換えようとして落として割った」という失敗があったとします。本人の不注意で片付けるのではなく、「水場までの移動経路」や「割れやすい材質」といった環境や仕組みの問題として捉え直す視点が大切です。
人を責める場では本音が出ず、本当の原因が隠れてしまいます。そのため、原因分析では「なぜミスをしたのか」と個人に問うのではなく、「どのようにしてこの事象が起きたのか」と仕組みに焦点を当てる問いに変えると、建設的な議論になります。
あわせて、深夜・休日のオンコール負担を定量化し、担当者のバーンアウトを防ぐ労務的な配慮も、持続可能な復旧体制には不可欠です。
まとめ
ITシステム障害復旧は、暫定復旧と恒久対策を切り分け、RTO・RPOという数値目標に基づいて設計することが出発点です。そのうえで、検知から事後対応までの基本フローをマニュアル化し、少人数でも回る役割分担を決め、監視・バックアップ・訓練という事前準備で復旧力を底上げしていきます。
さらに、外部パートナーを活用する際は、対応範囲とSLAを見極め、ベンダーコントロールの視点を持つことが復旧品質を左右します。費用はRTO・RPOの厳しさと監視体制によって大きく変わるため、失われるリスク額と比較した投資判断が合理的です。
そして、復旧を一度きりで終わらせず、非難なき文化のもとで学習資産に変えていくことが、再発しない強い組織をつくります。本記事を起点に、それぞれのテーマを深掘りした関連記事もあわせてご覧いただき、自社に最適な障害復旧体制の構築にお役立てください。
【関連記事】
・ITシステム障害復旧の進め方|暫定復旧と恒久対策の切り分け
・ITシステム障害復旧のおすすめ会社・サービス比較
・ITシステム障害復旧の費用・見積もり相場を解説
・ITシステム障害復旧の外注・委託|監視と運用代行の活用法をご覧ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。