
ITシステム障害復旧に必要な機能と標準で含まれる機能は、異常に気づいてから、サービスを戻し、原因を突き止め、再発を防ぐまでの流れに沿って並んでいます。本記事は、ITシステム障害復旧が提供する必要機能・標準機能を、発注企業(情シス)の視点から一覧的に整理する「機能特化」の解説です。
- 検知・監視
- 一次対応・復旧
- 原因調査
- 再発防止
- AIOps・自動検知
案件を探す際は、条件整理から実績化までの流れを先に確認しておくと判断しやすくなります。全体像をまだ把握していない方は、まずITシステム障害復旧の完全ガイドから読むことをおすすめします。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
業務システム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
障害を捉える検知・監視機能
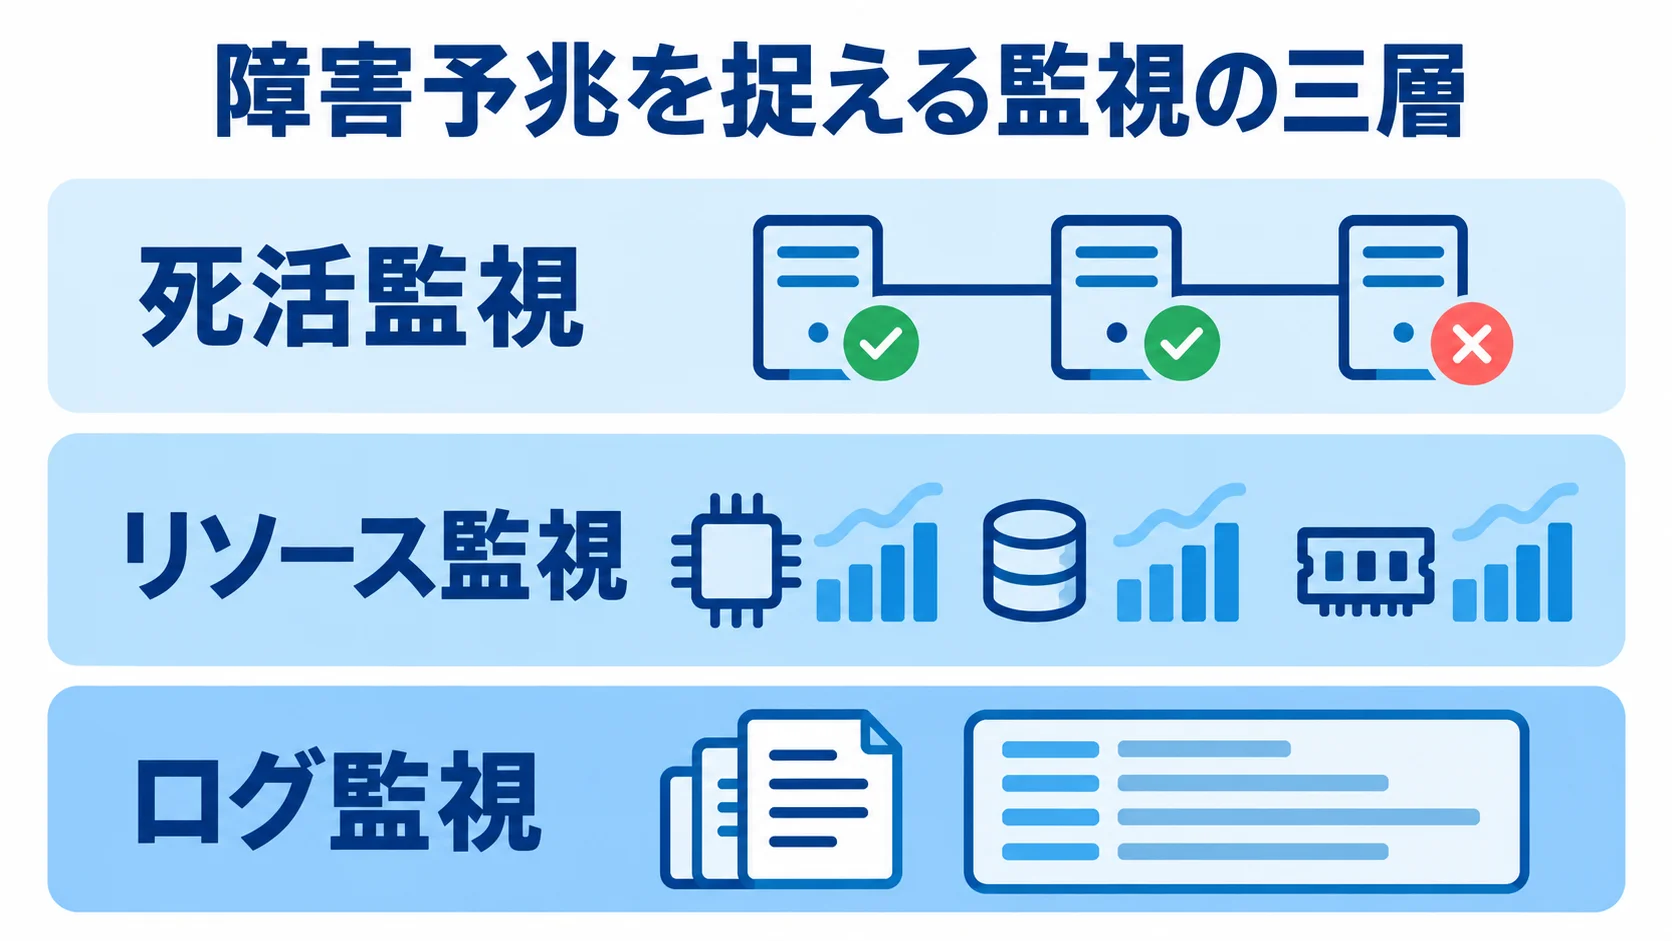
障害復旧のすべての起点となるのが、異常をいち早く捉える検知・監視機能です。障害は起きてから対応するのでは遅れがちで、起きた瞬間か予兆の段階で気づけるかどうかが、復旧時間を左右します。復旧の前提となる監視は、層ごとに役割が分かれています。
死活監視・リソース監視・ログ監視という三層の検知機能
検知機能は、大きく三つの層で構成されます。まず死活監視は、サーバーやサービスが「生きているか・応答しているか」を一定間隔で確認します。次にリソース監視は、CPU使用率・メモリ・ディスク容量といった性能指標を見て、閾値を超えたら異常の予兆として捉えます。
ログ監視は、アプリケーションやOSが出力するログから、エラーメッセージや異常な挙動を検出します。死活監視だけでログ監視が含まれていない場合、アプリケーション層の障害予兆は見逃される可能性があり、復旧が後手に回ります。言い換えると、三つの層がそろって初めて、障害の発生と予兆の両方を捉えられます。
これらの機能は、運用・監視サービスの基本料金に含まれることが多く、一次データでは24時間365日の死活・リソース監視で月額5万〜20万円が相場とされています。たとえば、サービス会社の料金体系には、バルクサーバーの監視を5,000円/台とするものもあります。重要なのは、契約する監視サービスがどの層までをカバーしているかを確認することです。
アラート通知と閾値設計という検知の質を決める機能
検知機能で見落とされがちなのが、アラート通知と閾値設計です。異常を検知しても、適切な担当者へ適切なタイミングで通知されなければ、復旧の初動は始まりません。アラート機能は、検知した異常の重大度に応じて、メール・チャット・電話といった経路で関係者に通知します。
重大障害は即座に電話で呼び出し、軽微なものは翌営業日でよいといった出し分けが、復旧体制の質を決めます。同時に重要なのが閾値設計です。閾値を厳しくしすぎると、問題のない一時的な負荷上昇でもアラートが鳴り続け、「またか」と無視されるアラート疲れを招き、逆に緩すぎると本当の障害を見逃します。
監視ツールとしては、Zabbix(OSS・ライセンス無料だが構築維持に工数)や、Datadog・New Relicといったクラウド型(ホスト数やメトリクス量で従量課金、中規模で月数万〜数十万円)が使われます。どのツールでも、中心になるのはこの閾値の作り込みです。つまり、検知機能は通知ルールと閾値という運用設計まで含めて初めて、復旧につながる検知になります。
サービスを立て直す一次対応・復旧機能
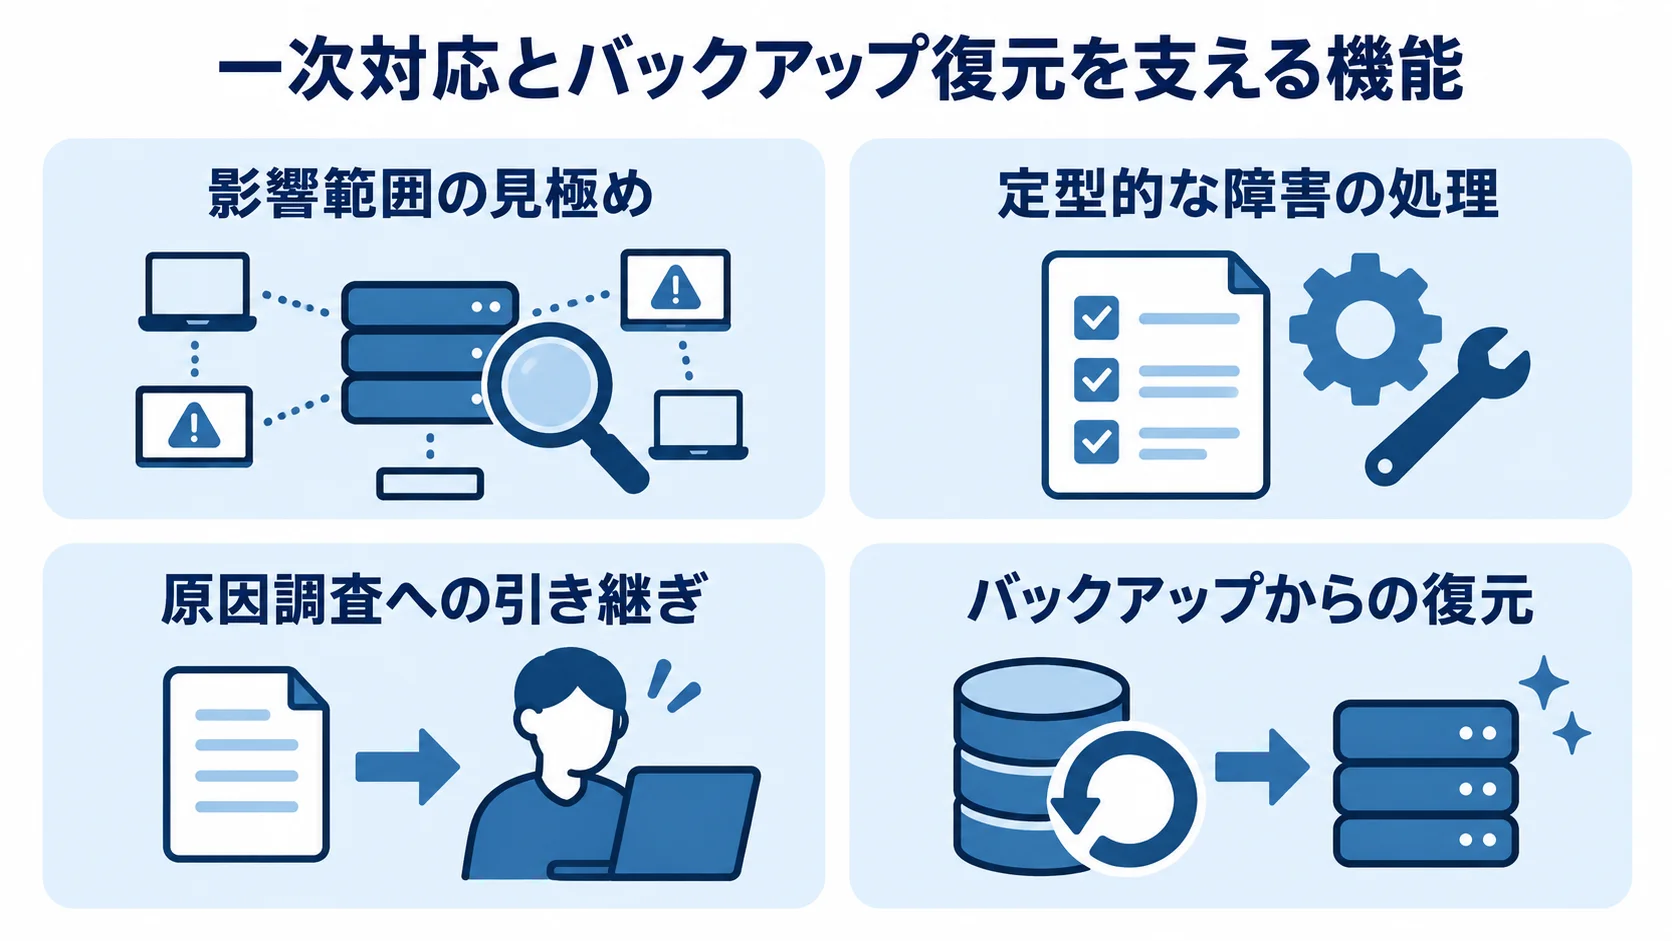
検知の次に動くのが、止まったサービスを立て直す一次対応・復旧機能です。障害復旧の中核にあたり、この機能が「どこまで・どれだけ速く」対応するかによって、ダウンタイムの長さが直接決まります。復旧の実働部分は、一次対応と、バックアップからの復元に分かれます。
一次対応・切り分けという初動を担う機能
一次対応機能は、アラートを受けて最初に動く工程です。まず「どこで・何が・どの範囲で起きているか」を切り分け、影響範囲を見極めます。切り分けでは、原因がネットワーク、サーバー、アプリケーションのどこにあるかを特定します。
- ネットワークの問題:通信経路や接続で起きている障害
- サーバーの問題:サーバーの稼働状態や設定で起きている障害
- アプリケーションのバグ:プログラムの不具合で起きている障害
この切り分けが正確で速いほど、的外れな対応に時間を浪費せず、復旧へまっすぐ進めます。一次対応で復旧できる定型的な障害(サービスの再起動、リソース逼迫の解消など)は、その場で処理します。一方、複雑なものは原因調査へ引き継ぎます。
一次データでは、障害対応の費用は営業時間内対応で月3万〜8万円、24時間の緊急対応で月10万〜20万円、スポット対応で1件3万〜10万円が目安とされます。さらに、Cloud Naviの例では重大issueに15分以内の一次対応を保証し、シーズホスティングでは検知から60分以内に通知するなど、初動の速さをSLAとして明示するサービスもあります。
一次対応機能を選ぶ際は、この初動時間がどう保証されているかを必ず確認すべきです。
バックアップからの復元という復旧の最後の砦
復旧機能の中でも、最後の砦となるのがバックアップからの復元です。データ破損やシステム全体の停止といった重大障害では、正常だった時点のバックアップへ戻すこと(リストア)が唯一の復旧手段になることがあります。このため、定期的なバックアップ取得と、いざというときに確実に復元できる仕組みは、障害復旧機能の根幹をなします。
バックアップは、取得するだけでなく、実際に復元できるかを定期的に検証するところまでが機能の範囲です。復旧時間の目標は、一般的に重大障害で2時間以内に対応を開始し、24時間以内の完全解決が一つの目安とされます。官公庁仕様では原則4時間以内の完全復旧、シーズホスティングでは12時間での復旧といった例があります。
これらの復旧時間は、バックアップからどれだけ速く復元できるかに大きく左右されます。取得頻度が低いと、復元しても直近のデータが失われ、その分の損失が生じます。そのため、復旧機能を評価するときは、「どこまで戻せるか(データの鮮度)」と「どれだけ速く戻せるか(復旧時間)」の両面を見ることが欠かせません。
根本原因を突き止める原因調査機能
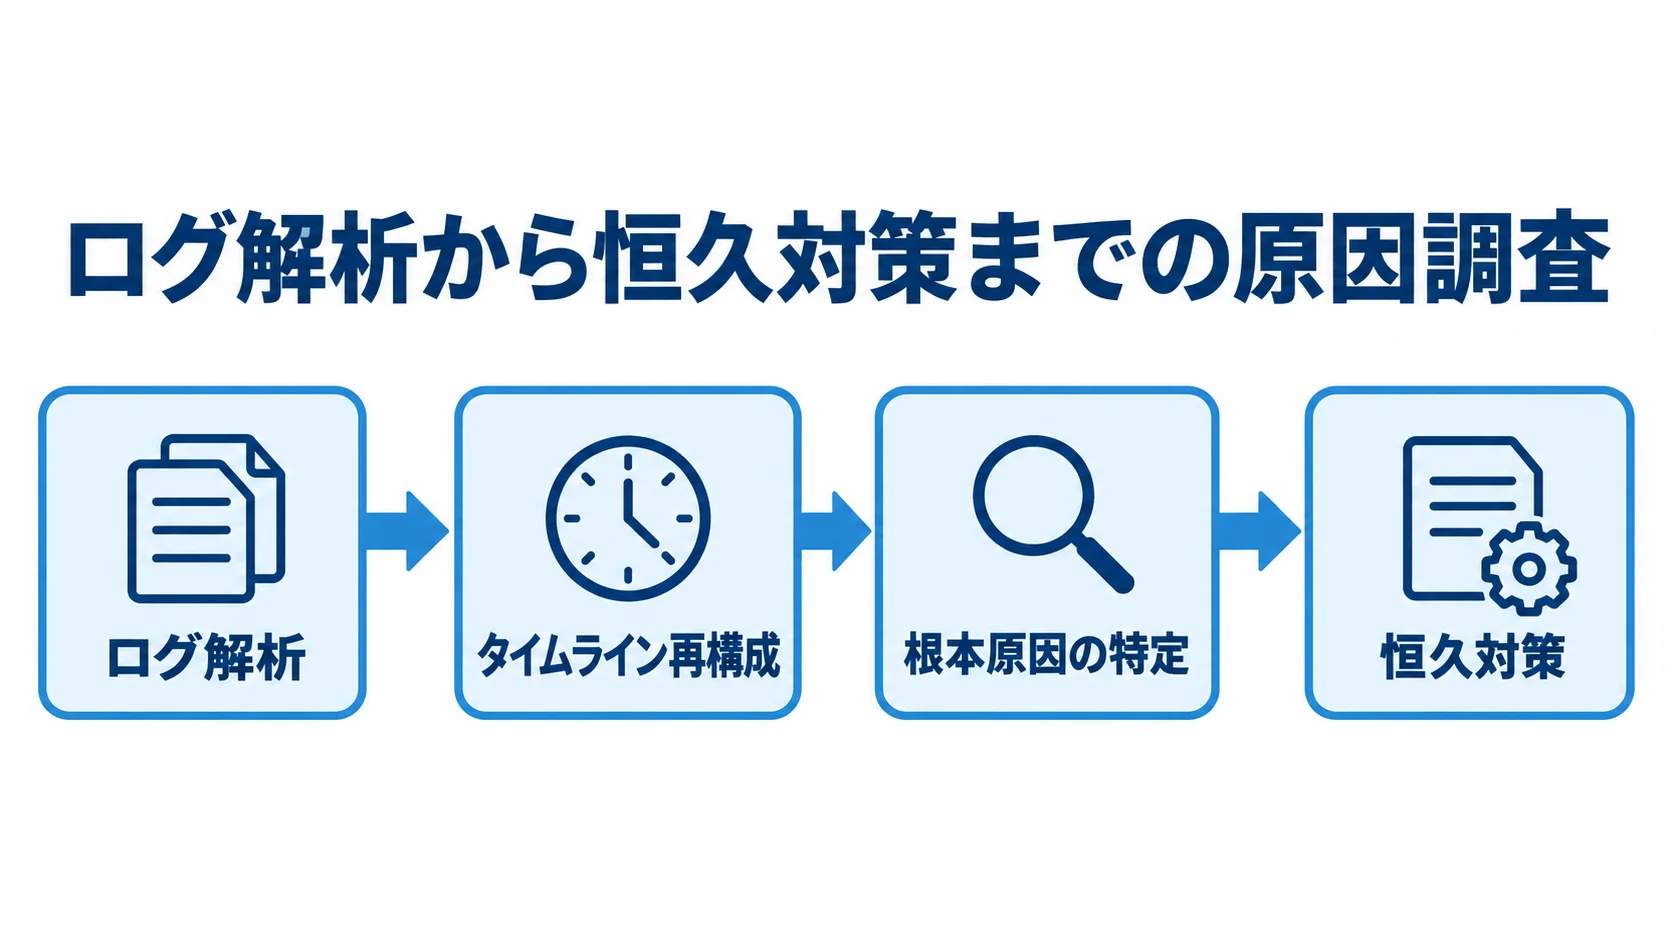
サービスを暫定的に復旧させても、障害対応はまだ終わりません。なぜ起きたのかを突き止めなければ、同じ障害が繰り返されます。その役割を担うのが原因調査機能です。
一次対応で暫定的に止めたあと、原因調査で根本の要因を特定します。それが再発防止の前提となる重要な工程です。
ログ解析・タイムライン再構成という調査機能
原因調査の中心は、ログ解析です。障害発生前後のログを時系列で追い、どのタイミングで何が起き、それが連鎖的にどう波及したかというタイムラインを再構成します。そのうえで、アプリケーションやシステムのログ、アクセスログ、データベースのスロークエリログなど、複数のログを突き合わせることで、表面的なエラーの裏にある根本原因にたどり着きます。
この機能を担うには、ログを横断的に検索・相関分析できる基盤が役立ちます。また、大規模環境では、SOC(セキュリティオペレーションセンター)の運用対象としてSplunk CloudのようなSIEM(ログ統合・相関分析基盤)が使われることもあります。原因調査の機能レベルは、ログ基盤の有無と、それを読み解く分析担当者のスキルに左右されます。
一次データでは、SOCサービスの費用例としてCEC SOCが月30万円〜(1,000台規模)、SHIFTのSOC運用支援が月9万円〜(シルバープラン)といった水準が示されています。さらに、人月単価では、インシデント分析を担う運用設計者が80万〜120万円とされ、調査の質はこうした専門人材によって支えられます。
再発防止策の立案・恒久対策という機能
原因が特定できたら、次は再発防止策を立案する段階です。暫定対応で止めた障害に対し、根本原因を取り除く恒久対策を講じます。たとえば、特定のバグが原因ならコード修正とテスト、リソース不足なら増強や自動スケーリング、設定ミスなら手順の見直しと自動化といった形です。
再発防止のもう一つの機能は、障害報告書(ポストモーテム)の作成です。何が起き、なぜ起き、どう対応し、今後どう防ぐかを文書化して、関係者で共有します。これにより、同種の障害が再び起きたときの初動が速くなり、組織として復旧力が蓄積されます。
この恒久対策まで踏み込むかどうかが、運用の質を大きく分けます。一方で、安すぎる障害対応サービスでは、暫定復旧までで止まり、原因調査や再発防止が含まれないことがあって、同じ障害を何度も起こしかねません。したがって、原因調査機能は、目先の復旧だけでなく、二度と起こさないための投資として位置づけるべき機能です。
復旧を自動化するAIOps・自動検知機能
近年、障害復旧の機能として注目されているのが、AIを活用した運用自動化(AIOps)と自動検知です。人手による監視と対応には限界があるため、膨大なログやメトリクスから異常を見つけ出すには、機械の力が有効です。最新の自動化機能は、予兆の検知から定型的な復旧の自動実行まで広がっており、中小企業も段階的に取り入れられます。
異常検知・予兆検知を担うAIOps機能
AIOpsの中心機能は、異常検知と予兆検知です。過去の正常な状態を学習し、そこから外れた挙動を「異常」として自動で検出します。加えて、固定の閾値では捉えきれない、複合的な指標の微妙な変化や、時間帯による正常範囲の違いも考慮できるのが特長です。
これにより、人が閾値を一つひとつ設定する手間を減らしつつ、障害が深刻化する前の予兆段階で気づける可能性が高まります。予兆の段階で対処できれば、そもそも復旧が必要な障害を未然に防げます。
さらに進んだAIOps機能では、検知した障害に対し、過去の類似事例から推奨される対応手順を提示したり、定型的な復旧アクションを自動実行したりするものもあります。また、アラートの集約・相関分析により、一つの根本原因から派生した大量のアラートを束ねて、本当に対応すべき障害だけを浮かび上がらせる機能も、運用負荷の軽減に貢献します。要するに、これらは復旧の自動化と効率化を同時に実現する機能です。
中小企業向けのスモールスタートという導入機能の選び方
AIOpsと聞くと大企業向けの大がかりな仕組みを想像しがちですが、機能の取り入れ方は段階的でかまいません。JUASの調査では、IT運用でのAI活用は約78%が検討中・未検討という段階にあり、いきなり全面導入する必要はないと示唆されます。
中小企業であれば、まず既存のクラウド型監視ツールに備わる異常検知機能から使い始め、効果を見ながら範囲を広げるスモールスタートが現実的です。たとえば、DatadogやMackerelといったSaaS型監視ツールには、機械学習ベースの異常検知機能が標準やオプションで備わっており、追加のシステム構築なしに使い始められます。
レガシーシステムを維持しながら、まずは重要なサーバーだけにAIOps的な検知機能を当てる、という部分導入が低コストで始められます。全部を一度に入れるより、自社の規模と重要度に応じて必要なものから段階的に取り入れる視点で選ぶことが、過剰投資を避ける鍵になります。
まとめ
ITシステム障害復旧の機能は、検知・監視から始まり、一次対応・復旧、原因調査と進んで、AIOpsによる自動検知が加わる流れで構成されます。検知・監視は死活・リソース・ログの三層とアラート・閾値設計で、一次対応・復旧は切り分けとバックアップ復元で、原因調査はログ解析と再発防止で担われます。
それぞれの工程に必要な機能が連動して初めて、障害は速やかに収束し、再発も防げます。費用は監視で月5万〜20万円、24時間緊急対応で月10万〜20万円が相場であり、SOCやSIEMを伴う高度な調査機能はさらに費用がかかります。
機能を検討するときに大切なのは、「どの機能が標準で含まれ、どこからが追加費用になるか」を契約前に一覧で確認することです。とくに原因調査と再発防止が対応範囲に入っているかは、同じ障害を繰り返さないために必ず押さえてください。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、検知から復旧、再発防止までの機能を自社システムの重要度に合わせて過不足なく設計する支援を行っています。全体像の確認には、あらためて完全ガイドをご活用ください。
開発を相談する前に、業務システム開発とAI駆動開発の完全ガイドブックをご覧ください。
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。