
障害復旧のRFP(提案依頼書)や要件定義書には、監視項目と閾値、SLAの数値を過不足なく書き込みます。クラウドを使う場合の責任分界と、追加費用が発生する対応範囲も明記します。
全体像をまだ把握していない方は、まずITシステム障害復旧の完全ガイドを読むことをおすすめします。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
監視項目と閾値を定義する要件
障害復旧の要件定義は、まず「何を監視するか」を明確にすることから始まります。監視対象と閾値が曖昧なままだと、復旧の前提となる検知そのものに穴が開いてしまいます。
RFPには、監視対象の列挙と、閾値および通知ルールの定義を書き込みます。
監視対象と監視項目を漏れなく列挙する要件
要件定義書には、監視対象を層ごとに具体的に列挙します。サーバーやデータベースといった基盤と、ユーザーから見たサービスの応答を測る外形監視とを、分けて明記します。各対象について、死活監視やリソース監視(CPU・メモリ・ディスク)などのうち、どれを行うかも書き分けます。
「サーバーを監視すること」とだけ書くと、ベンダーごとに解釈が分かれ、提案を比べられなくなります。そこで、監視項目を漏れなく列挙するには、「障害が起きたとき、どの指標を見れば気づけたか」を過去の障害から逆算するのが有効です。
たとえば、過去にディスク満杯でサービスが止まった経験があれば、ディスク使用率の監視は必須要件になります。
一次データでは、運用・監視の費用は月額5万〜20万円が相場とされています。監視対象と項目が増えれば、費用も上がります。そのため、重要なシステムは手厚く、影響の小さいものは最低限にするなど、メリハリをつけた要件にすることが、過剰な見積もりを避ける鍵になります。
- 監視対象:サーバー、ネットワーク機器、データベース、アプリケーション、外形監視
- 監視方式:死活、リソース、プロセス、ログのうち、対象ごとに選ぶ方式
閾値と通知ルールを数値で定義する要件
監視対象を決めたら、各項目の閾値を数値で定義します。たとえば「CPU使用率が90%を5分間継続したら警告、95%を超えたら障害として通知」のように、数値と継続時間を書き込みます。
閾値は、検知の精度を決めます。曖昧なままだとベンダー任せの設定になり、アラートが鳴りすぎたり、逆に重大な障害を見逃したりします。そのため、要件定義の段階で、自社の運用実態に合った閾値の考え方を示しておくことが重要です。
あわせて、通知ルールも要件に含めます。検知した異常について、重大度ごとに、誰へ、いつまでに知らせるかを定めます。具体的には、重大障害は電話で即時、軽微なものは翌営業日のレポートで、といった出し分けを明記しておけば、復旧の初動が設計どおりに動きます。
監視ツールには、Zabbix(OSS)やDatadog、Mackerelなどが候補に挙がります。ただし、RFPで特定のツールを指定するより、満たすべき監視要件と閾値を示し、最適なツール構成をベンダーに提案させるほうが、良い提案を引き出せます。
- 重大度の区分:障害として扱う水準と、軽微な異常として扱う水準を分ける
- 通知経路:メール、チャット、電話のどれを、どの重大度に使うか
SLAの数値要件を明記する書き方
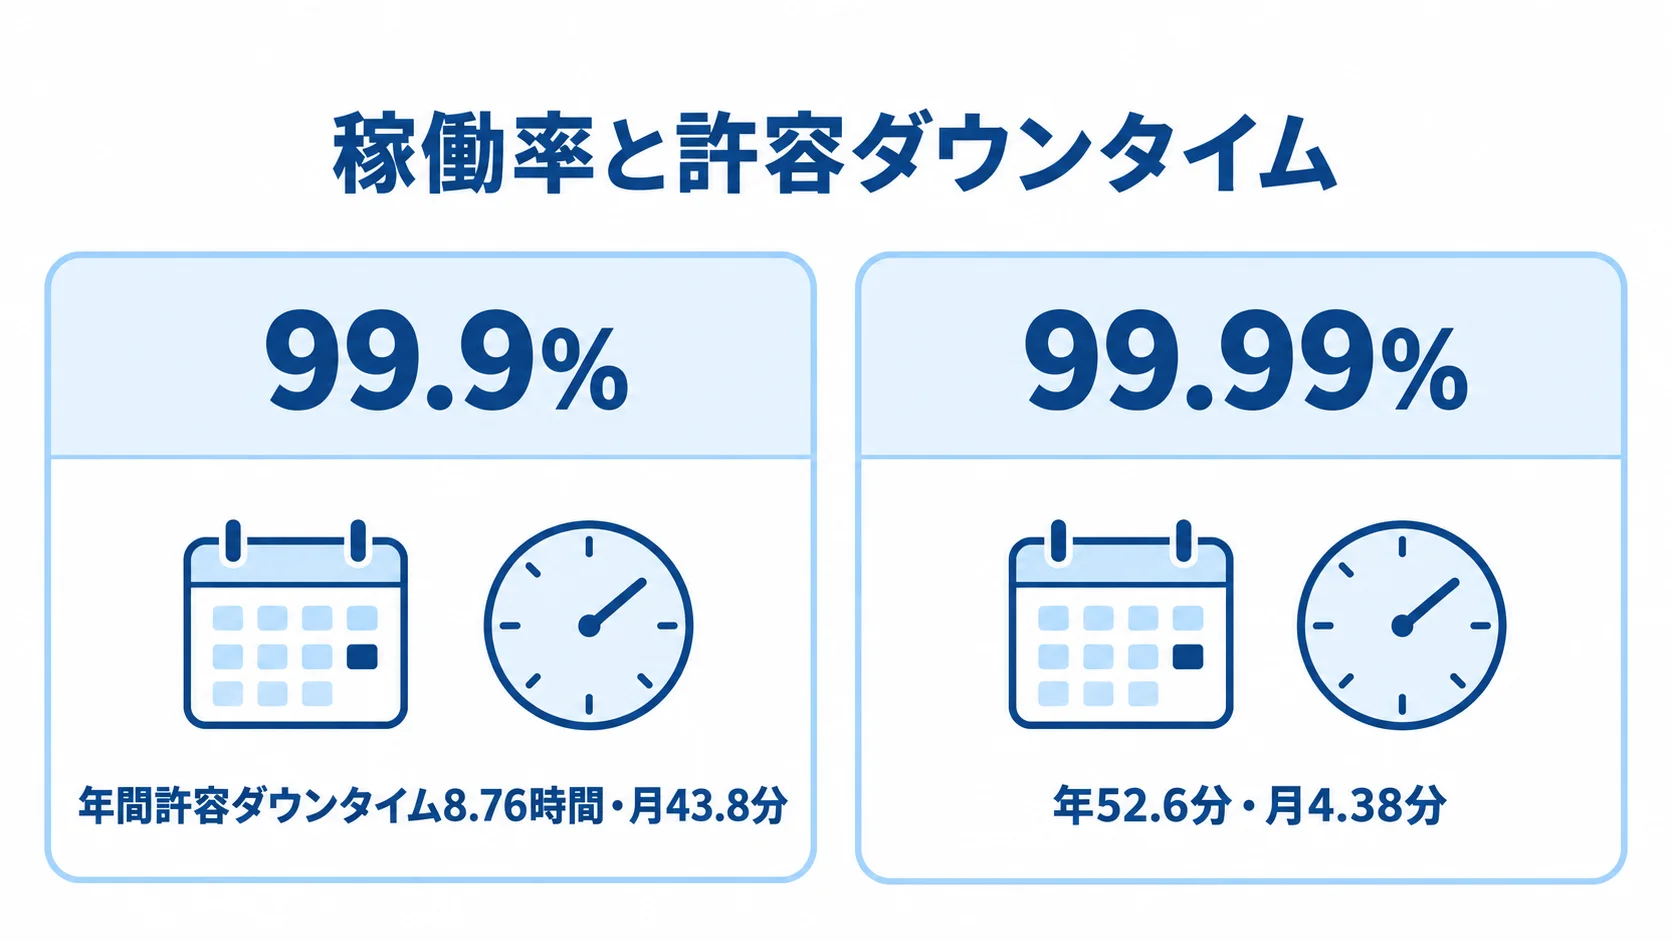
障害復旧の要件定義で、費用と品質にもっとも直結するのがSLAの数値要件です。稼働率、初報応答時間、復旧時間といった数値を、根拠とともに明記する必要があります。
稼働率を事業影響度から逆算して定義する要件
稼働率は、SLAの中心となる数値です。ただし、要件定義で陥りやすいのが、「とにかく高い稼働率を求める」ことです。
一次データでは、稼働率99.9%は年間許容ダウンタイム8.76時間・月43.8分であるのに対し、99.99%は年52.6分・月4.38分と、桁違いに短くなります。
また、「9」が一つ増えるごとに、運用コストが段階的に跳ね上がります。すべてのシステムに99.99%を求めれば、費用は青天井になります。
正しい書き方は、システムごとに事業影響度から稼働率を逆算することです。止まれば売上が直撃するECや基幹系には高い稼働率を、停止しても代替手段で業務が回る社内系には控えめな稼働率を設定します。
総務省2025年版の統計では、金融・医療・EC系で5分以上の停止1回あたり平均1,200万円の機会損失とされています。この損失額と稼働率を上げるコストを比べれば、各システムに必要な稼働率を論理的に導けます。
要件定義書には、稼働率の数値とともに、その根拠となる事業影響度を併記しておきます。併記しておくと、ベンダーも提案しやすくなり、社内の合意形成にも役立ちます。
- 停止時の影響:売上への直撃度と、代替手段で業務が回るかどうか
- 稼働率の数値:システムごとの値を、根拠の事業影響度とあわせて書く
初報応答時間と復旧時間を保証型で書く要件
稼働率と並んで重要なのが、初報応答時間と復旧時間です。初報応答時間は「障害発生から、ベンダーが第一報を返すまでの時間」で、復旧時間は「障害発生から、サービスが復旧するまでの目標時間」を指します。
一次データには、参考になる実例があります。官公庁仕様では、「1時間以内に現地到着・対処開始」「1時間以内に内容と予想作業時間を報告」「原則4時間以内に完全復旧」と定められています。
また、Cloud Naviでは「重大issue 15分以内の一次対応保証」、シーズホスティングでは「検知から60分以内通知・12時間で復旧」といった水準です。
要件定義で押さえるべきは、これらの時間が「努力目標」なのか「保証」なのかを明確にすることです。努力目標型は「できる限り早く対応します」という表現にとどまり、未達でもペナルティがありません。
保証型は、未達時にサービスクレジット(利用料の返金)などのペナルティを伴います。そこで、重要なシステムほど、保証型のSLAをRFPで求めるべきです。
さらに、未達時の補償内容(サービスクレジットの上限、損害賠償の範囲)も要件として書き込みます。いざというときに復旧の責任の所在が曖昧にならないよう、あらかじめ決めておくためです。
- 初報応答:第一報までの時間を、障害の重大度に合わせて決める
- 復旧時間:目標時間を、事業影響度に合わせて保証型で書く
クラウド責任共有を前提にした範囲要件
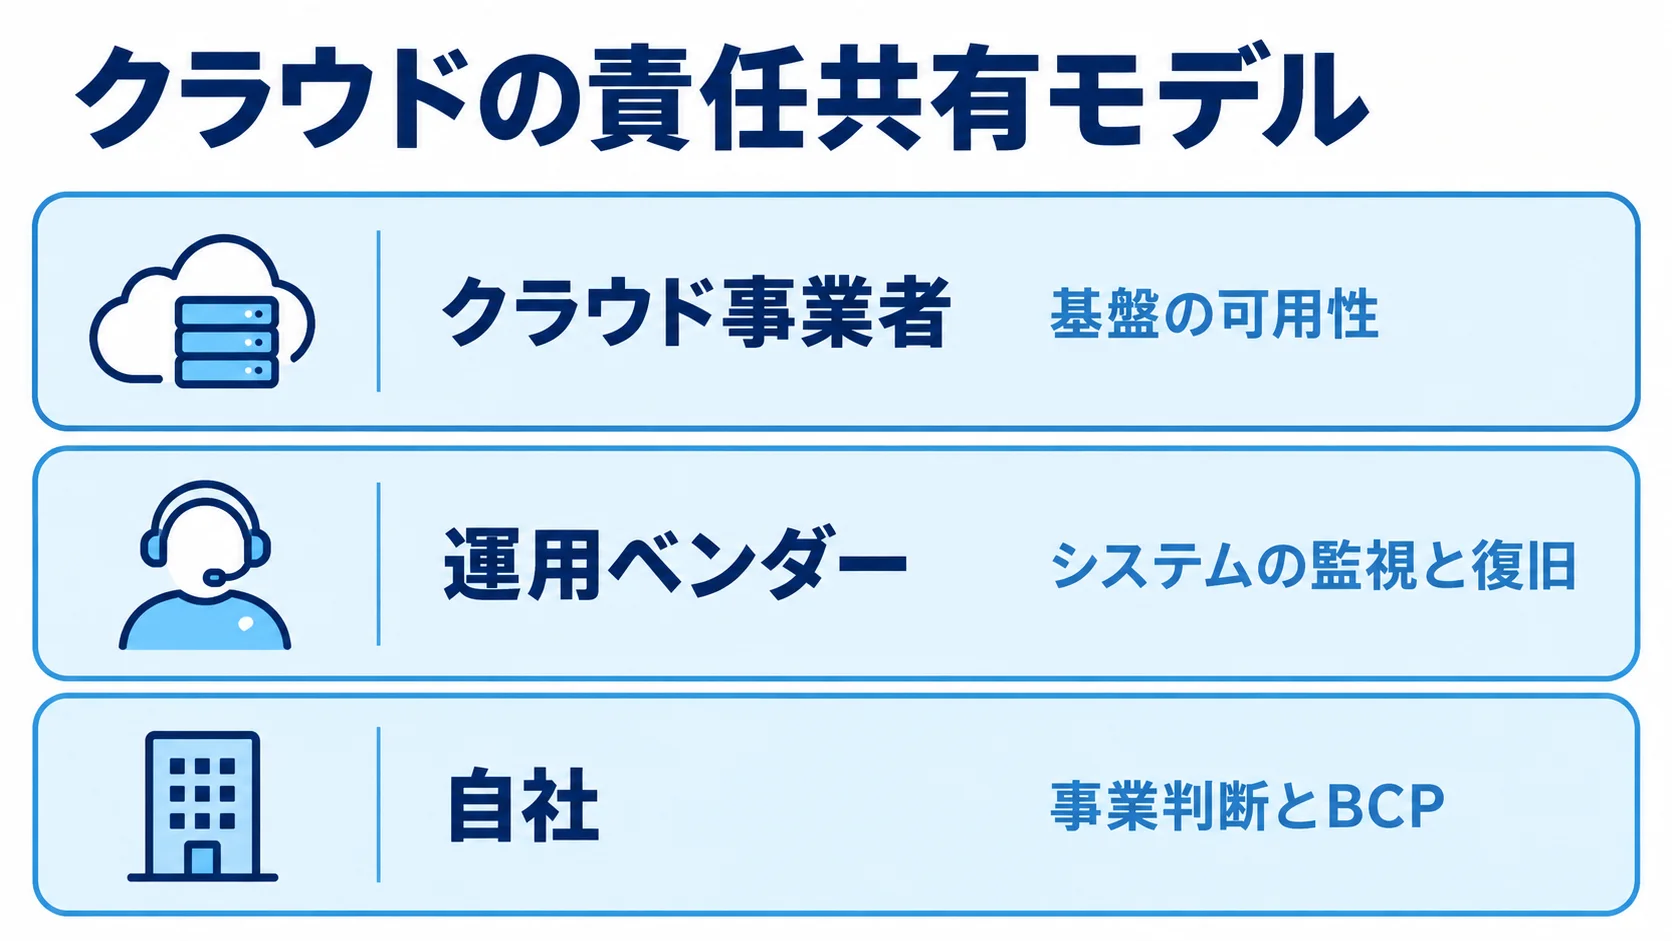
クラウド上でシステムを動かすことが当たり前になった今、障害復旧の要件定義では、クラウドの責任共有モデルを前提に範囲を切り分ける必要があります。クラウド比率は2022年で約5割(IDC Japan)に達しており、基盤側の障害は自社では復旧できません。
クラウド事業者・ベンダー・自社の責任分界を定義する要件
クラウドを使う場合、障害復旧の責任は三者に分かれます。クラウド事業者は基盤の可用性を、運用ベンダーは基盤上で動かすシステムの監視と復旧を、自社は最終的な事業判断とBCPを受け持ちます。
要件定義書では、この三者の責任の境目を明確にします。たとえば「基盤障害はクラウド事業者の責任だが、その障害を検知し、代替リージョンへ切り替える作業は運用ベンダーの範囲」といった形で、誰が何をするかを書き分けます。
この切り分けが曖昧だと、基盤障害が起きたときに「それはクラウド側の問題なので当社は関与しません」とベンダーに言われ、自社だけが取り残されかねません。
そのため、要件定義では、基盤障害が起きたときのベンダーの役割まで範囲に含めておく必要があります。状況把握や自社への報告、代替手段への切り替え支援などを定義しておくことで、復旧の空白を防げます。
クラウドの障害では、サービスクレジット以上の補償を受けられないことが多いため、自衛の手段も要件に入れておく必要があります。また、冗長化やバックアップの取得先の分散といったアーキテクチャ要件も、要件定義の段階で検討しておくべきです。
- 三者の担当範囲:クラウド事業者、運用ベンダー、自社のそれぞれが受け持つ部分
- 基盤障害時の役割:状況把握、報告、切り替え支援を、契約に明記する役割として書く
バックアップ・冗長化の復旧目標を数値で定義する要件
クラウド環境での障害復旧要件では、バックアップと冗長化の目標を数値で定義します。具体的には、RPO(目標復旧時点=どの時点のデータまで戻せるか)とRTO(目標復旧時間=どれだけ速く復旧するか)の二つです。
例として、「RPO 1時間(最大1時間分のデータ損失まで許容)」「RTO 4時間(4時間以内に復旧)」のように書きます。この二つの数値が、バックアップの取得頻度や冗長構成の設計を決めます。
RPOを短くするほど高頻度のバックアップが必要になり、RTOを短くするほど冗長化やホットスタンバイ構成が求められます。いずれも費用が増えるため、この二つの数値も事業影響度から逆算して決めます。
たとえば、データ損失が許されない決済系はRPOをほぼゼロに、多少の損失と復旧時間が許容できる社内系は緩めに設定するなど、メリハリをつけます。
要件定義書にRPO・RTOを数値で明記しておけば、ベンダーは必要な構成を正確に提案でき、見積もりの根拠も明快になります。
逆に、これを書かないと、ベンダーは安全側に倒した過剰な構成を提案するか、不十分な構成を提案するかのどちらかになり、後でトラブルの種になります。
- バックアップの頻度:RPOから導く取得間隔を、要件書に明記する
- 冗長構成:RTOに応じて、ホットスタンバイなどの構成を選ぶ
隠れコストを潰す対応範囲の定義
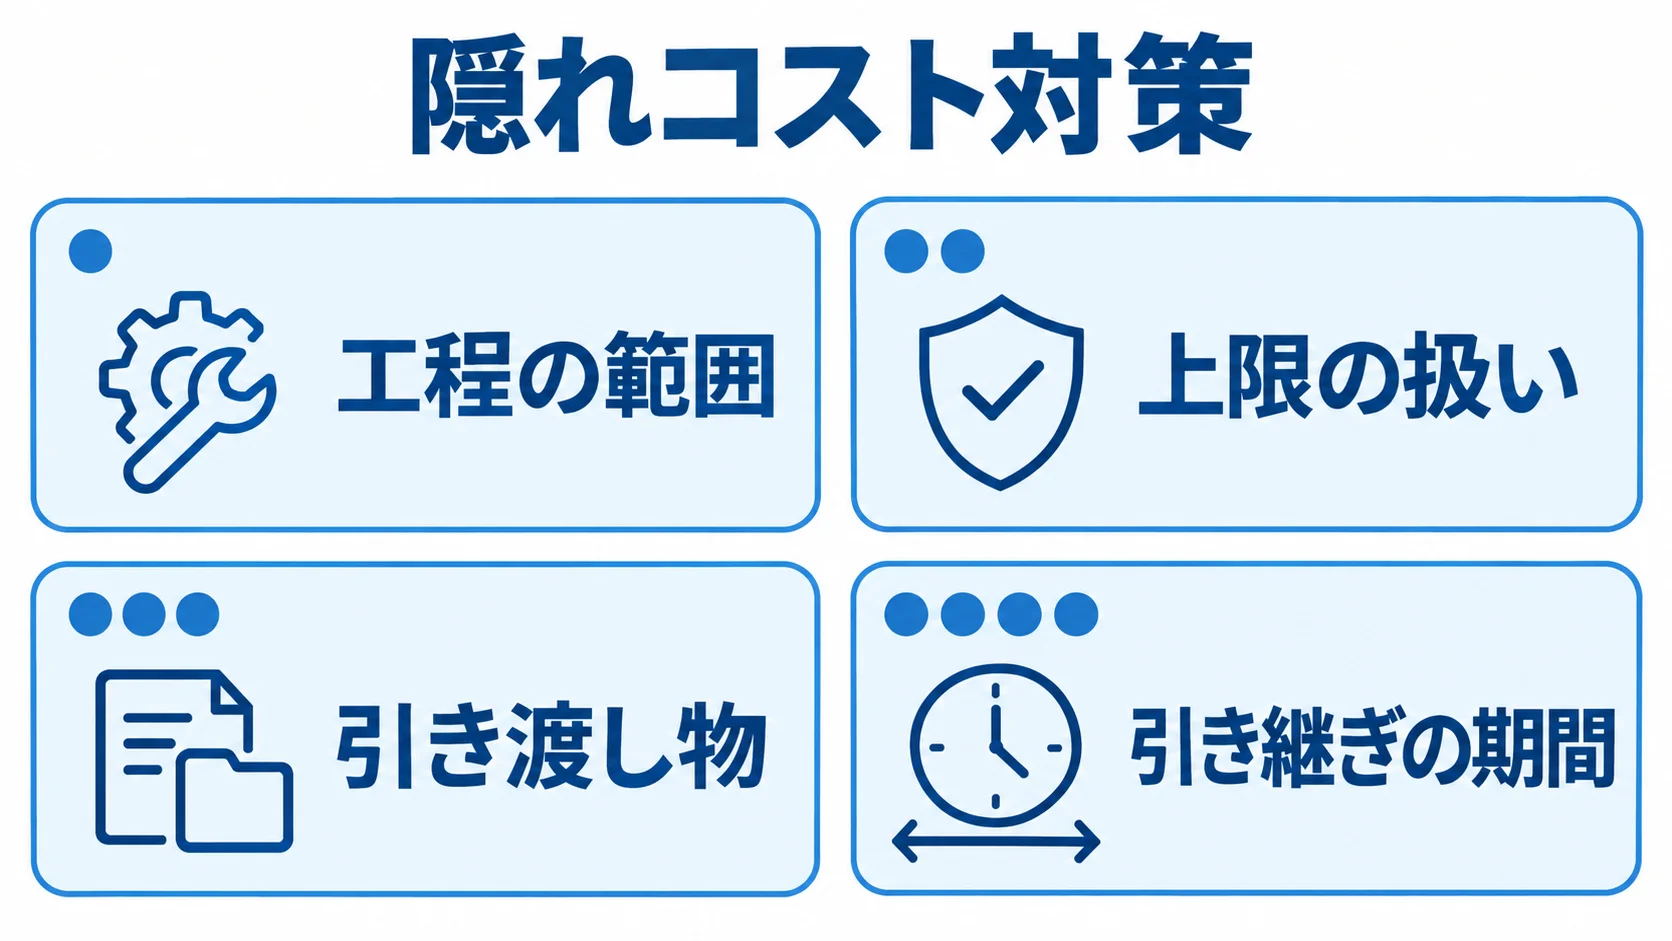
要件定義の最後の関門が、対応範囲の明確化による隠れコスト対策です。安い見積もりに飛びついた結果、いざ障害が起きたら「それは範囲外で追加費用です」と言われ、想定外の出費がかさむことがあります。
この落とし穴を防ぐには、対応範囲を精密に定義する要件を入れておく必要があります。
基本料金に含む範囲と追加費用の線引きを定義する要件
もっとも重要なのが、「基本料金に何が含まれ、どこからが追加費用か」を要件として明文化することです。
障害対応は、検知から報告書作成まで、いくつもの工程に分かれます。一方で、安価なサービスでは、一次対応の暫定復旧だけが含まれ、他の工程が対象外になっていることがあります。
また、原因調査や恒久対策が別料金になっているケースもあります。要件定義書では、どの工程を基本料金に含めるかを、具体的に列挙して求めます。
一次データでは、障害対応の費用はスポット対応で1件3万〜10万円が目安とされています。対応範囲の外にある作業が積み重なると、当初の月額を超える出費になりかねません。
あわせて、月間の対応回数や作業時間に上限があるかも、要件として押さえておきます。「月◯時間まで」「月◯件まで」といった上限が設定されていれば、それを超えた分が追加費用になります。
要件定義の段階で、自社の障害発生頻度を踏まえた現実的な範囲と上限を求めておくことが、後の予算超過を防ぎます。
- 工程の範囲:検知、一次対応、切り分け、原因調査、恒久対策、報告書作成のうち、どこまでが基本料金か
- 上限の扱い:月間の対応回数や作業時間の上限と、超えた分の取り扱い
ベンダー切り替えを見据えた引き継ぎ要件
見落とされがちですが、将来のベンダー切り替えを見据えた引き継ぎ要件も、RFPに盛り込んでおくべきです。運用を委託すると、自社システムの構成や運用ノウハウがベンダー側に蓄積されます。
いざ別のベンダーに切り替えようとしたとき、引き継ぎがスムーズに行われなければ、復旧体制に空白が生じます。そのため、要件定義書には、契約終了時に引き渡すものを明記しておきます。
あわせて、解約予告期間や引き継ぎにかかる工数についても触れておくと安心です。
これらを契約段階で要件化していないと、ベンダーに依存しきった状態(ロックイン)に陥ります。不満があっても切り替えられず、言い値の費用を払い続けることになりかねません。
障害復旧の要件定義は、目先の監視や対応だけでなく、長期にわたって主導権を握り続けるための条件まで含めて設計することで、本当の意味で隠れコストを潰せます。
riplaは、フルスクラッチ受託の立場から、こうした引き継ぎ性まで含めた要件整理を重視しています。
- 引き渡し物:ソースコード、設定情報、運用手順書、監視設定、アカウント情報
- 引き継ぎの期間:解約予告から切り替えまでに、どれだけの時間を見込むか
まとめ
ITシステム障害復旧のRFP・要件定義書では、(1)監視対象と閾値を漏れなく数値で定義し、(2)稼働率・初報応答・復旧時間のSLAを事業影響度から逆算して保証型で書きます。さらに、(3)クラウドの責任共有を前提に三者の責任分界とRPO・RTOを定め、(4)基本料金の範囲と追加費用の線引き、引き継ぎ条件まで明文化します。この四点が要点です。
99.9%と99.99%の許容ダウンタイムの差や、停止1回あたり1,200万円という損失統計を根拠に、必要十分な数値要件を組み立てることが重要です。過不足のない発注につながります。
要件定義で大切なのは、自社の事業影響度から逆算して必要な水準を見極めることです。「とにかく手厚く」「とにかく安く」のどちらに寄せても、過不足が出ます。曖昧な要件は、安すぎる見積もりの隠れコストや、いざというときの責任の空白を招きます。
riplaはフルスクラッチ受託と国内運用保守の知見から、監視・SLA・クラウド責任・対応範囲を自社の重要度に合わせて要件化し、作った後も伴走する支援を行っています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。