
ITシステムの障害復旧体制を整えたはずなのに、起きやすい失敗は、クラウド監視の任せきり、SLAの決め方、安すぎる見積もり、発注側の初動の四つです。
障害復旧は本番の障害で初めて真価が問われるため、他社の失敗から型を学んでおくことが備えになります。この記事は、失敗とリスクに絞って、発注企業(情シス)の視点から掘り下げます。全体像は、まずITシステム障害復旧の完全ガイドでご確認ください。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
クラウド監視のブラックボックス化という失敗
近年もっとも増えている失敗は、クラウド化で監視がブラックボックス化し、いざ障害が起きても自社で手出しできなくなることです。
クラウド比率は2022年で約5割(IDC Japan)に達し、多くのシステムがクラウド上で動いています。一方で、その便利さの裏には、復旧上のリスクが潜んでいます。
基盤障害でユーザー側が手出しできない失敗
クラウド基盤そのもので障害が起きると、ユーザー企業はその復旧に直接手を出せません。クラウド事業者が復旧するのを待つしかなく、自社のシステムが止まっていても、できることはほとんどありません。
これは「監視はしていたが、復旧の主導権がない」という、従来のオンプレミスにはなかった新しい失敗パターンです。さらに、障害の原因が自社の領域なのか基盤側なのかも、すぐには切り分けられないことがあります。
特に深刻なのは、補償の限界です。クラウド事業者が提供する補償はサービスクレジット(利用料の一部返金)にとどまり、停止中の売上機会損失をカバーするものではありません。
総務省2025年版では、EC系で5分以上の停止が1回あたり平均1,200万円の機会損失とされます。一方で、サービスクレジットで戻るのは利用料のわずかな割合だけです。
「クラウドだから安心」と監視も復旧も委ね切った結果、基盤障害で大きな損失を被るのは、典型的な失敗です。
- 補償の条件:サービスクレジットの対象になる範囲と、戻る金額の決まり方
- 監視の見える範囲:自社で確認できる監視項目と、基盤側に任せる部分の線引き
自衛アーキテクチャを怠るリスクと回避策
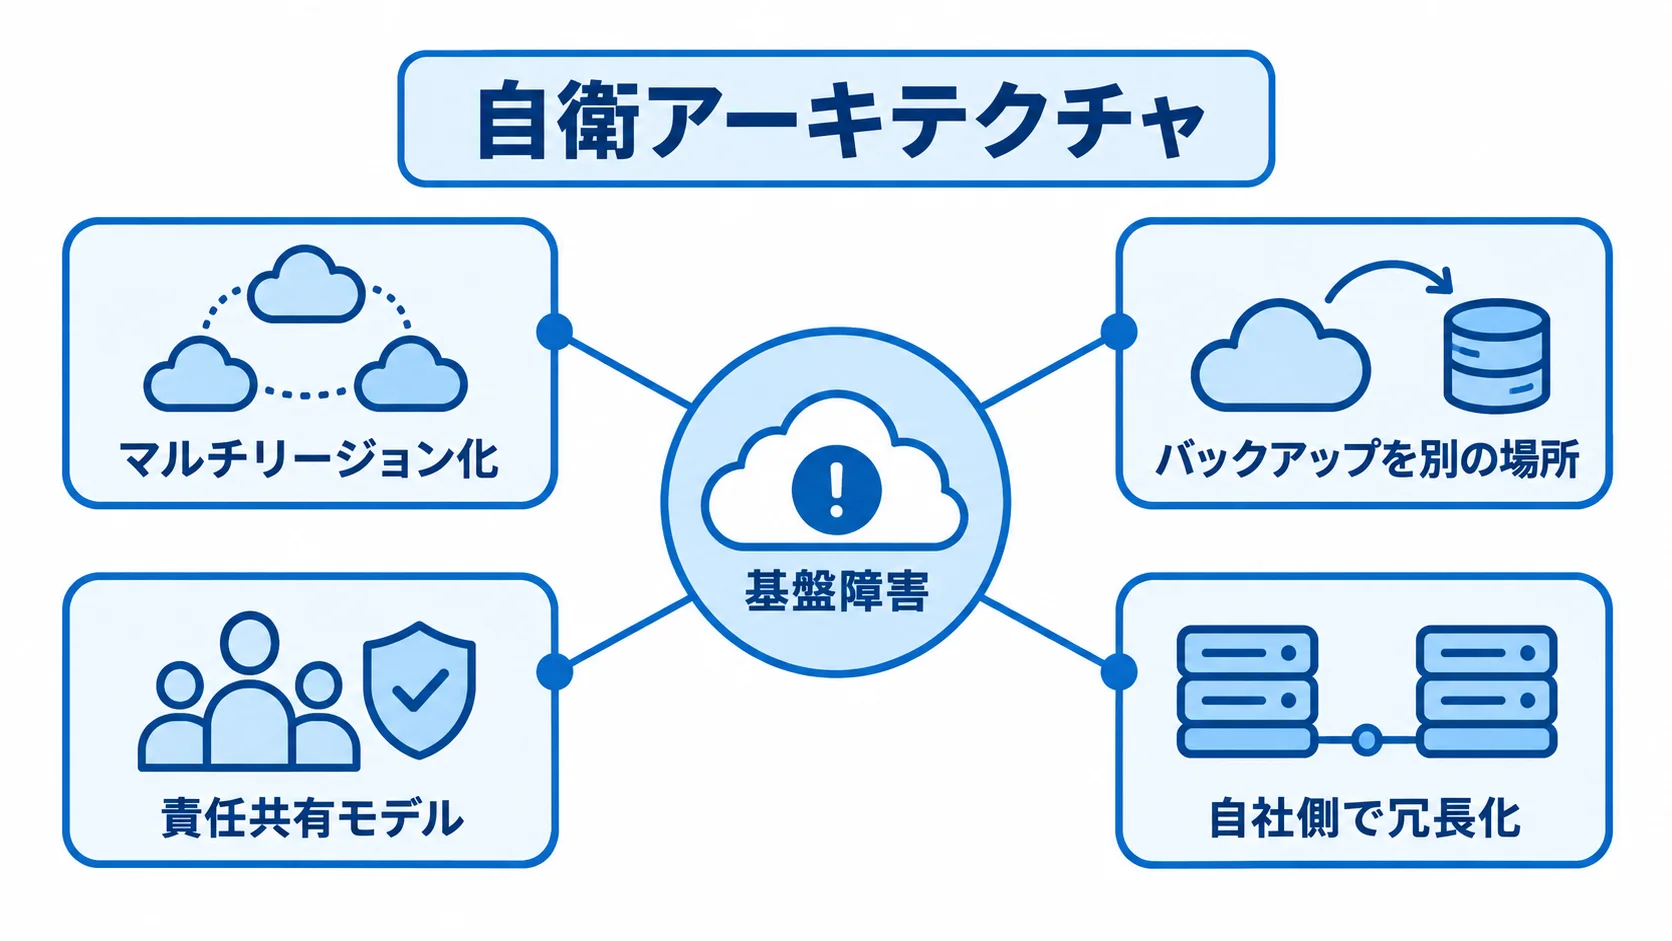
ブラックボックス化への自衛策を怠ると、二次的な失敗を生みます。クラウド基盤の障害は防げなくても、その影響を抑える設計は自社で行えます。具体的な方法は、重要なシステムを複数リージョンに分散するマルチリージョン化や、バックアップを別の場所にも保管する仕組みです。
こうした対策を「クラウドが落ちることなどない」と過信して怠れば、基盤障害がそのまま全面停止につながります。回避策として重要なのは、クラウドの責任共有モデルを正しく理解し、「基盤は事業者、その上のシステムの可用性設計は自社」という線引きを認識することです。
そのため、自社側で冗長化やバックアップ分散を設計しておけば、基盤障害が起きても代替手段で復旧できます。コストはかかりますが、停止1回1,200万円の損失と比べれば、自衛アーキテクチャは合理的な投資です。
ブラックボックス化は、設計段階で自衛策を組み込むことでしか防げません。この認識を持つことが、回避の第一歩です。
- 冗長化の対象:止まると事業に直結するシステム
- バックアップの保管先:同じ基盤に依存しない場所
過剰・過少なSLA設定という課題
障害復旧のSLA設定には、「手厚すぎる」失敗と「足りない」失敗の両方があります。事業影響度から考えずになんとなく決めると、過剰なら無駄なコストを、過少なら復旧の不足を招きます。
過剰SLAによる無駄なコストという失敗
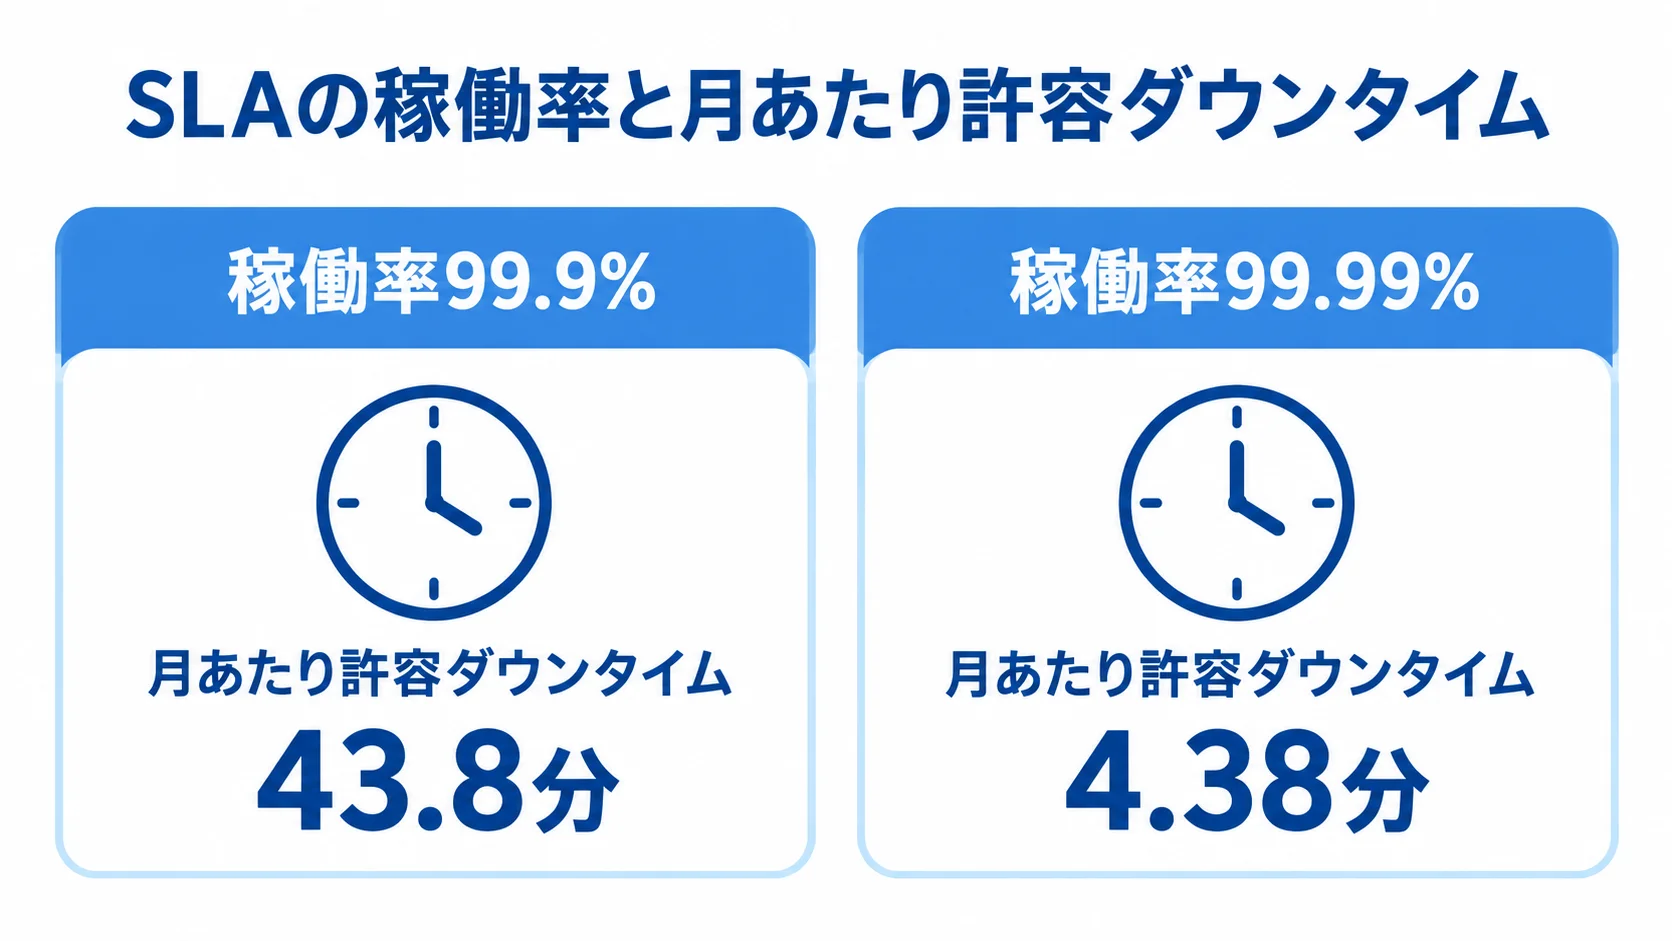
過剰SLAの失敗は、すべてのシステムに最高水準の稼働率を求めてしまうことです。一次データによると、稼働率99.9%の月あたり許容ダウンタイムは43.8分です。99.99%になると月4.38分と桁違いに短くなり、「9」が一つ増えるたびに運用コストが段階的に跳ね上がります。
業務を止めても回せるシステムにまで99.99%を求めれば、その分の費用は丸ごと無駄になります。「安全のため」という名目で見過ごされがちな失敗です。
この失敗が根深いのは、SLAを下げようとすると社内調整が難しいことにあります。業務部門は「うちのシステムの優先度を下げるのか」と反発しがちです。
回避策は、各システムの事業影響度を客観的なデータで示し、関係者が合意することです。情シスがビジネス部門を説得してSLAを適正化する社内調整こそが、過剰コストを減らす実務上の鍵になります。
影響度のアセスメントを行わず一律に高いSLAを敷くのは、典型的な過剰投資の失敗です。
- 損失額:停止1時間あたりいくら損失が出るかを、システムごとに金額で示した数字
- 代替手段の有無:停止中に代替で業務を続けられるかどうかの見極め
過少SLAによる復旧不足というリスク
逆方向の失敗が、過少なSLAです。コスト削減を優先するあまり、止められない基幹系にまで努力目標型の緩いSLAしか設定せず、いざ重大障害が起きると、復旧が遅れて大きな損失を被ります。
Gartner 2024では、ダウンタイム1分あたり5,600米ドルの損失とされます。復旧が数時間遅れれば、損失は膨大になります。安さを優先したSLAが、結果的に最も高くつくという、皮肉な失敗です。
過少SLAのリスクは、平常時には見えないことです。障害が起きない限り「緩いSLAでも問題ない」ように錯覚し、本番障害で初めて復旧の遅さに気づきます。
回避策は、過剰SLAと同じく事業影響度から逆算することです。止まれば事業に直撃するシステムには保証型の手厚いSLAを、影響の小さいものには緩いSLAを設定し、メリハリをつけます。
どちらの失敗も、根本原因は事業影響度のアセスメントを省いたことにあります。システムごとに損失額を見積もり、それに見合ったSLAを設定する一手間が、両方の失敗を防ぎます。
- 基幹系の洗い出し:止まると損失が膨らむシステムの一覧
- SLAの見直し頻度:障害が起きていない時期にも、業務に合っているかを確かめる周期
安すぎる見積もりに潜む罠
ベンダー選定で陥りやすいのが、安さだけで選んでしまう失敗です。複数の見積もりを並べたとき、突出して安いものには相応の理由があります。その理由を見抜けないと、契約後に「こんなはずではなかった」という事態を招きます。
対応範囲外の追加費用という隠れコスト
安すぎる見積もりで最も多いのが、対応範囲が極端に狭いケースです。基本料金には死活監視と暫定的な一次対応しか含まれず、原因調査や恒久対策、報告書作成は別料金、という構成です。
一次データによると、運用・監視の相場は月額5万〜20万円です。24時間緊急対応は月額10万〜20万円なので、これを下回る見積もりは、含まれる範囲が薄いと疑うべきです。いざ障害が起きると、スポット対応(1件3万〜10万円)が次々に積み上がり、結局は割高になります。
この罠を避けるには、安い見積もりに飛びつく前に、「この価格で何が、どこまで対応されるのか」を一覧で問い質すことが欠かせません。金額だけでなく、対応範囲と作業上限を必ず確認します。「月◯時間まで」「月◯件まで」といった上限があれば、超過分が追加費用になります。
- 原因調査と再発防止:含まれていないと、同じ障害でスポット費用が都度かかる
- 対応範囲の内訳:この価格で何が、どこまで対応されるかを並べた一覧
SLA・監視欠如のまま契約するリスク
もう一つの罠は、SLAや監視そのものがないのに、安さで契約してしまうことです。応答時間や復旧時間の保証がない契約では、いざ障害が起きてもベンダーがいつ動くか分からず、復旧が大幅に遅れる可能性があります。
また、監視が手薄であれば、障害の発生に気づくのが遅れ、初動そのものが後手に回ります。安い見積もりが保証や監視を省いて成り立っているなら、その安さは「必要なものが入っていない」結果です。
口頭で「しっかり対応します」と言うだけのベンダーは、要注意です。
障害復旧は、いざというときに約束された水準で動いてもらうための投資です。その約束(SLA)が欠けた安い契約は、最も肝心な場面で機能しません。
価格の安さは、対応範囲・SLA・監視の中身とセットで評価することが、契約段階での失敗を防ぎます。
- SLAの数値:稼働率・初報応答・復旧時間の明記
- 監視の範囲:監視対象と項目が、障害の発生を捉えるのに足りる広さ
ベンダー丸投げと発注者側の初動失敗
障害復旧の失敗で最も見落とされがちなのが、発注者(情シス)側の立ち回りです。ベンダーに任せれば安心と丸投げした結果、障害時に自社側がなすすべなく混乱することがあります。
発注者側の初動は、ほかの失敗パターンと違って自社で完全にコントロールできる領域です。だからこそ、改善の余地が最も大きいといえます。
経営層・業務部門への報告遅延という失敗
ベンダーが復旧作業を進めていても、情シスが経営層や業務部門へ状況を報告できなければ、社内は混乱します。
報告が伝わらないと、業務部門は顧客対応に窮し、経営層は判断を下せません。障害そのものより、この報告の不在が信頼を損なうことがあります。
技術的な復旧はベンダーに任せられても、社内への報告とエスカレーションは情シスの責任です。ここを丸投げ感覚で放置するのは、典型的な失敗です。
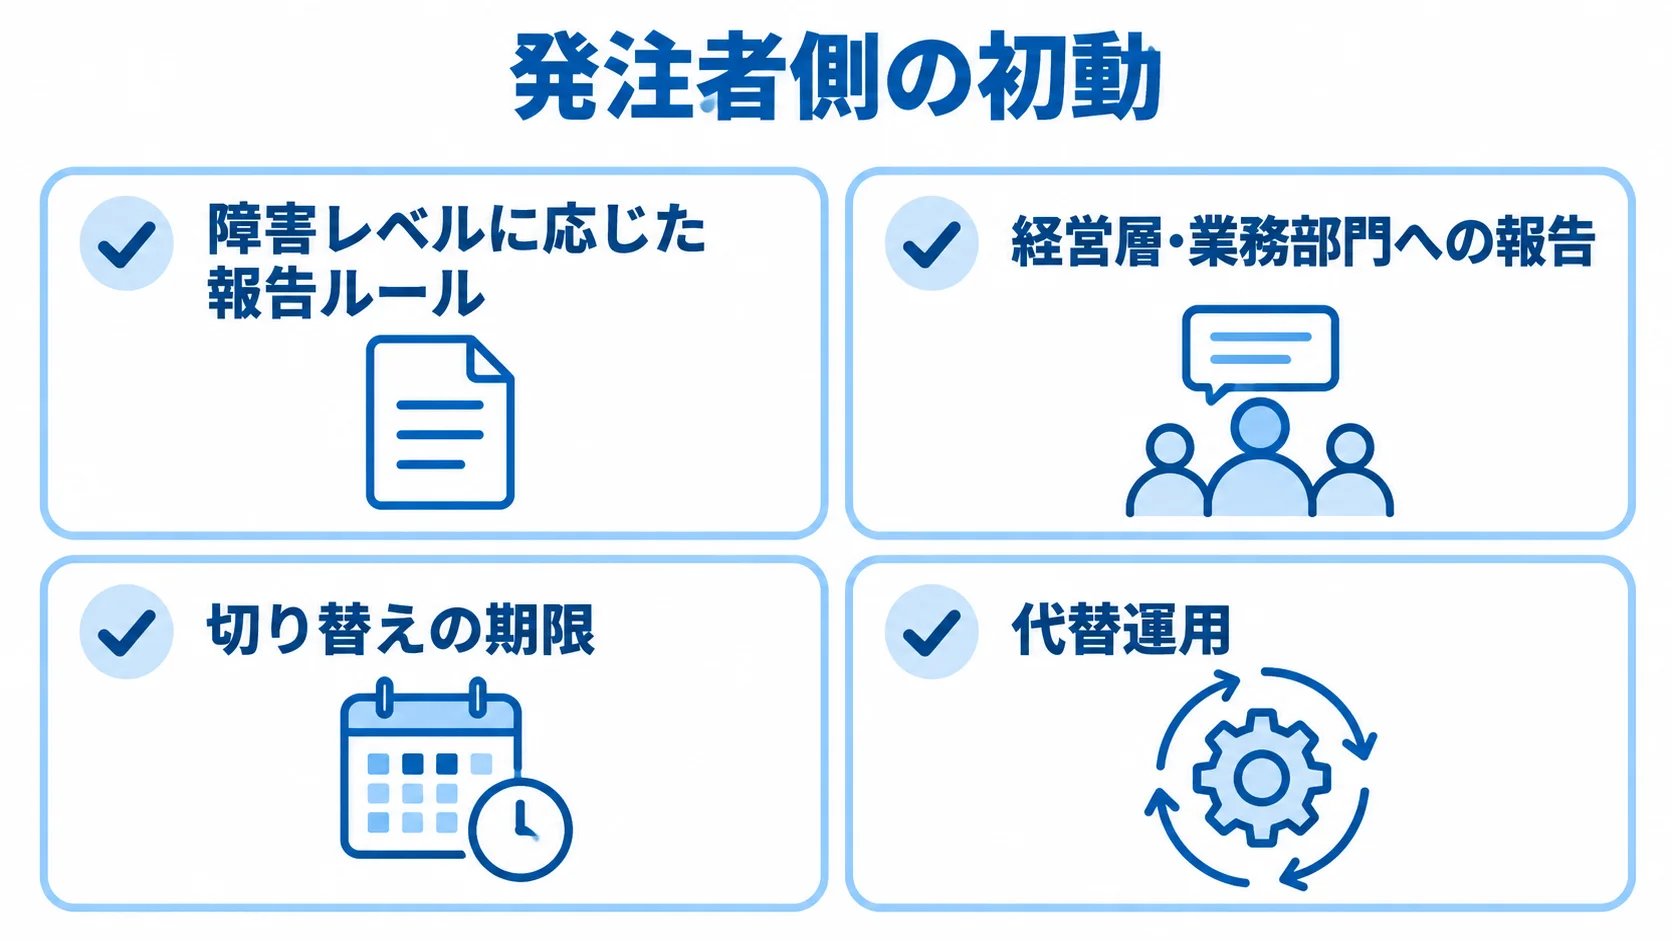
回避策は、障害レベルに応じた報告ルールを事前に定めておくことです。たとえば、一次データでは、官公庁仕様で「1時間以内に障害の内容と予想作業時間を報告」といった初報応答の時間要件が定められています。
これに倣い、重大障害なら情シス責任者が何分以内に経営層へ第一報を入れる、と決めておきます。その後は、復旧の見込みが立たなくても「次にいつ報告するか」だけは必ず伝える必要があります。報告経路を平常時に整備しておくことが、本番での混乱を防ぎます。
- 報告の中身:何が起きているかと、いつ復旧するかの見込み
- 報告の相手:経営層と業務部門、それぞれに必要な情報の違い
BCP不在で代替運用に移れない失敗
発注者側のもう一つの失敗が、事業継続計画(BCP)の不在です。システムが長時間停止したとき、「復旧を待つ」以外の選択肢を持たない企業は、その間ビジネスが完全に止まります。
BCPがあれば、一定時間以上の停止が続く場合でも、代替手段で最低限の事業を回せます。ベンダーに復旧を任せきりで、自社が止まったときの代替運用を準備していないことは、被害を拡大させる失敗です。
回避策は、障害復旧をBCPと連動させることです。これは技術的な復旧体制とは別に、発注者側が主導すべき領域です。
riplaは、フルスクラッチ受託と国内運用保守の立場から、技術的な復旧支援に加えて、発注者側のエスカレーションやBCP連動まで含めて伴走することを重視しています。
発注者が初動・報告・代替運用の主導権を握ることが、最大の失敗回避策です。
- 切り替えの期限:いつまでに復旧しなければ、代替運用に移るかの基準
- 代替運用の内容:手動運用や顧客への告知など、停止中に業務を回す手段
まとめ
ITシステム障害復旧の失敗は、四つのパターンに整理できます。クラウド監視のブラックボックス化は、自衛アーキテクチャを怠ると基盤障害で全面停止を招きます。過剰・過少なSLAは、事業影響度のアセスメントを省いたことから生まれます。
また、安すぎる見積もりは対応範囲・SLA・監視の薄さという隠れコストを抱え、ベンダー丸投げは発注者側の報告遅延とBCP不在という初動失敗につながります。いずれも、停止1回1,200万円、1分5,600ドルという損失を前にすると、事前の備えを怠った代償は極めて大きくなります。
これらの失敗に共通する教訓は、障害復旧をベンダーやクラウドに丸投げせず、発注者側が事業影響度の見極め、自衛アーキテクチャ、報告とBCPの主導権を握ることに尽きます。
技術的な復旧体制を整えるだけでなく、止まったときに事業をどう守るかを自社で設計しておくことが、最大の保険になります。
riplaは、フルスクラッチ受託と国内運用保守を組み合わせ、作った後も伴走しながら、こうした失敗を回避する障害復旧の設計を支援しています。全体像の確認には、あらためて完全ガイドをご活用ください。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。