
ITシステム不具合対応は、業務影響の止血、原因調査と修正、再発防止の事後検証の順に進めると、停止時間を抑えながら収束できます。期間は、業務を再開させる暫定対応と、原因を取り除く恒久対応を別々に捉えると見通せます。
▼全体ガイドの記事
・ITシステム不具合対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム不具合対応の開発期間の全体像
保守監視は、システムを常時見張って異常の兆候を検知し、アラートを発報します。
不具合対応は、発生や報告の後に影響を抑え、原因究明と再発防止を進める実務です。
経済産業省の「DXレポート」は、日本企業のIT関連費用の8割以上が既存システムの運用保守に充てられると指摘しています。不具合対応は日々発生し、開発と情シスの双方のリソースを恒常的に消費します。
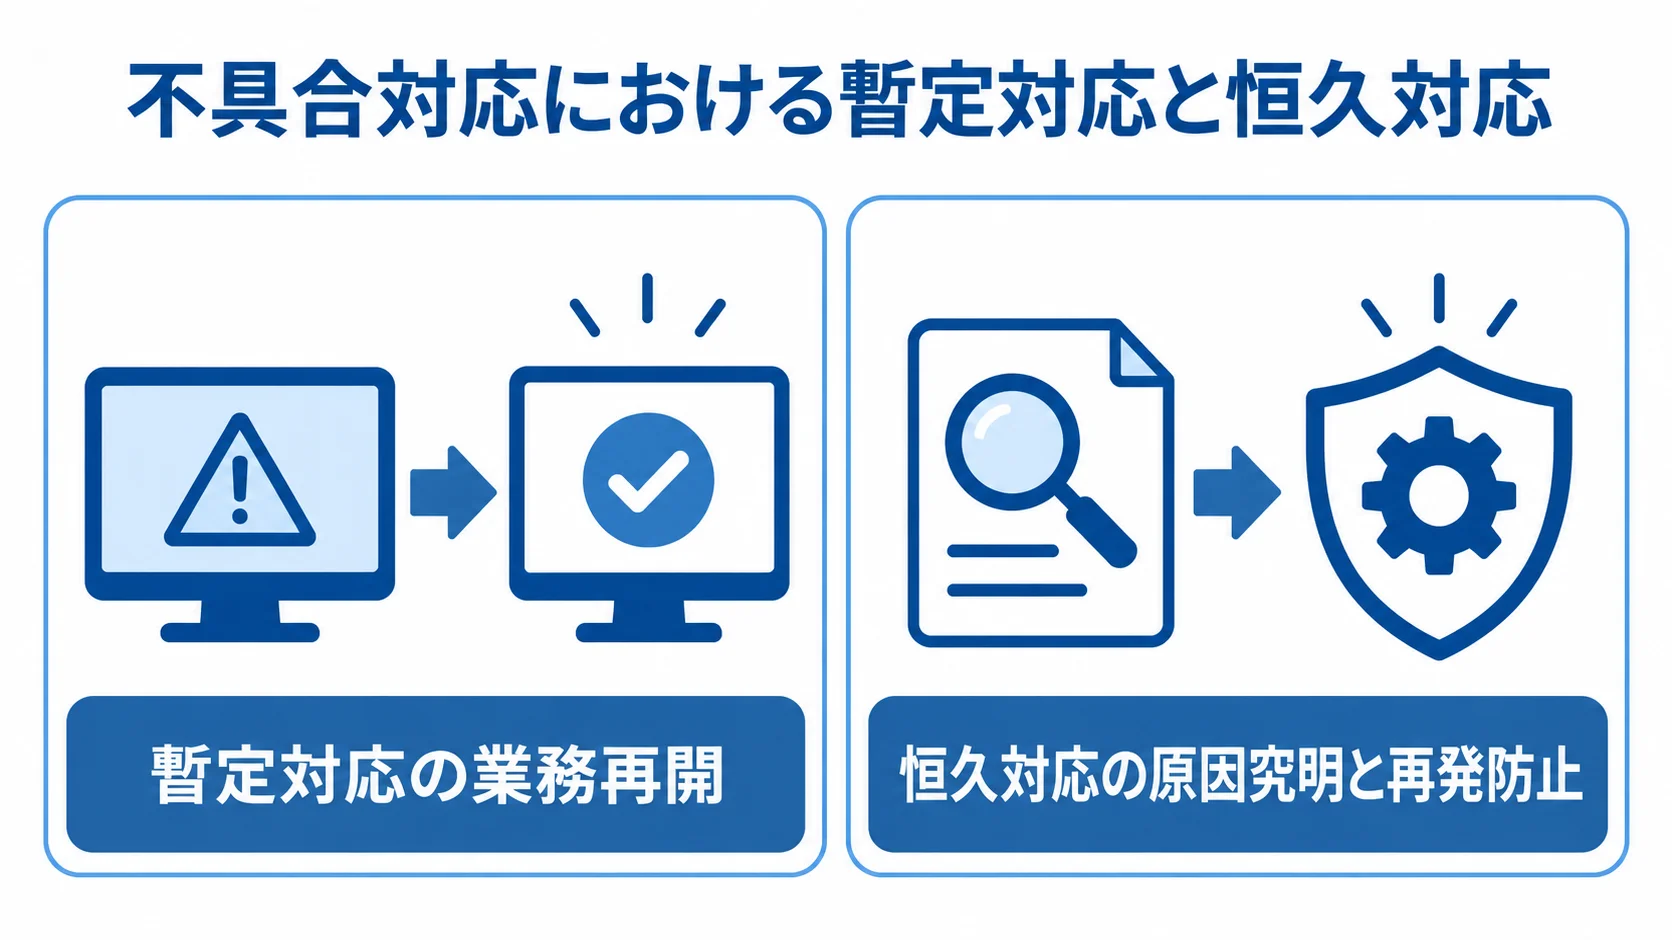
不具合対応の期間は、暫定対応(インシデント管理)と恒久対応(問題管理)に分けて、別々に進めます。特に障害時には、根本解決とサービスの継続復旧を同時に進めると、変更テストや再デプロイに膨大な時間がかかり、停止が長引くおそれがあります。
両者を一括で考えると、現場と経営層の期待がずれ、無理な短納期や、本来急ぐべき止血の遅れにつながります。そこで、暫定対応と恒久対応では期間の考え方が違うことを理解するのが、現実的な計画の出発点になります。
暫定対応(インシデント管理)にかかる時間
暫定対応は、原因究明よりも利用者の通常業務の再開を優先する止血対応です。
- 対応時間:分単位から時間単位の速さを重視
- 応急処置:予備サーバーへの切り替え、再起動、代替手段の提供
- 恒久対応への移行:利用者が業務を再開できた時点で引き継ぐ
原因調査に時間をかけると業務停止が長引くため、この段階では業務影響の停止に目的を絞ります。
切り替えの時点を明確にしておくと、対応チームの役割分担や、経営層・利用部門への状況報告が円滑になります。
恒久対応(問題管理)にかかる期間
恒久対応は、暫定対応でサービスを継続した後、根本原因を取り除いて再発を防ぐ取り組みです。
期間は、技術的な難易度と優先度判定の結果で大きく変わります。
- 調査と修正:ログ分析で原因を特定し、コードやパラメーターを修正
- 検証と適用:本番同等環境で機能を検証してからパッチを適用
- 設定ミス:技術的な難易度や優先度によっては、数日で完了することもある
- 構造的な問題:アーキテクチャに起因する場合、数週間から数ヶ月かかる
- 完了後:先延ばしは再発と工数増につながるため、事後検証まで行う
暫定対応とは違い、恒久対応は中長期にわたって進めます。
障害レベル別のSLA目標復旧時間
納期の見当をつけるには、障害の深刻度に応じて求められる対応時間、つまりSLA(サービスレベル合意)の一般的な水準を知ることが有効です。
すべての不具合を同じ速さで扱うと現場が疲弊します。そこで、深刻度に応じて段階的な目標時間を設定します。
重大度別の初回応答・目標復旧時間
コンサルティング会社などが示す目安では、重大度が上がるほど、初回応答と目標復旧までの時間が短く設定されています。
- Critical(極大):初回応答15分以内、目標復旧1時間以内
- High(大):初回応答30分以内、目標復旧4時間以内
- Medium(中):翌営業日中の復旧が目安
- Low(小):1週間以内の復旧が目安
Criticalは、全社業務が停止し、全ユーザーがアクセスできない状態です。インターネット回線の全断やランサムウェア被害などが該当します。
Highは、部門や特定業務、主要機能が停止する状態です。特定SaaSの停止やサーバー障害などが該当します。
Mediumは、一部の非コア機能に不具合があり、代替手段(ワークアラウンド)がある状態です。
共有は翌営業日の朝会などが目安です。
Lowは、画面表示の乱れなど、実務遂行への影響がない軽微な不具合です。週次定例報告の枠組みで共有します。
可用性の目標には、月間稼働率「99.5%以上」といった指標を使うケースもあります。
自社でレベル分けとSLAを合意しておくと、現場が対応時間を判断しやすくなります。区分がないと、軽微な不具合にも重大障害と同じ体制を使うことになり、優先すべき対応が遅れるおそれがあります。
企業事例に見る実際のMTTA・MTTR
SLAの目標値に加えて、企業の実際の対応速度も、自社のスケジュールを考える参考になります。
PagerDutyが公開する事例では、株式会社ココナラがインシデント管理ツール(PagerDuty)を導入しています。
- 平均確認時間(MTTA:Mean Time To Acknowledge):日中のアラートは1分以内
- 平均修復時間(MTTR:Mean Time To Repair):暫定対応として1営業日程度
仕組みを整えれば、アラートの認知から暫定対応の完了までを短縮できます。
ツールや体制がない組織では、同じ深刻度でもMTTA・MTTRが長引く可能性が高く、SLA目標と実際の対応力に差が出ることがあります。
不具合の優先度判定とスケジュール決定のプロセス
不具合は、優先度に応じて修正の順番を決めます。
優先度は、システムへの影響を示す重要度と、いつまでに対応すべきかを示す緊急度を掛け合わせて判断します。そのうえで、修正時期は不具合判定会議などで、開発リソースの空き状況を見ながら決めます。
重要度×緊急度マトリクスによる4段階の優先度
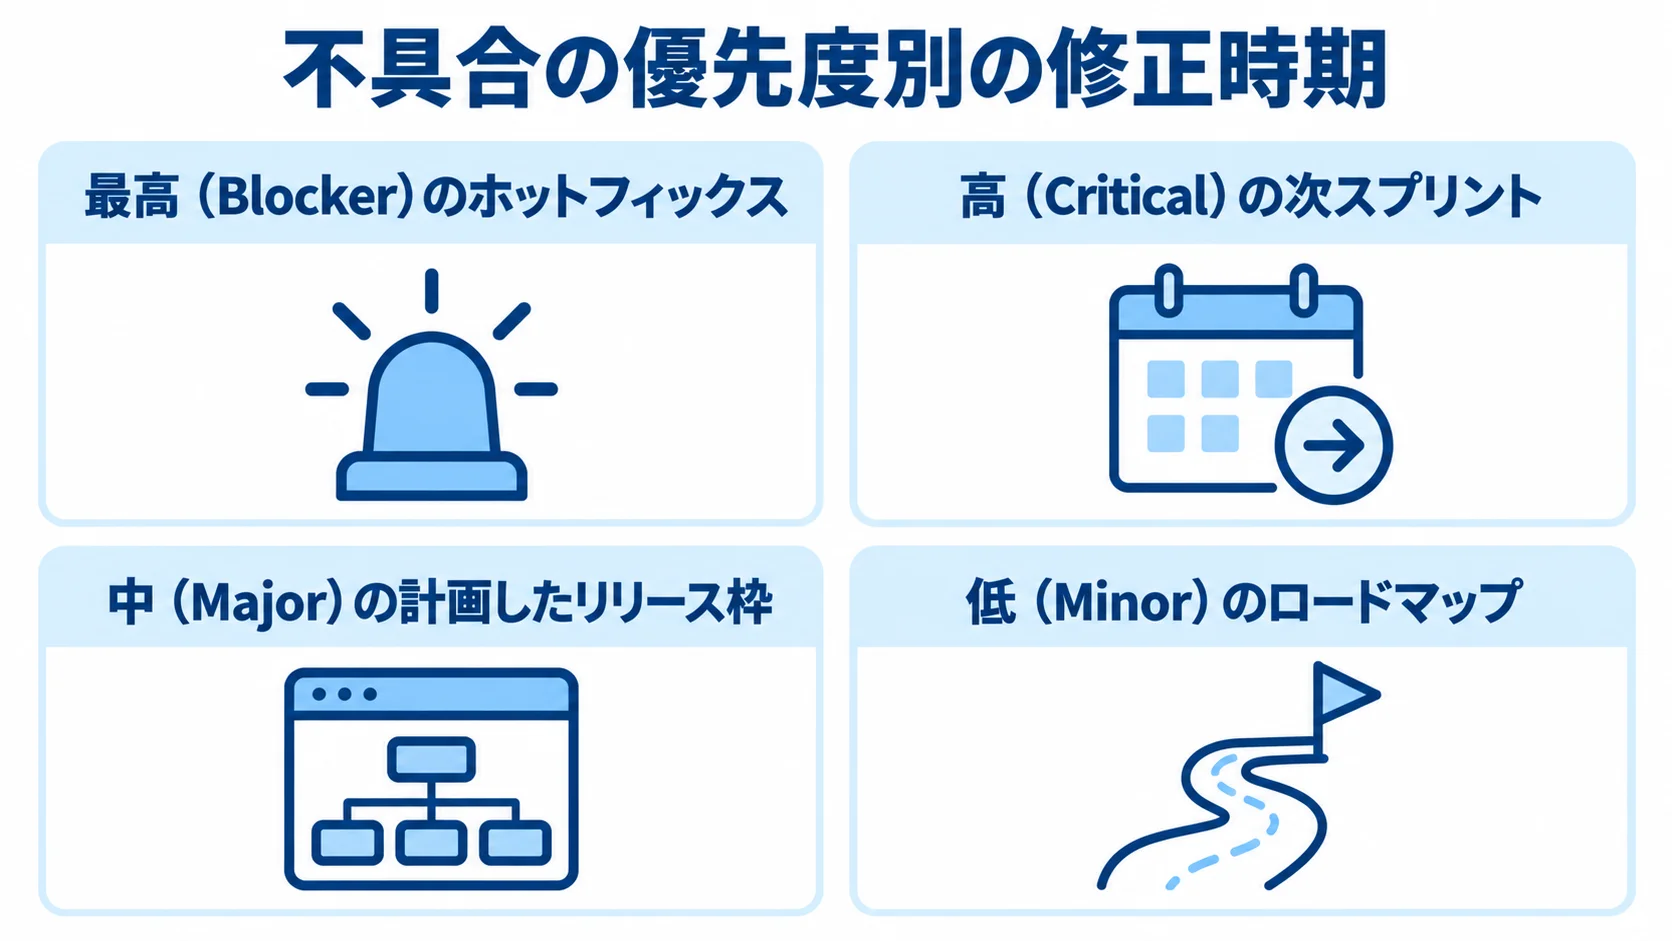
優先度ごとに修正の時期と進め方が異なります。次の区分でスケジュールを考えます。
- 最高(Blocker):全タスクを直ちに中断して行う、アドホックなホットフィックス(緊急修正)
- 高(Critical):次のスプリントか数週間以内の修正
- 中(Major):計画したリリース枠での順次修正
- 低(Minor):ロードマップに余裕が出てからの修正
最高は、コア機能の著しい破損や致命的な脆弱性がある状態です。リリース予定日や顧客との契約期限が数日以内に迫る場合も該当します。
高は、主要機能が動かず、複雑な代替手段で回避できる状態です。
高の不具合は、バックログの最上部に置いて修正します。
中は、補助機能の停止や特定環境下の不具合です。緊急度が低く、一定期間保留しても実害がないと判断した場合は、計画枠で消化します。
低は、軽微な表示崩れやスペルミスなど、操作に支障がない不具合です。数ヶ月から半期ほど保留しても問題がないと判断し、余裕が出た時点で修正します。
優先度によって、修正期間は数日以内から数ヶ月〜半期まで変わります。
優先度判定の主導者
優先度判定の主導者を定めることが、納期の一貫性を保つ助けになります。
- 発見者だけで決めない:テスト担当者やエンジニアの単独判定は避ける
- 検出者バイアス:発見者は自分の見つけた不具合を急いで直したいと考えがち
- 主導者:開発全体を理解するプロダクトマネージャー(PM)やプロダクトオーナー(PO)
さらに、発見者は残っている技術的負債や全体のリリース予定を、十分に把握できていない可能性があります。こうしたガバナンスがあると、組織として一貫した納期で不具合対応を進めやすくなります。
切り分け・再現確認から恒久対応完了までの標準フロー
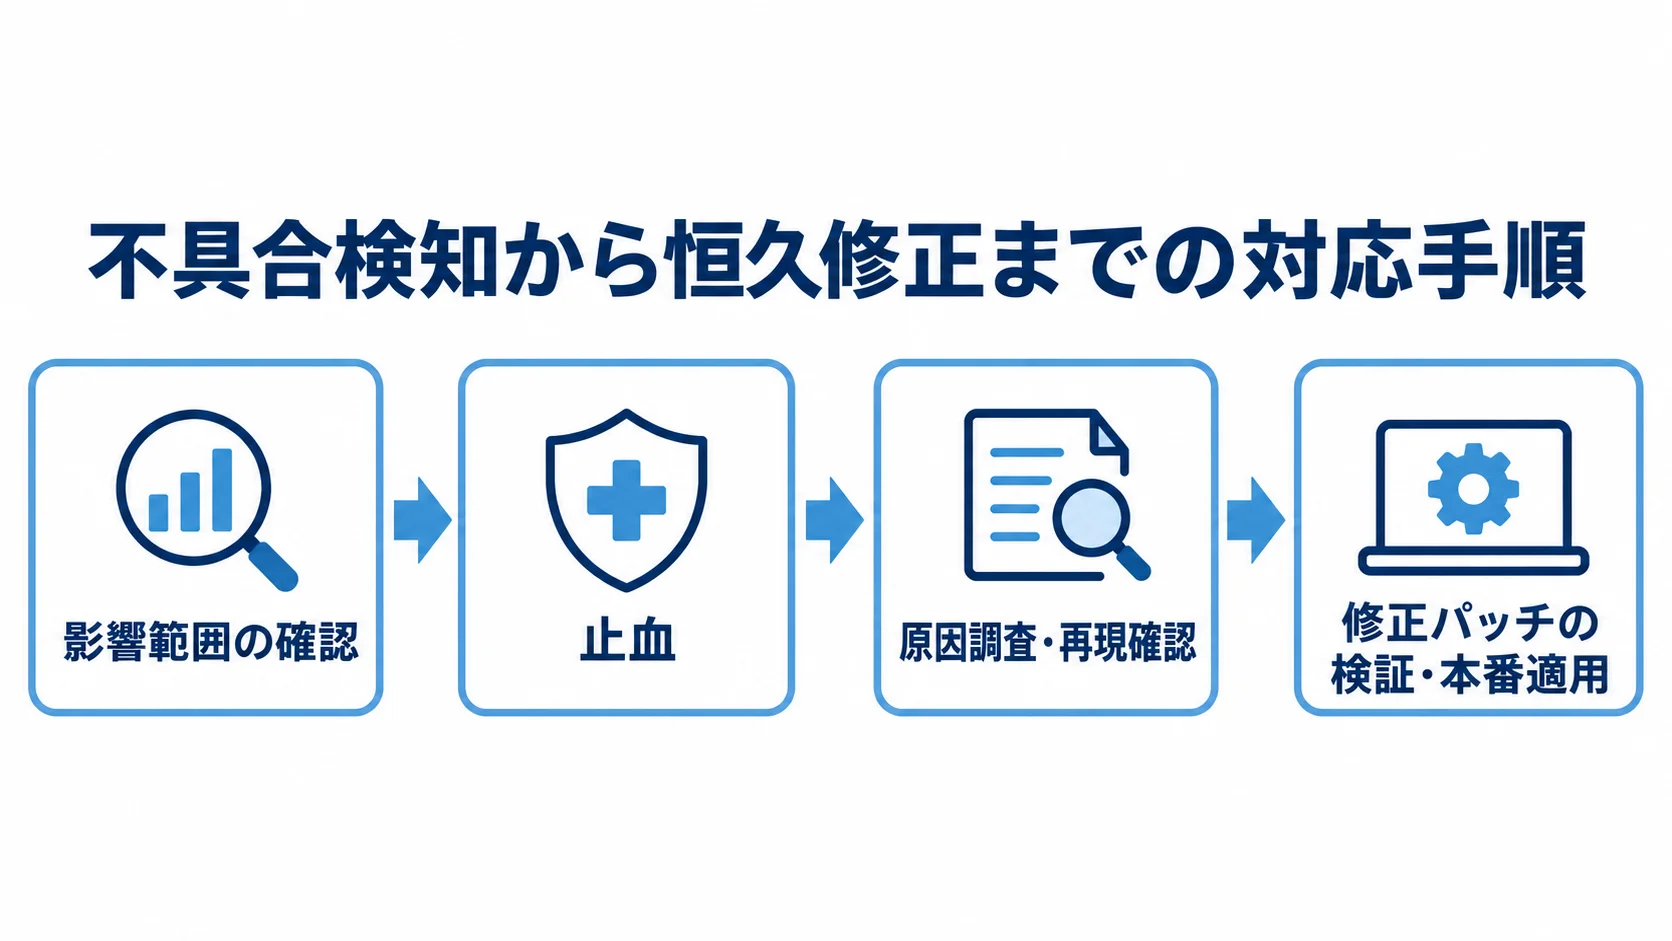
ここまでの期間の考え方、SLA、優先度を踏まえると、不具合の発生から収束までの全体のスケジュールを具体的にイメージできます。
発生検知〜暫定対応(止血)までのタイムライン
不具合対応は、発生を検知して一次切り分けを行うことから始まります。認知したら影響範囲を確認し、止血へ進みます。
- 監視ツールのアラートや利用者の問い合わせで認知し、対象機能・利用者・影響の程度を確認します。
- 予備システムへの切り替え、再起動、代替手段の案内で業務影響を止めます。
- 止血後に原因を究明する段階へ進みます。
一次対応は、Critical〜Lowの障害レベルに応じた初回応答時間内に始めます。この段階では、原因の完全な特定までは目指しません。
止血は、各レベルの目標復旧時間を目安に完了させます。例えば、Criticalは1時間以内、Highは4時間以内が目安です。
この段階の対応スピードは、後続の原因調査や恒久対応の予定に直接影響しません。
一方で、業務影響を先に抑えることが、全体の対応期間の短縮につながります。
原因調査・再現確認〜恒久対応・パッチ適用までのタイムライン
サービスが継続できたら、原因調査からパッチ適用までを順に進めます。
- ログ分析で発生条件を特定し、開発環境や検証環境で再現して原因の仮説を検証します。
- 原因特定後、不具合判定会議などで優先度を決め、予定に沿って修正パッチを開発します。
- パッチは、本番同等環境で不具合の解消と新たな不具合がないことを検証してから、本番に適用します。
- 最高は数日以内、高は次スプリントから数週間以内、中・低は数ヶ月から半期が期間の目安です。
ポストモーテム(事後検証)の実施期限
恒久対応で不具合が収束したあとも、対応は続きます。その後、原因分析と再発防止策を話し合うポストモーテム(事後検証)を行います。
- 実施時期:関係者の記憶が新しいうちが望ましい
- 期限の目安:解決後72時間以内、あるいは2〜3営業日以内
- 遅れた場合:経緯や判断根拠が曖昧になり、再発防止策の質が下がる
- 予定への組み込み:恒久対応の完了時に実施日を決め、継続的な改善につなげる
根本原因がシステムアーキテクチャの限界にある場合は、パッチでは対応しきれないことがあります。
そうした場合、大規模な改修や作り直しの検討が必要になることもあります。
判断の基準は、本テーマの「フルスクラッチ・オーダーメイド開発」編で詳しく解説しています。
まとめ
対応期間と障害レベル別の復旧時間を見たうえで、優先度判定、標準フロー、事後対応の期限を順に整理しました。
ITシステム不具合対応は、止血、原因調査と恒久修正、事後検証の順に進めます。暫定対応は分単位から時間単位で業務影響を抑えます。一方で、恒久対応は調査・検証・パッチ適用を含む中長期の工程です。
障害レベル別の復旧目標はCriticalが1時間以内、Highが4時間以内などです。優先度は重要度と緊急度で判定され、修正時期は数日以内から数ヶ月〜半期まで変わります。判定は開発全体を理解するPM等が主導します。
期間はシステムの複雑さや技術的負債によって左右されます。
現状のシステム構成と求めるSLA水準を、複数の開発会社・保守運用パートナーに示して相談することをお勧めします。
▼全体ガイドの記事
・ITシステム不具合対応の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。