
不具合対応では、PoC(概念実証)やプロトタイプ、モックアップを使い分けます。原因を調べる再現確認にはモックアップを、恒久対応の方針が不具合を解消するかを確かめるにはPoCやプロトタイプを使い、本番同等の環境で試験してから修正を適用します。
▼全体ガイドの記事
・ITシステム不具合対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
不具合対応におけるPoC・プロトタイプ・モックアップの位置づけ
PoC(概念実証)やプロトタイプ、モックアップは、新規開発の前に小さく試す手法です。
不具合対応でも、安全な再現や影響範囲の確認、修正方法の検証に役立ちます。
新規開発のPoCは「作るべきか」を判断します。
一方、不具合対応の検証は「どう直すか」「その方法で解決するか」を見極めます。
再現確認のための「モックサーバー」活用
決済代行サービスや外部の在庫連携など、自社で制御できないシステムの不具合は、本番で意図的に再現できません。本番で試すと、二次被害や顧客への実害につながるおそれがあります。
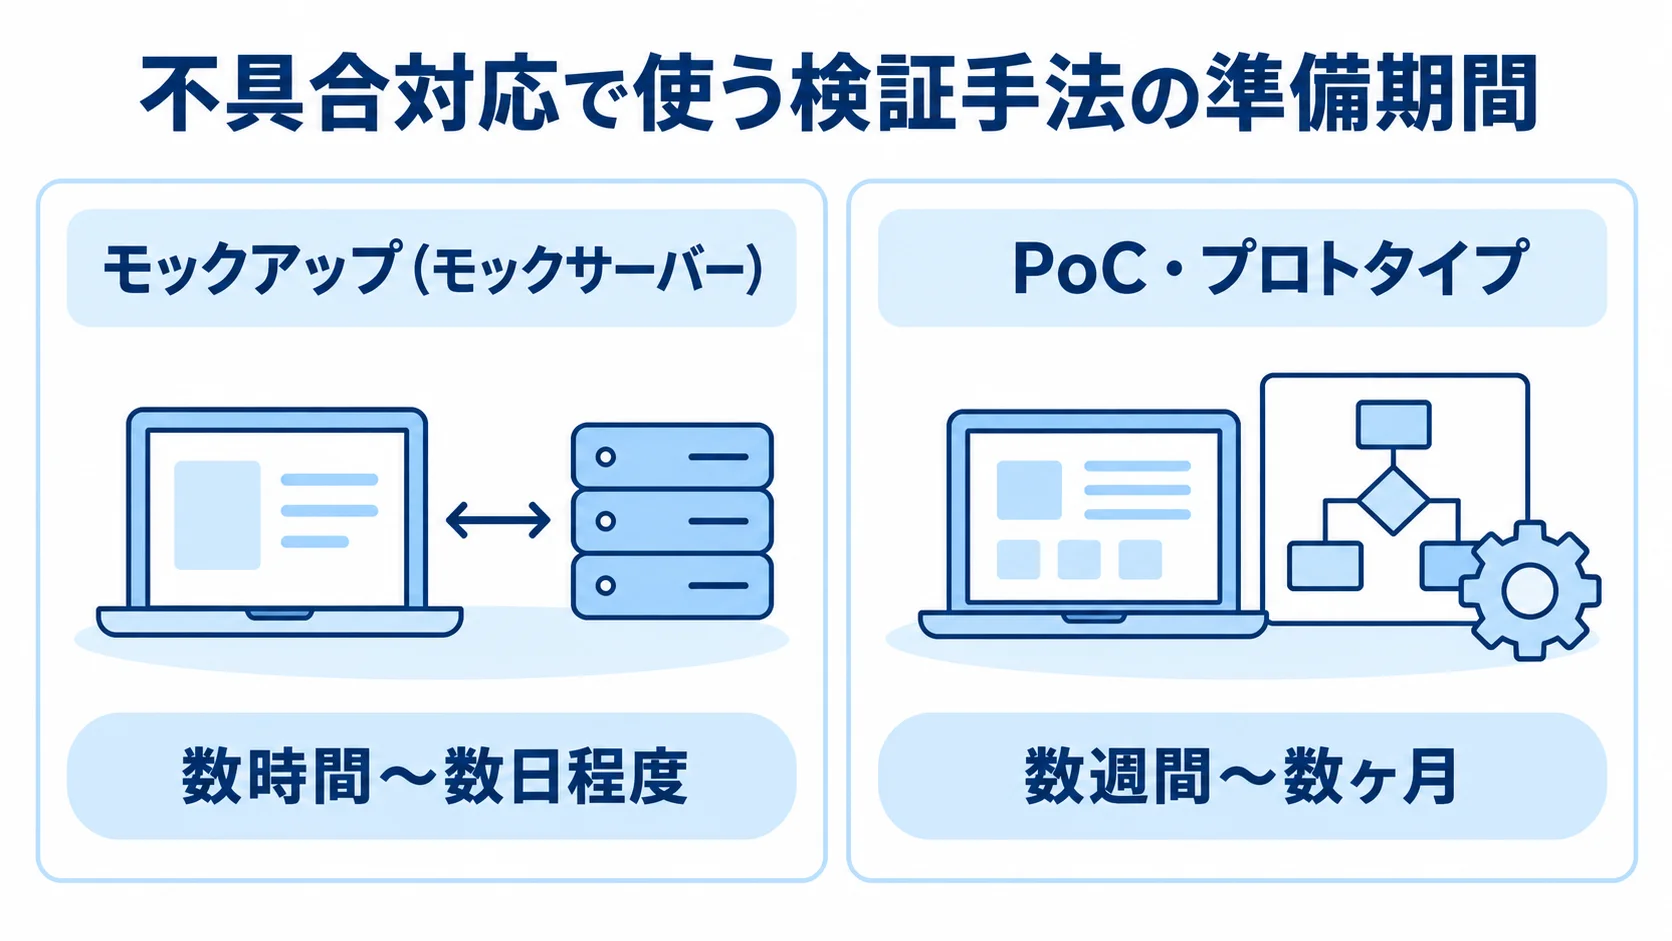
そこで使うのがモックアップ(モックサーバー)です。外部システムと同様のエラーや遅延を疑似的に返す仕組みで、検証環境で再現テストを行い、影響範囲を調べます。
- 使う場面:外部システムが関わる原因調査と再現確認
- 準備期間:簡易なモックなら数時間〜数日程度
モックは本格的なシステムを作らずに初動から使えるため、原因調査の速さが不具合対応全体のスケジュールを左右します。
恒久対応検証のためのPoC・プロトタイプ
原因が、アーキテクチャの限界やデータベース設計の欠陥と判明する場合があります。パッチだけでは同じ不具合が形を変えて再発しやすいため、抜本的な改修が必要になります。
- 技術の実現性:新技術やデータベースへの移行で解決できるか
- 性能要件:改修方針が求める性能を満たすか
- 複数案の比較:効果とコストを比べ、恒久対応を決める
PoCでは、本格的な改修の前に、方針が不具合を解消するかを小規模に検証します。たとえば、デッドロックには新しい制御方式を試作し、再現しなくなるかを確かめます。
性能要件が関わる場合は、想定負荷を再現した試作で実測値を得て、方針の妥当性を数値で確かめます。
事前検証を省くと、費用をかけても解決しないおそれがあります。
大規模な恒久対応ほど、事前検証が欠かせません。
新技術を試すPoCやプロトタイプには数週間〜数ヶ月かかる場合があり、モックより中長期のリソースを要します。
複数案がある場合は、それぞれの試作を並行して進められます。一案だけで進めると、別方式が確実と後から分かっても戻りにくいため、方針を決める前に選択肢を検証します。
修正パッチの検証環境とテストの実務フロー
原因と修正方針が定まったら、開発会社はパッチを検証してから適用します。検証の丁寧さは、恒久対応の質と、デグレードのリスクを左右します。
本番同等環境での機能検証とパッチ適用フロー
障害時は、サービスを継続するための暫定対応(止血)と、根本原因を取り除く恒久対応を明確に分けます。恒久対応のコードや構成パラメーターの修正は、本番へ直接適用しません。
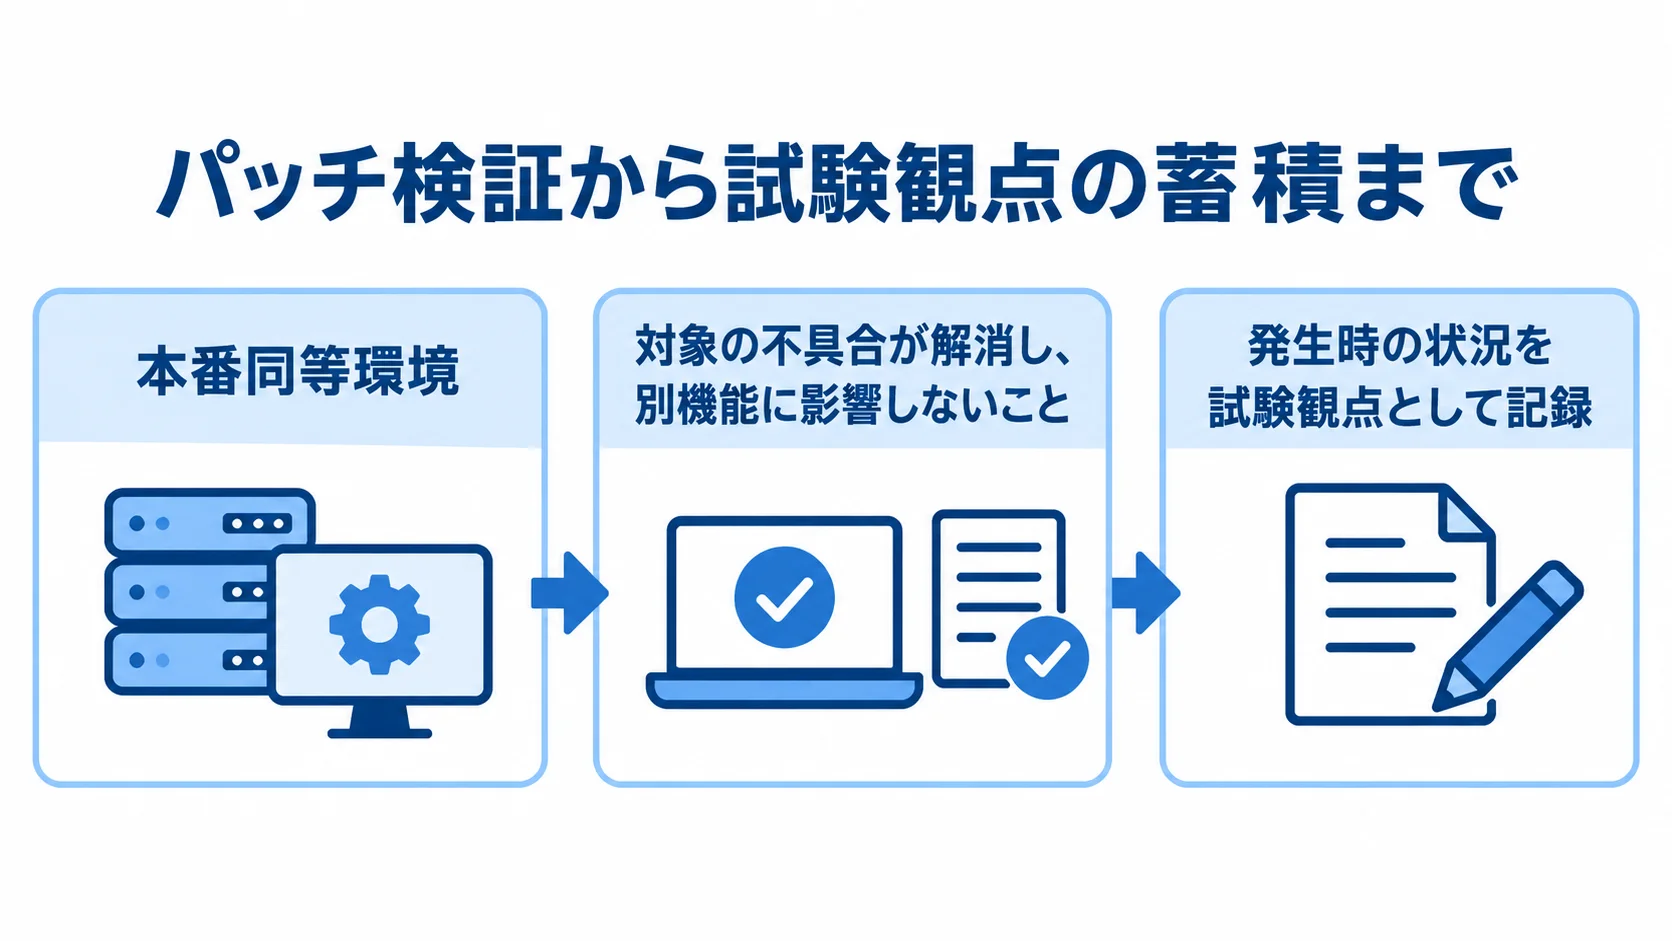
- 検証する場所:ステージングなどの本番同等環境
- 確認する内容:対象の不具合が解消し、別機能に影響しないこと
- 適用前の準備:必要に応じて本番相当のデータと設定を複製
緊急時は、早く直したいという圧力から検証を省きたくなることがあります。しかし、試験を飛ばして本番へ適用すると、より深刻な二次障害を招く事例が後を絶ちません。そのため、本番同等環境で機能を十分に試してから適用します。
常設が難しい中小規模のシステムでは、適用直前に一時的な検証環境を用意する方法があります。ただし、環境は平時に整えておくと、不具合発生後の構築による遅れを防げます。
試験観点への追加による再発防止
本番で起きた不具合は、リリース前のテストで検知できなかった問題です。そのため、原因を特定したら、発生時の状況を試験観点として記録します。
- テスト項目に蓄積:不具合が起きた条件を次回の試験に加える
- 手順を資産化:モックサーバーでの再現テストを自動化スクリプトにする
特定の入力値の組み合わせが原因なら、そのパターンをリグレッションテストに組み込みます。別機能を改修するときに、同種の問題が本番へ届くリスクを下げられます。
さらに、試験観点と再現手順を組織のテスト資産として蓄積すると、対応件数に応じて検出率とテストカバレッジが高まります。同種の再発を防げる範囲も広がります。また、自動化した手順は、次回の調査で環境を作り直す手間も省きます。
影響範囲の事前確認と高度な検証手法
修正やリリースが新たな不具合を生まないよう、影響範囲を事前に見積もり、自動検証の導入も検討します。
リリース前の影響範囲事前計算
修正や新機能のリリースでも、本番に出す前に影響を見積もっておく必要があります。恒久対応も一種のリリースであるため、負荷や性能への影響を同じように調べます。
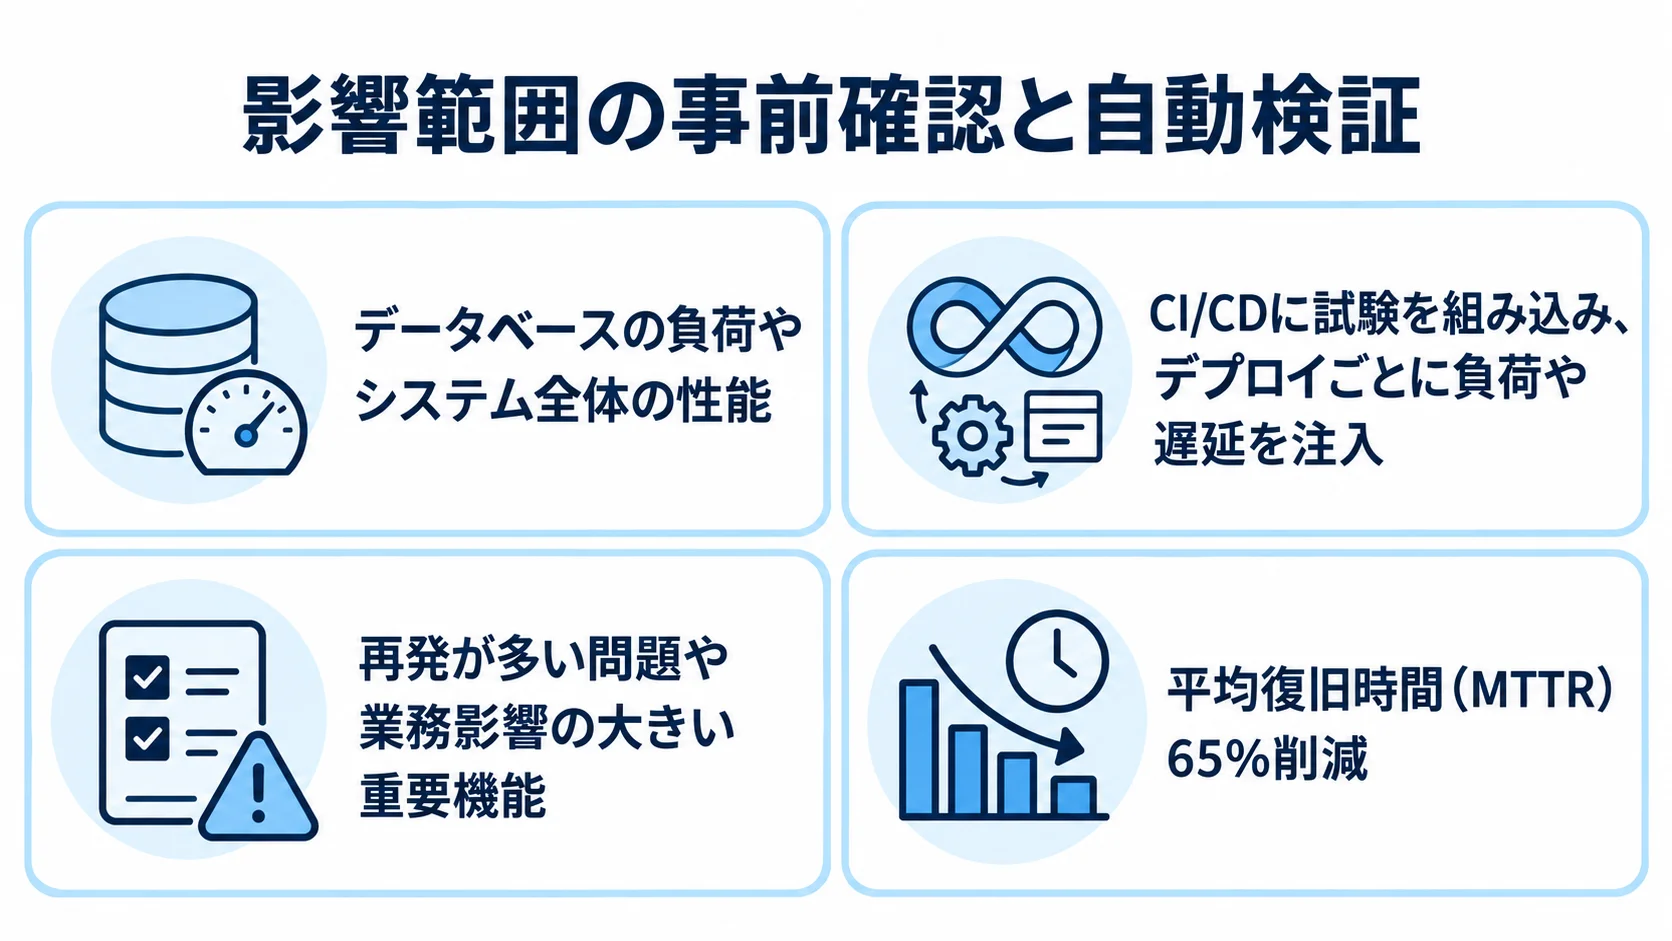
- 試算する対象:データベースの負荷やシステム全体の性能
- 確認の方法:モックアップやプロトタイプ環境で事前に試算
新機能のリリースでデータベース負荷が増えた事例では、遅延やリソース制約のなかで見積もりが甘くなったことが、根本原因とされました。
改善策としては、リソース使用量などの影響を事前に計算し、仕様をディレクターなどと議論すべきだったという教訓が挙げられています。
事前見積もりを怠ると、元の不具合を直しても、別の問題を誘発するおそれがあります。
CI/CDに組み込むカオスエンジニアリング
カオスエンジニアリングは、修正パッチや新規コードを自動で検証する手法です。本番または同等の環境で、モックによる遅延注入などの障害を意図的に起こします。
- 自動検証:CI/CDに試験を組み込み、デプロイごとに負荷や遅延を注入
- 段階的な導入:再発が多い問題や業務影響の大きい機能から始める
ある企業は、レジリエンス(回復力)の基準を満たしたコードだけをリリースする仕組みで、平均復旧時間(MTTR)を65%削減しました。
この仕組みでは、想定する障害にパッチが耐えられるかを人手のテストだけに頼らず確かめるため、恒久対応の品質を支えられます。
初期投資は必要ですが、繰り返す不具合をCI/CDに組み込めば、本番到達前に自動で検知できます。また、中長期で投資に見合う効果も期待できます。
まずは、再発を繰り返す問題や業務影響の大きい重要機能から段階的に始めるのが、投資対効果の面でも現実的です。
検証を省略した場合のリスクと注意点
早く直したいというプレッシャーから、検証が省かれることがあります。しかし、省いたことによる問題は、対応の遅れ以上に深刻になる場合があります。
モックアップ検証を省略するリスク
モックによる安全な再現を省き、本番や外部システムとつながる環境で直接調べると、二次被害のおそれがあります。
- 決済への影響:本番APIへのテストで実際の課金処理が動く
- 利用停止:繰り返す要求が外部ベンダーの制限に触れる
さらに、アカウントが一時停止する事態もあります。数時間〜数日で用意できるモックでも、緊急時の焦りから省かれることがあります。
安全な環境を用意せず本番相当の環境で試行錯誤すると、問題が複雑になり、対応期間が長引きます。
影響範囲見積もりを怠るリスク
影響範囲を調べずに恒久対応を出すと、元の不具合を直しても別の障害を招くおそれがあります。緊急時は、検討や関係部署との協議が省かれがちです。
- 組織的な課題:甘い見積もりは個人の技量だけでなく、進め方の問題でもある
- 事前検証:規模が大きい対応ほどPoCや影響計算を省かない
- 平時の準備:モックの型、環境構築手順、見積もりチェックリストを整える
遅延やリソース制約が、見積もり不足の背景にある場合もあります。
大規模な対応では、PoCと影響計算を省かないことが、期間とコストの抑制につながります。
優先度や緊急性が高い問題ほど、検証を急いで省くより、丁寧に確認します。
検証の型を平時に整えると、対応速度と品質を両立しやすくなります。
まとめ
不具合の調査では、モックサーバーで安全に再現します。恒久対応の方針は、PoCやプロトタイプで検証します。
簡易なモックは数時間〜数日、新技術を伴う検証は数週間〜数ヶ月かかる場合があります。
パッチは本番同等環境で確認してから適用し、発生条件を試験観点として蓄積します。加えて、影響範囲の事前計算やカオスエンジニアリングも、修正による新たな不具合を抑える方法です。
検証を急いで省くと、二次障害につながるおそれがあります。そのため、平時に環境や手順を整え、自社の対応プロセスを開発パートナーと見直すことが、緊急時の品質を支えます。
▼全体ガイドの記事
・ITシステム不具合対応の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。