
ITシステム障害復旧とは、サーバーダウンやデータ破損、ランサムウェア被害から、定めた目標時間・時点までにシステムを回復させる仕組みと体制です。平時に備えるDR体制づくりは、要件定義から設計・構築、テストと訓練までの3工程で進み、標準規模なら最短3ヶ月程度が目安です。
特に、BCP(事業継続計画)の一環で経営層から期限を示された場合は、現実的な日程を決めずに始めると、RTO・RPOの合意に時間がかかり、計画が破綻するおそれがあります。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
DR・バックアップ体制構築の開発期間の全体像
DR・バックアップ体制の期間は、目標RTO・RPOの厳しさと、選ぶ方式によって変わります。計画の出発点として、一般的な3工程の流れを押さえておきましょう。
- 現状分析・要件定義:BIAをもとにRTO・RPOとDRサイトを決めます。
- 設計・構築:レプリケーション方式とDR環境を設計し、構築します。
- テスト・本稼働・訓練:フェイルオーバーを検証し、訓練後に稼働します。
設計・構築と、テスト・本稼働・訓練は、それぞれ約1〜2ヶ月が標準的な目安です。
目標RPOが決まると、それを満たすレプリケーション方式が絞られ、方式によってDR環境のネットワーク設計も変わります。
テストでは、本番環境を擬似的に停止し、DR環境への切替と元環境への復帰を試します。目標RTO内に収まるかを確認してから、本稼働に進みます。
要件定義の段階は、BCP方針がどこまで固まっているかで期間が変わりやすい工程です。
3工程の合計は、標準規模のシステムで最短3ヶ月程度です。ただし、要件定義に時間がかかる場合や複数システムが対象の場合は、半年前後を見込みます。
DR方式・対象システム規模別の期間目安
構築期間は対象規模だけでなく、コールド・ウォーム・ホットスタンバイのどれを選ぶかでも変わります。
- コールドスタンバイ:遠隔地やクラウドにデータを保管し、災害時にサーバーを調達するシンプルな方式です。
- ウォームスタンバイ:最小スペックの待機サーバーを用意し、定期的に同期します。
- ホットスタンバイ:本番同等の環境を常時稼働させ、リアルタイムで同期します。
ウォームやホットは、ネットワーク設計と同期方式の検証に時間がかかる傾向があります。特に、秒・分単位のRTOを狙うホットスタンバイでは、自動切替やデータ整合性の検証も必要です。
ホットスタンバイは、標準的な3〜6ヶ月の範囲でも期間が上振れしやすく、その点を見込んでおく必要があります。
対象が基幹システム1つか、複数の関連システムを含むかによっても、要件定義とテストの工数は大きく変わります。
期間を左右する3つの要因
同じ規模でも、構築期間には差が生まれます。
- 要件の合意:BIAとRTO・RPOを決めるための調整の重さが影響します。
- DRサイトの選定:クラウドか遠隔地オンプレミスかで準備が異なります。
- 既存資料の状況:データ構造やシステム間依存関係の文書化状況が影響します。
BIAでは、業務停止による損失を部門をまたいで洗い出し、その重要度に応じたRTO・RPOを経営層や事業部門と合意します。関係者が多いほど、この合意に時間がかかります。
要件が曖昧なまま設計に進むと、後工程で手戻りが生じ、全体の日程を圧迫します。
クラウド型DRサービスは、テンプレートを使えるぶん構築期間を短縮しやすい方式です。一方で、自前で遠隔地のデータセンターを確保するオンプレミス型は、契約や設備の準備に時間がかかります。
そうした資料が整っていない場合、現状分析の調査に時間がかかり、後続の工程も遅れやすくなります。
工程別スケジュールと期間配分
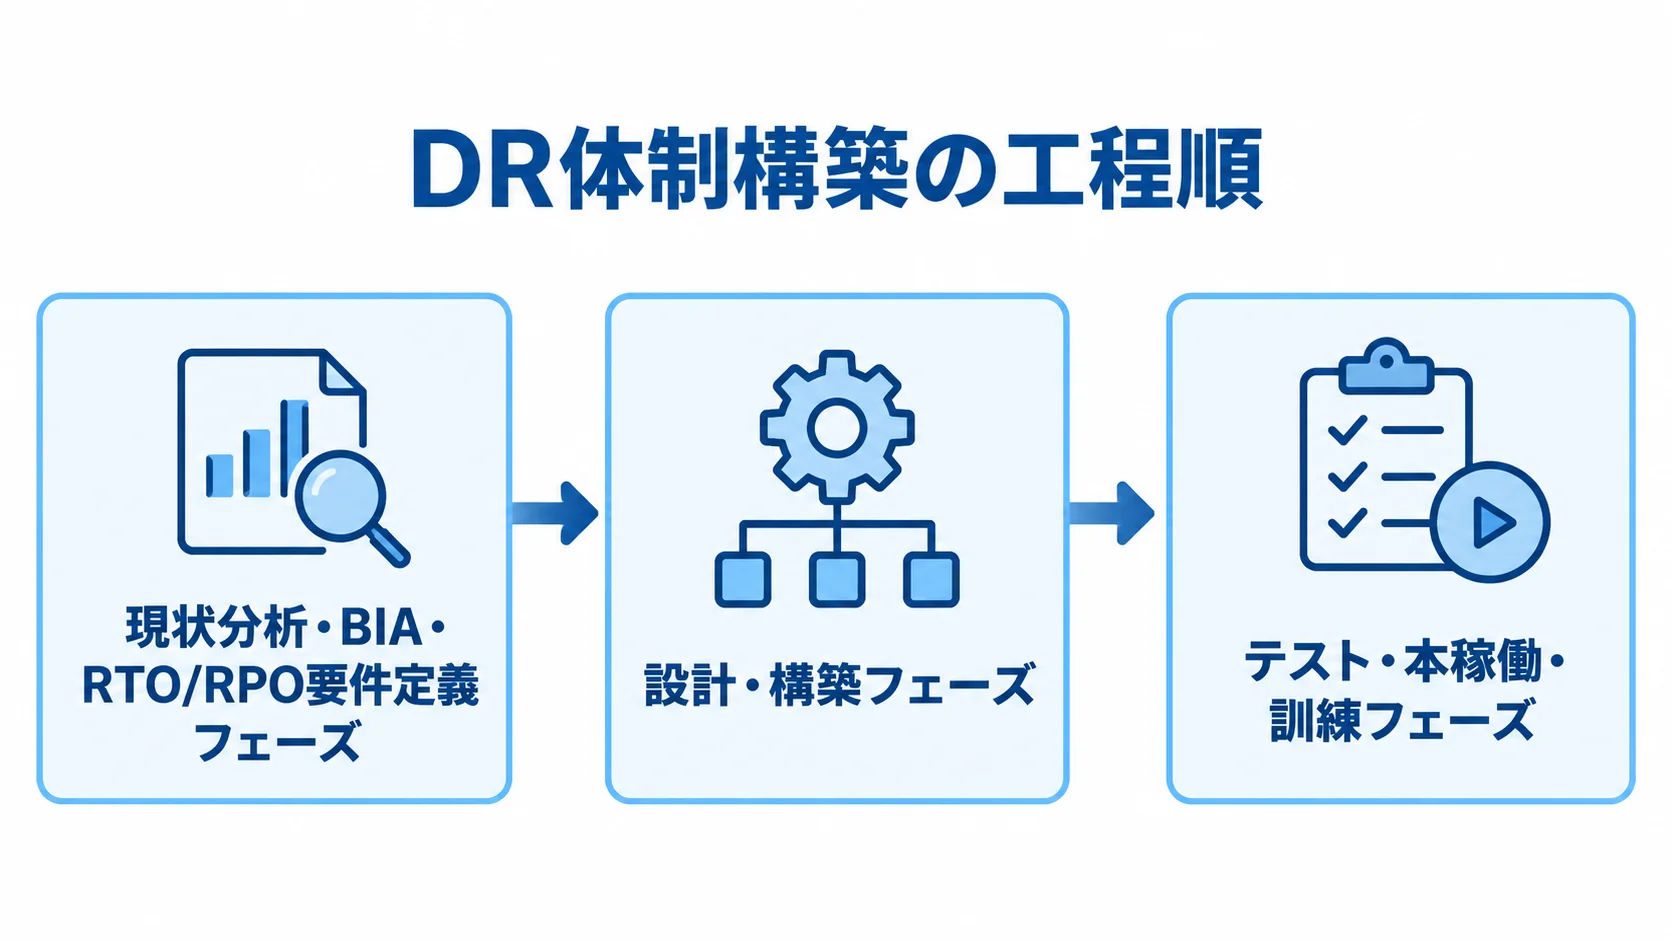
標準的な流れは3工程で、要件を固めてから設計・構築に進み、テストと訓練を経て本稼働します。各段階で確定すべき内容を押さえておくと、スケジュールの遅延を防ぎやすくなります。
現状分析・BIA・RTO/RPO要件定義フェーズ
まず、対象のシステムと業務プロセスを洗い出します。そのうえで、BIA(ビジネスインパクト分析)により、業務停止による損失を見える形にします。
- 復旧目標:BIAの結果をもとに、システムごとのRTO・RPOを設定します。
- DRサイト:遠隔地オンプレミスかクラウドかを選びます。
- 重要度の調整:停止が損失に直結する領域は目標を短くし、影響が小さい領域は緩めます。
部門をまたぐ合意が要るため、要件定義書をまとめる期間には余裕を持たせます。必要な期間は案件によって幅があり、相応の時間を見込んでおく必要があります。
数値目標が曖昧なまま次工程に進むと設計の手戻りにつながるため、この段階で丁寧に合意しておくことが、結果として全体の納期短縮につながります。
設計・構築フェーズ(約1〜2ヶ月)
RTO・RPOとDRサイトの方針が固まったら、設計・構築に移ります。標準期間は約1〜2ヶ月で、その間に方式の決定、ツール導入、ネットワーク構築を進めます。
- レプリケーション:目標RPOに合わせて、同期か非同期かを決めます。
- ツール導入:バックアップツールを導入します。
- 環境構築:クラウドDRではネットワークを設計・構築します。
遠隔地オンプレミスの場合は、物理設備の手配やネットワーク回線の敷設も必要になり、期間が延びることがあります。
データ損失をほぼゼロに近づける同期方式は、非同期方式より回線帯域や遅延の検証に時間がかかります。目標RPOが厳しいほど、この工程も長くなります。
テスト・本稼働・訓練フェーズ(約1〜2ヶ月)
構築後は、本番環境を擬似的に停止し、DR環境への切替と、復旧後に元の環境へ戻すテストを行います。
- 目標の実測:フェイルオーバーが目標RTO内に収まるか確認します。
- 構成の調整:目標に届かなければ、構成や自動化スクリプトを見直します。
- 訓練と移行:複数回訓練して手順を安定させ、本稼働へ移ります。
この工程も標準で約1〜2ヶ月です。単発のテストで済ませず、切替訓練を複数回重ねることが望まれます。さらに、本稼働のあとも、定期訓練で体制の実効性を保つ必要があります。
訓練期間を十分に取らずに本稼働へ進むと、実際の災害時に手順の不備が明らかになるリスクが高まります。
DR方式によるスケジュールの違い
DR体制の中核方式は、コールド、ウォーム、ホットスタンバイの3つです。方式によって日程が大きく異なり、目標RTOも構築期間に直結します。
コールドスタンバイ・クラウド型DRサービスの場合
コールドスタンバイは、バックアップデータを遠隔地やクラウドに保管し、災害時にサーバーを調達します。RTOを数日程度まで許容できる業務に合います。
- クラウドの活用:AWS Elastic Disaster RecoveryやAzure Site Recoveryを利用できます。
- 平時の保管:クラウドの安価なストレージ領域にデータを同期します。
- 準備の簡素化:物理サーバー調達やデータセンター契約が不要です。
設計・構築は、標準の1〜2ヶ月の範囲でも短めに収めやすく、初めてDRを構築する企業や、主要システムから始めたい企業に向きます。
クラウド型DRサービスを使うコールドスタンバイは、納期を優先するプロジェクトの選択肢になります。
ホットスタンバイ・オンプレミス自社構築の場合
ホットスタンバイは、本番と同じ構成を遠隔地で常時稼働させ、リアルタイムでデータを同期します。RTOを数秒〜数分にする方式のため、構築期間も長くなります。
- 設備の準備:オンプレミス型では、遠隔地のデータセンターと本番同等の機器を用意します。
- ネットワーク検証:リアルタイムのデータミラーリングを検証します。
- 独自基盤の開発:監視や自動切替まで作る場合は、さらに期間を見込みます。
フルスクラッチで仕組みを作る場合は、要件定義や技術検証にも期間が必要です。詳しくは、本テーマの「フルスクラッチ・オーダーメイド開発」編で解説しています。
納期を優先する場合はクラウド型DRサービス、自社要件に合う基盤を時間をかけて整える場合はオンプレミス自社構築、と分けて検討できます。
納期を短縮する具体的な方法
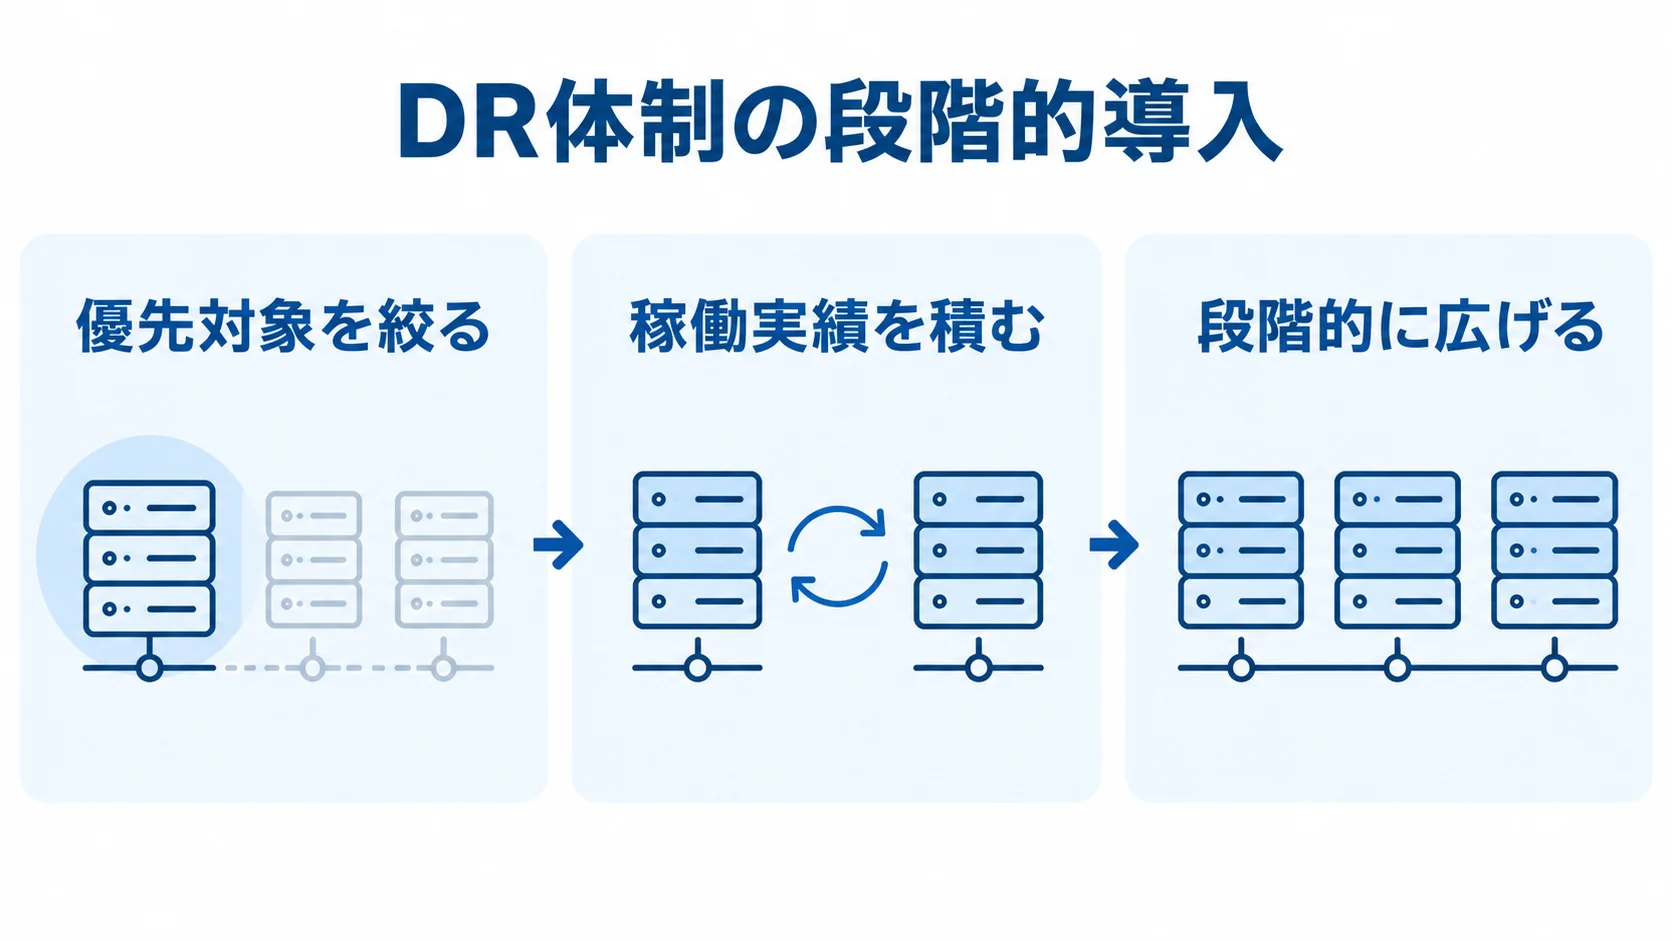
DR体制の導入期間は、工夫しだいで短縮できます。復旧力(RTO・RPOの達成度)を損なわずに進めるには、対象の絞り込みと、既存のテンプレートやサービスの活用が効きます。
Tier別の段階的導入(スモールスタート)
まず、BCP上のTier1(最重要:停止すると事業が停止する)に指定した基幹システムから着手します。
- 優先対象を絞る:事業継続への影響が大きいシステムを先行させます。
- 稼働実績を積む:要件定義・設計・テストを完了し、復旧力を早期に確保します。
- 段階的に広げる:次年度以降にTier2、Tier3へ対象を拡大します。
全システムを一度に対象にすると、BIAやRTO・RPOの合意形成に膨大な時間を要し、導入期間が間延びします。
導入を段階的に進めれば、初期の立ち上げを短縮でき、対象範囲を一度に広げるよりプロジェクトの複雑さも抑えられます。
クラウド型DRサービスとテンプレートの活用
クラウド型DRサービスのテンプレートを使うと、設計・構築を短縮できます。契約形態やPoCの時期も、工程に合わせて検討します。
- テンプレート:AWS Elastic Disaster RecoveryやAzure Site Recoveryの初期設定を活用します。
- 契約形態:要件定義は準委任、仕様確定後の設計・構築は請負とします。
- 事前検証:設計前に小規模なPoCを組み込みます。
レプリケーションやネットワークのテンプレートは、ゼロから設計するより短期間での構築に役立ちます。
要件が未確定のBIA・RTO/RPO工程は準委任、仕様が確定したあとは請負に分けます。こうすると、要件変更による手戻りを抑え、計画どおりに進めやすくなります。
設計前に、2〜4週間程度の小規模なPoC(詳細は本テーマの「PoC・プロトタイプ・モックアップ開発」編を参照)を行い、レプリケーションの実現性を先に確かめる方法もあります。
納期遅延の典型要因と対策
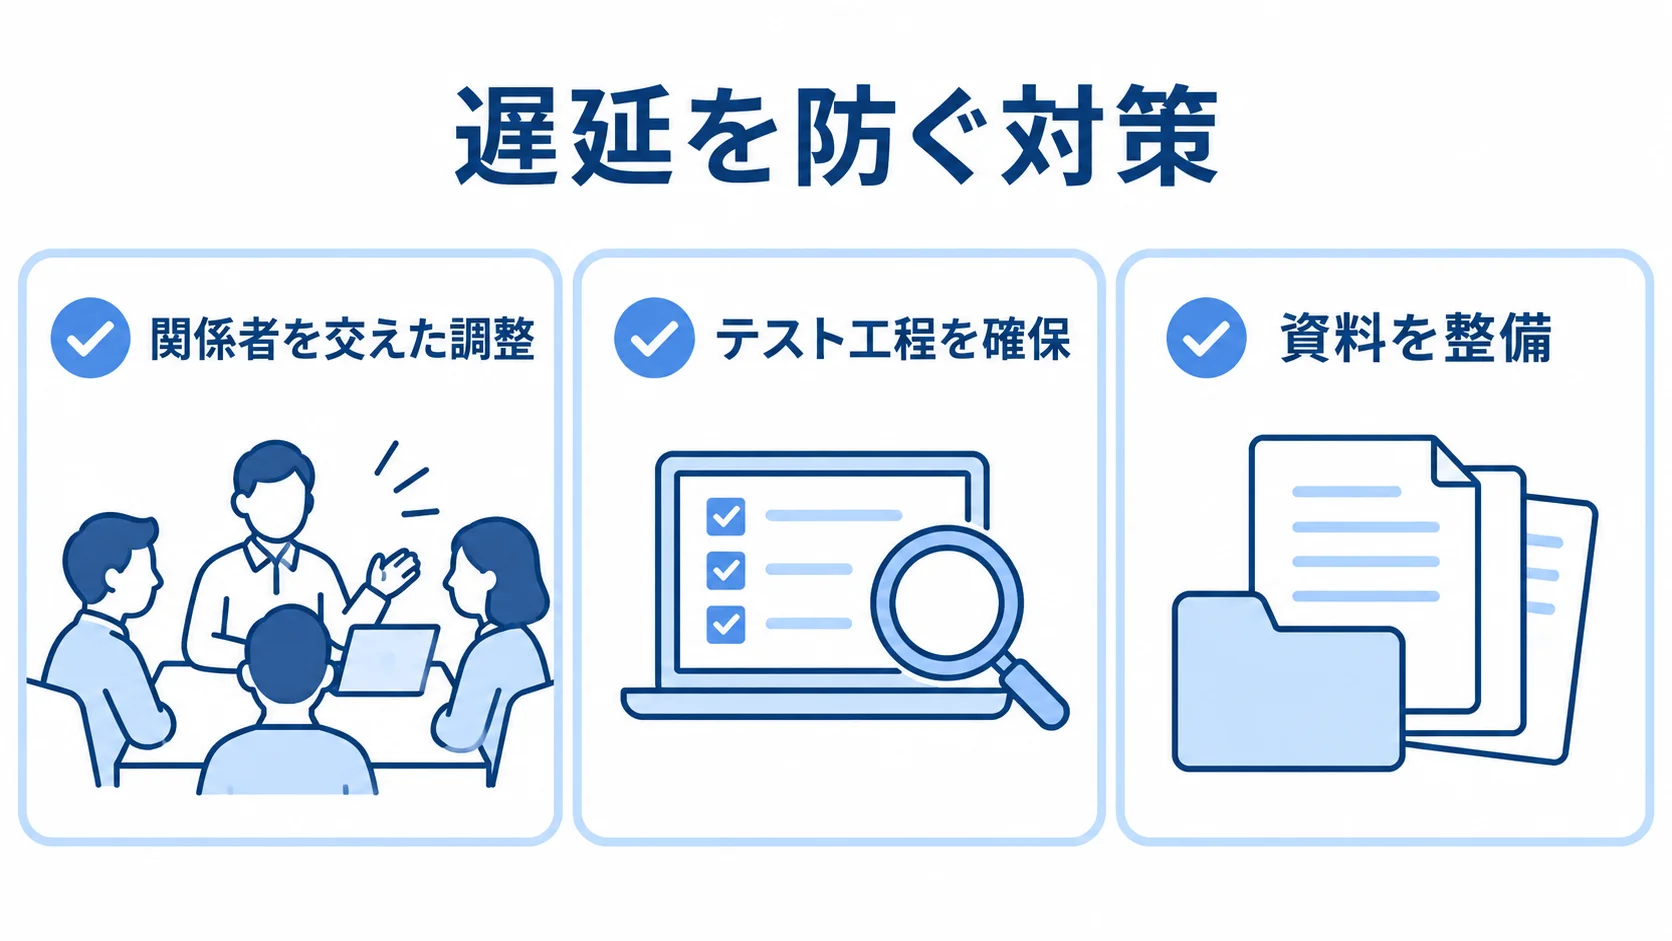
綿密に計画しても、遅延のリスクは残ります。そこで、起きやすい要因を事前に把握し、対策を契約や進捗管理の仕組みに組み込みます。
BIA・RTO/RPO合意形成の遅れ
よくある遅延要因は、BIAとRTO・RPOの目標をめぐる部門間の合意が長引くことです。復旧の速さは、技術部門だけでは決められず、事業部門や経営層を含めた合意が欠かせません。
- 関係者を交えた調整:事業部門と経営層を含めて目標を決めます。
- 目標の文書化:具体的な数値と対応フローを早期に記録します。
調整を軽視して技術部門だけで仮の目標を置くと、設計終盤やテストで「さらに短いRTOが必要」と判明し、大きな手戻りになることがあります。
ある自治体の調達仕様書では、障害の初期報告から原則4時間以内の復旧を明記しています。同じ仕様書では、4時間以内の復旧が困難な場合に代替機で機能を確保することも求めています。復旧に4時間以上かかる場合は、翌開庁日17時15分までに復旧計画を作成して承認を得る条件です。
仕様書の条件を早い段階で整理しておくと、後工程の遅延を防げます。
テスト・訓練フェーズの圧縮リスク
第二の遅延要因は、納期が迫ると削られやすいテスト・本稼働・訓練の圧縮です。本来は約1〜2ヶ月かける工程です。
- テスト工程を確保:訓練を、削減してよい余剰工程には含めません。
- 資料を整備:対象データやシステム構成は、文書に残します。
- 現状分析に工数を確保:依存関係の調査を、工程計画に組み込みます。
訓練を1回のテストに減らして本稼働すると、災害時に初めて復旧できないという問題に気づくおそれがあります。
バックアップから実際に戻せない、または自動切替スクリプトが想定外のエラーで停止するなど、重大な問題が本番で発覚しかねません。
資料や依存関係の把握が遅れると、現状分析が長引き、後続の工程がすべて後ろ倒しになります。
テスト・訓練は、復旧力の実効性に欠かせない工程として契約時に明記しておきます。口頭だけに頼らず文書にしておくと、後の工程で認識のずれが起きにくくなります。
まとめ
DR体制の構築期間は規模と方式で変わります。設計・構築と、テスト・本稼働・訓練は、各約1〜2ヶ月です。標準規模なら全体で最短3ヶ月程度、複雑な要件では半年前後を見込みます。
クラウド型のコールドスタンバイは短期間で立ち上げやすく、ホットスタンバイやオンプレミス自社構築は長くなります。方式は、目標RTOと納期に合わせて選びます。
Tier別の導入、クラウド型DRサービスのテンプレート、工程別の契約は、いずれも短縮に役立ちます。さらに、合意形成やテスト・訓練の遅れを防ぐ対策を契約段階から組み込むと、実効性を保ちつつ無理のない日程で立ち上げられます。
具体的な日程を相談する際は、複数の開発会社やDRサービス会社に、現行構成と希望するRTO・RPOを提示して見積もりを依頼します。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。