
モックアップ、プロトタイプ、PoCの順に検証を深めていくと、本稼働への判断材料を段階的にそろえられます。
ITシステム障害復旧は、サーバーダウンやデータ破損、ランサムウェア被害などの際に、定めた時間・時点までに回復させる仕組みと体制です。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
DR・バックアップにおけるモックアップ・プロトタイプ・PoCの違いと定義
DR体制は本番稼働後、大規模障害が起きるまで手順の不備に気づけないことがあります。そのため、導入前後の検証が、その後の復旧品質を左右します。
本格導入の前に、開発会社と発注側の担当者が小規模な対象へシステムの一部を組み込み、障害発生からフェイルオーバー、復旧報告までをシミュレーションします。確認するのは、復旧目標の達成可能性と、現場での実行可能性です。
技術面に加えて、担当者が手順書どおりに操作し、分かりやすさや対応負荷も評価します。設計書だけでは見えない運用面を、この段階で確かめられます。
検証の深さに応じて、次の3段階を使い分けます。
- モックアップ:画面や手順の見た目を、稼働前の資料で確かめる
- プロトタイプ:一部の環境で、機能や動作を試す
- PoC:効果と実現可能性を検証する
モックアップでは、復旧手順書や連絡フロー、管理画面の構成を、実際のシステムを動かさずに見比べられます。一方で、プロトタイプでは、一部のサーバーやデータを使い、複製や切り替えが想定どおりに動くかを試作環境で確かめます。
PoCでは、設計したRTO(目標復旧時間)・RPO(目標復旧時点)の達成可能性や、投資に見合う復旧力を検証します。
段階を進めるほど、検証の深さと再現性が増していきます。進め方は、まず関係者が手順に合意し、次に動作を確認したうえで、目標達成度とコストを見て導入を判断する流れです。
PoC・トライアル導入の具体的な進め方
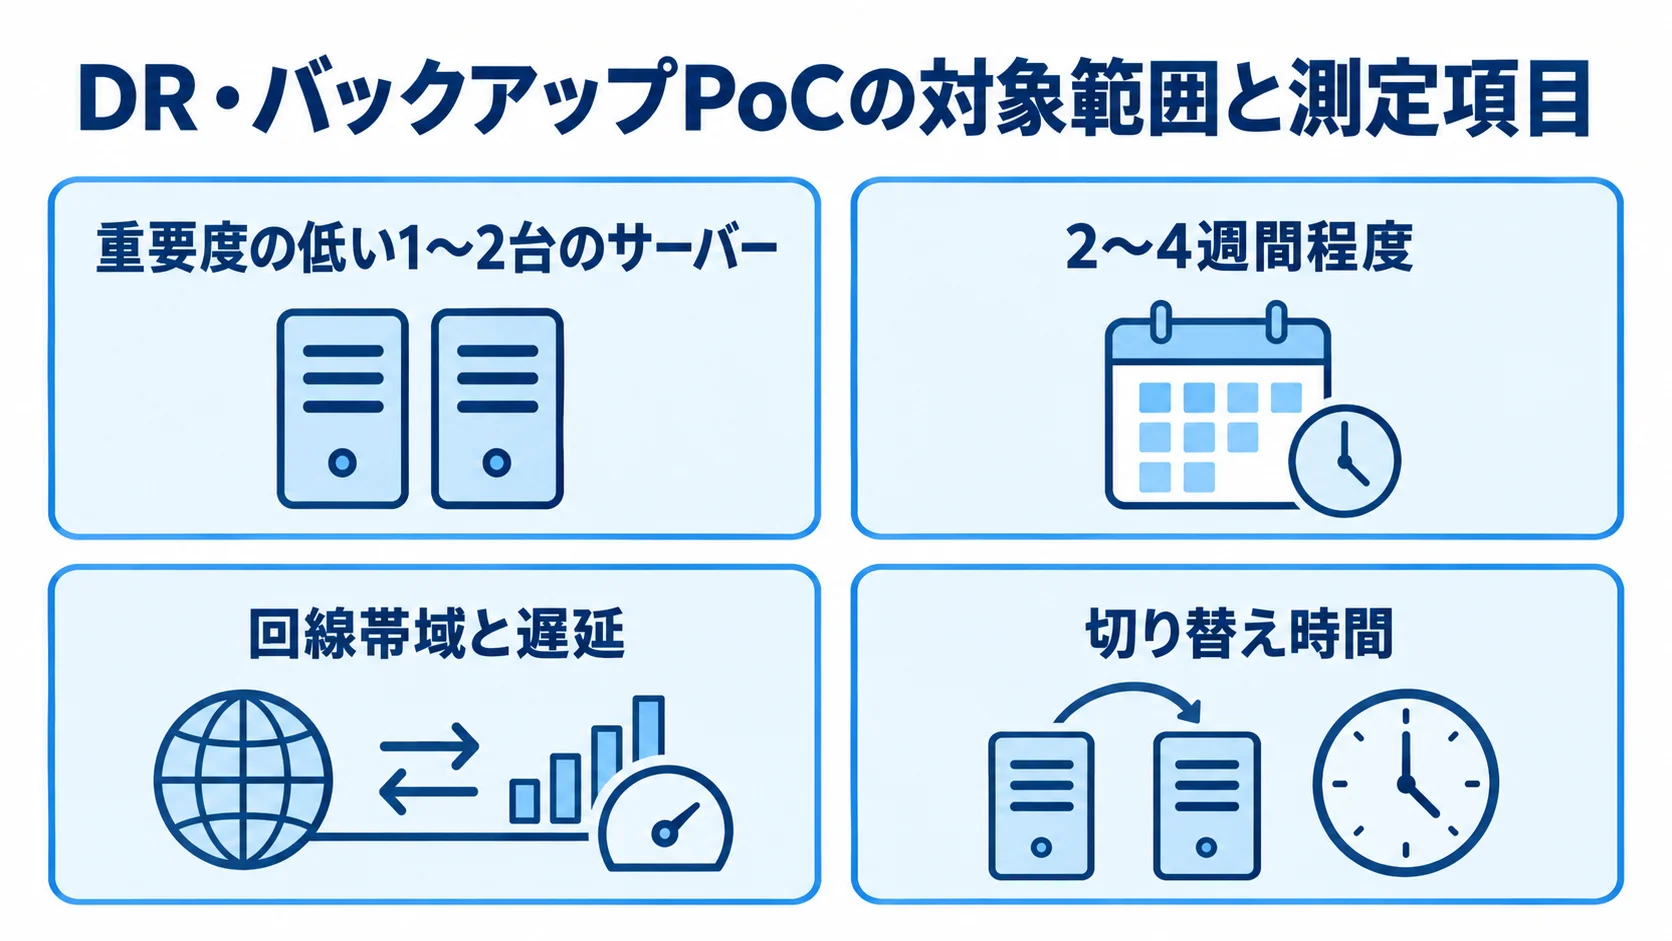
DR・バックアップの検証は、全システムを一度に対象にすると、設定作業やコストが膨らみ、失敗しやすくなります。そのため、まず対象範囲を絞ったPoCから始めます。
PoCの対象範囲と期間の目安
PoCは、重要度の低い1〜2台のサーバーやテスト環境を対象に、2〜4週間程度で実施するのが標準的です。
期間中はデータを複製し、次の測定項目で、設計したRTO・RPOを達成できるかを確かめます。
- 回線帯域と遅延:レプリケーションが与える影響の大きさ
- 切り替え時間:フェイルオーバーにかかる時間
本番システムを広く対象にするほど、検証項目が増えてPoCが長引きます。そこで、業務への影響が限定的なシステムやテスト用データセットで基本動作を確かめ、問題がなければ段階的に対象を広げるのが現実的です。
無料トライアルを提供するクラウド型DRサービスを使えば、発注側は追加のスポット予算をかけずに導入判断の材料を得られます。
Tier別の段階的導入(スモールスタート)
PoCで実現可能性を確認した後は、全システムへ一斉に導入せず、BCP上の優先度に沿って対象を広げます。
- Tier1:停止すると事業が止まる最重要の基幹システムで、最初に導入する対象
- Tier2・Tier3:Tier1の次年度以降に、段階的に導入する対象
PoCで1〜2台を検証して得た知見は、Tier1の導入に活かせます。
稼働実績を積んでから範囲を広げると、移行を無理なく進められます。さらに、段階導入は、一度に広げる場合と比べて、トラブル時の影響範囲を限定できます。
PoCの結果を踏まえ、優先度の高いシステムから復旧力を確保します。この進め方は、DR・バックアップの分野に共通する堅実な方法です。
DR訓練・テストの具体的な手法
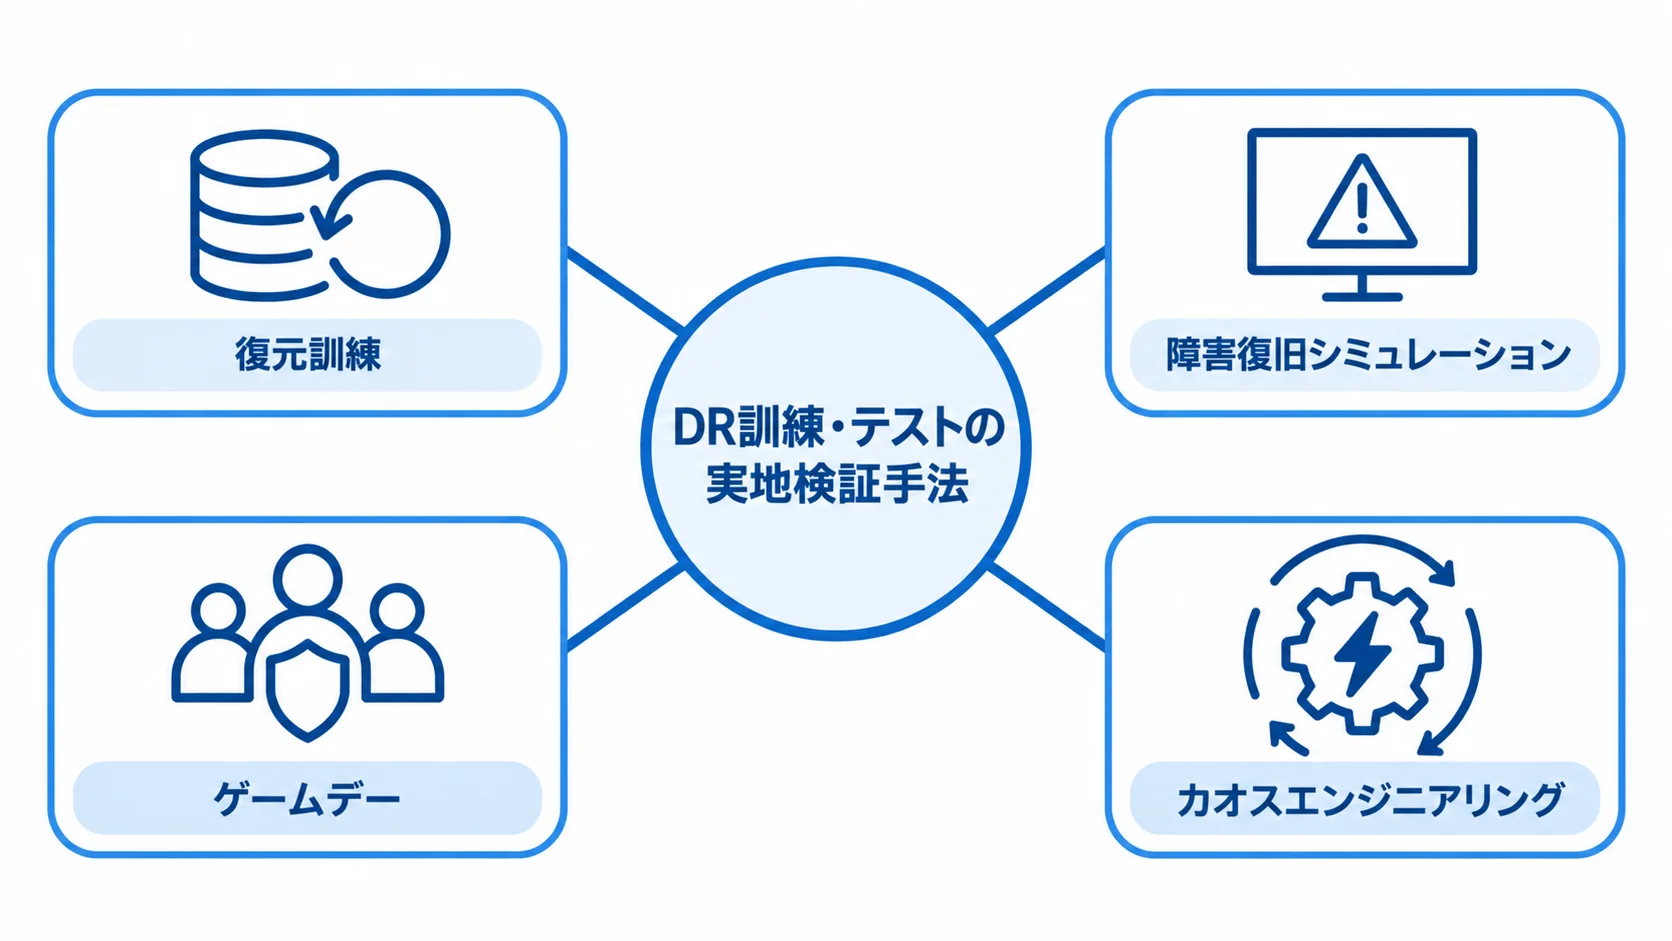
PoC・プロトタイプと並行して、または本稼働に向けて、障害時にDR体制が機能するかを、訓練やテストで検証します。
バックアップ復元テストと障害復旧シミュレーション
バックアップを取得しても、実際にデータを戻せるとは限りません。そのため、取得したデータを定期的に復元し、復旧できることを確かめます。
- 復元訓練:バックアップからのリストアと、手動の復旧手順
- 障害復旧シミュレーション:予備サーバーへのフェイルオーバーや暫定措置が、正常に行えるかどうか
復元テストでは、システム設定や構成を含むバックアップも対象にします。本番データの消失に備え、取得から復元までの流れを通して確かめます。
想定シナリオで定期訓練を行い、チームが役割を分けて対応します。また、事後にフローやマニュアルを見直すと、属人化しない組織力を高められます。
ゲームデーとカオスエンジニアリングによる実地検証
ゲームデーでは、開発・運用・セキュリティ・カスタマーサービスなどの混成チームが、本番または本番に近い環境に障害を起こします。
- ゲームデー:障害シナリオを通じた、チームの対応のシミュレーション
- カオスエンジニアリング:定常状態のシステムに、制御した障害を注入する手法
たとえば、ロードバランサーの片系切断やデータベースへの遅延注入を行うと、監視の閾値や緊急連絡用アカウントの問題を事前に見つけられます。
カオスエンジニアリングでは、専用ツールを使って回復力を検証します。さらに、静的な手順書では見落としがちな脆弱性の特定にもつながります。
検証は一度で終えず、システム構成や組織体制が変わるたびに繰り返します。変更により復旧手順が古くなるのを防ぐためです。
モックアップで手順や画面を確かめ、プロトタイプでは現場の担当者に擬似障害を体験してもらいます。出た現場の声を手順に反映すると、本格導入後の信頼性につながります。
本格導入への移行判断基準
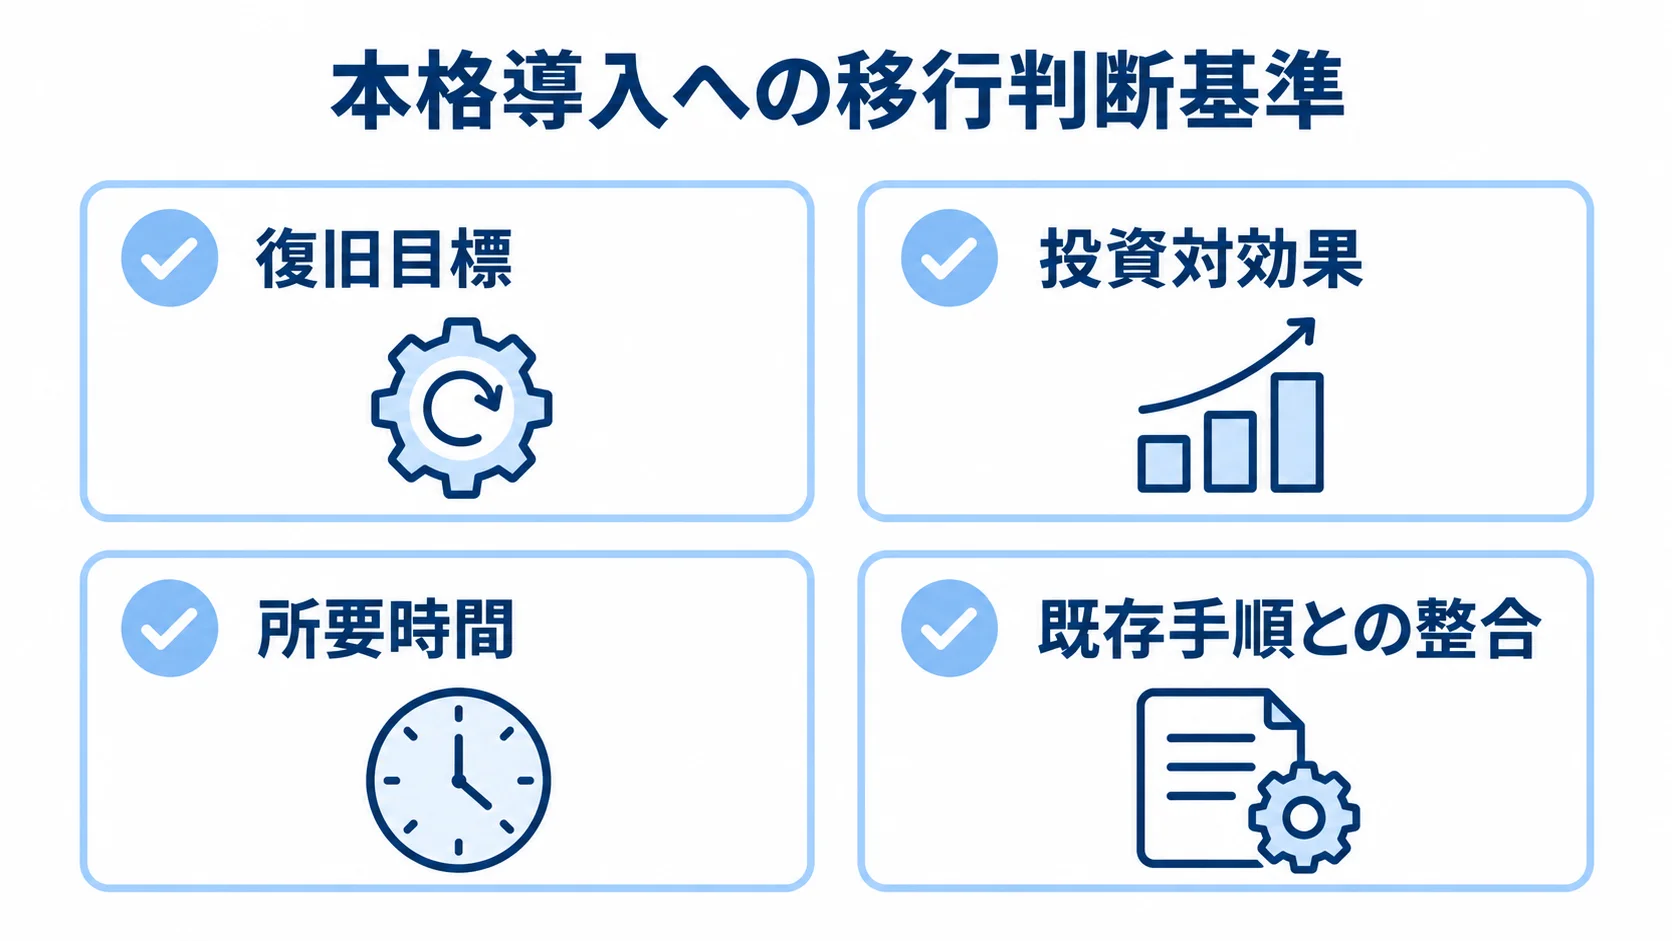
検証の後で本格導入へ進むか見送るかを決めるには、その基準を事前に定めておくことが、導入プロジェクトの成功に欠かせません。
基準が曖昧なまま本番へ移すと、大規模障害時にフェイルオーバーが動かず、データを復元できない恐れがあります。
判断では、復旧目標の達成度、コスト、現場の実行可能性を見比べます。
RTO・RPO達成度とコスト面の基準
移行判断では、復旧目標と費用対効果を、事前に定めた基準で評価します。
- 復旧目標:フェイルオーバーがRTO内か、喪失データがRPO内かを試験運用で計測
- 目標未達時:レプリケーション方式や自動化スクリプトの見直しと再検証
- 投資対効果:DR環境の構築・運用費用と、事業停止による想定損失額の比較
- 導入水準:検証前に数値や条件で定め、結果を都合よく解釈しないための基準
- 候補比較:数値化した基準による、DRサービスや構成候補の主観に頼らない比較
現場の実行可能性という判断基準
目標やコストの基準を満たしても、現場が手順を実行できなければ、本格導入を見送るか体制を見直します。
- 所要時間:復旧手順を業務に支障のない時間内に完了できるか
- 対応体制:特定の担当者に頼らず、複数人で対応できるか
- 既存手順との整合:運用手順書に無理なく組み込めるか
DRは情報システム部門だけで完結しません。障害対応にあたる担当者が手順どおりに動けて、初めて効果を発揮します。
発注側は、検証フェーズの早い段階から現場担当者を巻き込み、復旧手順を実際に操作してもらって意見を集めます。
シフト勤務や当番制の職場では、複数人が参加して、一人だけで対応する状態を防ぎます。
検証フェーズでよくある失敗と回避策
DR・バックアップの検証にも、典型的な失敗パターンがあります。小さく始めても、進め方を誤ると導入判断に至らず、実際の障害時に機能しない場合があります。代表的な失敗は2つあり、それぞれに回避策があります。
「バックアップは取得しているが復元できない」という致命的な見落とし
復元できない見落としを防ぐには、次の確認を検証に含めます。
- 第一の失敗:取得だけで安心し、復元テストを省いたまま本稼働に進むこと
- 復元できない原因:正常ログがあっても、データ破損や古い版を前提にした手順書では戻せない事態が珍しくありません
- 稼働前のテスト:本番相当の環境で意図的に復元し、取得から復旧まで機能するかの確認
- 構成変更後の再テスト:変更のたびに復元テストを行い、設定変更による復元失敗を防ぐこと
復元できなければ、DR・バックアップ体制を構築した意味が失われます。
検証範囲を広げすぎて判断が長引く失敗
検証が長引くと、要件が古くなったり、関係者の要望が増えたりして、判断が遅れます。PoCを次の段階へ進めるには、対象を絞ることと、基準を事前に関係者と合意しておくことが要ります。
- 範囲の広げすぎ:多くのシステムや複雑なシナリオを対象にし、検証が膨らんで導入判断を下せなくなる場合があること
- 要件の陳腐化:2〜4週間の予定が数ヶ月に延び、環境の変化で要件が古くなること
- PoCの範囲:重要度の低い1〜2台のサーバーやテスト環境に絞り、事前の基準を満たしたら次へ進むやり方
- 網羅的な検証:全体確認の要望はPoCではなく、Tier別導入で満たすこと
- 事前合意:PoCとの切り分けを最初に関係者と合意し、検証の迷走を防ぐこと
まとめ
モックアップは手順や見た目、プロトタイプは複製や切り替えの動作、PoCはRTO・RPOの達成可能性を検証します。導入は対象を絞って小さく始めるのが基本で、そのうえでPoCは、重要度の低い1〜2台のサーバーで2〜4週間程度を目安に実施します。
実証の後は、BCPのTier区分に沿って範囲を広げます。また、訓練では復元テストや障害復旧シミュレーションを行い、ゲームデーやカオスエンジニアリングも実地検証に使えます。
特に、訓練やテストを省くと、本稼働後にフェイルオーバーが動かず、データを復元できない事態につながりかねません。
移行判断では、RTO・RPOの達成度、コスト、現場の実行可能性を事前に定めておきます。加えて、検証の早い段階から現場担当者を巻き込みます。
DR・バックアップ体制の導入では、全社で一斉に本格導入せず、小さな検証で確度を高めます。開発やDRサービスのパートナーと相談し、進め方を設計します。
▼全体ガイドの記事
・ITシステム障害復旧の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。