
ITシステム死活監視の進め方は、監視対象を洗い出して優先度をつけ、監視間隔と通知経路を設計し、ツールに実装して運用後に見直す流れです。監視間隔や通知経路を誤ると検知が遅延し、ダウンタイムによる機会損失も膨らみます。そのため、最初の設計が欠かせません。
- 監視対象:サーバーやネットワーク機器などを洗い出す
- 監視間隔:重要度に応じて確認頻度を決める
- 通知経路:障害の深刻度に応じて通知先を分ける
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム死活監視の全体像と他の監視との違い
死活監視とは、サーバーやネットワーク機器、サービスが正常に稼働しているかを定期的に確認し、応答がなくなった瞬間に異常を検知する監視手法です。
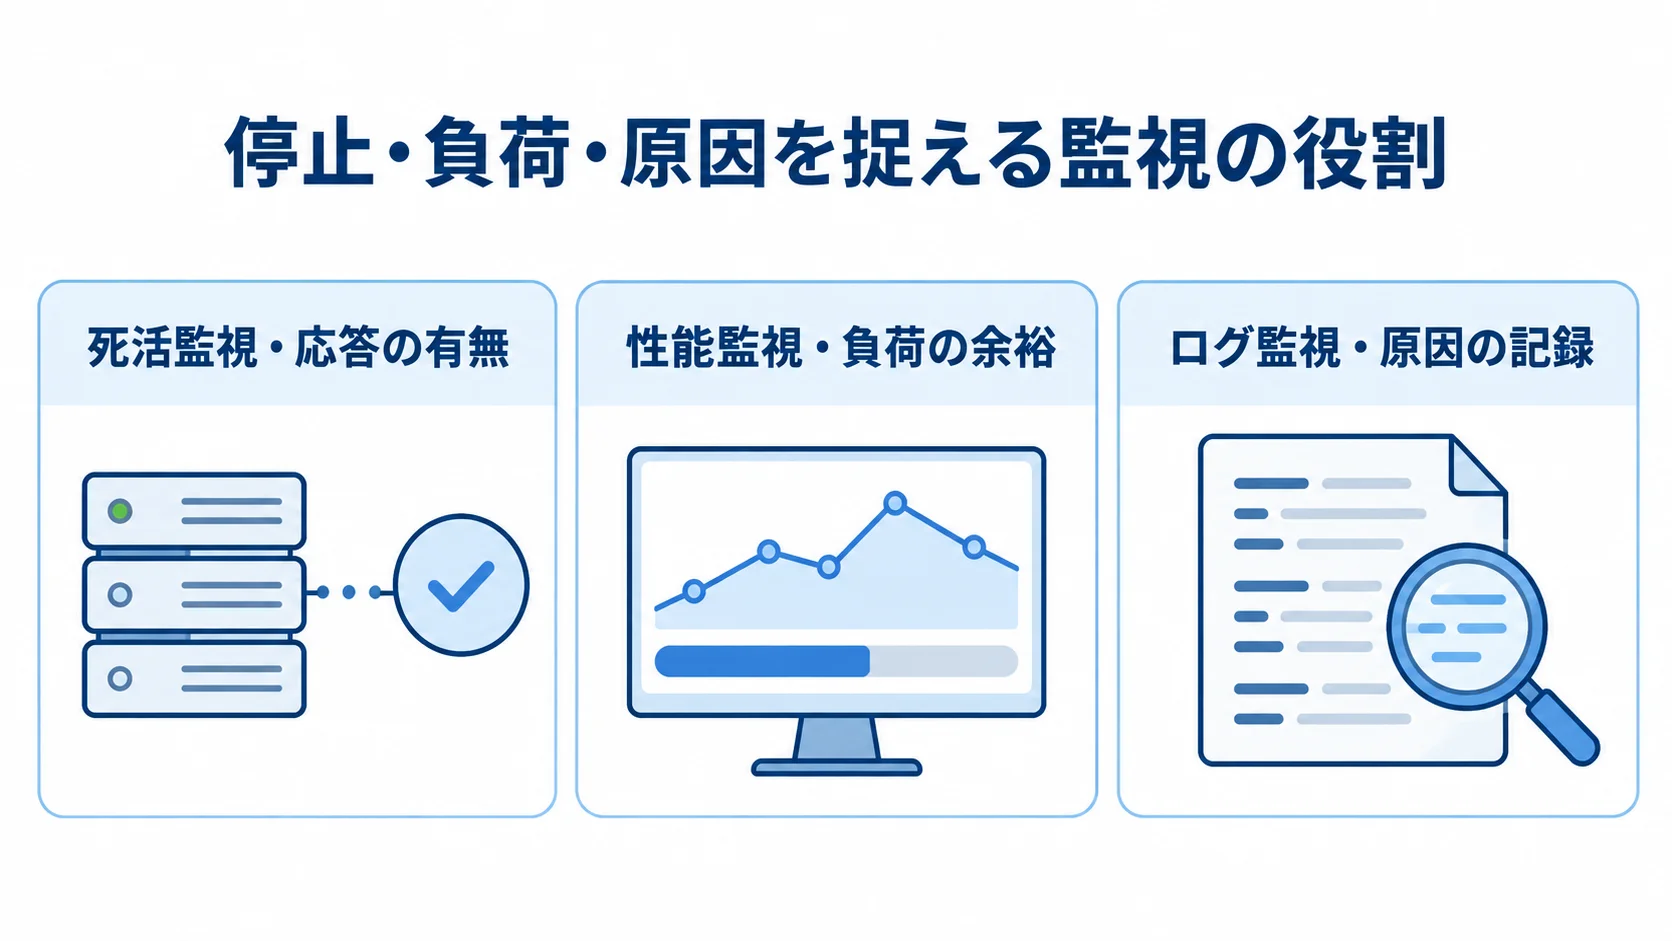
システム監視は一般に、死活監視・性能監視・ログ監視の3種類に分けられます。特に死活監視は、最も基礎的で、即時性が求められる役割を担います。
死活監視・性能監視・ログ監視の役割分担
3つの監視は、それぞれ見ている対象が異なるため、組み合わせて運用するのが基本です。
- 応答の有無:死活監視で、動いているか止まっているかを判定
- 負荷の余裕:性能監視で、停止前の負荷の上昇を捉える
- 原因の記録:ログ監視で、問題が起きた理由を追う
応答の確認には、PingやSSH、特定ポートへの接続を使います。
性能監視は、CPU使用率やメモリ、ディスク使用量、レスポンスタイムといった数値で「どれくらい余裕があるか」を把握し、停止する前の異常な負荷上昇、つまり障害の予兆を捉えます。ログ監視は、アプリケーションやOSが出力する記録を解析し、「なぜ問題が起きたか」を追跡する役割です。
死活監視で停止を即座に捉え、性能監視で停止前の負荷上昇を捉え、ログ監視で原因を特定する、という流れです。
ただ、死活監視だけではCPUが100%に張り付いて応答が極端に遅くなっている状態を「正常」と判定してしまう場合もあります。そのため、性能監視との併用が欠かせません。
死活監視が運用保守の出発点となる理由
死活監視が運用の出発点となるのは、システムの停止をユーザーより先に把握できる唯一の仕組みだからです。
- 機会損失とブランドへの影響:停止に気づくのが遅れると、売上と信頼の両方に響く
- 復旧着手までの時間:自社で先に検知できれば、着手までの時間を縮められる
- 被害の最小化:先に検知するほど、被害を最小限に抑えられる
死活監視がなければ、ECサイトが落ちていることを顧客からの問い合わせで初めて知る、という事態も起こり得ます。死活監視は、仕組みが比較的シンプルで、無料のオープンソースツールでも始めやすい、という特徴があります。一方で、検知の速さがビジネスに直結するため、監視間隔やアラート経路の設計品質が問われます。
手軽に始められるからこそ、設計を軽視すると「監視しているつもりで、実は障害を見逃していた」という落とし穴に陥りやすい領域です。
死活監視の主な手法とその使い分け
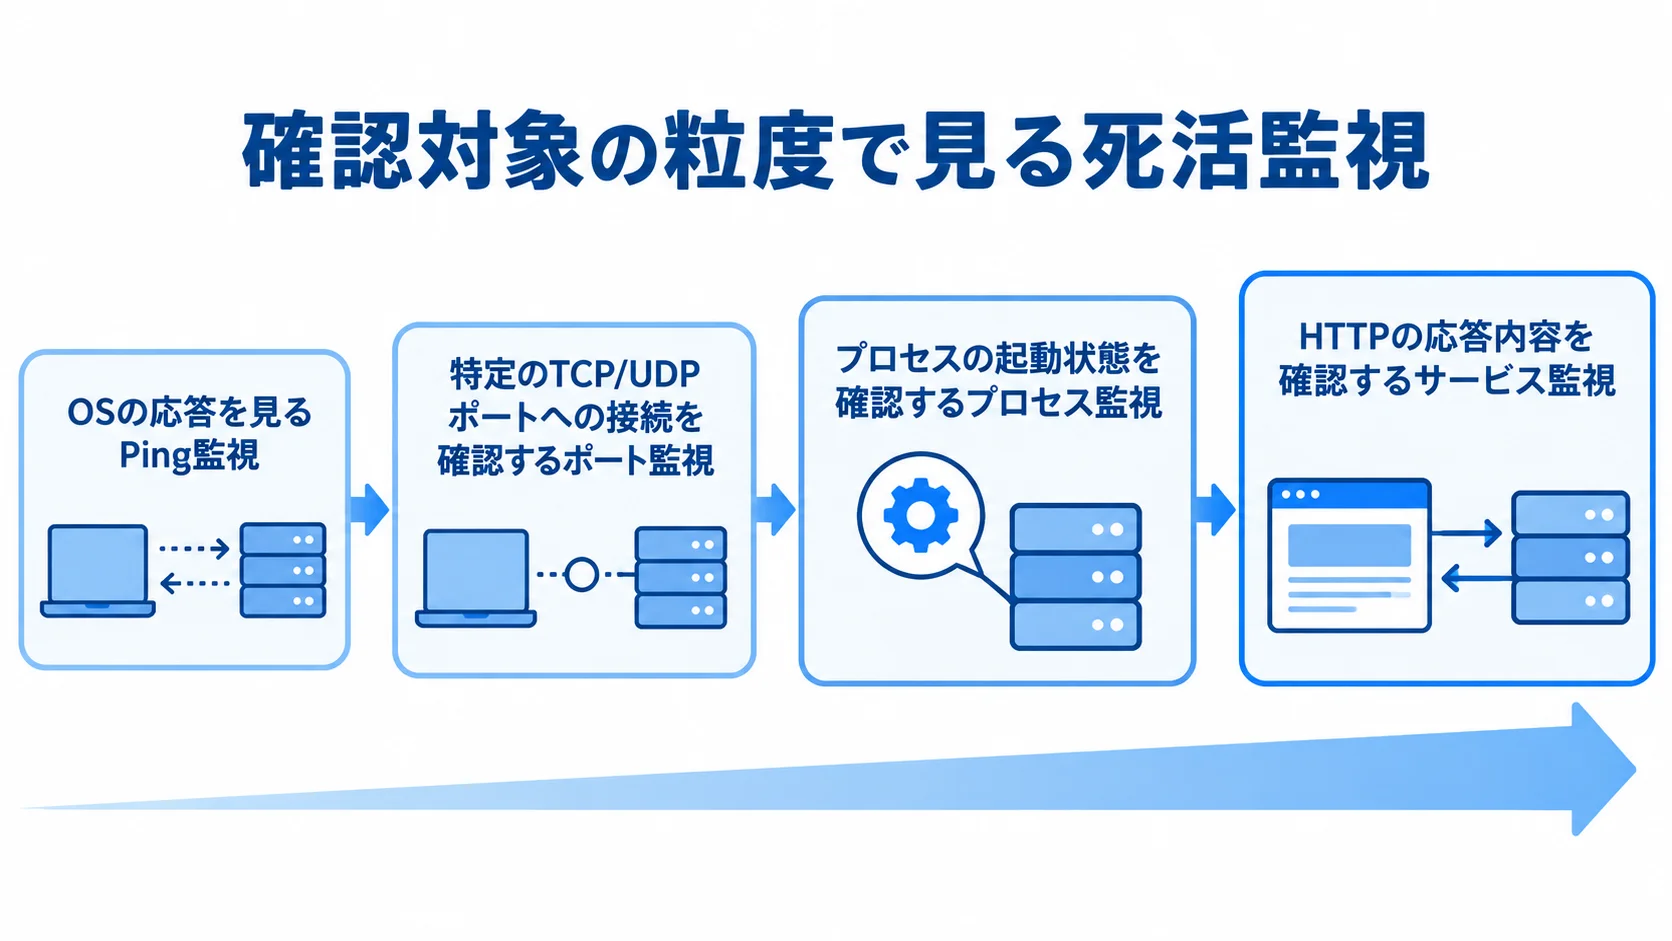
死活監視といっても、確認する対象のレイヤーによって手法は分かれます。代表的なのはPing監視とポート監視、プロセス監視、サービス監視の4つです。
4つは、それぞれ「どの粒度で生死を判定するか」が違うため、監視対象の重要度や、検知したい障害の種類に応じて使い分けます。手法の違いを押さえず、Ping監視だけで済ませてしまうと、サーバー自体は生きていてもWebサービスだけが落ちている状態を見逃すことになります。
Ping監視とポート監視の違い
Ping監視は、最も基本的な死活監視です。ネットワーク的に到達可能で、OSが応答を返せる状態であれば「生存」と判定します。
- ICMPへの応答:対象機器にパケットを送り、返答の有無を見る
- ポートへの接続:特定のTCP/UDPポートに接続できるかを見る
- 外部公開サービスでの併用:外部に公開する対象で組み合わせる
実装が容易で、監視ツールのほぼ全てが対応しています。そのため、サーバーやルーター、スイッチの稼働確認に広く使われます。
Pingが通ることは、OSが動いていることを示すだけです。その上で動くアプリケーションの正常性までは保証しません。
ポート監視は、特定のTCP/UDPポートに接続を試み、応答があるかを確認する手法です。たとえば、Webサーバーなら80番や443番、メールサーバーなら25番、データベースなら3306番といった具合に、サービスが待ち受けるポートを指定します。
Pingが通ってもWebサーバーのプロセスが落ちていれば443番への接続は失敗するため、ポート監視を併用するとサービスレベルの停止を検知できます。
外部公開しているサービスでは、Ping監視とポート監視をセットで設定するのが定石です。
プロセス監視・サービス監視による中身の確認
プロセス監視は、サーバー内部で特定のプロセスが起動しているかを確認する手法です。ApacheやNginx、データベースのデーモンといった重要なプロセスが落ちていないかを、エージェント経由でチェックします。
- プロセスの起動状態:ApacheやNginxなどが、起動したまま動いているか
- 特定ポートの開放状況:ポートが開いていて、外から接続できるか
- HTTPの応答内容:返ってくる内容が正しいか
ポート監視は外部からの接続性を確認します。一方、プロセス監視は内部の状態を直接確認するため、微妙な状態の切り分けに役立ちます。たとえば、ポートは開いているのにプロセスが応答不能になっている状態を見分けられます。
サービス監視は、さらに一歩進み、実際にHTTPリクエストを送ります。特定の文字列が返ってくるか、ログインや決済といった主要なシナリオが成功するかまで確認します。
ユーザー目線で「使えるかどうか」を判定できるため、より実態に近い死活確認が可能になります。
重要度の高いサービスでは、4つの監視をすべて組み合わせます。こうすると、どのレイヤーで障害が起きても、いずれかが捉えられる構成になります。
死活監視を立ち上げる進め方の5ステップ
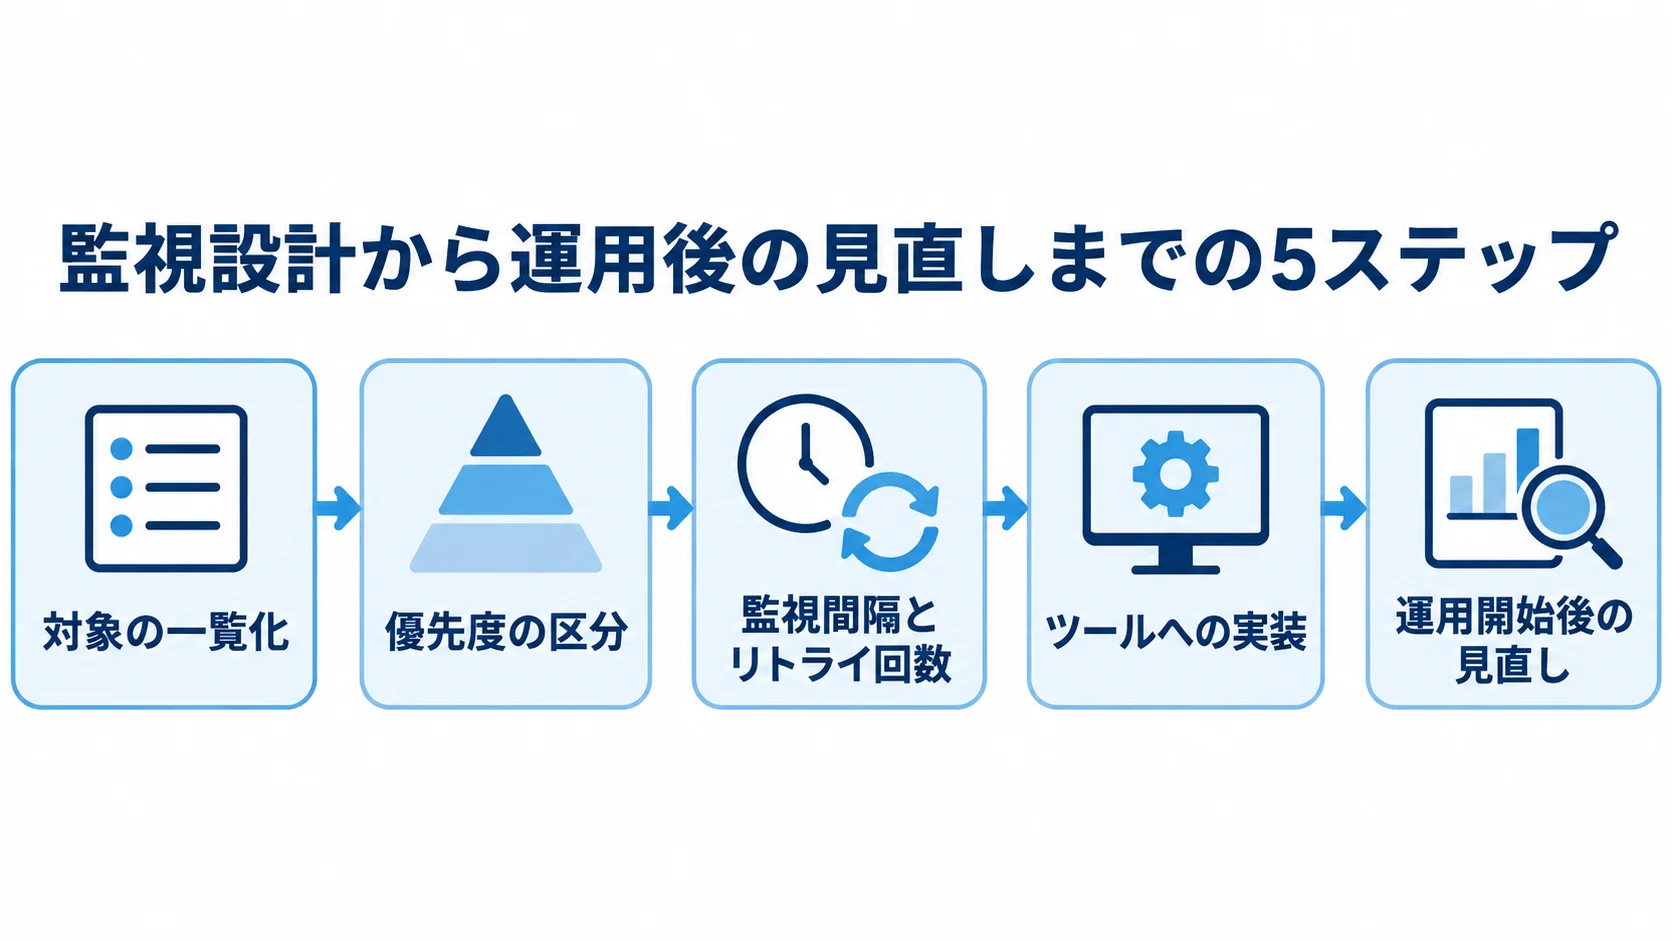
死活監視は、何を、どの粒度で、どれくらいの間隔で監視し、異常をどこに通知するかを設計して初めて機能します。ツールに対象を登録するだけでは、設計が済んだことにはなりません。
監視対象の洗い出しから運用開始後の見直しまで、実務では5つのステップで進めます。
ステップ1〜2: 監視対象の洗い出しと優先度づけ
最初のステップは、監視すべき対象を漏れなく洗い出すことです。たとえば、Webサーバー、APIサーバー、データベースといったサーバー類が該当します。ロードバランサーやネットワーク機器、外部連携先のエンドポイントも、対象に加えます。
- 対象の一覧化:サーバーやネットワーク機器などを、抜けなく書き出す
- クラウドのマネージドサービス:クラウド環境では、対象に含める
- 優先度の区分:停止の影響の大きさで分ける
クラウド環境であれば、インスタンスだけでなく、マネージドサービスのヘルスチェックエンドポイントも対象に含めます。この洗い出しが不十分だと、監視されない対象が残り、そこで起きた障害に気づけません。
次に、洗い出した対象に優先度をつけます。停止が売上やユーザーに直結する本番系のサービスは最優先にします。社内ツールやバッチ処理は中程度、検証環境は低めといった具合に区分します。
この優先度は、後の監視間隔とアラート通知の設計に直結します。すべてを同じ重みで監視すると、重要な障害が大量の通知に埋もれる「アラート疲れ」を招くため、優先度でメリハリをつけます。
ステップ3〜4: 監視間隔の設計とツールへの実装
ステップ3は、死活監視の品質を大きく左右する監視間隔の設計です。
- 監視間隔の決定:優先度に応じて、チェックの頻度を決める
- リトライ回数の設定:何回連続で応答がなければ障害とみなすかを決める
- ツールの選定と登録:自社の環境に合うツールに、対象を登録する
監視間隔とは、どれくらいの頻度で生死をチェックするかのことです。間隔が短いほど検知は速くなりますが、監視対象やネットワークへの負荷も上がります。誤検知の確率も上がるため、むやみに短くはできません。
目安として、最重要の本番サービスは30秒〜1分間隔、一般的なサーバーは1〜5分間隔、影響の小さい対象は5〜15分間隔と、間隔に差をつけるのが現実的です。
一度の応答失敗で即アラートを鳴らすと、一時的なネットワークのゆらぎで誤検知が頻発します。
たとえば「3回連続で応答なしなら障害とみなす」と設定すれば、瞬間的なパケットロスを障害扱いせずに済みます。ステップ4では、これらの設計を監視ツールに反映します。
ZabbixやMackerelのほか、CloudWatchやOpManagerなどから、自社の環境に合うツールを選びます。チームの技術レベルに合わせて、監視対象と間隔、リトライ回数を登録します。
ステップ5: 運用開始後の見直しと継続改善
運用開始後の見直しは、5つ目のステップです。実際に運用すると、アラートが想定より多すぎたり、逆に重要な障害を見逃していたりと、設計とのズレが必ず生じます。
- 誤検知の発生頻度:アラートが多すぎないかを、定期的に振り返る
- 検知から復旧までの時間:検知してから復旧するまでの時間を振り返る
- しきい値の見直し:監視間隔やリトライ回数、しきい値を調整する
振り返りは一定期間ごとに行い、その結果をもとに、監視間隔やリトライ回数、しきい値を調整していきます。
障害が起きた後は、「なぜ起きたか」に加えて、監視が正しく動いたかどうかも振り返ります。具体的には、「監視は適切に機能したか」「アラートのタイミングは妥当だったか」を確認します。ポストモーテム(事後検証)を行うと、監視システム自体が強くなります。
死活監視は、構成変更やトラフィックの増加に合わせて育てていく対象だと捉えると、長期的な運用品質を支えられます。
即時検知を実現するアラート設計としきい値
死活監視では、異常を検知することと同じくらい、異常を適切な相手に、適切なタイミングで伝えることが大切です。どれだけ早く停止を捉えても、通知が届かなければ意味がありません。
逆に、些細な事象まで片端から通知すると、担当者がアラートに慣れてしまい、重大な障害を見落とす「アラート疲れ」を引き起こします。即時検知につながる通知経路の組み方と、しきい値の考え方を順に見ていきます。
通知経路とエスカレーションの組み方
通知経路は、障害の深刻度に応じて段階的に設計します。
- 通知先の振り分け:届け先を、影響の大きさで分ける
- 夜間・休日の呼び出し:重度の障害で、担当者を直接呼び出す
- 二次担当者への引き継ぎ:一次担当者が一定時間内に動けなければ、上位へ回す
影響の小さい警告は、Slackやチャットツールへの通知にとどめます。重大な障害の呼び出しには、電話や専用のオンコールツールを使います。これは、夜間や休日の重大障害が、誰も見ていないチャンネルに流れて朝まで放置される事態を避けるためです。
エスカレーションも欠かせません。一次担当者が一定時間内に対応に着手しなければ、二次担当者やリーダーへ自動的に通知が上がる仕組みを組んでおくと、対応の取りこぼしを防げます。
ある現場では、特定キーワードを含むログだけをSlackに通知する条件分岐を設定しました。ところが、設定ミスで重要なエラー通知が飛ばず、障害の発見が3時間遅れました。
この事例が示すのは、ツールの高機能さよりも、アラート設計のシンプルさと確実さが即時検知の鍵だということです。
警告・軽度・重度を分けるしきい値の目安
死活監視を性能監視と組み合わせる場合、アラートは「警告・軽度障害・重度障害」の3段階に分けて扱います。そうすると、対応の優先順位を決める材料になります。
- Load Average:CPUの負荷の高さを見る指標
- ディスクやInodeの使用量:使用率の高さで判定する
- メールキューの件数:溜まっているメールの数で判定する
ある運用事例では、1CPUあたりのLoad Averageを4以上で警告、8以上で軽度障害、12以上で重度障害と区分しています。ディスクやInodeの使用量は、80%超過で警告、90%超過で軽度障害、95%超過で重度障害という基準です。メールキューであれば、500件超で警告、1,000件超で軽度障害、2,000件超で重度障害といった具合です。
こうした段階的なしきい値を設けると、通知の重みを変えられます。たとえば、警告は記録のみ、軽度障害は日中の対応、重度障害は即時のオンコールといった具合です。
ただし、ここで挙げた値は、環境ごとに調整すべき出発点です。最初は一般的な目安で設定し、運用しながら誤検知の頻度を見て徐々にチューニングします。その結果、ノイズが減り、本当に対応すべきアラートだけが残る状態に近づきます。
24時間365日体制を実現する内製とMSP委託の判断
死活監視は仕組みの導入自体は難しくありませんが、「24時間365日、検知したアラートに人が即対応する」体制を維持するとなると話は別です。
深夜や休日に発生した障害へ、誰がどう対応するかを決めておかなければ、せっかくの即時検知も活かせません。
自社で対応する内製と、監視代行のMSPに委託する方法、両者を組み合わせるハイブリッド運用の3つを比べます。
監視代行の料金相場とハイブリッド運用
監視代行を提供するMSPの料金相場として、一次対応を含む24時間365日監視のパッケージは、1台あたり月額10,000〜30,000円程度が目安です。
- 一次対応を含むパッケージ:監視と一次対応を、まとめて外部に任せる
- 個別サービスの監視:必要なサービスだけを選んで監視を頼む
- 自動復旧のオプション:月額の料金が別途かかる追加機能
個別サービスの監視は、月額200円程度から利用できます。ApacheなどのプロセスがダウンしたときにMSP側で自動復旧するオプションは、月額3,000円程度です。
夜間・休日のみといった時間帯を指定して委託できるサービスもあり、自社対応が難しい時間帯だけを補完する使い方も可能です。
現実的な選択肢は、日中は自社で監視・対応し、夜間休日のみMSPに一次対応を委託するハイブリッド運用です。すべてを内製すると、人的負担と人件費が重くなります。一方で、すべてを丸投げすると、ブラックボックス化のリスクが生じます。
そこで、コアとなる本番サービスの一次対応だけを委託し、設計や根本対応は自社で握ります。自社のリソースと重要度に応じて切り分けると、無理のない24時間体制につながります。
死活監視を含む運用保守全体の費用感は、ITシステム死活監視の見積相場や費用についても参考になります。
丸投げによるブラックボックス化の防止
MSP委託で陥りやすい失敗の一つが、ブラックボックス化です。監視と運用を丸ごと外部に任せきると、自社システムの構成や監視の意図を理解できる社員がいなくなります。
- 運用全体の把握:構成と監視の意図を、社内で説明できる状態を保つ
- 契約条件の見直し:契約を見直すときに、判断の材料を社内で持つ
- 委託先の変更:移行が膨大になる前に、判断できるようにしておく
日々の運用は回っているように見えても、契約を見直す場面や、大規模な障害で踏み込んだ判断が必要になった場面で、誰も全体像を説明できないという事態に陥ります。
委託先を変更しようにも、移行コストが膨大になり、身動きが取れなくなることもあります。
これを避けるには、発注側が手放してはいけないスキルを決め、社内に残しておきます。具体的には、SLA設計の能力、システム全体のアーキテクチャを把握する力、監視項目とアラート設計の妥当性を判断する力です。
これらを残せば、MSPを「実働を担うパートナー」として使いながら、主導権は自社が握れます。
委託の進め方は、ITシステム死活監視の発注・外注方法についてもご確認ください。
まとめ
ITシステム死活監視は、停止をユーザーより先に検知する、運用保守の出発点です。
Ping監視やポート監視、プロセス監視、サービス監視を、対象の重要度に応じて組み合わせます。監視間隔とリトライ回数を優先度別に設計すると、即時かつ誤検知の少ない監視に近づけます。
検知後は、深刻度に応じて通知経路とエスカレーションを組み、警告・軽度・重度のしきい値で対応の優先順位を明確にします。これが、アラート疲れを防ぐ鍵となります。
24時間365日の体制は、内製かMSP委託かで決め切るより、夜間休日だけ委託するハイブリッド運用を選ぶほうが現実的です。委託するときは、発注側が手放さないスキルも決めておきます。
死活監視は、ポストモーテムを通じて継続的に育てていくものです。その積み重ねが、長期的な運用品質を高めます。
死活監視の全体像は、ITシステム死活監視の完全ガイドもご覧ください。
ツール選定には、ITシステム死活監視でおすすめの開発会社・ベンダー6選と選び方も参考になります。
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。