
ITシステム死活監視の開発期間は、監視方式、対象規模、冗長化の範囲によって、数十分から数ヶ月まで変わります。新規に構築するなら、まず立ち上がりまでの期間が気になるでしょう。死活監視は、SLA設計や障害後の一次対応体制を整える運用とは異なり、異常の技術的な検知や自動切り替えを構築する領域です。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム死活監視プロジェクトの開発期間の全体像
立ち上げにかかる期間は、ツールの種類と構築の範囲によって大きく変わります。そのため、監視ツール単体の稼働開始と、運用に耐える仕組みの完成は、別々の期間として考えます。
ツールによって、監視開始までの時間は大きく違います。AWSのCloudWatchは約30分、OpManagerはインストールから最短10分で監視を始められます。
一方で、OSSのZabbixを自社で構築した小規模案件では、手作業の設定に約1週間かかった実例があります。業務で使える状態にするには、スモールスタート導入・PoCに約1ヶ月を見込みます。さらに、本番運用とチューニングの並走には3〜6ヶ月が目安です。
監視方式・規模別の期間目安
構築期間は、規模によって大きく3つに分けて見ると、全体の見通しが立ちます。
- 小規模:数台にPing・HTTP監視を導入する場合です。稼働は数十分から数日で、閾値の調整を含めると2〜4週間となるケースが多いです。
- 中規模:複数のサービスやポートを設計し、閾値を段階的に設定します。約1ヶ月のPoCを経て、本番稼働に入るのが標準です。
- 大規模:ヘルスチェックの実装に加え、ロードバランサーやDNS連携の切替設計と擬似障害テストに、数週間から1ヶ月を上乗せします。
大規模構成では、アクセス切り替えの設計と試験を独立した工程にします。判定と切り替えを組み合わせて初めて不具合が見つかることもあるためです。どの規模でも、判定ロジックを現場に合わせる必要があり、本番運用後の調整に3〜6ヶ月を確保しておきます。
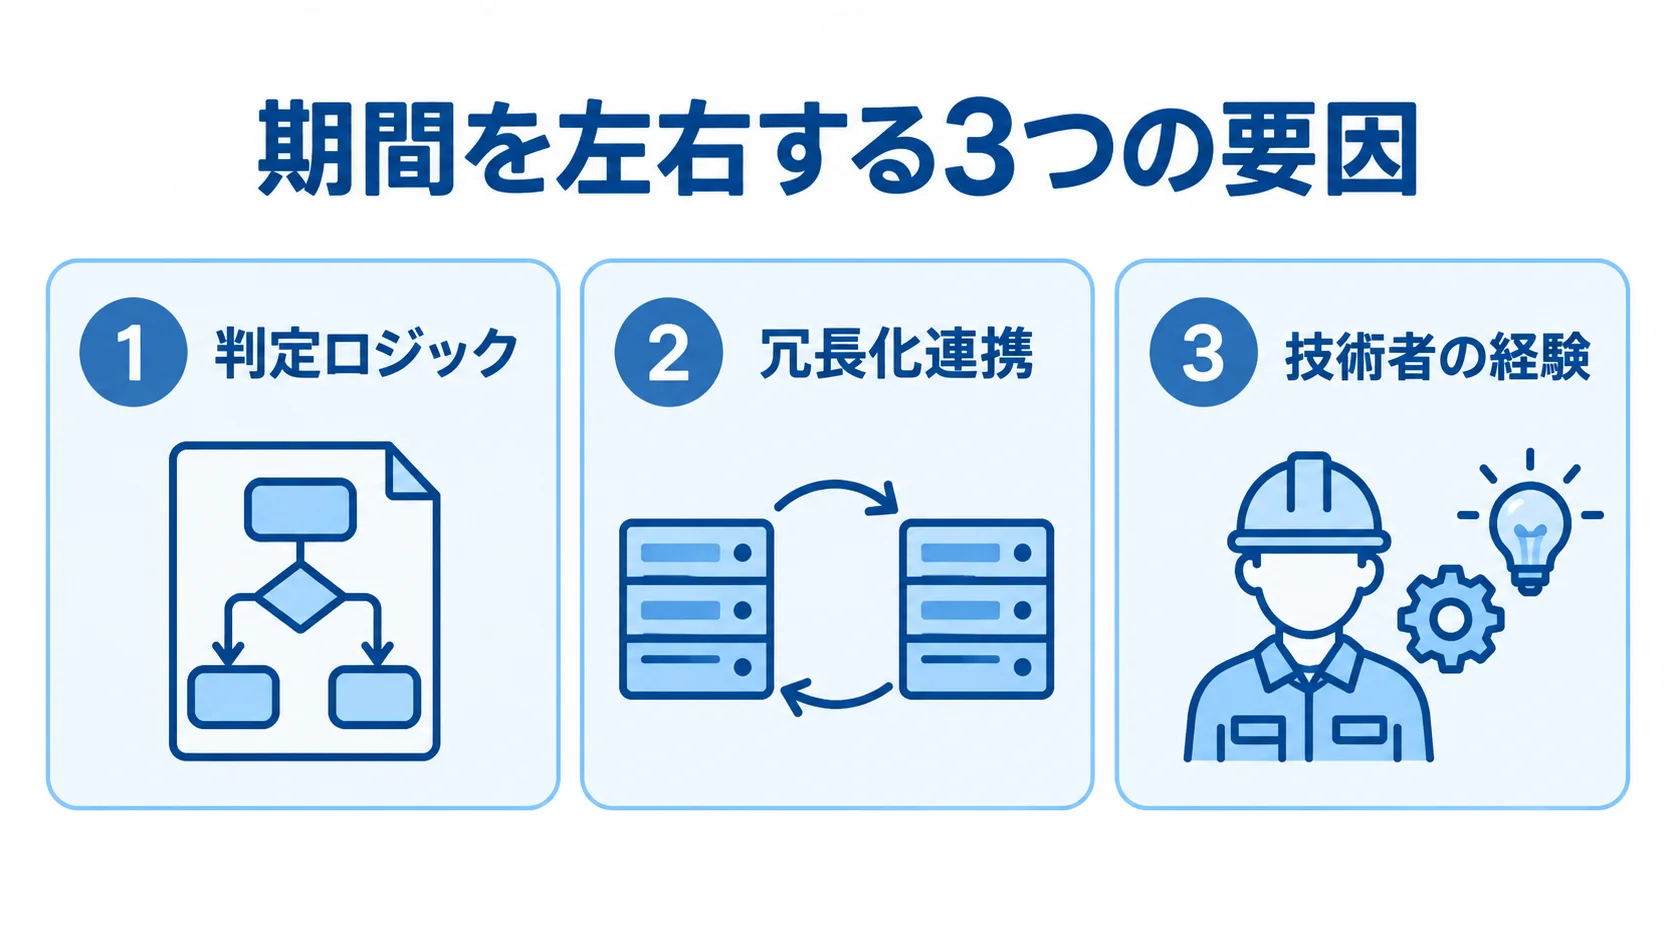
期間を左右する3つの要因
同じ規模でも期間に差が出るのは、主に判定設計、冗長化連携、技術者の経験によるものです。
- 判定ロジック:閾値を段階的に設定したり、誤検知を防ぐ条件分岐を入れたりすると、設計とテストが長引きます。
- 冗長化連携:単体の監視なら短めで済みます。ロードバランサーやDNSと連携すると、自動切替の設計と擬似障害テストで期間が延びます。
- 技術者の経験:設定や調整に不慣れだと想定外の手戻りが起き、当初の見込みより長期化します。
3つの要因を事前に評価しておくことが、無理のないスケジュールを組む出発点になります。なお、単純な判定であれば短期間で設計できます。たとえば、直近3回の連続未応答や、異常が15分続いた場合を条件にできます。
工程別スケジュールと期間配分
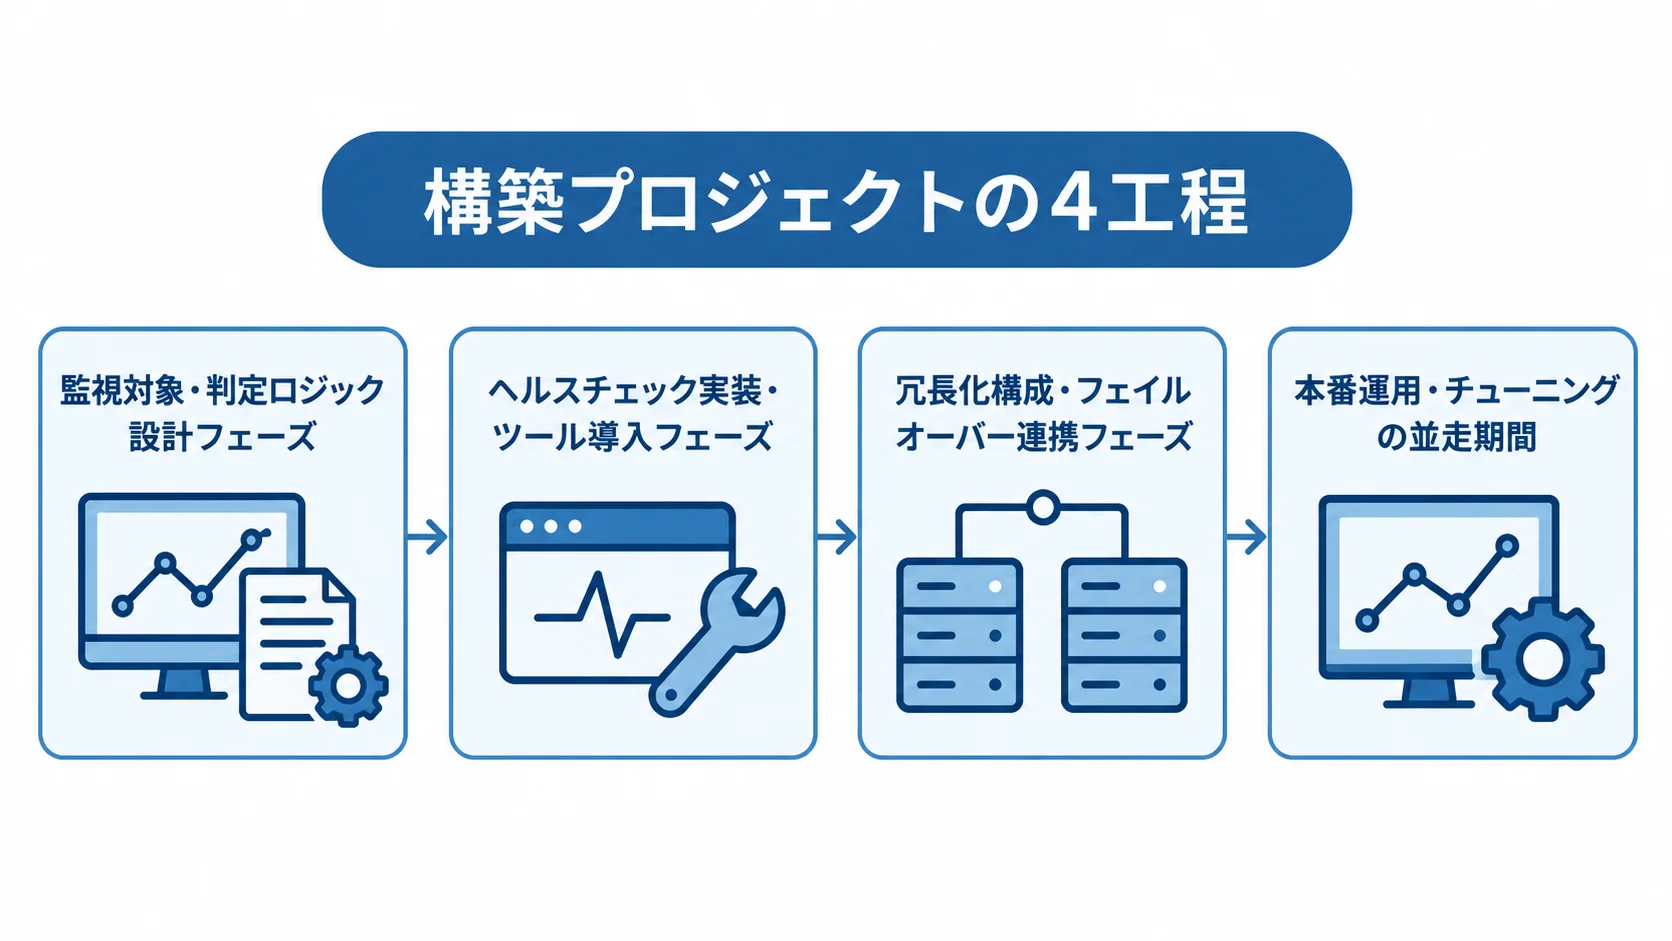
構築プロジェクトは、標準的に大きく4つの工程に分けられます。各工程で何が確定するかを把握しておくと、スケジュール遅延を防ぎやすくなります。
監視対象・判定ロジック設計フェーズ
最初に、監視するサーバー・サービス・ポートを洗い出します。そのうえで、対象ごとに判定の方法を決めておきます。
- Ping監視:確認の間隔と、何回応答がなければ異常とするかを決めます。
- HTTPヘルスチェック:確認するURLとポート、タイムアウトまでの秒数です。
設計例では、60秒間隔で確認し、3回連続で未応答なら異常とします。異常が15分以上続けば完全ダウンとみなし、自動復旧の対応を起動します。
判定の厳密さは対象システムの重要度で変わるため、業務への影響が大きいシステムから優先します。標準的な規模であれば、設計に数週間を見込みます。
ヘルスチェック実装・ツール導入フェーズ
判定方法が決まったら、監視ツールに設定を反映するか、ヘルスチェックを実装します。稼働開始までの時間は、ツールによって差があります。
- CloudWatch:AWS環境では、監視開始まで約30分です。
- OpManager:パッケージ型で、最短10分で監視を開始できます。
- Zabbix:監視項目や通知設定を手作業で作り、小規模でも約1週間かかった実例があります。
HTTPヘルスチェックでは、外部からリモートで監視する方法と、サーバー内のエージェントで監視する方法を組み合わせるのが一般的です。また、HTTP・HTTPS・DNS・POP・SMTPやデータベースのポートなど、稼働中のサービスごとに監視対象を設定します。
冗長化構成・フェイルオーバー連携フェーズ
ロードバランサーやDNSフェイルオーバーと連携すると、判定結果に応じてアクセス先を自動で切り替えられます。特に、この工程は丁寧な検討が必要です。
- 切り替え条件:異常と判定してから、何秒後に切り替えるかを決めます。
- 復旧条件:正常な状態に復旧した後に、元の系統へ戻すタイミングです。
- 擬似障害テスト:サーバーを止めて、意図どおりに切り替わるかを確かめます。
期間は、監視対象や冗長化構成の複雑さによって変わります。納期の遅れを避けるため、独立した工程として数週間から1ヶ月を確保します。
本番運用・チューニングの並走期間
本番稼働後は、アラートの状況を見ながら判定ロジックを調整します。
- 設定直後の課題:一時的な負荷や通信遅延まで検知し、不要な通知が頻発する「アラート地獄」に陥りがちです。
- 調整方法:継続時間の条件を加え、閾値を段階的に見直して現場に合わせます。
並走期間の目安は3〜6ヶ月です。その間に、季節性のある業務のピークを一巡させると、閾値を実データで検証できます。なお、期間を短縮しすぎると、誤検知や検知漏れが本番後に起きるリスクが高まります。
監視方式・ツール導入形態によるスケジュールの違い
SaaS型を使うか、OSSで自社構築するかによって、導入スケジュールは大きく変わります。その選択は、そのまま納期に直結します。
SaaS型ツール(CloudWatch、Mackerel等)の場合
ツールごとの立ち上がりやすさは、監視開始までの時間や試用の条件に表れます。
- CloudWatch:サーバーの構築が不要で、約30分で監視を開始できます。
- Mackerel:エージェントを入れて監視でき、全機能を2週間無料で試して本番前に挙動を確認できます。
- テンプレート:あらかじめ用意されていることが多く、閾値をゼロから設計するより早く立ち上がります。
契約と初期設定だけなら、数日から数週間で稼働させることも現実的です。納期が限られるプロジェクトには、この形が合っています。
一方で、複数サービスの監視や冗長化連携を求める場合は、個別の実装工程も必要になります。
OSS(Zabbix等)で自社構築する場合
ZabbixなどのOSSは、ライセンス費用が無料です。ただし、サーバーの構築や監視項目・通知ルールの設定は自社で行う必要があります。
- 初期構築:小規模の案件でも、約1週間かかった実例があります。
- 監視範囲:対象数やヘルスチェックの種類が増えると、稼働まで長くなる傾向があります。
- 自動増減への対応:クラウドのオートスケーリングに監視対象を追従させる設定には、手間がかかります。
納期を優先するならSaaS型、自社の運用に合わせた仕組みを時間をかけて作り込むならOSSが現実的な選択肢になります。独自の判定ロジックやフェイルオーバー連携を実装するフルスクラッチ開発については、本テーマの「フルスクラッチ・オーダーメイド開発」編で解説しています。
納期を短縮する具体的な方法
判定の精度を保ったまま導入期間を縮めるには、監視対象の広げ方や設定の進め方を工夫します。
スモールスタートと段階的な監視対象拡大
まずは、監視対象を絞り込むスモールスタートです。全機器やサービスを最初から対象にすると、設定の量が膨らみ、導入が長引きます。
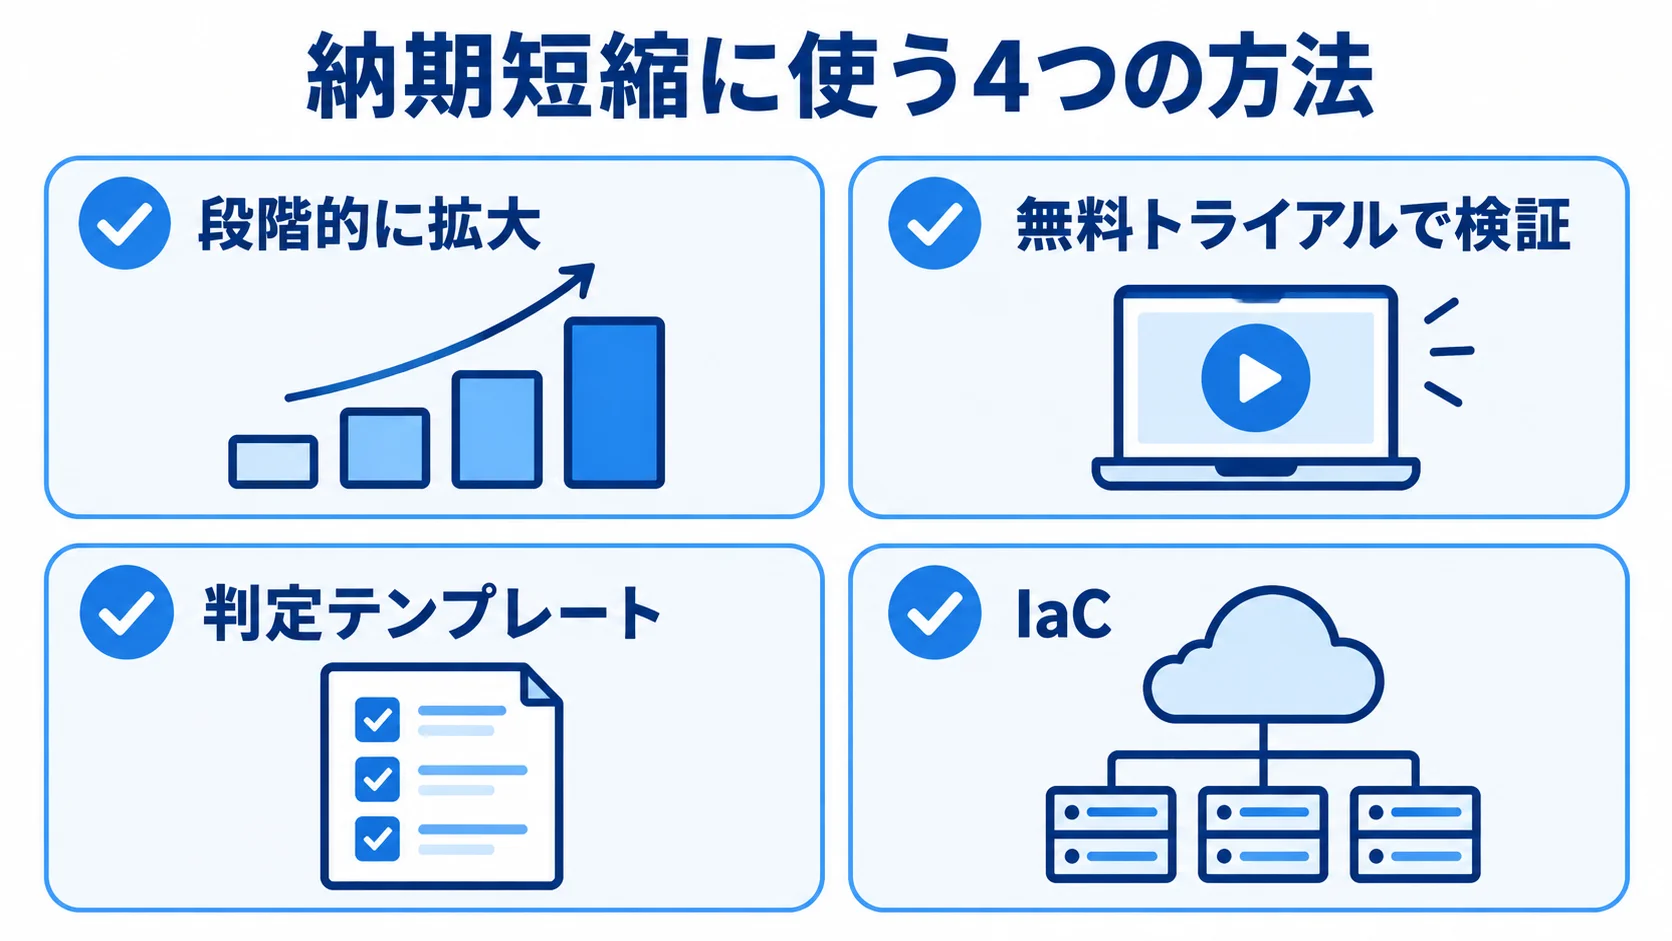
- 段階的に拡大:業務停止につながる機器のPing監視から始め、安定後にHTTPヘルスチェックやポート監視へ広げます。
- 無料トライアルで検証:ケーブルを抜くなどの疎通テストで判定を確かめ、契約前の手戻りを減らします。
段階的に導入すれば、一度に広い範囲を対象にする場合と比べて、トラブルの影響を限定できます。
テンプレート・IaCの活用
納期を縮めるには、テンプレートやIaC(Infrastructure as Code)を使う方法があります。どちらも、設定作業の進め方を変えられます。
- 判定テンプレート:閾値を一から設計するより、実装期間を短縮できます。
- IaC:インフラと監視を自動化し、監視設定やフェイルオーバー構成をコード化できます。
また、DevOps(開発と運用の統合)では、デプロイ時間が従来の数週間〜数ヶ月から、数時間〜数日へ縮まる目安も示されています。IaCで設定を自動化しておくと、修正のたびに手作業で設定し直す負担が減り、テストも速く回せます。
要件が固まっていない判定設計には準委任契約を、仕様が確定した後の実装や冗長化連携には請負契約を使う方法があります。工程の性質に合わせて契約形態を使い分けると、手戻りのリスクを抑えながら計画を進められます。
納期遅延の典型要因と対策
綿密に計画しても、遅延のリスクは残ります。そこで、典型的な要因を把握し、その対策を計画と進捗管理に組み込んでおきます。
アラート地獄によるチューニング長期化
遅延の要因で多いのが、閾値設計の甘さによる「アラート地獄」です。一時的な負荷や遅延まで異常と判定してしまうため、不要な通知が大量に発生します。
警告、軽度障害、重度障害のように閾値を段階分けし、継続時間の条件も設けて、ノイズを抑えます。さらに、負荷のパターンを事前に洗い出し、閾値の設計に十分な工数を割いておくと、後工程での手戻りを防げます。
フェイルオーバー連携テストの後回し
連携テストを後半に詰め込むと、納期を圧迫します。判定ロジックと切り替えロジックは、組み合わせて初めて不具合が見つかることもあり、後回しにしにくい工程です。
擬似障害テストには本番相当の環境が必要で、その準備にも時間がかかります。後回しにするほど、全体の日程への影響は大きくなります。
このため、冗長化連携を独立したマイルストーンとして扱い、テスト環境を早めに準備します。また、判定方法の合意を取ってから実装に進みます。
まとめ
死活監視の構築期間は、監視方式や規模、冗長化の範囲によって変わります。稼働開始までの時間は、CloudWatchが約30分、OpManagerが最短10分です。一方、OSSのZabbixを自社で構築した小規模案件では、約1週間かかった実例があります。
PoCには約1ヶ月、本番運用と調整には3〜6ヶ月を見込むのが現実的です。そのうえで、判定設計、ヘルスチェック実装、冗長化テストを独立した工程として計画すると、遅延を防ぎやすくなります。
納期を縮めるには、スモールスタートやテンプレート・IaCの活用が有効です。加えて、アラート過多や連携テストの後回しへの対策も、計画に含めておきます。
最後に、具体的な日程を相談する際は、複数の開発会社にシステム構成と冗長化要件を提示し、見積もりを取ることから始めます。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。