
死活監視は、Ping疎通、HTTP・HTTPSのヘルスチェック、TCP応答で稼働を見張り、PoCで確かめてから段階的に導入するのが流れです。
未検証の自動切替は障害時に失敗するおそれがあるため、擬似障害を起こして試します。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
死活監視のPoC・プロトタイプ検証の全体像
死活監視のPoCは、本番の前に判定ロジックとツールの組み合わせが業務に耐えるかを小さく確かめる工程です。監視間隔、判定回数、タイムアウト時間の組み合わせで検知精度は大きく変わるため、この確認が欠かせません。
いきなり全社に導入すると、閾値の設定ミスによる誤検知や、本当の障害の見逃しが全社規模で起きるおそれがあります。このため、影響の少ない対象で実データを使って妥当性を確かめ、本番導入の範囲を段階的に広げる進め方が現実的です。
死活監視にPoCが必要な理由
資料上の機能比較では、ダッシュボードの操作性や通知精度、初期設定の難易度が分かりにくいため、PoCで実際に動かして確かめます。
- 通知内容:受け取ったアラートの分かりやすさ
- 閾値設定:GUIでの細かな調整のしやすさ
- 実運用との適合:本番に近い環境での使い勝手
カタログ上では同等に見えるツールでも、使ってみると差が出ることがあります。そのため、実際の運用に近いトライアルを行うと、本番導入後に想定と違うと気づく事態を避けやすくなります。
PoCで検証すべき範囲の考え方
検証の対象は、業務停止につながる機器などの影響度を踏まえて選びます。そのうえで、検証中の影響を許容できる範囲に絞ります。
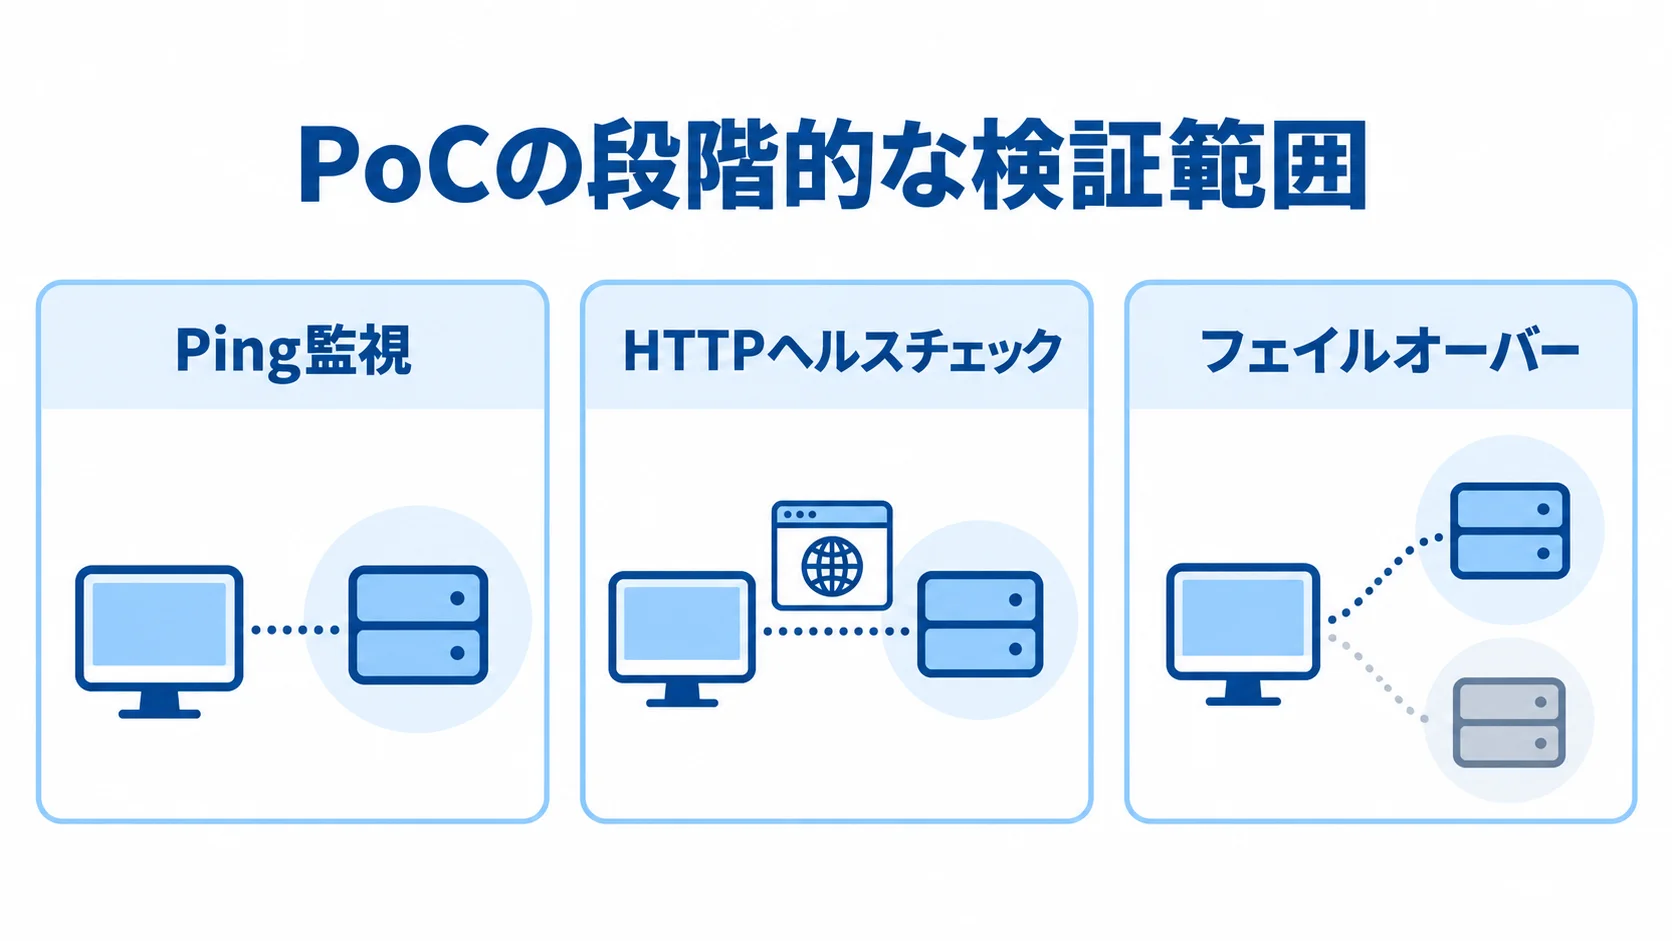
- 着手時:社内向け業務システムでPing監視を試す
- 精度確認後:HTTPヘルスチェックやポート監視へ広げる
- 次の段階:冗長化構成のフェイルオーバーを検証する
すべての方式とシステムを一度に試すと、確認項目が広がって評価がぼやけます。反対に、1回のPoCで範囲を絞れば、検証期間の短縮にもつながります。
検証の進め方(無料トライアル・OSS活用)
死活監視のPoCは、費用をかけずに始められる方法があり、ツール選定の段階に応じて使い分けます。
SaaS型無料トライアルの活用
Datadog、New Relic、Mackerelなど多くの主要なSaaS型監視ツールは、機能制限のない無料トライアルを提供しています。
- Mackerel:有料機能を含めて2週間試せる
- AWS中心の環境:CloudWatchを初期費用0円で始められる
たとえば、Mackerelのトライアル中に判定ロジックを設定し、サーバーを意図的に停止して、アラートが発報されるかを確かめます。
無料期間には限りがあるため、事前に検証項目を一覧にしておき、期間内に効率よく評価を終えられるよう準備します。
OSS型(Zabbix等)でのプロトタイピング
ZabbixやNagiosは、ソフトウェアのライセンスが無料で、自由に構築して試せます。
- 強み:独自の判定ロジックやアラート条件を組み込める
- 留意点:構築や設定変更に人件費と時間がかかる
社内に技術力のあるエンジニアがいれば、ライセンス費用をかけずにプロトタイプを作成できます。
小規模案件でも構築に約1週間かかった実例があるため、PoCの期間には一定の余裕を見込んでおく必要があります。
フルスクラッチで独自開発を見据える場合は、本テーマの「フルスクラッチ・オーダーメイド開発」編も参照してください。
検証すべき項目
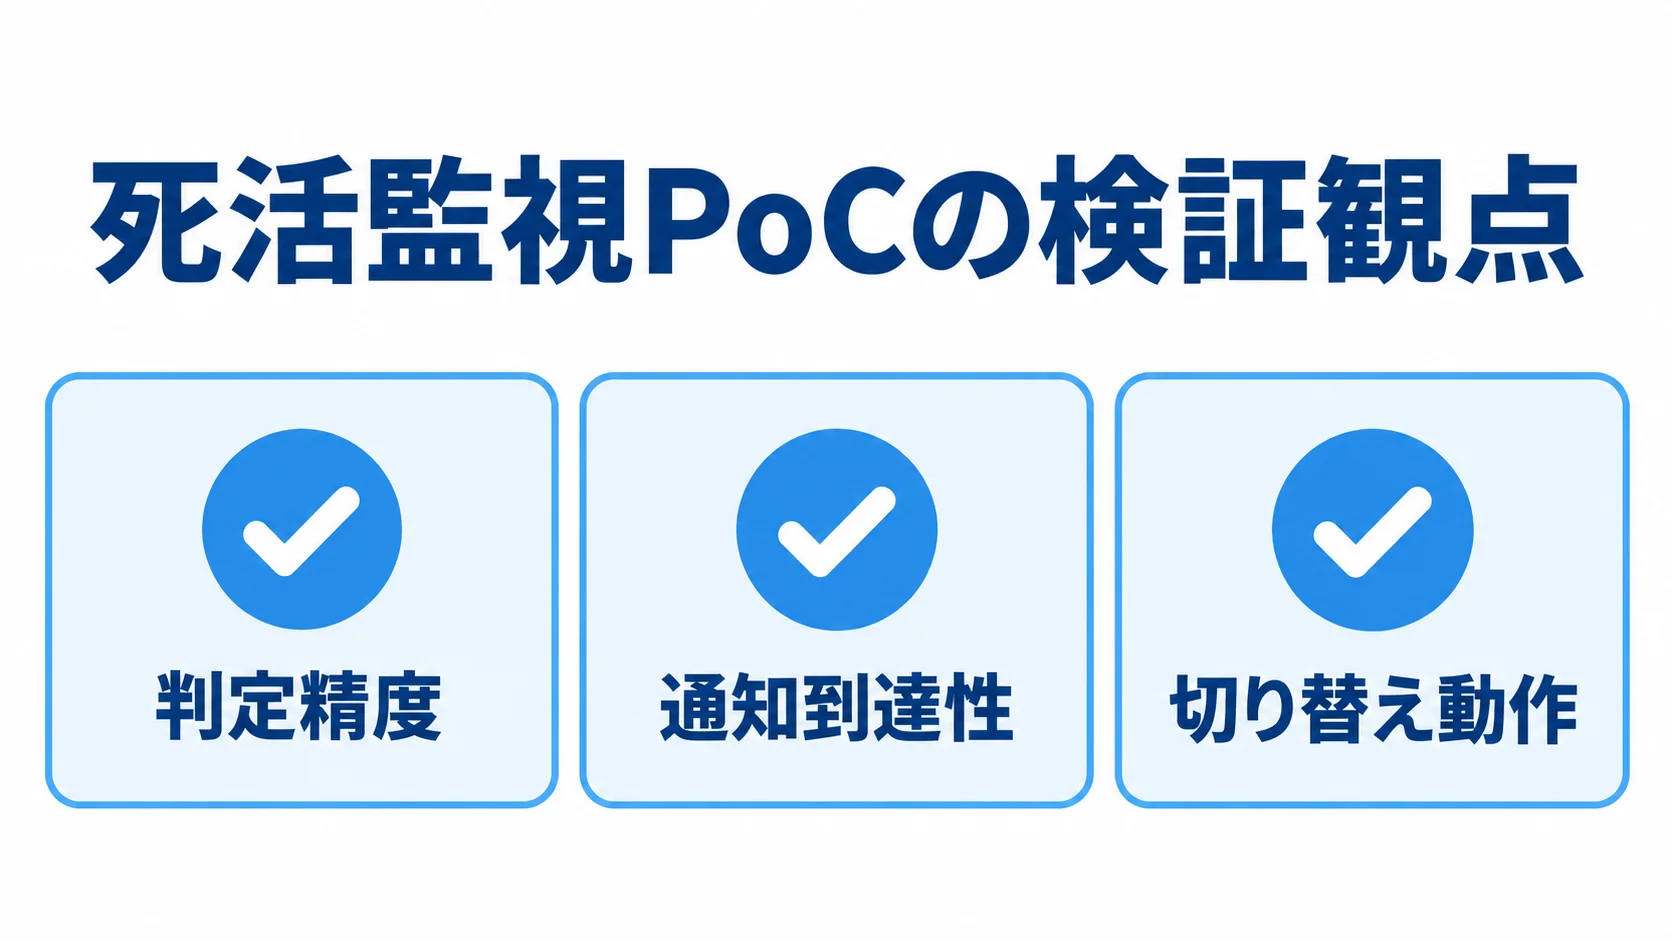
PoCで確かめる項目は多岐にわたりますが、特に判定精度、通知到達性、切り替え動作を押さえます。
誤検知率・閾値の段階設定
まず、誤検知や過検知がどの程度起きるかを調べます。頻繁な通知によるアラート疲れを防ぐため、閾値は複数の段階に分けて設けます。
- CPU負荷:Load Averageを4、8、12で段階設定する
- ディスク使用量:80%、90%、95%の水準で分ける
たとえば、CPU負荷では4以上を警告、8以上を軽度障害、12以上を重度障害とします。
PoCで各水準を試し、データをもとに現場にとって過不足のない通知頻度を決めます。適切な段階設定を行えば、本番運用で「アラート地獄」に陥るのを避けられます。
通知到達性とアラート設計のテスト
「どのログを、どんな条件で、誰に通知するか」という設計が妥当かを検証します。
- 通知条件:条件分岐をできる限りシンプルにする
- 到達確認:擬似障害を起こし、通知が確実に届くかを試す
設計が複雑になるほど、設定ミスで重要な通知が届かないリスクが高まります。
実際に、特定キーワードを含むログだけをSlackへ通知する設定を誤り、障害の発見が3時間遅れた事例があります。このため、本番での検知漏れを防ぐには、PoCの段階で通知の経路を押さえておく必要があります。
冗長化構成でのフェイルオーバー切替テスト(擬似障害演習)
ロードバランサーやDNSフェイルオーバーと連携する場合は、PoCの中で擬似障害演習を行います。
- 障害の再現:サーバー停止やLANケーブル切断で疎通を遮断する
- 切替の確認:判定の発火後、想定した動作を確かめる
- 復旧の確認:切り戻し後に想定外の状態がないか調べる
切替にかかった時間も確認しておくと、単体の判定ロジックだけでは分からないシステム全体の挙動を検証できます。
演習は一度で終わらせず、判定ロジックを調整するたびに繰り返すのが理想です。さらに、変更による意図しない副作用も、その都度確かめます。
検証期間・費用感
死活監視のPoCにかかる期間と費用は、選ぶツールや検証範囲によって変わります。
ツール別構築時間の目安
PoC用の環境構築にかかる時間は、ツールごとに大きく異なります。
- 短時間で開始:CloudWatchは約30分、OpManagerは最短10分
- OSSで構築:Zabbixは小規模でも約1週間の実例がある
- 無料期間:Mackerelは2週間、Site24x7等は30日間が目安
CloudWatchやOpManagerなら、当日中に基本的な検証を始められます。
Zabbixは独自ロジックを試すプロトタイプに適しますが、準備にはSaaS型より長い時間を見込みます。
無料期間を1回のPoCサイクルの単位とみなし、確認項目を計画的に進めていく方法が現実的です。
PoCコストの内訳
PoCの段階は、初期費用を大きく抑えて進められます。特に、主要SaaSの無料トライアルなら、機能制限なしで評価できます。
- SaaS無料トライアル:ツール利用料の支出は基本的にない
- CloudWatch:初期費用0円に近い形で始められる
- Zabbix・Nagios:ソフトウェアのライセンス費用は0円
CloudWatchは従量課金制ですが、PoCのデータ量はごくわずかです。
一方で、実質的なコストの中心は、担当者が検証や調整に使う人件費です。検証項目の明確さが工数を左右します。
項目が曖昧だと期間内に評価を終えられず、期間の延長や再契約で追加費用が生じることもあります。そのため、事前の準備によって、PoCの費用対効果は大きく変わります。
PoCで陥りやすい落とし穴
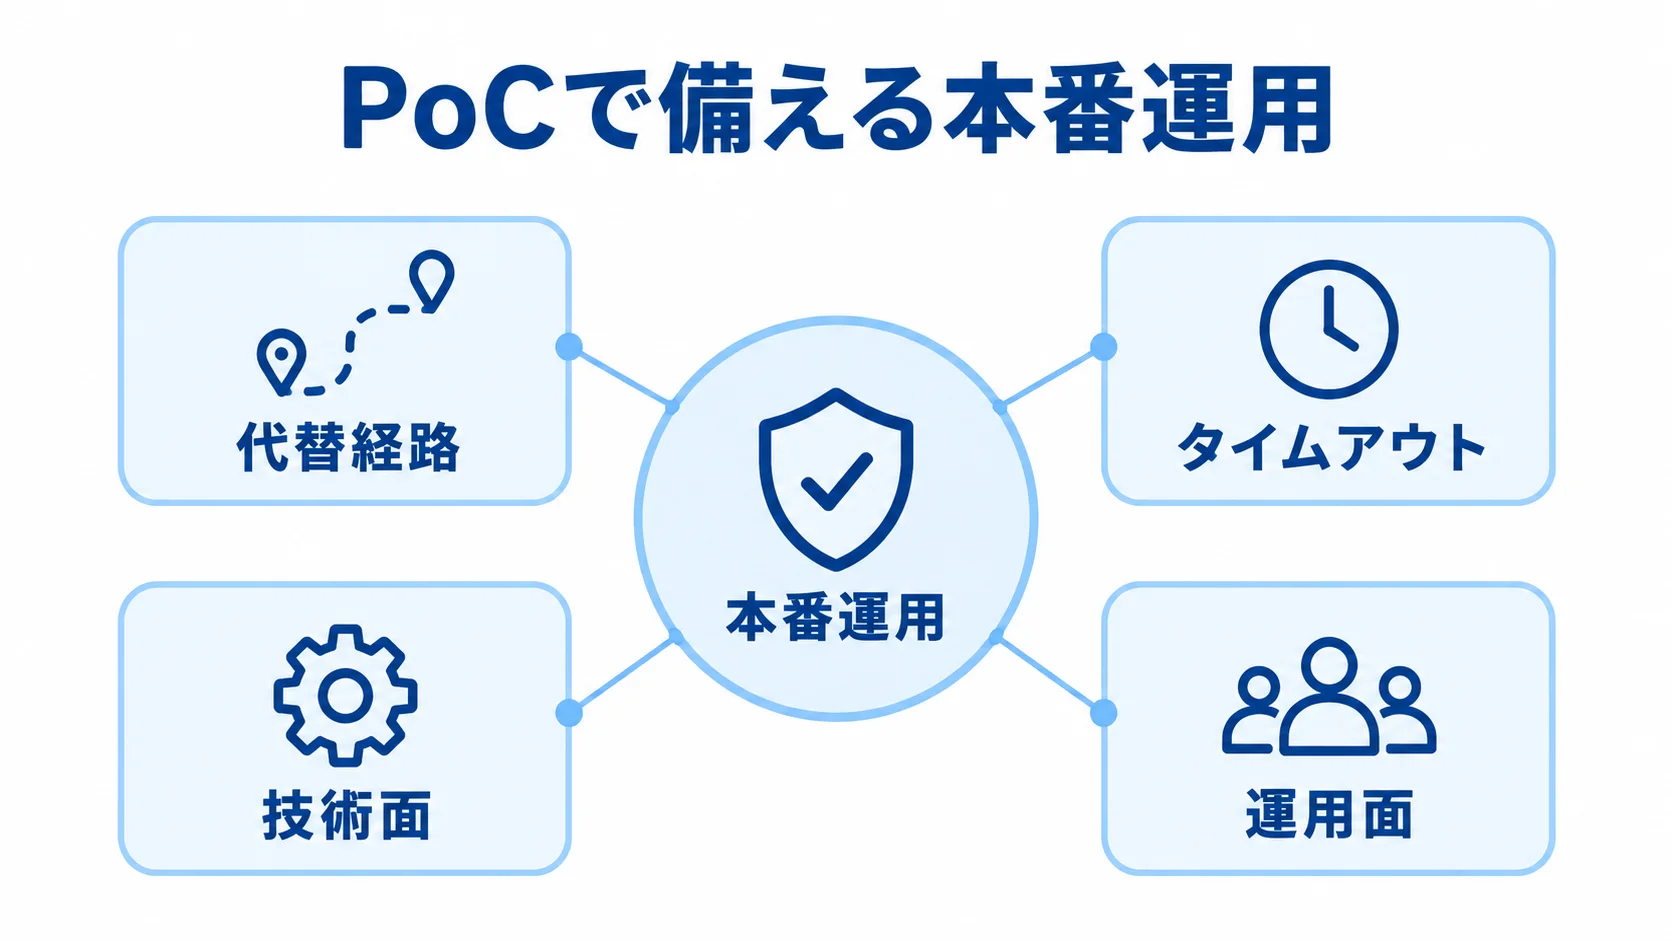
PoCで見落としがあると、本番運用後に深刻な問題が起きることがあります。
「失敗系(異常系)」の未設計
監視ツールの停止や通知APIとの連携失敗に備えた代替経路を設計しないことが、落とし穴になります。
- ツール障害:監視自体が止まった場合を想定する
- 通知連携の失敗:通知が届かない場合の経路を確認する
- タイムアウト:設定が妥当か検証する
死活監視は、異常を検知して知らせる仕組みです。そのため、監視自体の停止に備えていないと、肝心なときに誰にも通知が届かないおそれがあります。
PoCの間にこれらを検証しておけば、本番運用での監視の死角を防げます。
現場リソースの過小評価
アラートを受けて対応するオペレーターや情シス担当者を、PoCの段階から参加させないことも落とし穴です。
- 技術面:誤検知率や切り替え動作を評価する
- 運用面:担当者が現実的に運用できるかを確かめる
情シス部門やベンダーだけで進めると、判定ロジックが優れていても現場の運用と合わないことがあります。
その結果、本番導入後に定着しないこともあります。Go/No-Go判断では、技術面と運用面を併せて見ます。
まとめ
死活監視のPoC・プロトタイプ開発について、進め方、検証項目、期間・費用、落とし穴を順に解説しました。
無料期間の目安は、Mackerelが2週間、Site24x7等が30日間です。OSSはライセンス費用がかかりませんが、構築や設定変更には人件費と時間がかかります。
閾値は段階的に設定し、通知が確実に届くかも確かめます。ロードバランサーやDNSフェイルオーバーと連携する場合は、擬似障害演習も行います。
構築時間はCloudWatchで約30分、OpManagerで最短10分です。OSSや独自ロジックの検証には約1週間を見込みます。
代替経路を設計せず、現場のオペレーターを加えないまま進めると、本番後の定着が妨げられます。
代替経路を用意し、現場のオペレーターを交えてGo/No-Goを判断することが、実運用に耐える仕組みを立ち上げる近道です。
▼全体ガイドの記事
・ITシステム死活監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。