
ITシステムログ監視基盤の構築は、対象の棚卸しとツール選定から始め、ログの集約・構造化、監査保管設計、異常検知と本番移行の順で進みます。
開発期間は、ツールを動かすまでと実運用に耐えるまでで大きく異なり、納期の見通しもその違いに左右されます。各テーマの詳細は関連記事もご覧ください。
▼全体ガイドの記事
・ITシステムログ監視の完全ガイド
ITシステムログ監視は、複数システムのログを集めて一つにまとめ、構造化・保管して異常を検知する仕組みです。対象には、アプリケーションサーバーやWebサーバーに加え、ネットワーク機器やクラウドサービスがあります。障害の予兆や不正アクセス、性能劣化などを、ログから検知します。
死活・性能監視はCPU使用率やディスク容量、応答速度を見張ります。一方、ログ監視は大量のテキストを分析できる基盤づくりが中心で、アラート後の一次対応やオンコール整備とも役割が異なります。
ログやアラートなどのデータは急増し、担当者が手作業で異常を見つけるのは難しくなっています。こうした中で、AIOps(IT運用のための人工知能)の活用も広がっています。さらに、AIが数百万行のログを絞り込み、根本原因を特定する仕組みも登場しました。
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ログ監視基盤構築の開発期間の全体像
ツールの起動と実運用化では、必要な期間が異なります。AWS CloudWatch Logsの標準機能では、個人エンジニアが約30分で基本のログ収集を設定した例があります。ただし、この事例はツール単体の初期設定を示すもので、複数システムのログ形式の統一や監査要件を満たす保管、異常検知の調整は別途必要です。
近接領域の保守監視体制では、標準的な規模でヒアリングから運用開始まで1〜2ヶ月が目安です。中堅企業向けのアウトソースでは1〜3ヶ月とされています。
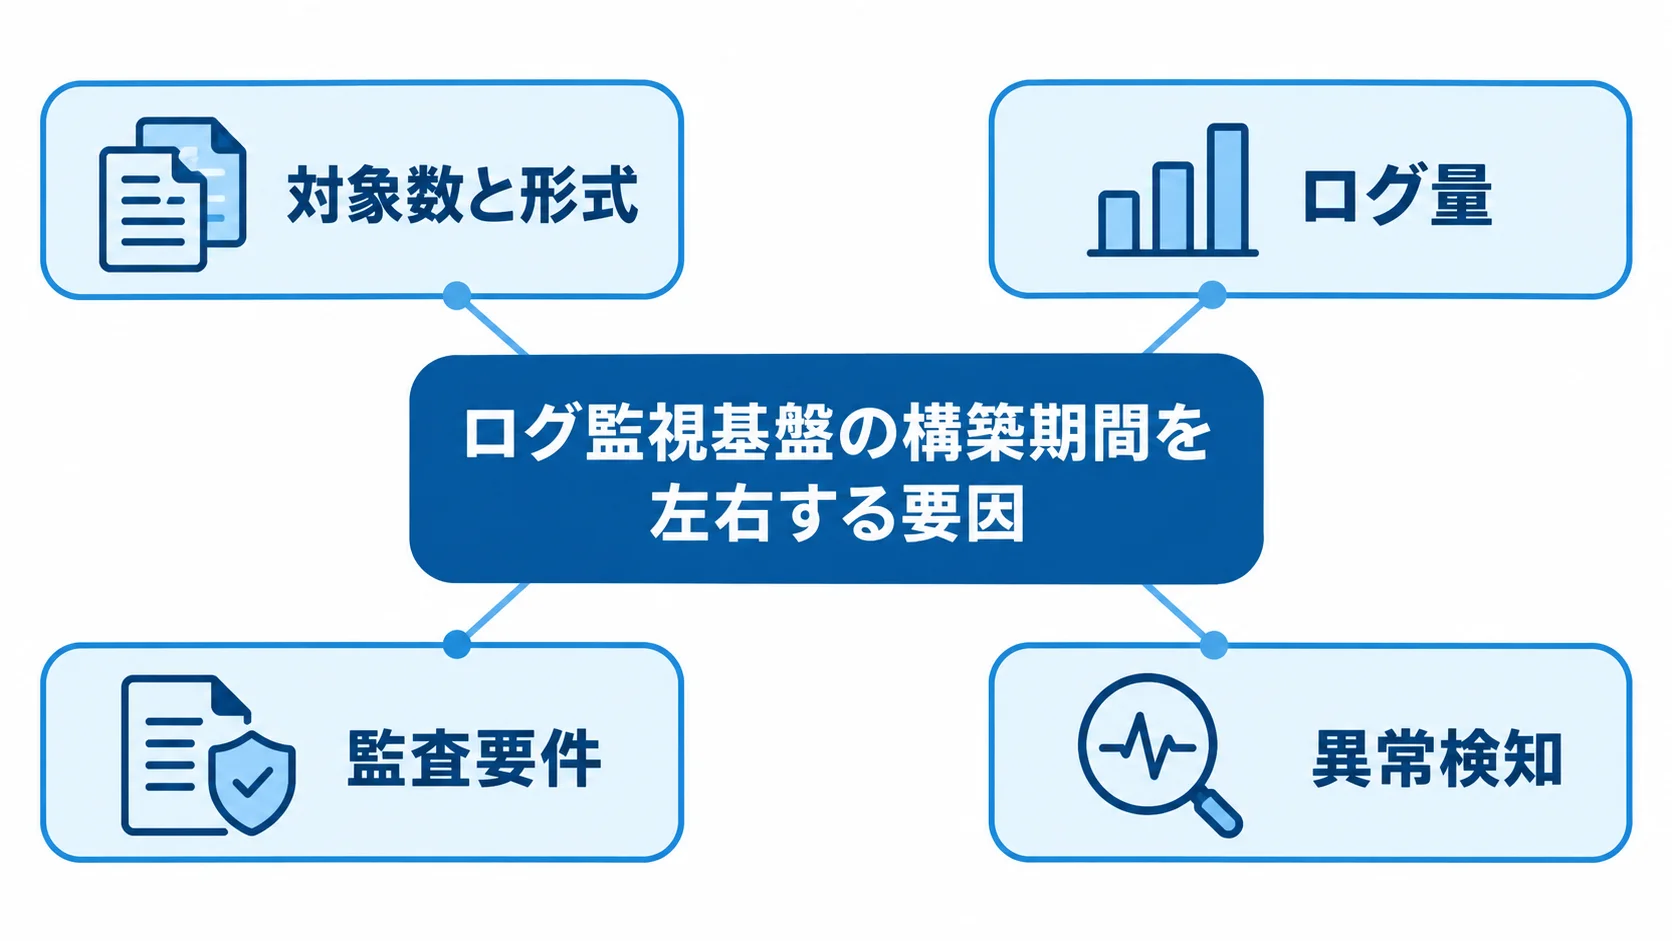
ログ監視基盤では、対象システム数やログ形式の多様性も期間に影響します。監査要件や異常検知の組み込み度合いも、期間を左右する要素です。
「ツールの設定完了」と「基盤としての実運用化」は別物
SaaS型ツールはGUIで操作でき、短時間でログの取り込みを始められます。CloudWatch Logsでは基本設定が約30分で完了した例があります。
- SaaS型:Datadog Logsはマルチクラウド収集に対応し、テンプレートで初日稼働も可能です。
- OSS:Zabbixで約50台のサーバーを手作業で構築した事例は約1週間です。
いずれも、ツールが動くまでの時間を示しています。OSSの事例は、設定ファイルや監視項目、通知を手作業で用意した実体験です。
実運用には、多様なログの構造化や監査要件に沿った保管が必要です。さらに、異常検知の誤報を抑えて現場で使える状態にするには、相応の調整期間も見込んでおく必要があります。
設定完了と実運用化を同じ期間とみなすと、後述する納期の遅れを招きかねません。
期間を左右する4つの要因
構築期間は案件ごとに幅があり、その幅を生む要因を把握すると、現実的なスケジュールを立てやすくなります。
- 対象数と形式:形式が異なるほど、解析・変換ルールの設計が増えます。
- ログ量:GB/日単位で見たログ量が、費用と性能設計に関わります。
- 監査要件:保存設計や改ざん防止、アクセス制御の検討が加わります。
- 異常検知:既製のAIOps機能を使うか、自社ログに合わせて閾値や分析を調整するかで、期間が変わります。
対象が少なく、ログ形式も統一されていれば、構造化は比較的短期間で済みます。一方、監査対応では要件定義が増え、個別の閾値やアルゴリズムを調整する場合も検証期間が必要です。
DatadogやCloudWatch Logsは従量課金制のため、取り込み量を事前に試算し、収集粒度を設計しておく必要があります。
工程別スケジュールと期間配分
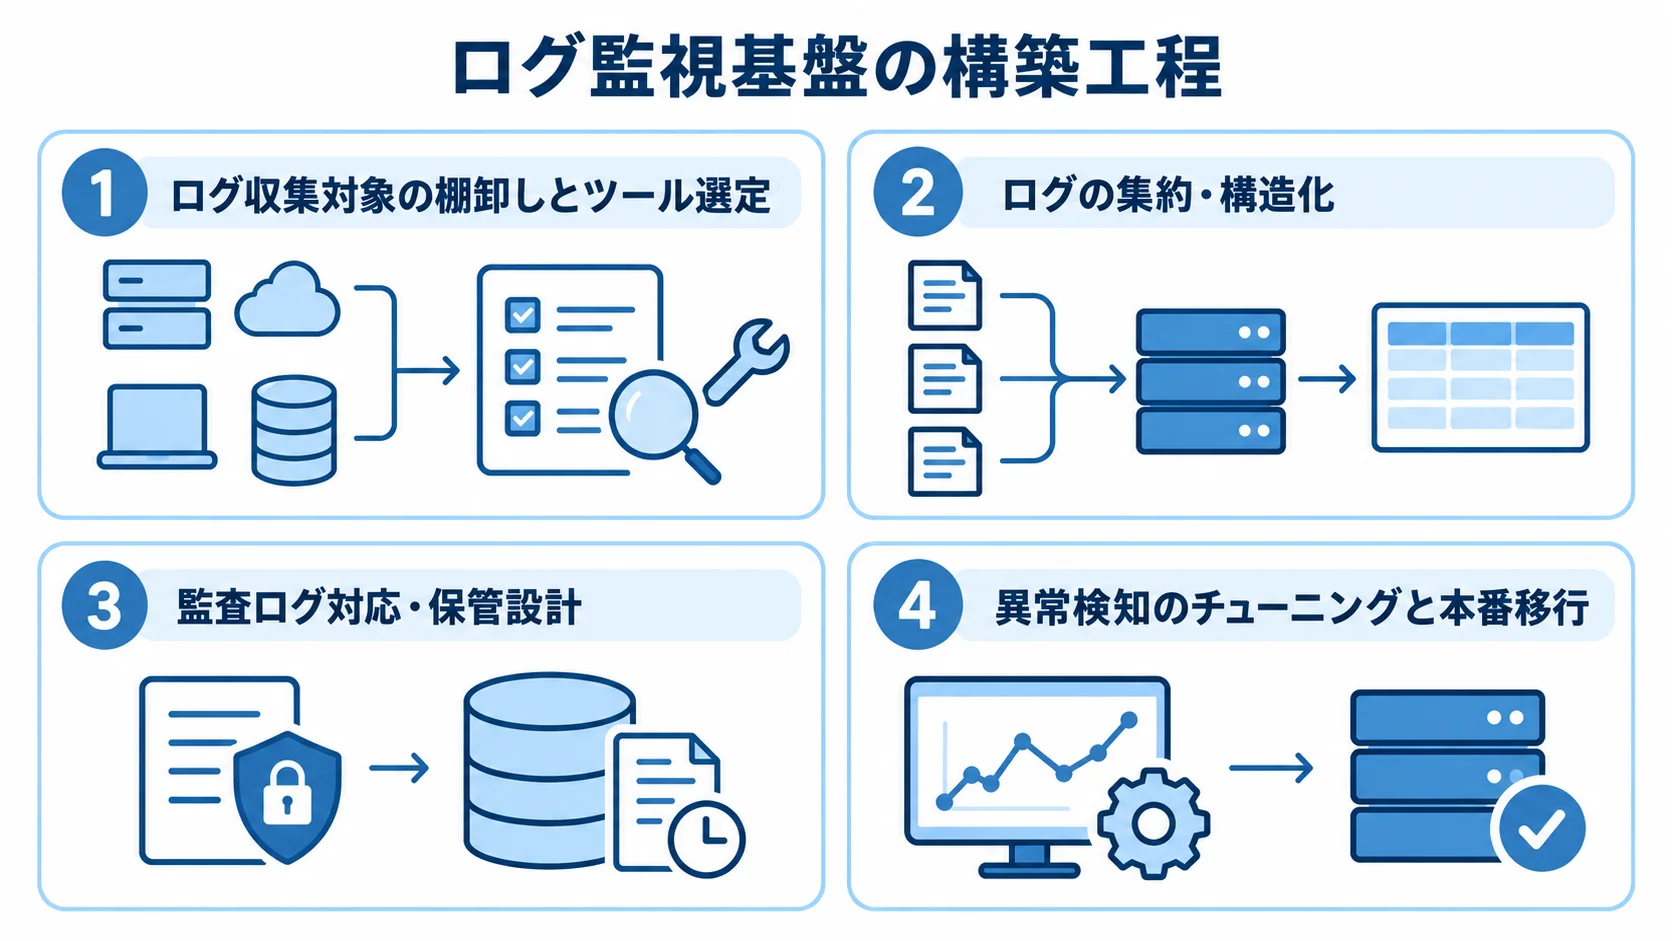
構築は大きく4段階に分けて進めるのが実務的です。各段階で何を決めるかを理解しておくと、後工程の手戻りや遅延の防止に役立ちます。
ログ収集対象の棚卸しとツール選定フェーズ
まず、発注側と開発会社が、各システムやサーバー、アプリケーションのログを洗い出し、重要度と想定ログ量も整理します。
- 候補:ELK Stack、Datadog Logs、CloudWatch Logs、Splunkから、要件に合うものを選びます。
- AWS中心:AWS環境なら、CloudWatch Logsなどのクラウドネイティブツールが小規模開始に適しています。
- 複数クラウド:ログ、メトリクス、APMを一つにまとめて見たい場合は、Datadog Logsが候補になります。
- 検索・分析重視:Splunkはエンタープライズ標準として評価されますが、ライセンス費用が高額になりやすいため、費用面も確かめます。
ログには、アプリケーション、アクセス、セキュリティなどの種類があります。ツールの選定と並行して保管期間や監査要件も決めておくと、後続の設計が進めやすくなります。
対象範囲が明確であれば、この工程は数週間程度で完了させるのが現実的です。ただし、期間は対象システム数とログ出力状況の把握度によって変わります。
ログの集約・構造化フェーズ
ツールを選んだ後は、各システムからログを集めて集約し、構造化します。この工程は、特に工数がかかりやすい部分です。
- 形式の変換:異なるログを、分析できる統一形式に変換・解析します。
- 項目の整理:発生日時や発生元、重要度、メッセージを、分析しやすい形にそろえる作業です。
- 画面設計:必要な情報をひと目で把握できるダッシュボードの設計です。
Datadogのように、複数クラウドやリージョンにまたがるログをまとめて管理できるツールもあります。一方で、形式の統一は各社の出力仕様にも左右されます。対象システムが多い場合やレガシーシステムが混在する場合、構造化にかかる期間は長くなる傾向があります。
監査ログ対応・保管設計フェーズ
集約・構造化と並行して、または直後に、監査ログやアクセスログの保存要件を満たす設計を進めます。
- 対象ログ:認証ログや操作ログ、システムと通信のログを扱います。
- 保管方針:保存期間とアクセス制御を、法令や業界基準、社内規程に照らして決めます。
- 要件確認:コンプライアンス部門や法務部門との連携が必要です。
認証ログや操作ログは、内部統制や第三者監査に使われる重要なデータです。保存要件は業界や企業によって異なるため、社内規程などで確かめておく必要があります。
CloudWatch Logsなどのクラウド型ツールは、保管が長期化するとストレージ費用が増えます。さらに、保管期間は運用費用にも関わります。
異常検知(アノマリー検知)のチューニングと本番移行フェーズ
ログの構造化と保管設計が済んだら、開発会社が異常検知を組み込み、調整します。AIOpsは、ログやメトリクスの傾向をAIで学習する方法です。
- 既製機能:Datadog、New Relic、Dynatraceの標準機能なら、比較的短期間で導入できます。
- 個別調整:自社ログに合わせた閾値や分析ロジックには、実データでの試行が必要です。
異常検知は、異常パターンを捉えて、不要な通知を抑えたり根本原因の推定を支援したりします。ただし、調整が足りないまま本番運用に入ると、誤検知が増えて、現場が通知に慣れてしまう「アラート疲れ」を招くおそれがあります。
そのため、本番移行の前に一定期間並走させ、実際のログで検知を確かめてから完全移行するのが望ましい進め方です。
SaaS型ツールとOSS自社構築のスケジュール比較
ログ収集・分析の中核ツールを、SaaS型(クラウドサービス)で使うか、OSS(オープンソース)で自社構築するかによって、スケジュールは大きく異なります。この選択は納期に直結する重要な判断です。
SaaS型ログ管理ツール(Datadog Logs、CloudWatch Logs等)の場合
Datadog LogsやCloudWatch Logsはサーバー構築が不要で、GUIから操作できます。ログ取り込みは、導入初日から始められる場合が一般的です。
- 基本設定:CloudWatch Logsで約30分で完了した事例があります。
- 小規模開始:主要なシステムのログだけを対象にできます。
- 立ち上がり:インフラ保守が不要なため、OSS自社構築より早く進みます。
取り込みを始めることと、実運用に耐える基盤を完成させることは、別の作業です。構造化や監査対応、異常検知の調整には、別途期間がかかります。
SaaS型ツールは、納期を優先したいプロジェクトと相性のよい選択肢です。
OSS(Elastic Stack、Zabbix等)で自社構築する場合
Elastic StackやZabbixはライセンス費用が無料です。一方、構築からエージェント設定、パース処理、更新対応までを自社で担います。
- 作業範囲:サーバー構築からアップデート対応までが、自社の範囲です。
- 必要な知識:正規表現によるログ解析などの専門知識が求められます。
- 納期との兼ね合い:時間をかけて要件に合わせるか、納期を優先してSaaS型を選ぶかで判断が分かれます。
Zabbixで約50台のサーバーを手作業で構築した事例では、約1週間かかりました。この約1週間は、基本的な監視設定にかかった時間です。
構造化や監査対応、異常検知の調整を含めると、さらに時間が必要です。コマンド操作に不慣れなチームでは、期間が長引くことがあります。
自社構築を選ぶかどうかの詳しい検討は、「フルスクラッチ・オーダーメイド開発」編で解説しています。
納期を短縮する具体的な方法
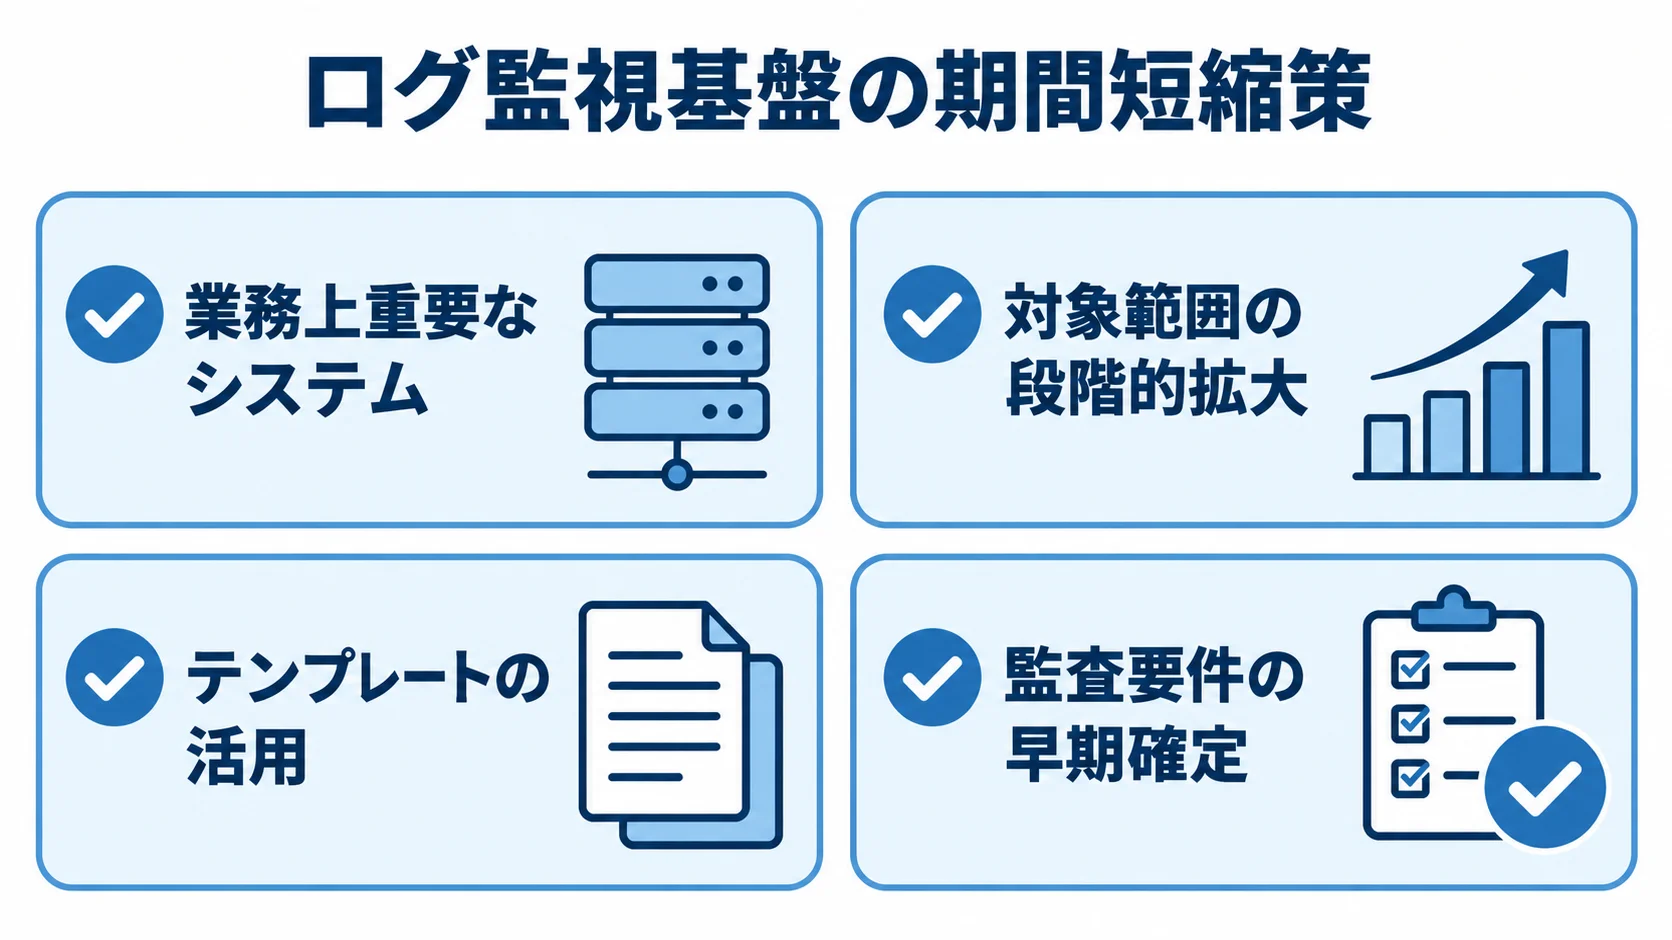
ログ分析の品質を保ったまま構築期間を縮められるかは、対象範囲と要件確定の進め方で決まります。
収集対象ログの絞り込みによるスモールスタート
まずは業務上重要なシステムから始めます。全システムの全ログを一度に扱うより、小規模に導入して運用しながら改善する方法が、失敗しにくいとされています。
- 対象を限定:障害時の影響が大きい基幹システムを優先します。
- 段階的に拡大:稼働が安定してから、対象範囲を広げます。
多機能で複雑な設定を最初から目指すと、形式の統一と異常検知の調整が同時に発生します。これが導入期間を延ばす原因になります。
テンプレートの活用と監査要件の早期確定
SaaS型のダッシュボードやアラートのテンプレートを使えば、画面を一から設計するよりも短い期間で、構造化と画面での表示を完了できます。
- 監査要件を早く決める:保管期間やアクセス制御は、収集設計に関わります。
- 契約を使い分ける:棚卸しは準委任、仕様確定後の構造化や保管設計、実装は請負が有効です。
監査要件の確定が遅れると、後工程で設計変更や手戻りが発生するリスクが高まります。
納期遅延の典型要因と対策
綿密に計画しても、ログ監視基盤の構築には遅延のリスクが残ります。起こりやすい要因とその対策を押さえておくと、遅れを小さくできます。
ログフォーマットの多様性による構造化作業の長期化
最も多い遅延要因は、構造化の工程で対象ログの形式が想定以上に異なると分かることです。レガシーシステムでは形式が標準化されていないことがあり、個別の解析処理が必要になる場合があります。
- 初期に棚卸し:収集対象を丁寧に洗い出します。
- サンプルを取得:実際のログで、構造化の難易度を早めに見ておきます。
事前の確認がないと、構造化の工程で想定外の工数が発生します。こうした工数の増加は、後続の監査対応や異常検知にも影響しかねません。
監査要件の確定遅れとアラート誤検知の多発
第二の遅延要因は、監査要件の確定が後回しになることです。終盤に保存期間やアクセス制御を見直すと、調整に時間がかかり、設計をやり直す場合があります。
- 監査要件:要件定義の初期に確認し、ほかの作業と並行して進めます。
- 検知の調整:必須の工程として、計画に期間を確保します。
第三の遅延要因は、異常検知の調整不足による誤検知の増加です。試験期間を確保しないまま稼働時期を決めると、現場の信頼を損なう通知が続くおそれがあります。
まとめ
ログ監視の構築では、ツール設定と実運用化に必要な期間を分けて考えます。CloudWatch Logsは約30分で取り込みを始めた例がありますが、実運用には、構造化や監査を満たす保管設計、異常検知の調整も欠かせません。対象の数やログ形式、ログ量が期間を左右し、監査要件も期間に影響します。
工程は、棚卸しとツール選定から始まり、集約と構造化、監査と保管の設計を経て、異常検知と本番移行へ進みます。期間を縮めるには、対象の絞り込み、テンプレートの活用、監査要件の早期確定が役立ちます。
まずは、現状の構成や収集したいログ、想定量をまとめ、複数の開発会社やログ管理サービス会社に提示して見積もりを取ることから相談を始めます。
▼全体ガイドの記事
・ITシステムログ監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。