
ITシステム監視対応のPoCは、対象を絞って通知経路と当番体制を試し、KPIで評価してから導入します。
体制を急に替えると、担当や基準が現場に浸透せずに遅れを招くおそれがあります。試すだけで終えると、本番で不備が見つかり、手戻りやトラブルを招きかねません。
▼全体ガイドの記事
・ITシステム監視対応の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム監視対応のPoC・パイロット運用の概要
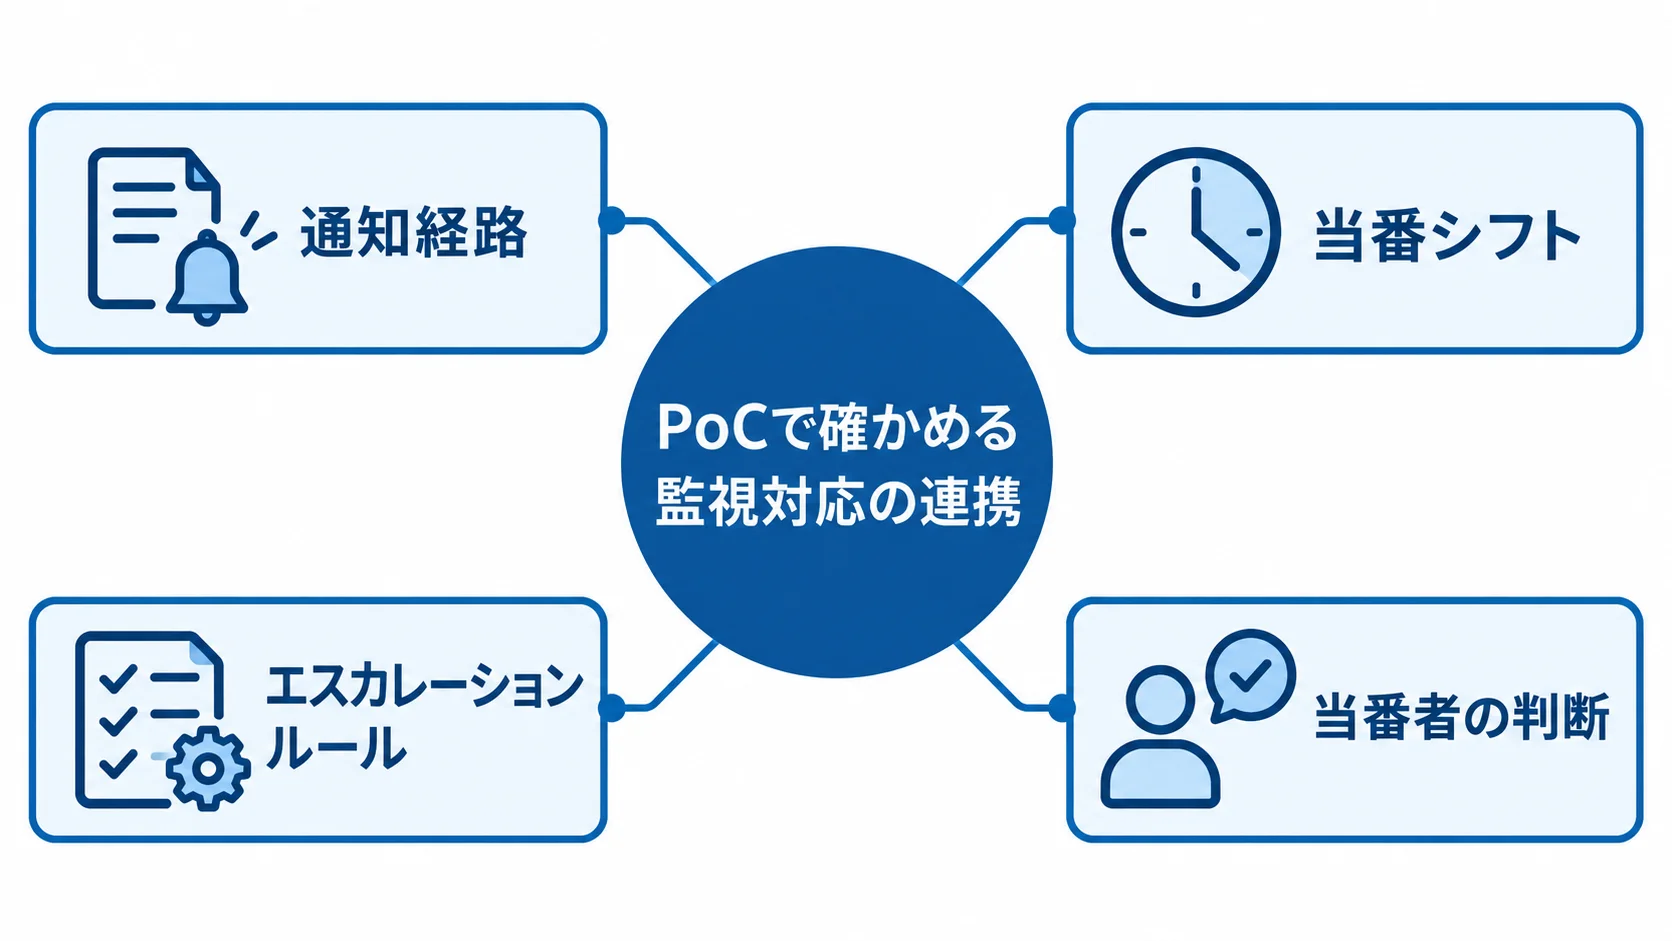
アラートの一次対応、当番体制、エスカレーションルールのPoCは、本格導入の前に範囲を絞って運用を試す検証です。範囲を絞るのは、大規模なトラブルを防ぎながら実用性を確かめるためです。
対象は、たとえば「止まったら業務停止になる機器」などに絞り、スモールスタートで始めます。
通常のシステム開発と違い、ツールだけでなく人とプロセスの連携も検証します。また、アラート時に当番者がどう動くか、基準に沿って判断できるかも確かめます。
通知経路の疎通確認(擬似障害テスト)
PoCの最初に、通知経路が正しく働くかを疎通テストで確かめます。
- 擬似障害の発生:監視ツールの設定後に、LANケーブルを抜くなどして障害を起こします。
- 通知の到達確認:異常の検知後、メール、SlackやTeamsなどのチャット、電話音声へ即時に届くかどうか。
- 閾値の調整:一瞬のスパイクは無視し、5分続いたら通知するなど継続時間を設定して、ノイズを抑えます。
- 代替経路の確認:一つの通知経路を止めたときに、代替の連絡手段が作動するかどうかを試します。
通知が多すぎると、当番者は対応が必要な異常に集中しにくくなります。
当番シフト・エスカレーション基準の検証
通知経路を確かめたら、次は基準どおりに当番シフトが回るかを試します。
- 障害対応の試行:一部のシステムを監視対象に加え、検知から報告までの流れを確かめます。
- 報告基準:検知から15分以内に解決できなければ上位者へ報告し、影響ユーザーが100人以上ならIT部長へ連絡します。
- 当番者の参加:当番者をPoCに巻き込みます。経営層やIT部門だけで決めると、既存業務に組み込めず、手間が増えたと現場が反発することがあります。
- 委託先の評価:外部ベンダーは、提案書には表れにくい連絡の円滑さや、改善提案への積極性も見ます。
パイロット運用の進め方
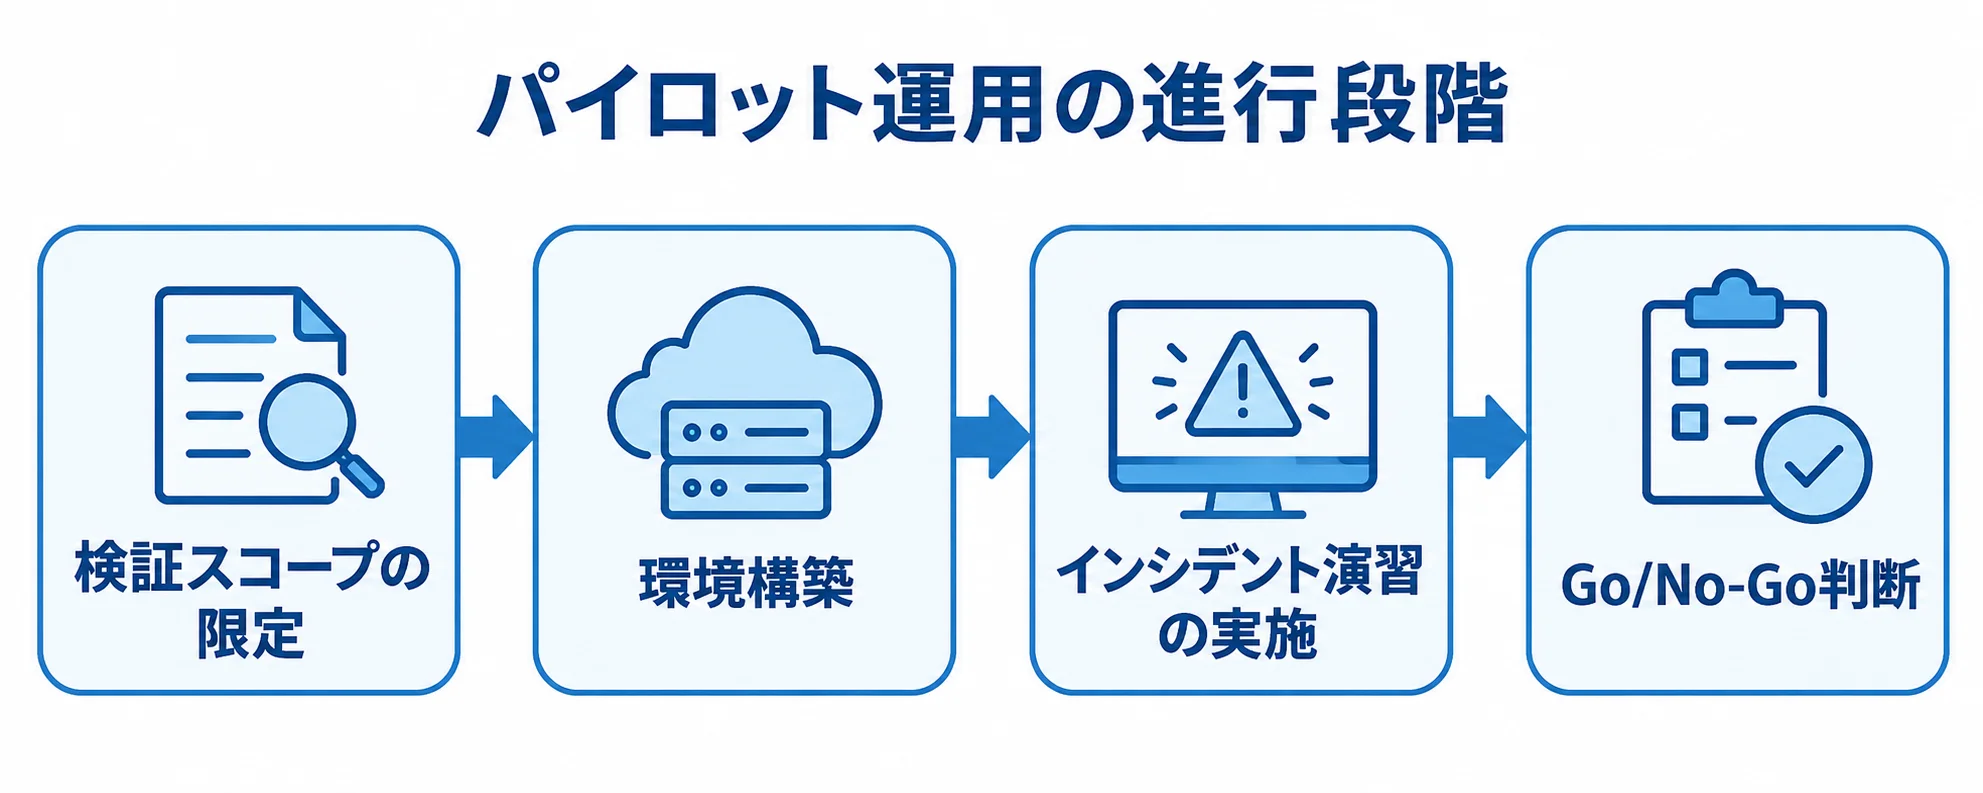
運用の検証は、現場業務の流れに乗るかを確かめるプロトタイプ(パイロット運用)で行います。検証範囲の限定から評価・分析まで、4つのステップで段階を追って進めます。
検証スコープの限定と環境構築
全システムへ一度に広げず、影響の少ない社内向けシステム、日中の時間帯、特定のシステムや部門のいずれかに絞ります。
次に、アラートを一次受けする担当(Tier1)から、エスカレーション先(Tier2)への導線を決めます。導線を機能させるには、通知ツールやアクセス権限も準備しておく必要があります。
当番者が使う通知ツールと対応記録の書き方まで具体的に決めておきます。さらに、実運用に近い環境を用意しておくと、後続のトライアルを進めやすくなります。
インシデント演習の実施とGo/No-Go判断
限定した環境での運用中に、必要に応じて擬似障害を起こすDR(災害復旧)演習を行います。そのうえで、マニュアルどおりにエスカレーションできるかを試します。
データと現場の声を事前の基準に照らし、全社展開(Go)、体制の見直し(再設計)、撤退(No-Go)のいずれかを判断します。
Go/No-Go判断に使う評価指標は、検証を始める前に決めておきます。評価を省いたまま検証を終えると、本番移行後も同じ課題を繰り返すおそれがあります。
検証項目とKPI(評価指標)
「とりあえず運用した」で終わるPoC死を防ぐには、運用・価値・経済の3レイヤーで、定量と定性のKPIを設定します。
運用レイヤー・価値レイヤーの指標
運用レイヤーでは、新しいオンコール体制や通知が現場に合うかを見ます。判断材料となる指標には、次の例があります。
- 誤検知率・ノイズ率:例として5%以下を目指します。
- ルール遵守率:エスカレーション基準の遵守状況。
- 情報の抜け漏れ:サポート導線上で確認する件数。
価値レイヤーでは、障害対応の速さや運用品質の向上を見ます。たとえば、検知から初期対応までの時間(MTTA)の短縮率は、30%削減が指標になります。運用オペレーターの満足度や負担感の軽減も確かめます。
旧体制や旧フローの現状値は、PoCを始める前に測っておきます。そうしないと、改善の効果を比べられません。
経済レイヤーの指標
外部MSPや監視ツールを導入する場合は、運用負担の軽減や障害防止の効果が、かかる費用に見合うかを確かめます。
- 費用対効果:人件費の削減額やダウンタイム防止の効果額が、初期・運用コストを上回るか。
- ROI(投資対効果):投資額に対して効果が見合うかの評価。
経済評価は本格導入後の予算確保にも関わるため、PoCの段階からデータを集めておくことが望ましいです。
3レイヤーの基準を満たさない場合は、体制や対象範囲を見直します。無理に全社展開へ進めず、立ち止まって判断することも重要です。
期間・費用感の目安
夜間対応や休日のエスカレーションを把握するには、日次・週次の業務サイクルを一周以上回す必要があります。その期間は、最低でも数週間が標準です。
PoC・トライアル期間の目安
運用の試行と本格稼働後の並走では、期間ごとに目的と確認できる範囲が異なります。
- パイロット運用:標準は2〜4週間程度。ツールの疎通確認だけなら数日で完了します。
- 当番シフトの検証:日次・週次のサイクルを最低1周します。短期間では、夜間や休日の実態は把握しきれません。
- SaaSの無料期間:DatadogやSite24x7などは、最初の30日間を全機能利用可能とするケースが一般的で、自社環境の動作やSLAを測れます。
- PoC後の並走:本格稼働後は3〜6ヶ月程度が推奨されます。1ヶ月以下では季節業務を一巡できず、手順書の不足や見落としを十分に洗い出せません。
PoCの費用感
監視ツールと外部MSPでは費用の仕組みが異なるため、対象範囲と本格導入後の料金も含めて比べます。
- SaaS型ツール:無料期間ならPoCは0円で、10ホストで月額2,800円程度からのツールもあります。
- 無料OSS:Zabbixなどを選べますが、構築や設定変更に多くのエンジニア工数がかかります。迅速なPoCでは、SaaS型のほうが総費用を抑えやすい傾向です。
- 外部MSPへの試験委託:一次・オンコール対応は、自社人件費を除き初期・試行費用が約50万〜100万円です。
- 対象の限定:夜間・休日のみ、または重要度の高い少数のシステムに絞れば、PoC費用を抑えられます。
- 本格導入後:一次切り分けを含む場合は月額10万〜30万円、フルマネージドは月額30万円以上が相場です。
PoCの金額だけでなく、本格導入後の費用と比べて、投資対効果を見極めます。
陥りやすい失敗パターンと対策
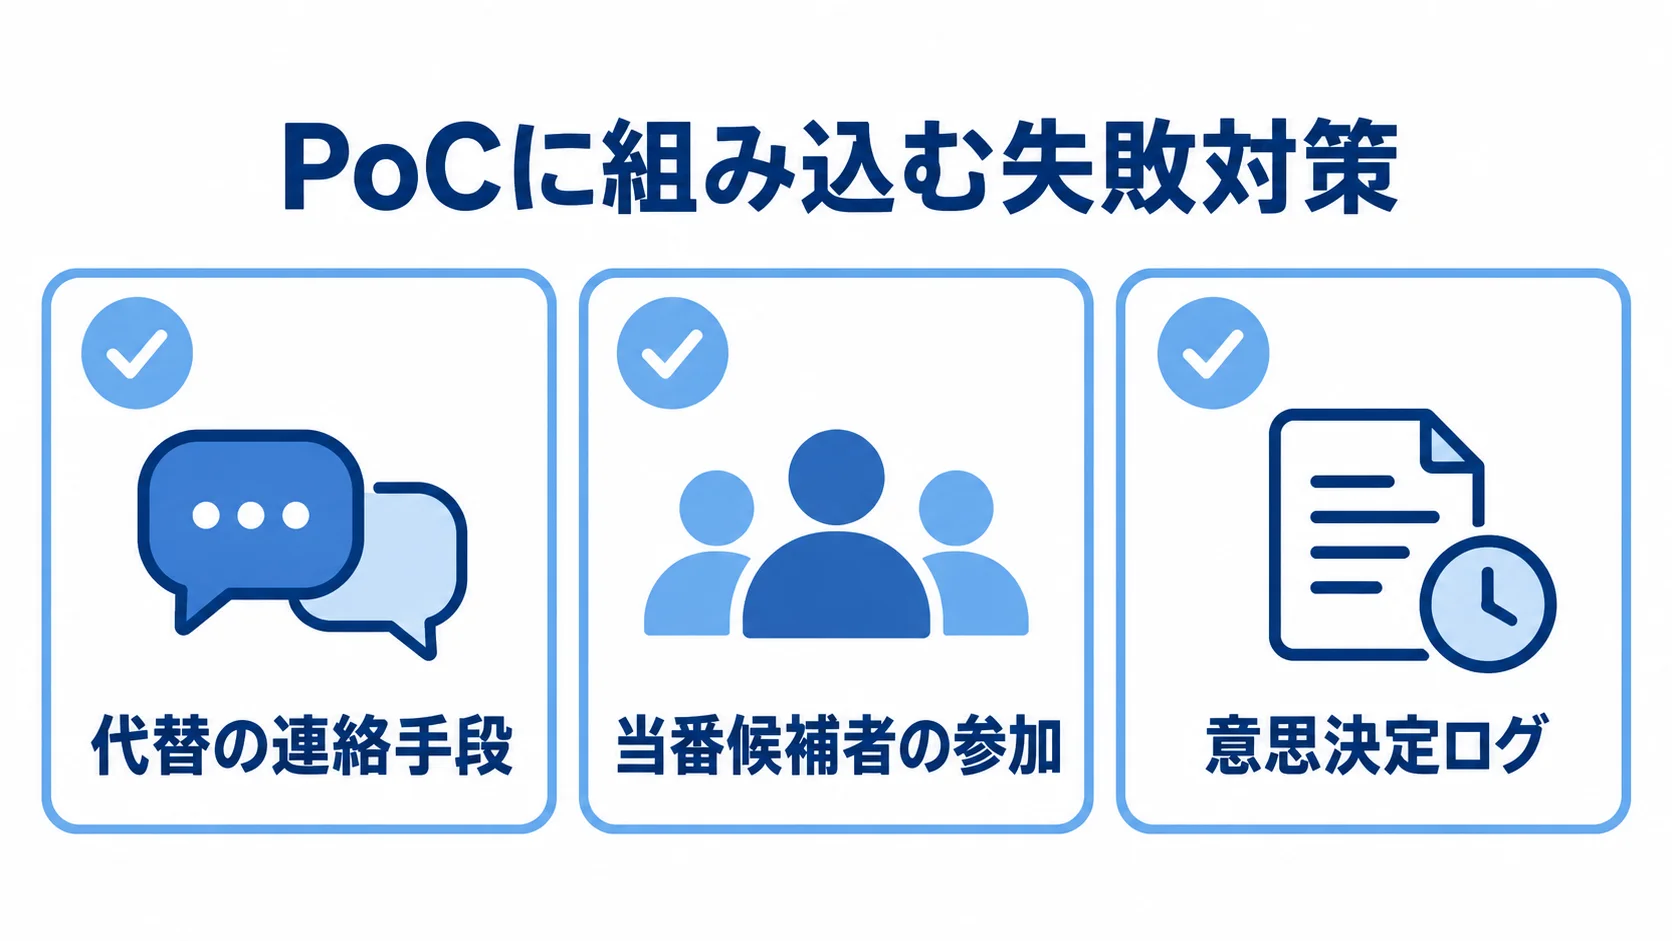
アラートの一次対応や当番体制のPoCには、典型的な失敗点があります。事前に把握して対策を組み込めば、検証の実効性を高められます。
「失敗系(異常系)」の未設計
監視ツールやPagerDuty、Slack連携などの自動エスカレーションツールが止まった場合を想定します。また、API連携の失敗も含めて、代替の連絡手段やタイムアウトを決めておきます。
失敗系の設計が抜けると、必要なときに誰にも通知されない事故につながります。そこで、PoCでは正常時だけでなく、通知経路を意図的に一つ止めます。
通知経路を止めたときに、代替手段へ正しく切り替わるかを確かめます。特に、代替手段の設計と検証は、本格導入前の必須要件です。
現場リソースの過小評価(見学者化)
運用保守の体制では、人とプロセスの連携が機能するかを確かめます。
- 当番者の不参加:既存業務に組み込めず、手間が増えたと現場が反発し、定着しないことがあります。
- 見学者化の防止:判断の迷いや心理的な負担は、傍観では把握しきれないため、計画の段階から当番候補者を参加させます。
- 演習後の記録:必ず現場の声を聞き、課題を意思決定ログに残して、運用手順書(Runbook)に反映します。
まとめ
ITシステム監視対応のPoC・プロトタイプ・モックアップ開発を、基本、進め方、KPI、期間・費用、失敗対策の順に見てきました。
PoCは、「止まったら業務停止になる機器」などに対象を絞り、スモールスタートで始めます。そのうえで、通知経路、当番シフト、エスカレーション基準を検証します。
運用・価値・経済の3つのKPIでGo/No-Goを判断します。期間の目安は2〜4週間程度です。また、外部MSPへの試験委託の初期・トライアル費用は約50万〜100万円です。
通知経路の失敗系や当番者の見学者化は、PoCが機能しなくなる典型例です。事前に対策を組み込み、見つかった課題はRunbookに反映します。
▼全体ガイドの記事
・ITシステム監視対応の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。