
ITシステム性能監視の開発期間は、数十分で済む場合から数ヶ月単位になる場合まであります。進め方を左右するのは、監視ツール、対象システム、運用で求める分析精度です。
まず、ツールを動かすまでと実用状態までを分けて見ます。全体像は、ITシステム性能監視の完全ガイドもご覧ください。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム性能監視プロジェクトの開発期間の全体像
ITシステム性能監視は、稼働中のCPU・メモリ・ディスクI/Oなどを常時計測する実務です。
WebアプリやAPIのレスポンスタイム(応答速度)、スループット(処理件数)も性能指標に含まれます。
性能指標を可視化・分析すると、遅延やボトルネックの兆候を早期に発見できます。その結果を、性能チューニングやキャパシティプランニング(将来のリソース増強計画)につなげます。
死活監視はサーバー・ネットワーク機器の稼働を判定し、保守監視は障害時の一次対応や復旧を担います。
これに対して性能監視は、正常稼働中も快適さや効率を数値で捉え、継続的な最適化を目指します。
専門的な手法として、APM(Application Performance Monitoring)では処理時間をトランザクション単位に計測し、分散トレーシングでボトルネックを特定して閾値ベースのアラートを設計します。性能・負荷を可視化して改善サイクルを回すには、こうした取り組みが必要です。
性能監視の期間は、ツールを動かすまでと、実運用に足る状態に整えるまでに分けて考えます。
ツールによる稼働開始は数十分から数週間ですが、実用状態には規模や分析精度に応じ、数週間から数ヶ月の継続的な取り組みが必要です。
この違いを押さえないと、導入後になって閾値調整やベースライン取得が足りないと分かる場合があります。そのまま稼働させると、アラートが頻発したり、本当のボトルネックを把握できなかったりするおそれがあります。そこで、期間の目安はツール導入と性能監視の立ち上げに分けて確認します。
ツール導入・初期セットアップにかかる時間
初期セットアップの所要時間は、選ぶツールによって異なります。
- CloudWatch:AWS標準の設定操作で、約30分から監視を開始できます。
- ManageEngine OpManager:最短10分で開始できる、ネットワーク・サーバー監視のパッケージ型です。
- Zabbix:OSSを自社構築した小規模案件で、約1週間かかった事例があります。
たとえばZabbixでは、設定ファイルや監視項目、アラート通知を手作業で実装します。
ただし、ここでの稼働開始は技術的な設定が終わった時点で、意味のあるデータが得られる状態とは異なります。
性能監視として運用に足るまでの期間を左右する要因
実運用に耐える状態に整えるには、セットアップ後にも追加工程が必要です。
- 設計負荷:オンプレミス型や高いカスタマイズ性を求めるほど、要件定義や設計に時間がかかります。
- 閾値調整:実データでの調整が足りないと、過検知や誤検知が増え、アラート疲れの原因になります。
- トレンド分析:時間によるデータの変化を追い、導入後も継続してPDCAを回す作業です。
この設計には、要件定義、監視項目のテンプレート作成、監視ルール設計が含まれます。
機能を最初から盛り込むと運用が複雑になるため、シンプルに始めて段階的に拡張する方法が推奨されます。
閾値は複数段階に分けて設定し、実運用データを使って調整します。このため、納期には、閾値調整とベースライン取得に加え、トレンド分析による予兆検知が機能するまでの期間を含めます。
工程別スケジュールと期間配分
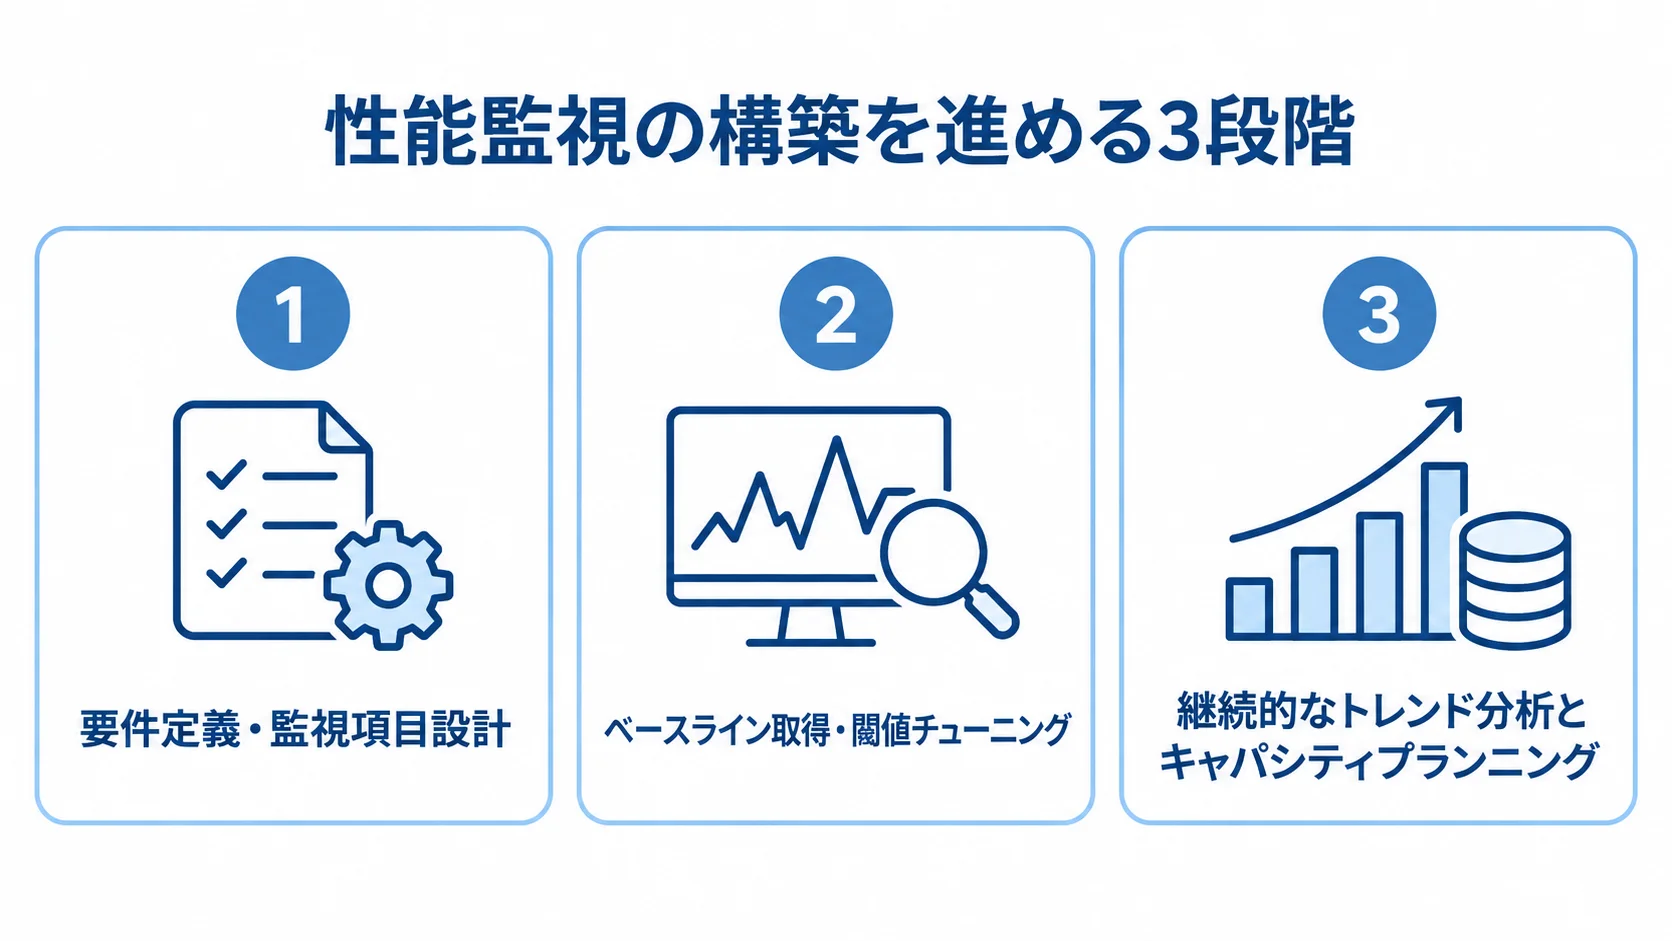
性能監視の構築は、設計、ベースライン取得と閾値調整、継続分析の3段階で進めます。
ツール導入が短く終わる場合もあります。ただし、実質的な期間の大半は、3段階を通じた精度向上に使われます。
要件定義・監視項目設計フェーズ
最初に、監視するシステムやコンポーネント、性能指標を決めておきます。
- 応答と処理:レスポンスタイムとスループットを確認します。
- リソース:CPU、メモリ、ディスクI/Oの使用状況です。
- 滞留:キュー滞留数などが対象です。
オンプレミス型や柔軟性の高いツールでは、要件定義やテンプレート作成、監視ルール設計に時間と人手がかかります。
網羅的に設計すると導入が長引くため、影響の大きいシステムやAPIに絞り、稼働後に段階的に広げます。
レスポンスタイムやスループットについても、「良好」「注意」「危険」の基準を仮に決めておくと、後の手戻りを防げます。
ベースライン取得・閾値チューニングフェーズ
監視項目を決めたら、ツールを稼働させて平常時の性能データを一定期間集めます。
ベースラインをもとに、指標ごとの閾値を複数段階で設定します。閾値が不適切だと、一時的な変動にも反応してしまい、注意すべき異常が埋もれるおそれがあります。
- Load Average(CPU負荷):4以上で警告、8以上で軽度障害、12以上で重度障害とする例です。
- ディスク・Inode使用量:80%超過で警告、90%超過で軽度障害、95%超過で重度障害とする例もあります。
数値は指標ごとに設けたうえで、実運用データや擬似負荷テストを踏まえて調整します。一度で終わらないため、調整を繰り返せる期間を確保しておきます。
継続的なトレンド分析とキャパシティプランニングのPDCA
ベースライン取得と閾値調整が済んだあとは、データを継続的に分析して、監視と調整のPDCAを回します。
- 性能データの変化から、リソース逼迫やスループット限界など将来の問題を予測します。
- 分析結果は、将来のインフラ投資やキャパシティプランニングの材料になります。
リソースを継続的に監視し、必要に応じて調整すると、システム効率を高められます。このPDCAは導入後も続きます。
立ち上がりの完了は、最初の月次または四半期レビューが一巡する時点が目安です。そのため、分析サイクルが軌道に乗る時期を納期に含めると、期待値のずれを防げます。
監視ツール導入方式によるスケジュールの違い
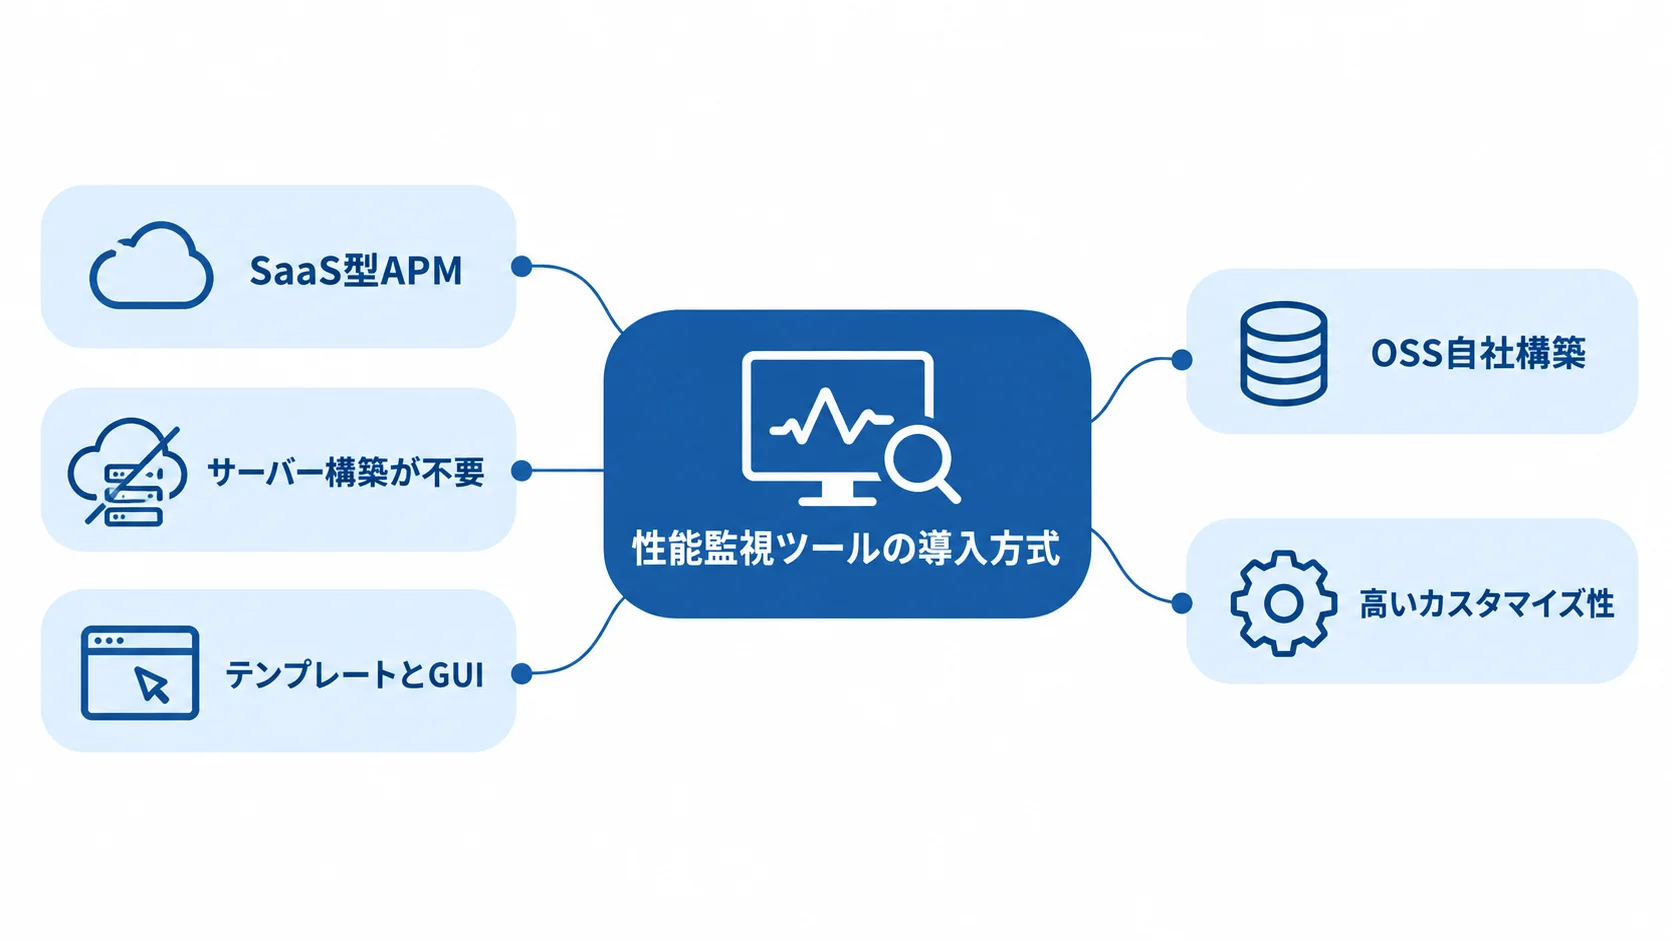
性能監視の中核ツールを、SaaS型APMで導入するか、OSSで自社構築するかによって、日程は大きく異なります。
選ぶ際は、初期設定の速さに加えて、閾値調整やカスタマイズの自由度との兼ね合いも見ておきます。
SaaS型APMツール(Datadog、New Relic等)の場合
DatadogやNew Relicは、サーバーを自前で構築する必要がなく、GUIから直感的に操作できます。初期設定のテンプレートを使えば、短期間で立ち上げられます。
- CloudWatch:AWS標準設定で、約30分からの監視開始が可能です。
- ManageEngine OpManager:パッケージ型で、最短10分での設定が目安です。
- Mackerel:有料機能を2週間無料で試せるサービスがあります。
評価期間に自社の性能指標に合う閾値を試せる点は、SaaS型の利点です。
SaaS型でも、短い稼働開始と、実用に足るベースラインや調整が整う時期は別です。
テンプレートとGUIで調整できるため、OSS自社構築よりもチューニングを進めやすい面があります。
OSS(Zabbix、Prometheus+Grafana等)で自社構築する場合
ZabbixやPrometheus+Grafanaはライセンス費用が無料ですが、基盤の各要素は自社で構築します。
- 構築するもの:サーバーから、監視項目やダッシュボード、アラートまでを自社で用意します。
- 適合性:非常に高いカスタマイズ性があり、複雑な構成や独自指標にも合わせやすいです。
50台未満の小規模な環境でも、Zabbixの設定と通知を手作業で実装して、約1週間かかった事例があります。
トランザクション単位のトレーシングなど、APM相当まで作り込む場合は、専門知識のある技術者と、さらに長い準備期間が必要です。
OSSはSaaS型より稼働までが長くなる傾向があります。そのため、納期を優先するならSaaS型APMが候補になります。
時間をかけてでも自社仕様に合う基盤を作りたい場合は、OSS構築が向いています。
納期を短縮する具体的な方法
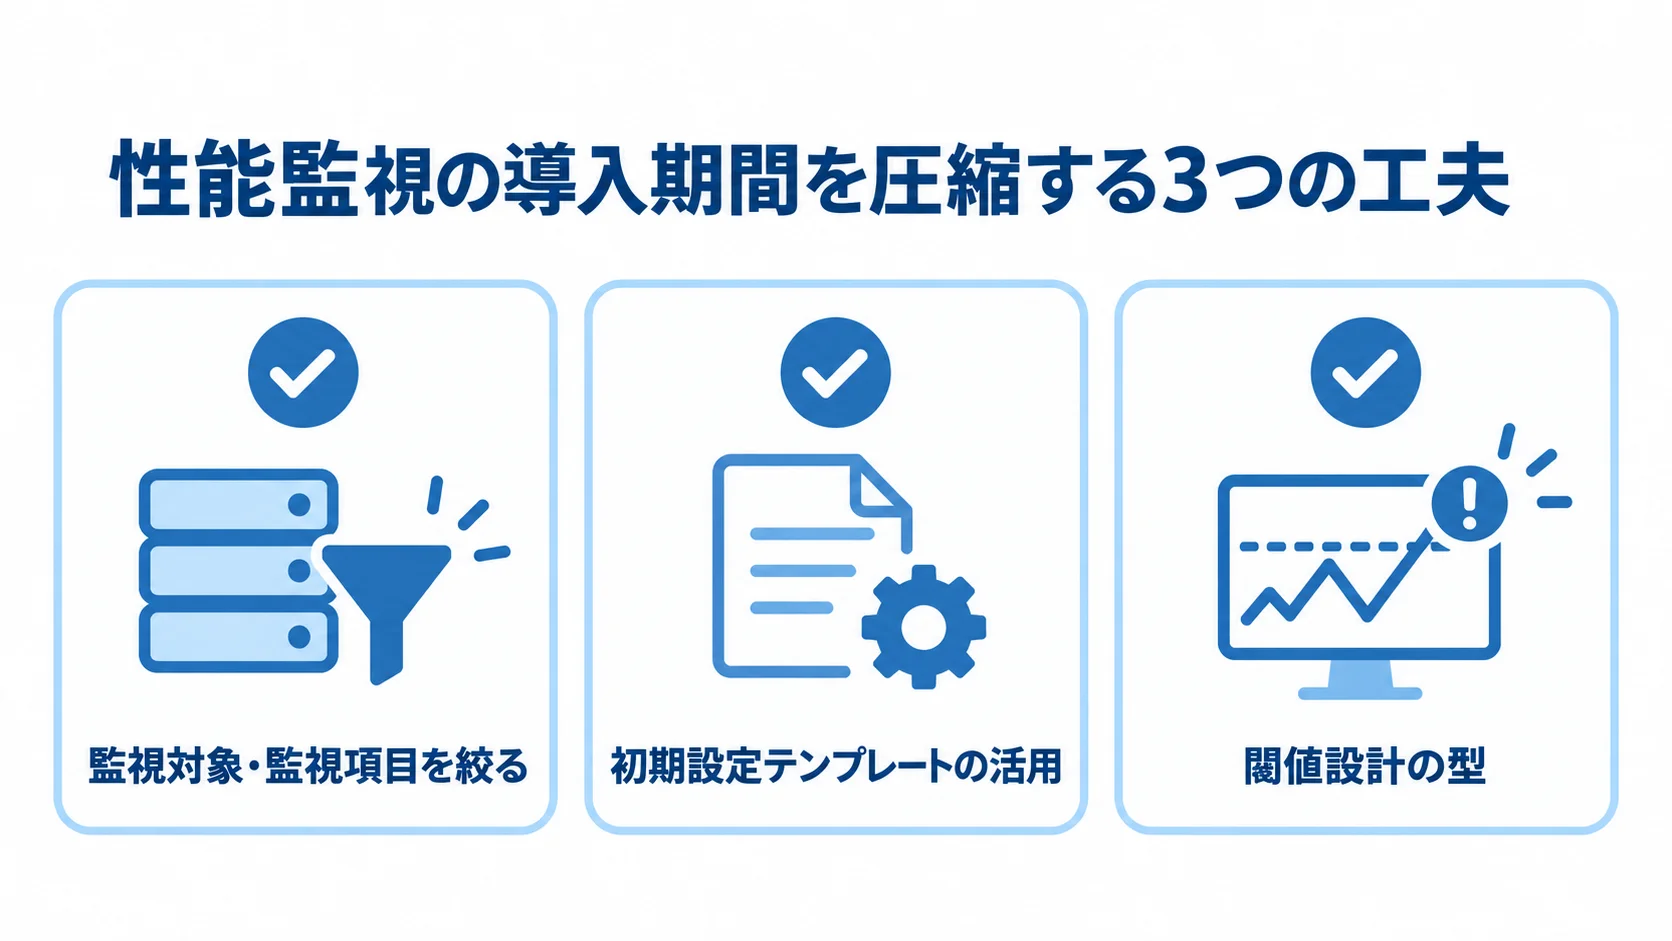
チューニングの質を落とさずに、性能監視の導入期間を縮める方法を紹介します。
監視対象・監視項目を絞ったスモールスタート
第一に、対象と項目を絞ります。全システムと全指標を網羅しようとすると工数が膨らみ、導入が長引きます。
- 優先対象:影響の大きい基幹システムや、応答遅延が体験に直結する主要APIを選びます。
- 拡張時期:稼働が安定した段階で、対象範囲を広げる時期です。
過剰な機能設定は運用を複雑にし、導入の障壁になります。そのため、シンプルに始めることが、期間短縮とチューニング精度の向上に有効です。
テンプレート活用と閾値の複数段階設定の型化
第二に、SaaS型APMの初期設定テンプレートを活用します。ダッシュボードや閾値のテンプレートを使えば、ゼロから設計するより大幅に早く済み、監視項目の設計期間を短縮できます。
第三に、閾値設計の型をあらかじめ用意します。
- 閾値の型:CPU負荷やディスク使用量に対する、複数段階の基準です。
- 契約形態:要件未確定の設計は準委任、テンプレート確定後の実装は請負にします。
具体的には、CPU負荷は4、8、12以上、ディスク使用量は80%、90%、95%超過の三段階で分ける例です。ただし、実測値に合わせて微調整する必要があります。
型を使えばゼロから考えずに済み、チューニング期間を短縮できます。また、工程に合わせた契約形態は、手戻りを抑えて計画的に進めるうえで有効です。
納期遅延の典型要因と対策
計画を綿密に立てても、性能監視の立ち上げには遅延リスクがあります。そのため、起きやすい要因を先に把握し、対策を計画段階から組み込むことが重要です。
閾値設計の甘さによる「アラート地獄」とチューニングの長期化
遅延の要因として多いのは、閾値を単一にしたことで過検知や誤検知が本番後に多発する「アラート地獄」です。
担当者はアラート対応と閾値の再設計に追われるため、調整工程が実質的に長引きます。
- 段階的な閾値:複数段階で設計し、実運用データを見ながら調整します。
- 期間の確保:継続調整を前提に、チューニング期間を計画に組み込む作業です。
閾値は、継続して調整していくものと位置づけます。チューニング期間を正式に確保しておけば、後工程の遅延を防げます。
ベースライン未取得のまま本番投入するリスク
第二の遅延要因は、ベースラインを十分に取らないまま、本番の閾値を見切り発車で決めてしまうことです。
データが足りないと、実負荷と離れた基準になり、運用後に閾値を全面的に見直す場合があります。
- 繁閑差:季節性やキャンペーンがある業務では、短期データで平常時の幅を捉えきれないことがあります。
- 観測期間:業務の繁閑を一巡できる期間を、予定に明記して確保します。
性能の最適化とキャパシティ計画は、継続的なPDCAです。そのため、初期の段階から関係者の間で合意しておきます。
まとめ
ITシステム性能監視の計画では、ツール導入と工程ごとの期間を踏まえ、導入方式の違いや短縮策、遅延要因も含めて考えます。ツールのセットアップは最短10分から約1週間まで幅があります。さらに、実運用には3段階の工程が必要です。
3段階として、要件定義と監視項目設計、ベースライン取得と閾値調整、継続的な分析とキャパシティ計画を順に進めます。閾値調整やベースライン取得は反復するものなので、計画もそれを前提にします。
スモールスタートやテンプレート、段階的な閾値設定は期間短縮に役立ちます。また、アラート地獄やベースライン不足への対策は、計画段階から組み込んでおきます。
相談の際は、現状のシステム構成と重視する性能指標を、複数の開発会社やツールベンダーに伝えて、見積もりを取ります。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。