
性能監視のフルスクラッチ・オーダーメイド開発は、監視対象の規模、必要なカスタマイズ、運用人材の有無を踏まえ、小規模な検証から段階的に進めると、自社に合う形を見極められます。
OSS自社構築とSaaS型APMは、費用と運用の負担が大きく異なります。各テーマの詳細は、関連記事もご覧ください。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
性能監視のフルスクラッチ・オーダーメイド開発の意味
性能監視は、CPU・メモリ・ディスクI/Oや、アプリ・APIの応答速度と処理件数を継続して測る取り組みです。
計測結果は、パフォーマンスチューニングやキャパシティプランニングに生かします。
死活監視や障害対応が中心の保守監視とは異なり、性能監視は性能と負荷を可視化して最適化します。
APM(Application Performance Monitoring)やオブザーバビリティ基盤が、この継続的な取り組みを支えます。
性能監視のフルスクラッチ・オーダーメイド開発は、DatadogやNew RelicなどのSaaS型APMをそのまま契約・利用しない方法です。
具体的には、ZabbixやPrometheus+GrafanaなどのOSSを基盤に、自社のシステム構成や業務ロジックに合わせて監視基盤を設計・構築します。既存の社内ツールとの連携要件も基盤に反映し、独自の性能監視基盤を作ります。
監視システムをプログラミング言語でゼロから作る狭義のフルスクラッチとは異なります。むしろ、OSSを土台に自社仕様を重ねる「オーダーメイド構築」と捉えるほうが、実務の実態に近い理解です。そこで次に、OSS自社構築とSaaS型APMの特徴を比べます。
OSS(Zabbix、Prometheus+Grafana)による自社構築
OSS自社構築では、ライセンス費用を抑えながら、環境に合わせて監視を設計できます。
- Zabbix:オンプレミスとクラウドの両方で使えます。
- Prometheus+Grafana:Kubernetes環境で特に人気のある組み合わせです。
- ライセンス:いずれもソフトウェア自体は無料です。カスタマイズ性は高い一方、構築・運用は複雑になります。
小規模な50台未満の環境でも、Zabbixの設定ファイルや監視項目、通知を手作業で整える必要があります。その作業に約1週間かかった導入事例もあります。
APM相当のトランザクション単位のトレーシングまで作る場合は、設計と実装にさらに長い期間が必要です。
特に、性能監視として使える可視化には、インフラ構築の専門的なノウハウを持つエンジニアが求められます。
SaaS型APMツールとのTCO比較
SaaS型APMとOSS独自基盤の費用の差は、料金の仕組みから、運用を担う人手の量まで複数の場面に表れます。
- 料金:DatadogやNew Relicなどは初期無料で、ホスト数・デバイス数・ログ量に応じた月額の従量課金です。
- 対応環境:サーバーの準備が不要で、AWS、Azure、GCPなどのマルチクラウドやオンプレミスに対応できます。
- 機能と操作:インフラ監視からログ管理まで、APMや分散トレーシングを含めて統合し、GUIで直感的に操作できます。
- 運用負荷:インフラの専門知識が限られるチームでも、負荷を抑えやすい特徴があります。
- 人員とTCO:構築と運用に割ける人手の量で、費用の差が出やすくなります。
情シスの人員が限られる企業では、OSSの構築・運用に人手を割くより、SaaSで時間と安心を得るほうがTCO(総保有コスト)を抑えられる傾向があります。そのうえで、OSS独自基盤を作るかは、SaaSとのTCOの差と、カスタマイズの必要度を比べて判断します。
フルスクラッチ構築のメリット・デメリット
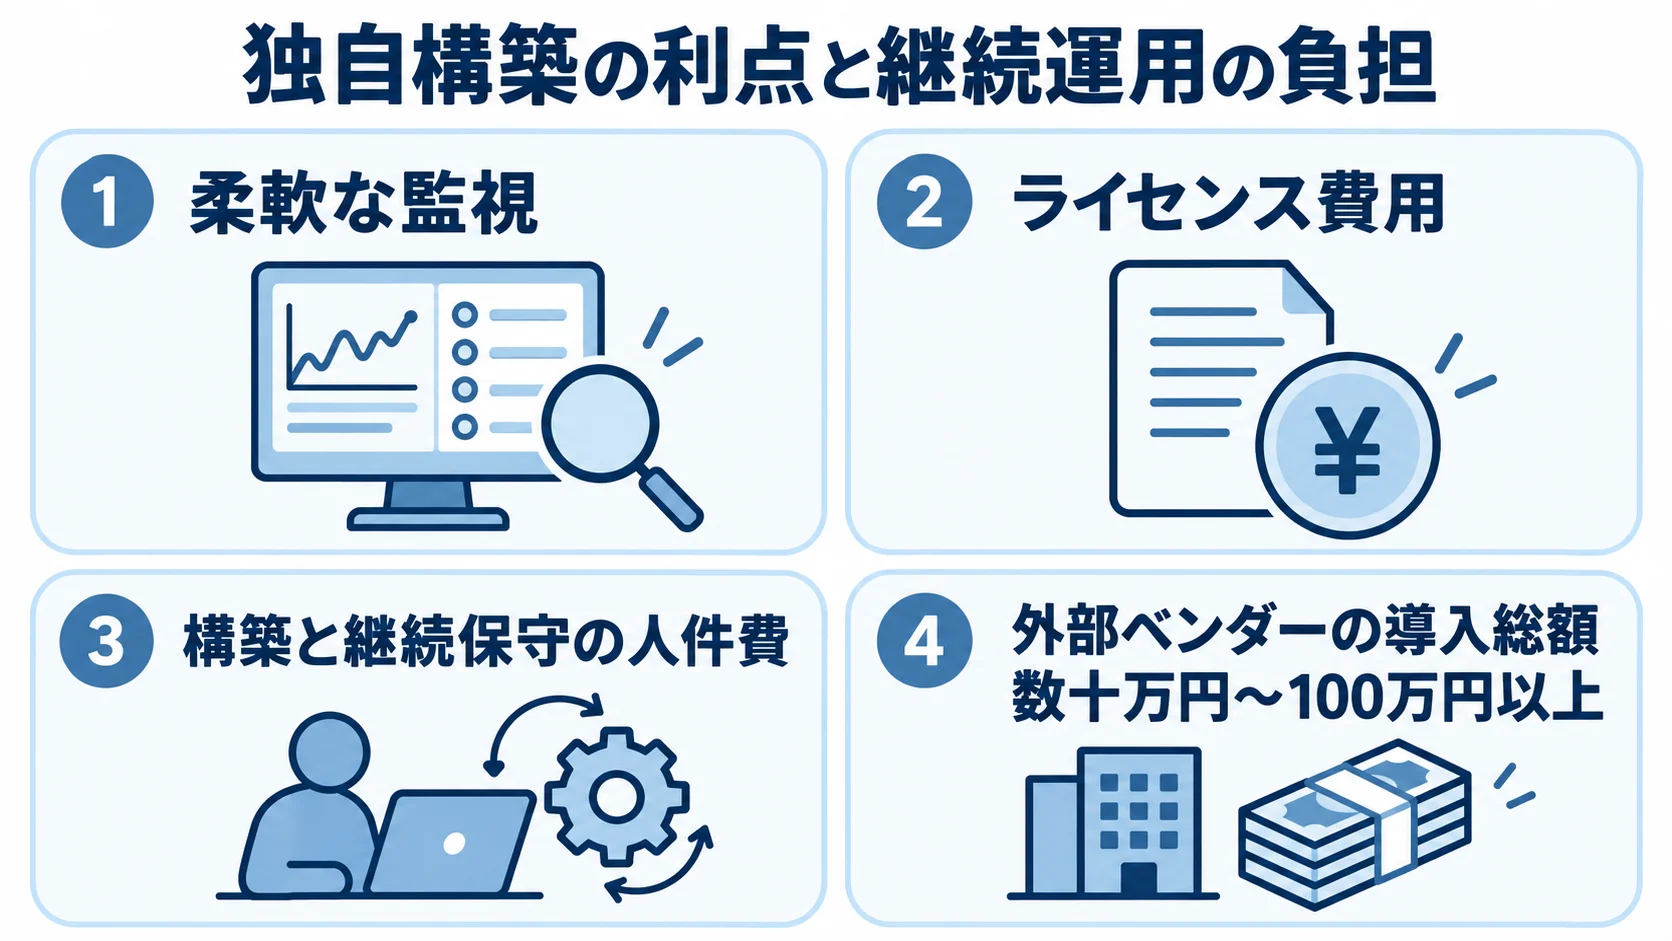
OSSで独自基盤を構築する選択には、明確なメリットとデメリットがあります。両方を理解したうえで、導入を判断します。
メリット:高いカスタマイズ性とキャパシティプランニングの自動化
独自構築の利点は、特殊なインフラ環境や複雑な業務ロジックに合う監視ルールを設計できることです。
- 柔軟な監視:既製ツールのテンプレートで扱えない自社要件も組み込めます。
- 費用面:監視対象が大規模な企業では、長期的にライセンス費用を抑えられる場合があります。
- 計画の自動化:独自の需要予測や業務カレンダーと連動したキャパシティプランニングも目指せます。
性能データのトレンド分析で時間による変化を捉えると、将来の問題を予測できます。リソース使用状況を継続的に監視し、必要に応じて調整すれば、システム効率の最大化につながります。さらに、分析結果は将来のインフラ投資計画にも活用できます。
AIOps(機械学習を活用した運用自動化)では、AIがログやメトリクスの傾向を学習します。異常検知の精度向上、不要なアラートの自動抑制、根本原因の推定を通じて、運用の属人化を防げます。
デメリット:初期構築・運用の高い人的コスト
最大の負担は、要件定義、テンプレート作成、監視ルール設計に時間と人手がかかることです。
- 導入時:機能を最初から盛り込みすぎると運用手順が複雑になり、導入の障壁になる恐れがあります。
- 運用時:ネットワーク、OS、クラウドの専門知識が、運用を続けるかぎり必要です。
- 外部支援:大規模または高可用性が必要な場合は、SIerなどの構築支援が必要になることがあります。
専門知識のないチームでは、設定変更のたびにエスカレーションが発生し、人件費が増える失敗例もあります。外部ベンダーを利用する場合は、導入総額が数十万円〜100万円以上になるケースもあります。
ライセンスが無料でも、構築と継続保守の人件費がSaaS型APMの月額課金総額を上回る可能性があります。そのため、費用はライセンス料だけでなく人件費も含めて比べる必要があります。この費用比較は、意思決定の際に見落としてはならない点です。
自社独自の性能監視・オブザーバビリティ基盤構築事例
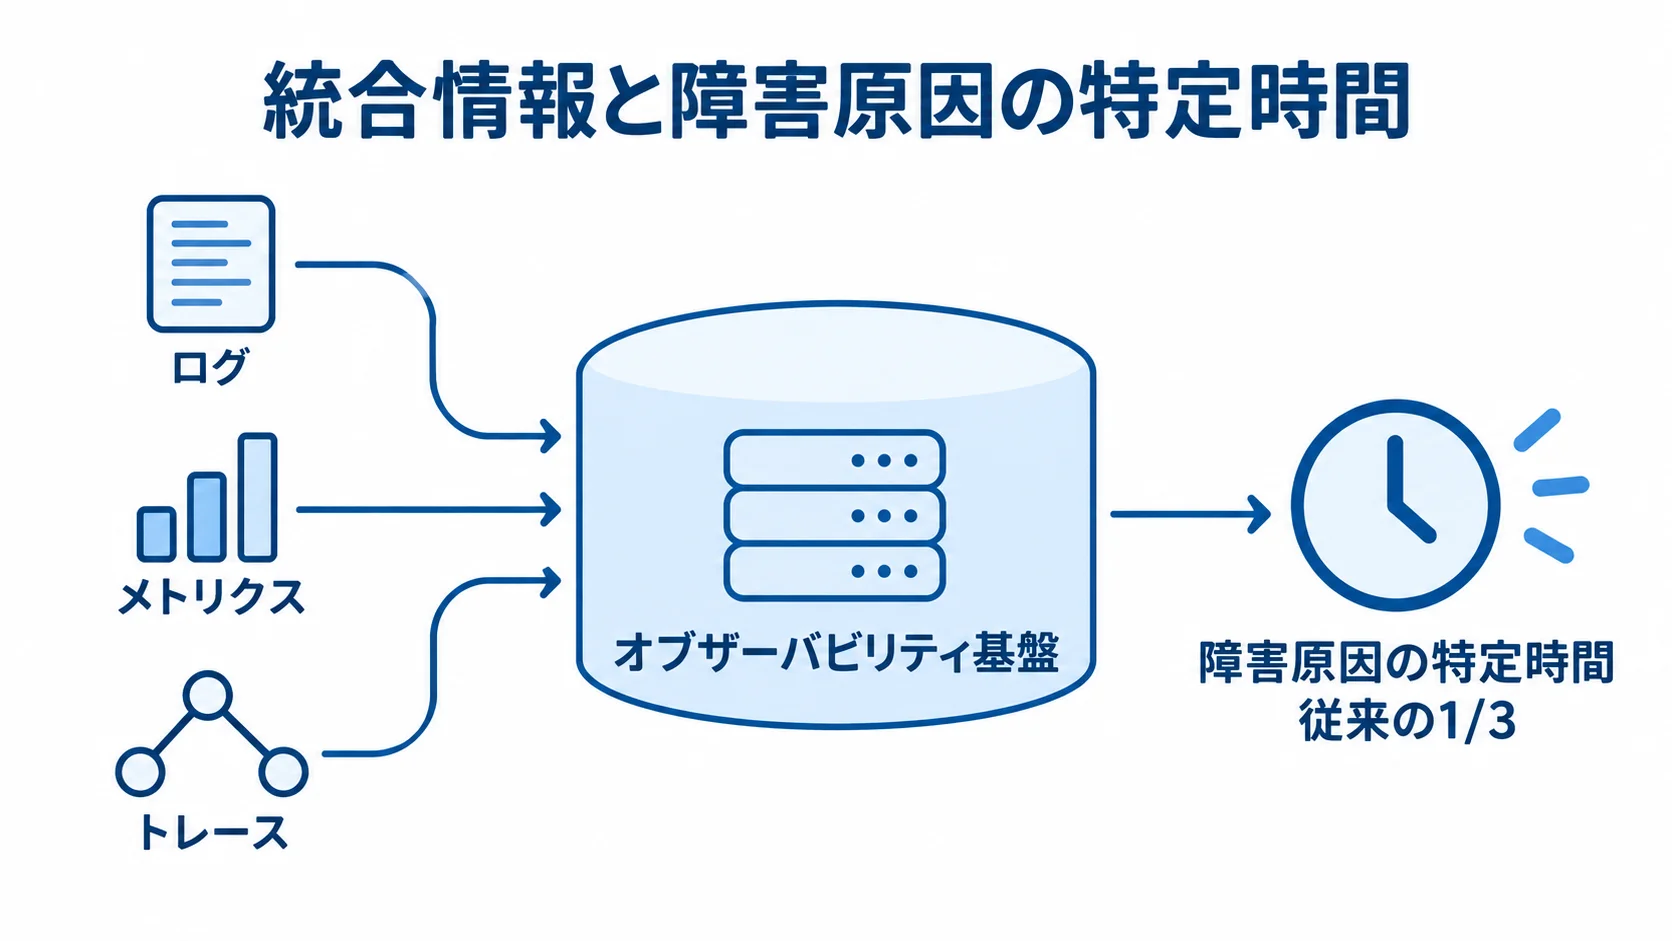
自社独自の性能監視基盤の構築事例から、独自開発が生み出す価値や応用できる考え方を読み取れます。
Datadog統合によるオブザーバビリティ基盤の事例
オブザーバビリティ(可観測性)は、異常箇所の検知に加え、障害の原因を深く理解する考え方です。
- 統合する情報:ログ、メトリクス、トレースを組み合わせて可視化します。
- 事例の成果:中規模SaaS企業では、障害原因の特定時間が従来の1/3に短縮しました。
この企業はDatadogを使い、各情報を統合して、全体像をGUIで直感的に把握できる基盤を構築しました。
この事例はSaaS型ツールの統合活用ですが、同様の可視化は独自基盤にも取り入れられます。さらに、既存の社内ツールと連携させ、性能監視基盤として組み上げることもできます。
AIOpsによる予兆検知自動化の事例
性能監視の先の取り組みとして、機械学習(AI)を活用するAIOpsが近年のトレンドとして挙げられます。
従来型の監視は、閾値を人手で決めて異常を見つけます。AIOpsは、ログやメトリクスの傾向を機械学習で読み取り、平常時のパターンからいつもと違う動きを捉えます。
- 従来型監視:単一または複数段階の閾値を、あらかじめ人手で設計する方式。
- AIOps:平常時のパターンを学習し、「いつもと違う」動きを検知する仕組み。
- 自動化:異常検知の精度を高め、アラート抑制と根本原因(アノマリー)の推定を担い、属人化を防ぐ。
季節性やキャンペーンによる負荷変動が大きいシステムほど、学習ベースの予兆検知が効果を発揮しやすいとされています。
既製APMの一部にもAIOps相当の機能があります。ただし、業務パターンに特化したモデルが必要な場合は、独自実装も選択肢になります。
フルスクラッチが向くケース・向かないケース
独自の性能監視基盤は、すべての企業に合うわけではありません。自社の規模や連携要件、人員体制に照らして、向き不向きを見極める必要があります。
フルスクラッチが向くケース
フルスクラッチが向くかどうかは、規模、連携、人材の3つの面から見ると整理しやすくなります。
- 大規模環境:監視対象が多く、SaaS型の課金が長期的に膨らみやすい。
- 複雑な連携:既製APMの機能では足りず、社内ツールと連携した自動化が必要。
- 専門人材:ネットワーク、OS、クラウド基盤に詳しいエンジニアが在籍する。
たとえば、連携先にはチケットシステム、チャットツール、独自の業務システムなどがあります。
初期構築と継続保守に十分な工数を割ける企業なら、長期的にライセンス費用を抑え、自社仕様に合う基盤を持てます。
フルスクラッチが向かないケース
「ひとり情シス」体制の企業や、専任のインフラエンジニアがいない企業では、独自構築が現実的でない場合があります。
- 人員が限られる:設定変更のたびにエスカレーションが起き、運用費が増えた失敗例もあります。
- 小〜中規模:既製APMで性能指標を可視化し、チューニングまで十分に行えます。
OSS基盤は、構築時から運用後まで専門知識が必要になり、専門外のチームには継続的な負担になります。そのため、既製ツールで足りる場合は、初期構築に多くの工数をかけるより、SaaSをGUIで運用するほうが有利なケースがほとんどです。
判断のポイント
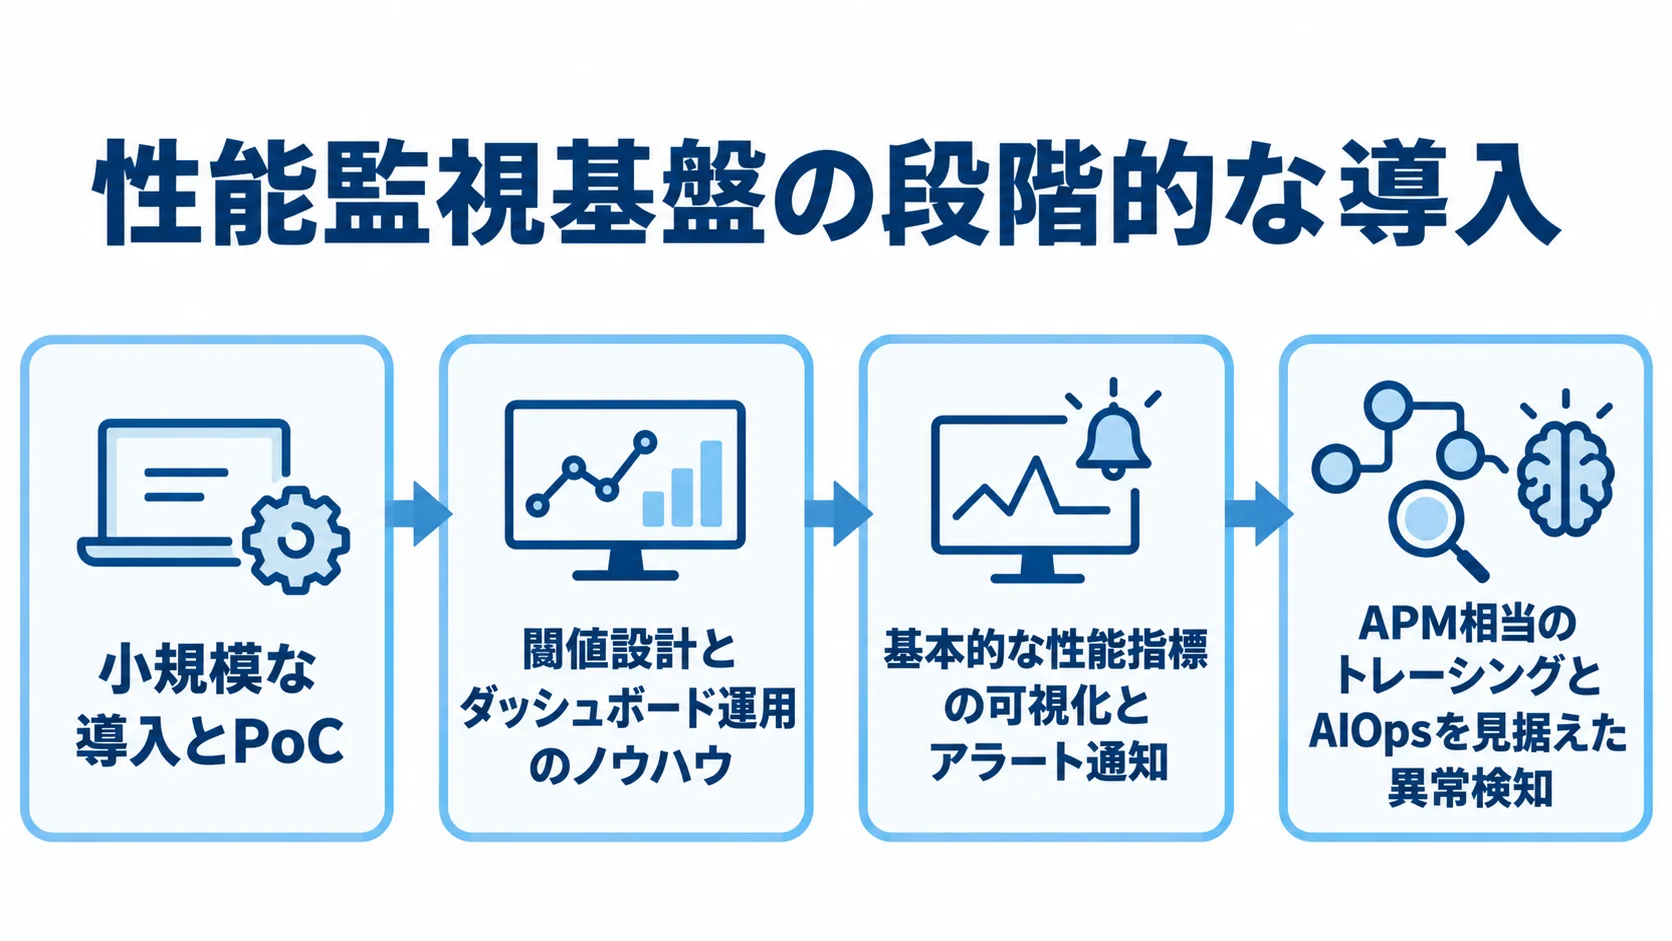
判断は、技術への関心よりも、自社の体制と将来の拡張計画を踏まえて、段階的に進めます。
自社のスキルセットの確認
まず、専門エンジニアの在籍状況と、性能監視を継続して担える人員体制を確認します。
- 専門知識:ネットワーク、OS、クラウドインフラに詳しい人材がいるか。
- 継続運用:閾値の設計やトレンド分析を続けられるか。
- 引き継ぎ:運用開始後、自社で保守を担える体制があるか。
OSS自社構築には、初期構築と運用の両方で専門知識が必要です。初期構築をSIerに頼んでも、自社で保守を引き継げなければ、属人化やブラックボックス化を招きます。
専門人材が不足する場合は、SaaS型APMを選ぶか、初期構築をSIerに委託して保守契約を続ける方法を検討できます。
段階的なロードマップ設計
独自構築を決めた場合でも、最初から全システムを対象にせず、小規模な導入で知見を得ます。過剰な機能は運用を複雑にし、導入の障壁になります。フルスクラッチであっても、この点は変わりません。
範囲は、小さく始めて段階を追って広げると現実的です。
- SaaS型ツールまたはOSSを小規模に導入し、PoCを行う。
- 閾値設計とダッシュボード運用のノウハウの蓄積。
- 基本的な性能指標の可視化とアラート通知から、自社構築を始める。
- 運用が安定した後、APM相当のトレーシングやAIOpsを見据えた異常検知へ範囲を広げる。
このように段階的に独自機能を追加すれば、初期投資のリスクを抑えながら基盤を育てられます。
まとめ
ここまで、独自構築の意味とOSSとSaaSの比較を見てきました。さらに、利点と課題、事例、向き不向きと判断点も確認しました。
ZabbixやPrometheus+Grafanaによる自社構築では、ライセンス費を抑えながら、自社仕様の監視や計画の自動化を実現できます。一方で、要件定義から運用まで専門知識と人件費が必要になります。自社の人材と要件に合う方法を選ぶことが求められます。
中規模SaaS企業では、Datadogで、APMを含むログ、メトリクス、トレースを統合した結果、障害原因の特定時間が従来の1/3になりました。
AIOpsによる予兆検知も可能で、統合可視化や学習ベースの異常検知は価値を生みます。ただし、自社で実現するには体制が必要です。
まずスキルセットを確認し、小規模なPoCから段階的にロードマップを描く方法が現実的です。具体的には、複数の開発会社へシステム構成とカスタマイズ要件を示し、SaaS型ツールとの比較見積もりを依頼します。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。