
性能監視のPoCは、対象の選定、負荷検証、閾値調整を本番前に行い、過検知や見逃しを抑える設計へ近づける工程です。
PoCと試作・モックアップは、どちらも対象を絞って確かめる点が共通しています。全体像は、ITシステム性能監視の完全ガイドもご覧ください。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム性能監視におけるPoCの位置づけ
性能監視のPoCでは、本格導入の前に、小規模な範囲の実システムへ監視・分析の機能を組み込みます。そのうえで、レスポンスタイムやスループットの計測、ボトルネックの検知、閾値設計が機能するかを検証します。
ツールが動くかの確認に加えて、実際の負荷変動やアクセスパターンの中で、性能低下の予兆を検知できるかも確かめます。検知したデータが改善の行動につながる粒度で得られるかを体験しておくことも大切です。
多くのSaaS型ツールは無料トライアルを提供しています。そのため、初期投資をかけずにPoCを試せる環境が整っています。
無料トライアル・評価期間の活用
性能監視ツールの多くは、本番導入の前に無料で試せるトライアル環境を用意しています。
トライアルの期間や使える機能の範囲は製品ごとに異なるため、自社の環境に合うかを評価する前に、まず期間と提供形態を確かめておきます。
- Mackerel:有料機能を2週間、無料で試せます。
- Datadog・New Relic:トライアル中は、機能の制限なく使えることが多いです。
- ManageEngine OpManager:サポート付きの無料評価版があります。
DatadogやNew RelicなどのAPMは、本番運用に耐えられるかをプロトタイプで評価するのに向いています。また、Mackerelは簡単なコマンド入力だけで、すぐに検証を始められます。さらに、OpManagerはインストールから最短10分で監視のプロトタイプを組めます。
トライアルであれば初期費用をかけずに、自社に合う性能指標や閾値の当たりをつけられます。その結果、本格導入時の要件定義の精度向上にもつながります。
負荷テストによる性能検証PoC
負荷テストを組み合わせると、性能低下やボトルネックを検知できるかを確かめられます。検証の方法には、自社で行う方法と外部に任せる方法があります。
- 自社で検証:平常時の監視に、意図的な負荷を加える形です。
- 外部MSP:負荷テストやDB最適化を依頼できます。
MSP(監視・保守・運用代行)には、Webやデータベースへのリクエスト処理能力を測るサービスがあります。負荷テストを5万円から実施できる事例もあります。
MySQLなどのデータベース最適化まで請け負うサービスもあります。APMや負荷試験の専門知識が自社にない場合は、外部サービスによるPoCも選択肢になります。
負荷で応答時間が悪化したときに、APMや分散トレーシングで原因をすぐに把握できるかが重要です。この確認は、本格導入の判断材料になります。
プロトタイピングの進め方
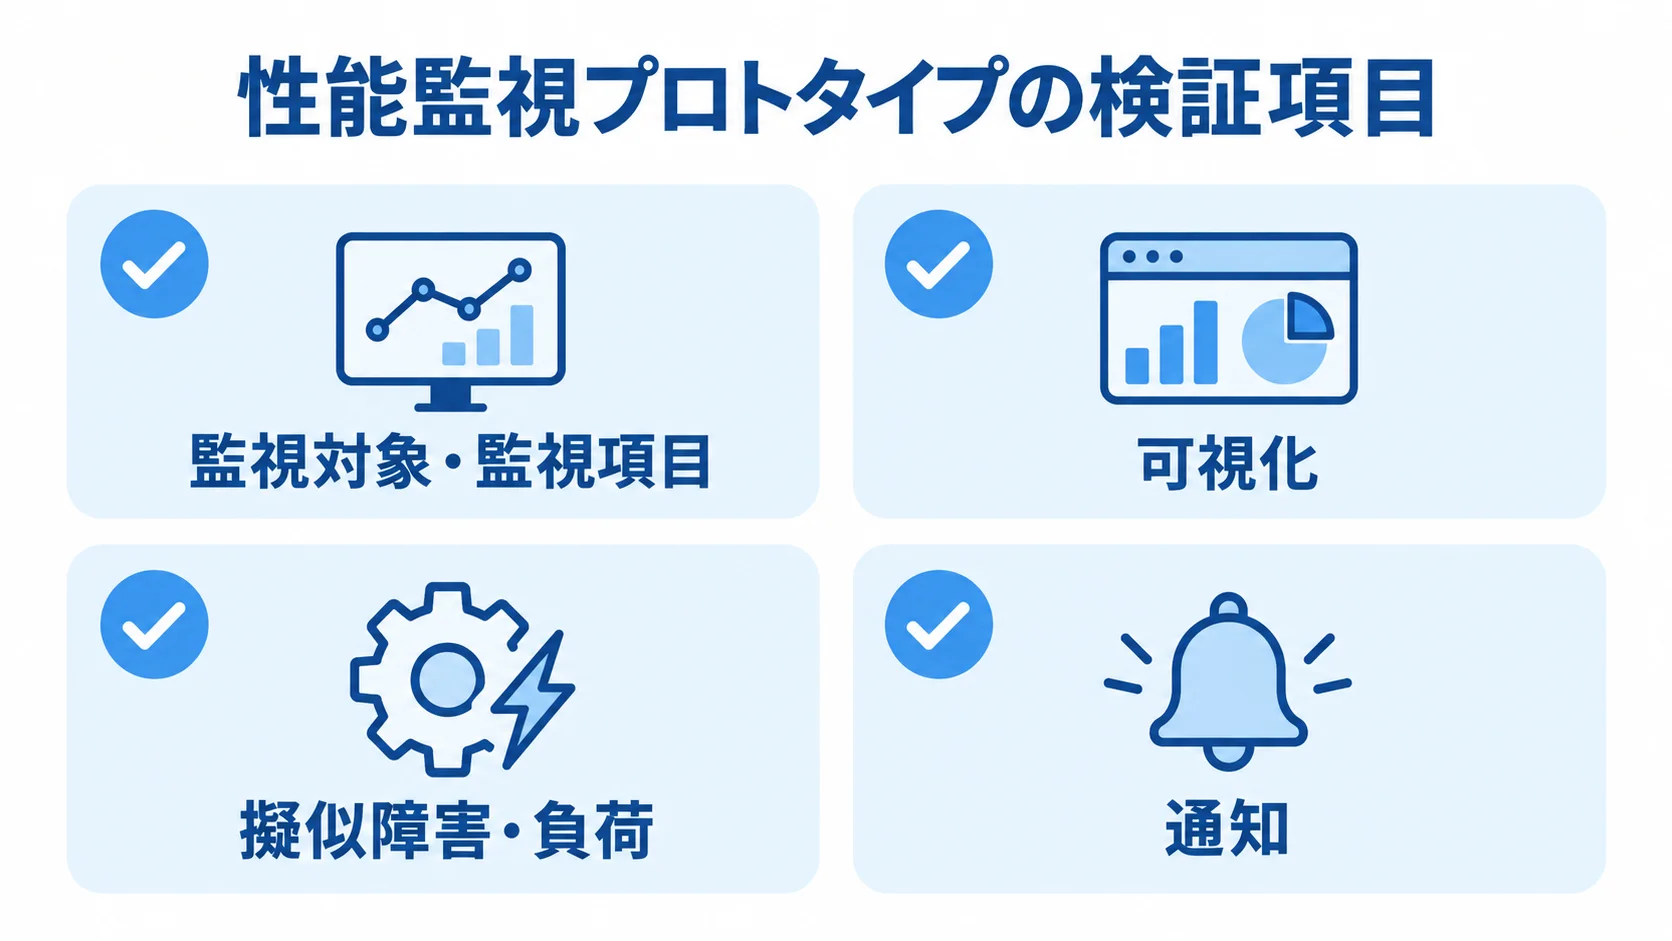
性能監視の試作は、最初から全システムや全指標を対象にせず、範囲を絞って段階的に進めます。まずダッシュボードやアラートの動きを確かめ、そのあとで検証範囲を広げます。
監視対象・監視項目の絞り込み
限られた範囲で検証を始めるには、監視対象と指標、利用プランを業務への影響に合わせて決めておく必要があります。
- 対象:基幹システムや主要APIの数台・数エンドポイント。
- 指標:CPU使用率やレスポンスタイムなど、業務に直結する値。
- プラン:無料で始め、必要に応じて有料の小規模な契約へ移る。
また、無料プランのなかには、数台までのサーバーやWebサイトの監視に加えて、1アプリケーション分のAPMを使えるものもあります。
機能を詰め込みすぎると運用が複雑になり、検証も停滞しがちです。そのため、試作はシンプルな構成から始めて、徐々に拡張することが大切です。
ダッシュボード・APM可視化のプロトタイピング
監視対象を決めたら、実機や検証用VMで、指標の可視化と通知を試します。
- 可視化:各指標がグラフ化され、詳細分析へ進めるかどうか。
- 擬似障害・負荷:ケーブル切断や負荷テストによる検知の試行。
- 通知:メールやチャットへ、即時に届くかどうか。
DatadogやAPMツールのエージェントを入れると、CPUとメモリの使用量をグラフ化できます。ディスク使用量と応答時間もあわせて見られるようにし、ダッシュボードの見やすさや、ドリルダウン(詳細分析への掘り下げ)のしやすさも評価します。
擬似障害の確認では、LANケーブルを抜くか、負荷テストで擬似的に高負荷をかけます。そのうえで、SlackやTeamsなど、設定したメールやチャットツールに通知が届くかを確かめます。
運用担当者が日常的に使いやすいかも、あわせて検証します。通知テストを通じて、本番導入後のエスカレーションフローが機能するかを見極めます。
閾値チューニングのプロトタイピング事例
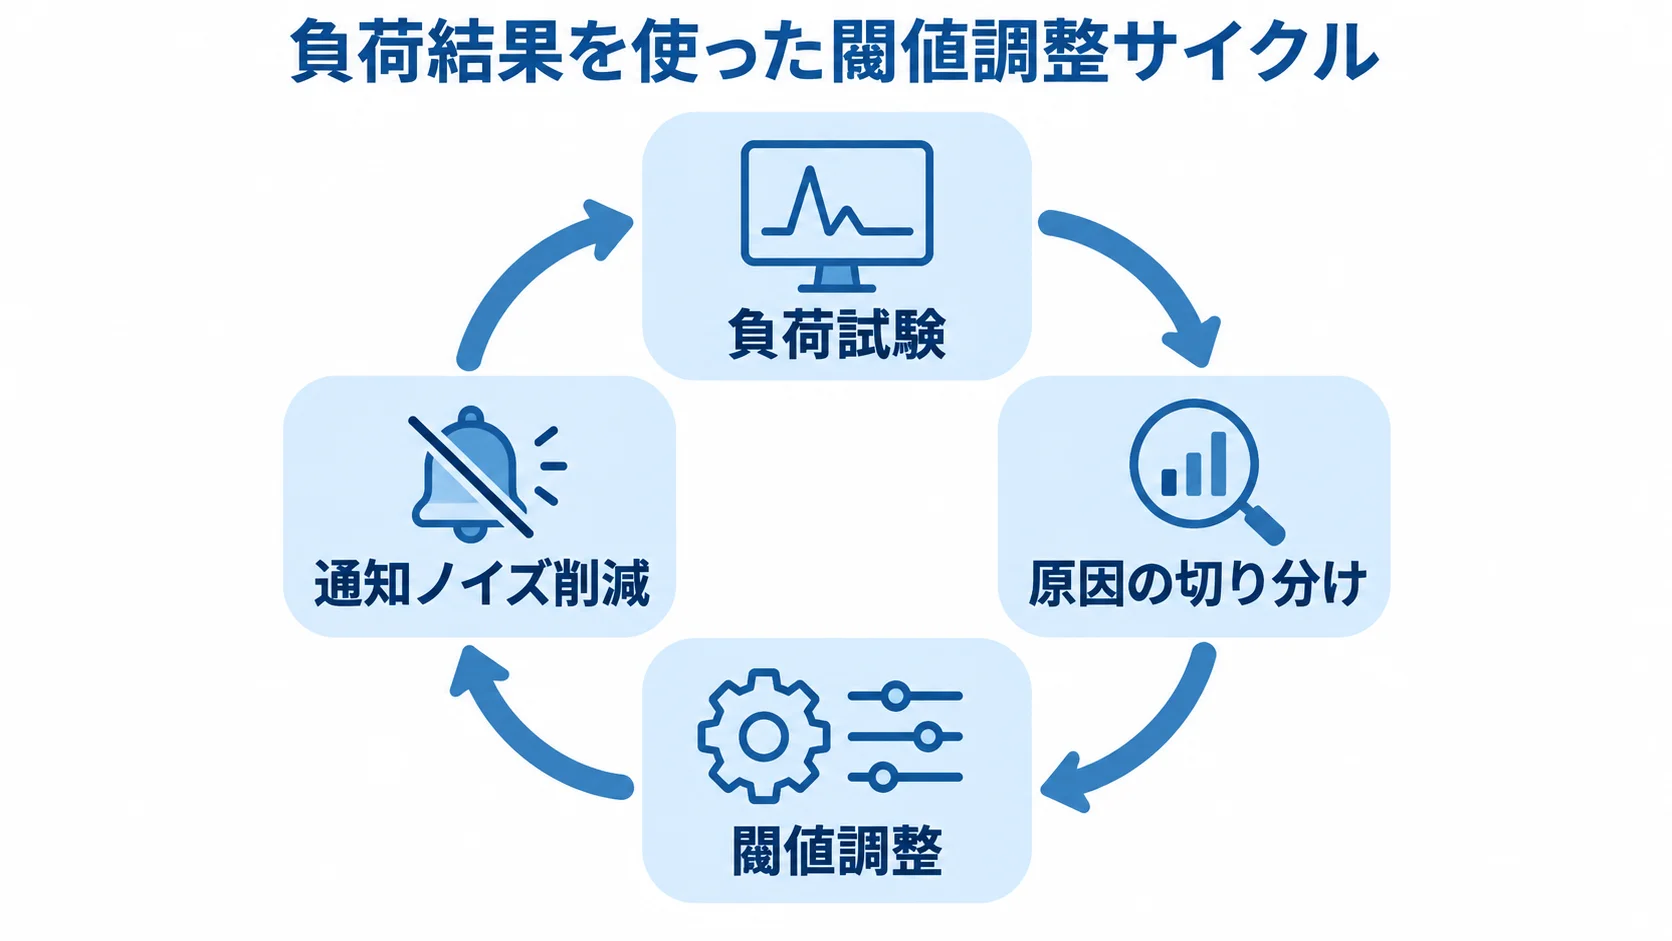
閾値を設計するときは、過検知や誤検知によるアラート疲れを避ける必要があります。リソースやトラフィックの予兆を捉えるために、PoCで複数段階の閾値を試行錯誤します。この調整が、本格導入後のアラート品質を左右します。
複数段階の閾値設計事例
レンタルサーバー事業者の段階的な閾値は、実運用の例として参考になります。各リソースに警告・軽度・重度の基準を設けた事例です。
- Load Average:1CPUあたりの値による3段階の基準。
- ディスク・Inode:使用率による3段階の基準。
- メールキュー:件数による3段階の基準。
Load Averageは、4以上で警告(軽度の遅延の可能性)、8以上で軽度障害(重度の遅延の可能性)、12以上で重度障害(通信断の可能性)とする事例があります。また、ディスク・Inodeは80%超で警告(リソース追加の検討)、90%超で軽度障害(容量超過の危険性)、95%超で重度障害(システム影響あり)の例があります。
メールキューは500件超で警告、1,000件超で軽度障害、2,000件超で重度障害とし、スパムの踏み台などによる異常配信を検知する例があります。これらの数値は初期ベースラインとして参考にし、自社システムの実測データに合わせて微調整します。
ボトルネック特定のテスト運用
負荷試験で応答悪化の原因を判別できれば、閾値調整にもつなげられます。そこで、検証する点をあらかじめ定めておきます。
- 負荷の影響:アクセス増加によるものかどうか。
- 原因の切り分け:DB負荷やネットワーク遅延も含めて調べる。
- 調整の反復:負荷結果をもとに、アラートノイズを減らす。
閾値設計と並行して、特定APIの応答時間が急に悪化したときに、APMや分散トレーシングで原因をすぐ切り分けられるかを検証します。
Datadogで、APM・ログ・メトリクス・トレースを統合した中規模SaaS企業の事例があります。報告では、障害原因の特定時間が従来の1/3に短縮したとされています。
原因特定の速さを実際に体験しておけば、導入後の効率化について、数値感をもって意思決定者に説明できます。まずは最小限の閾値と通知から始めます。そのうえで、負荷結果を見ながら通知ノイズを減らす工程を繰り返します。
PoC評価基準と本格導入の判断ポイント
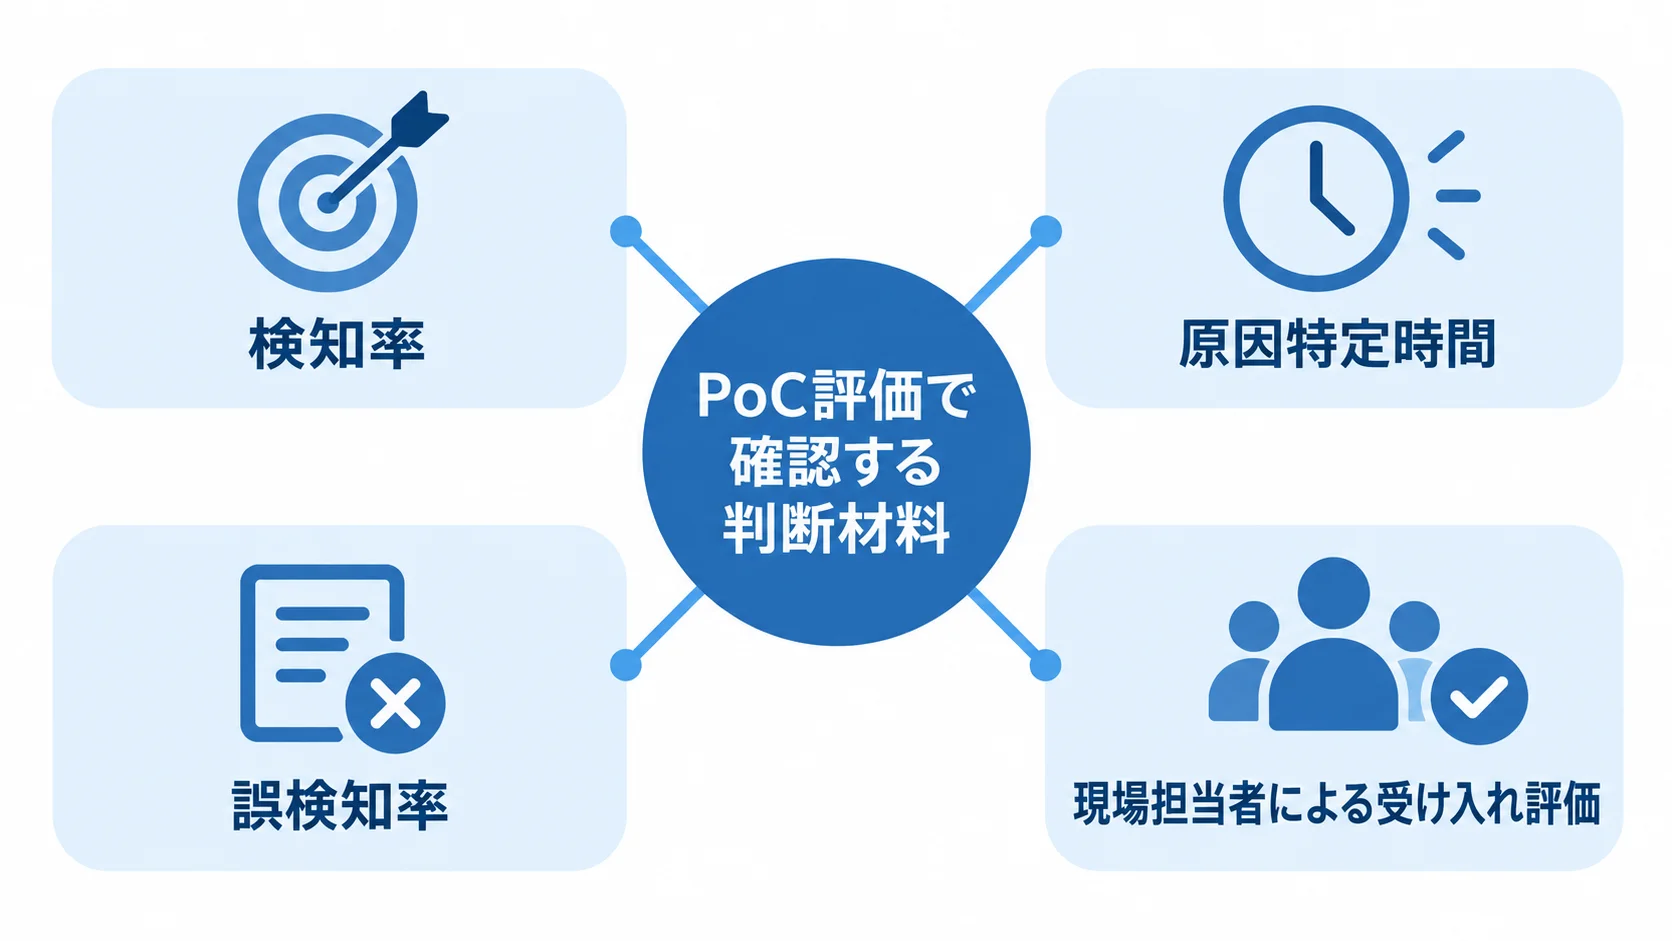
PoCを導入の判断につなげるため、事前に決めた基準で結果を振り返ります。判断は、定量評価と現場担当者による定性評価の両面から行います。
定量的な評価基準(検知率・原因特定時間・誤検知率)
本格導入後の検知品質と運用負荷を判断するため、PoCでは定量的な指標を記録します。
- 検知率:負荷テストや擬似障害を正しく検知した割合。
- 原因特定時間:検知後、原因の箇所を突き止めるまでの時間。
- 誤検知率:平常時の変動で不要な通知が出た割合。
中規模SaaS企業の統合導入事例では、原因特定時間が従来の1/3に短縮したと報告されています。この数値は、自社PoCとの比較に使えます。
誤検知率は、業務時間中の不要な通知を記録し、閾値調整の前後で削減量が分かるようにします。その記録は、本格導入時の投資判断を説明する材料になります。
現場担当者による受け入れ評価
数値の基準を満たしても、現場で使いにくければ、導入後に形骸化するおそれがあります。そこで、担当者が確かめるべき運用面の観点を、項目ごとに挙げます。
- 画面:ダッシュボードを見やすく使えるか。
- 通知:文面からボトルネック箇所を直感的に理解できるか。
- 連携:SlackやTeamsなどへの通知がスムーズか。
提案書やカタログでは分からない運用上の相性は、PoC中に現場担当者自身が触れて評価します。技術面と合わせて、受け入れやすさも確かめます。さらに、実際に使う人の評価も行うことで、導入後にツールが動いていても誰も見ない状態を防ぎます。
PoCでよくある失敗パターン
進め方を誤ると、PoCが導入判断の材料にならず、時間だけが過ぎてしまいます。起こりやすい失敗と、その対処法を確認します。
閾値未調整による「アラート地獄」
CPUの一時的な変動と継続的な異常を区別できるよう、通知条件を試しておきます。
- 継続時間を設定:一定時間続いたときだけ通知する。
- PoC中に試す:本格導入の判断前に調整効果を確かめる。
たとえば、CPU使用率80%で通知する単純な設定は、一時的なスパイクにも過剰に反応することがあります。その結果、担当者が疲弊し、性能可視化の有効性を冷静に評価できなくなります。
一瞬のスパイクは無視し、具体的には5分間継続したときだけ通知する設定を試します。調整せずに導入を決めると、実運用で同じ状態が再現し、PoCの意味が薄れます。
検証範囲が広すぎることによる評価の長期化
全システム・全指標を対象にすると、評価期間内に検証まで進めないことがあります。そこで、範囲を絞り、期間内に確かめる項目をあらかじめ定めておきます。
- 対象:業務影響度の高い数台・数エンドポイント。
- 確認項目:可視化、擬似障害・負荷の検知、調整効果。
要件定義や設定作業に時間を取られると、機能するかを確かめる前に評価期間が終わってしまいます。また、過剰な機能設定は運用を複雑にし、導入の障壁になると指摘されています。
Mackerelの無料トライアルは2週間で、他のSaaS型ツールもおおむね数週間程度です。そのため、この期間内に、ダッシュボードの動作、擬似障害・負荷の検知、閾値調整によるノイズ削減を評価することになります。
対象を絞ると、限られた期間でも判断材料を得られます。その結果、本格導入の意思決定にも役立ちます。
まとめ
ITシステム性能監視のPoCでは、対象を絞って可視化や通知を試し、そのあとで閾値を調整します。
Mackerel、Datadog、New Relicなど、多くのツールが無料トライアルを提供しています。ManageEngine OpManagerにも、サポート付きの無料評価版があります。
PoC・プロトタイプ・モックアップ開発の位置づけと進め方を示したうえで、閾値の検証事例を取り上げました。さらに、評価基準とよくある失敗も扱いました。
導入前には、ダッシュボードの可視化に加え、擬似障害や擬似負荷による通知テストも確かめておきます。そのうえで、Load Average、ディスク使用量、メールキューの段階的な数値を参考に、自社の実測値に合わせて閾値を調整します。
デフォルト設定や広すぎる検証範囲は、アラート過多や評価長期化につながる場合があります。そのため、業務影響度の高い対象に絞り、限られた期間で可視化、検知、チューニングの効果を評価することが、本格導入の判断材料になります。
▼全体ガイドの記事
・ITシステム性能監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。