
ITシステム原因調査は、初動、暫定復旧、根本原因の特定、恒久対応の順に進みます。工程ごとに時間の幅が大きく異なるため、流れを押さえると期間と納期を見積もりやすくなります。
原因調査は、異常を検知して一次対応する保守監視とは異なり、障害の検知後に行う分析です。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
ITシステム原因調査プロジェクトの開発期間の全体像
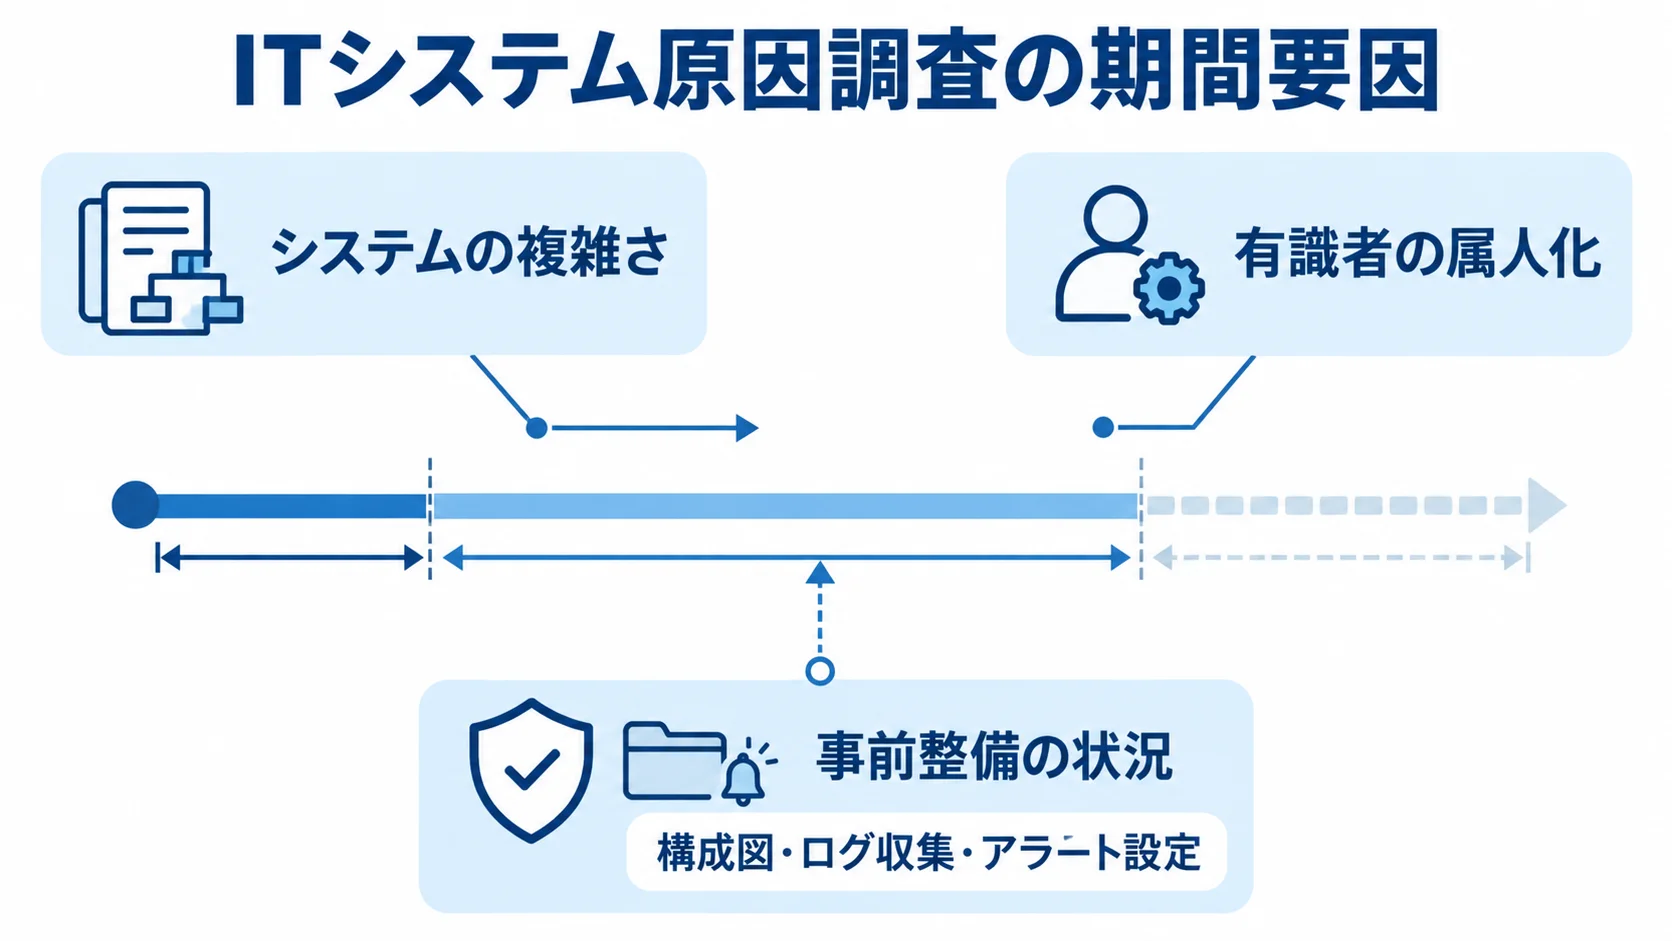
原因調査の期間は障害の重大度に応じて大きく変わり、システムの複雑さにも左右されます。
SLA(サービスレベル合意)の目標値は、期間を考える目安になります。
- Critical(極大):全社業務が停止する障害では、検知から15分以内の初回応答が目標です。
- High(大):特定部門や業務が停止する障害では、検知から30分以内の初回応答が目標です。
- 暫定復旧:MTTRの目安は、Criticalが1時間以内、Highが4時間以内です。
- 根本原因分析:解決後72時間以内、または2〜3営業日以内の実施が理想です。
初回応答では、関係者へのエスカレーションも行います。
ポストモーテムは、担当者の記憶が鮮明なうちに実施します。
調査全体は、分単位で進む初動、時間から1営業日単位の暫定復旧、数日単位の原因特定に分かれます。さらに、恒久対応には数日から数ヶ月かかることもあります。各工程で時間軸が大きく異なる点は、通常の開発と違うところです。
重大度別の期間目安
重大度に応じて、初動から根本原因の特定までに求められる時間は変わります。
- Critical:全社の基幹業務が停止する場合、初動から原因特定・再発防止策まで72時間以内(3日以内)が理想です。
- High以下:影響が一部機能やユーザーにとどまる場合、初動には猶予がありますが、分析は2〜3営業日以内が望ましいです。
時間が経つほど担当者の記憶が薄れ、ログだけでは追えない判断の文脈も失われます。
たとえば、GMOメディアのSREチームは、SREと開発チームの合同検証に計2時間を要したとZennで公表しています。内訳は説明・分析が1時間、対策・学びの整理が1時間でした。また、「2時間では長すぎた」との意見もありました。
この意見も踏まえ、障害の重大度や複雑さに応じて所要時間を柔軟に調整します。
調査期間を左右する3つの要因
同じ重大度の障害でも、調査期間には差が出ます。そのため、長期化に関わる要因を平時から確認しておくことが大切です。
- システムの複雑さ:長年の運用や改修で構造が複雑化すると切り分けが遅れ、原因特定やMTTRが長引きます。
- 有識者の属人化:構造や依存関係を知る人が限られ、夜間・休日の不在や退職・異動で初動調査が滞ります。
- 事前整備の状況:構成図やログ収集、アラート設定の状態で仮説検証の時間が変わります。
構成図には、論理・物理ネットワーク図、設定情報、データセンター情報などがあります。
調査時間は、発生後の対応では制御しにくく、平時の構成の把握とログ収集が期間を左右します。
工程別スケジュールと期間配分
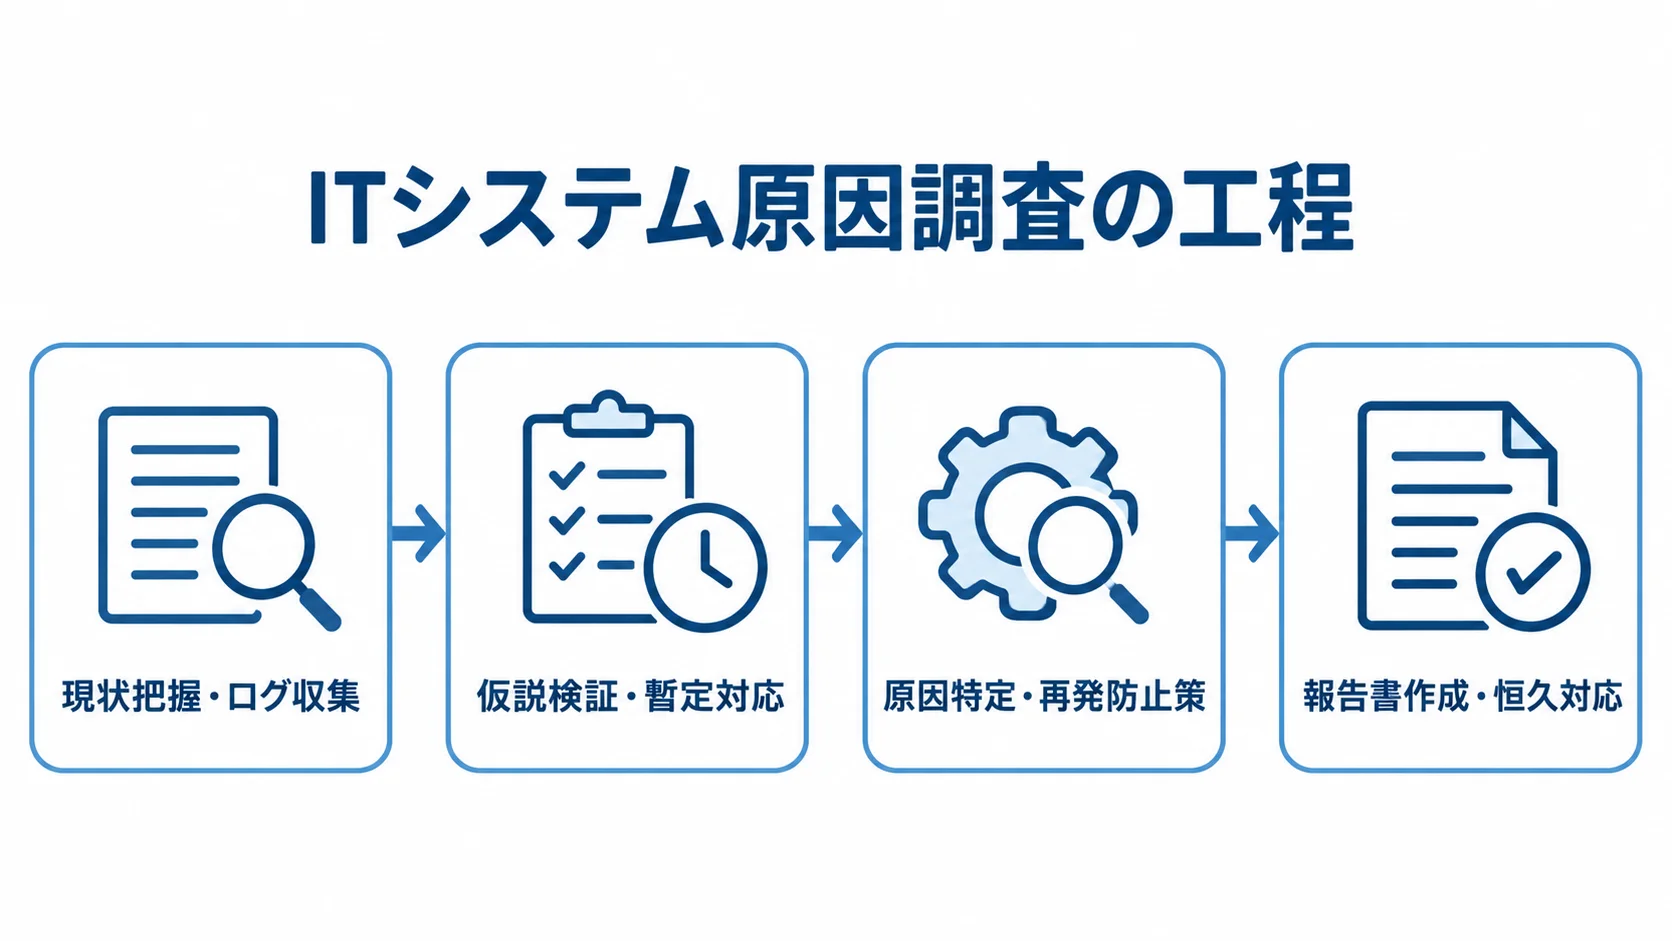
原因調査は、実務上4つの工程に分けて進めます。各工程で時間のスケールは大きく異なるため、フェーズごとの時間配分を理解しておくと、調査全体の遅延を防ぎやすくなります。
現状把握・ログ収集(一次切り分け)フェーズ
初動では、障害を検知した後に状況と影響範囲を把握し、関係部門へ連絡します。
- Critical:全社業務の停止時は、検知から15分以内の初回応答が目標です。
- High:特定部門や業務の停止時は、検知から30分以内の初回応答を目標とします。
初動の進み方は、担当者が手作業でログを確認するか、インシデント管理ツールで自動化するかによって大きく変わります。
PagerDutyの事例では、ココナラが日中アラートの平均確認時間(MTTA)を1分以内に抑えました。
シンプレクスはトリアージを自動化し、金融機関向けシステムの初期対応時間を従来の10分の1にしました。
初動の速さは、被害の拡大を防ぐうえで大切です。原因調査プロジェクトの納期を左右する、最初の段階でもあります。
仮説検証・暫定対応(復旧)フェーズ
初動の後は、根本原因を特定するより先に、システムの仮復旧を進めます。
- 復旧目標:MTTRは、Criticalで1時間以内、Highで4時間以内が一般的です。
- 事例:PagerDutyによると、ココナラは暫定対応の平均修復時間を1営業日程度に抑えています。
監視ログやレポートから異常データを調べ、原因の仮説を挙げて検証します。ただし、ログで特定できない場合は、過去の類似障害から仮説を立てる方法もあります。また、関係者がホワイトボードに事象を書き出し、切り分けを進める方法も使われます。
この工程の目的は、システムを止めない状態に戻すことです。
根本原因の完全な特定は次の工程に委ねるため、暫定復旧を先に行う点が、通常の開発プロジェクトとは異なります。
原因特定・再発防止策の策定(ポストモーテム)フェーズ
仮復旧の後は、ポストモーテム(事後検証)で障害の根本原因を調べます。この分析には、ログ解析の技術と、ポストモーテムの枠組みが求められます。
- 実施時期:記憶が鮮明な解決後72時間以内、または2〜3営業日以内が理想です。
- なぜなぜ分析:代表的な手法で、表面的な現象に「なぜ」を5回程度問い、直接原因の背後にある本質的な原因を探ります。
- メンタルモデル:近年重視される視点で、ログや操作履歴に加えて、担当者が操作を正しいと判断した心理的な過程も調べます。
分析結果を再発防止策に落とし込むことで、対策の実効性を高められます。
所要時間は障害の重大度によって変わります。たとえば、GMOメディアの合同検証では2時間程度かかりました。
事前にアジェンダとタイムボックスを決めておくと、予定に沿って進められます。
報告書作成・恒久対応の実行フェーズ
原因が特定できたら、原因や処置内容、改善提案を含む障害報告書を作成します。
恒久対応には、プログラム修正やインフラ構成の見直しなどがあります。ただし、すべてを直ちに実行するわけではありません。
- 優先度が高い対応:重要度と緊急度のマトリクスで順位を決め、数日以内にホットフィックスで修正します。
- 優先度が低い対応:数ヶ月から半期以上待ち、開発に余裕がある時期にまとめて対応することがあります。
原因特定までの期間と、その後の恒久対応の期間は、分けて考えます。
恒久対応は、他の開発案件との優先順位付けを経て、実行スケジュールが決まります。
調査体制によるスケジュールの違い
手作業を中心にするか、インシデント管理ツールで自動化するかによって、調査全体のスケジュールが変わります。
調査体制の選び方は、納期に直結します。
手作業でのログ確認・トリアージの場合
手作業中心の体制では、調査の速さや負荷が担当者の動き方に左右されます。
- ログ確認:担当エンジニアがログファイルを開き、異常値やエラーメッセージを目視で探します。
- 状況確認:関係者に電話やチャットで確認し、初動に数十分から数時間かかることがあります。
- 夜間・休日の対応:一人で担当する場合は、有識者と連絡が取れず調査が止まるおそれがあります。
- 負荷とコスト:導入費用はかかりませんが、複雑さや障害の頻度に応じて、時間と担当者の負担が増えます。
インシデント管理ツール導入による自動化の場合
インシデント管理ツールを使うと、検知後の連絡や初期の切り分けを仕組みとして進められます。
- 通知・初期切り分け:PagerDutyのようなツールで、検知後の連絡や初期の振り分けを自動化できます。
- 初動の短縮:初期対応を10分の1にした事例や、MTTAを1分以内に抑えた事例があります。
- 横断分析:複数機器のデータから、複雑なネットワークトラブルの要因を把握するツールもあります。
短縮しやすいのは、検知から初動、暫定復旧までです。一方で、ポストモーテムの質や速さは、人の分析にも左右されます。
なぜなぜ分析やメンタルモデルも掘り下げ、ツールと人の分析を組み合わせることが、全体の短縮につながります。
納期を短縮する具体的な方法
原因調査は、質を保ちながらスピードを高める工夫で期間を短縮できます。代表的な手法を2つ挙げます。
平時からのシステム構成図・ログ整備
障害発生前にシステム構成図とログ収集の仕組みを整えておくと、初動を早められます。
- 構成情報:ネットワーク図、設定情報、データセンター情報を、いつでも見られるようにまとめます。
- 監視設定:ログ収集の設定とアラートの閾値を、適切な値に調整します。
情報がそろっていれば、初動で確認事項を判断でき、仮説検証の時間も短縮できます。
準備の状況は、調査期間を左右する最大の要因です。そのため、ドキュメントの整備を平時の運用業務に含めておきます。
ポストモーテムのテンプレート化とタイムボックス設定
第二の手法は、ポストモーテムの手順をテンプレート化し、実施時間にタイムボックス(上限時間)を設けることです。記録内容や議論の順序が決まっていないと、話し合いが発散して時間を使いがちです。
- 時系列整理:障害の事象を時間順に並べる段階です。
- 原因特定:なぜなぜ分析で原因を調べる段階です。
- 対策整理:再発防止策をアクションプランにまとめる段階です。
工程の性質に応じて、契約形態を使い分けます。たとえば、要件が未確定の初動調査には準委任契約を、原因特定後の恒久対応の実装には請負契約を使います。
使い分けておくと、外部パートナーとのスケジュール管理を計画的に進められます。
納期遅延の典型要因と対策
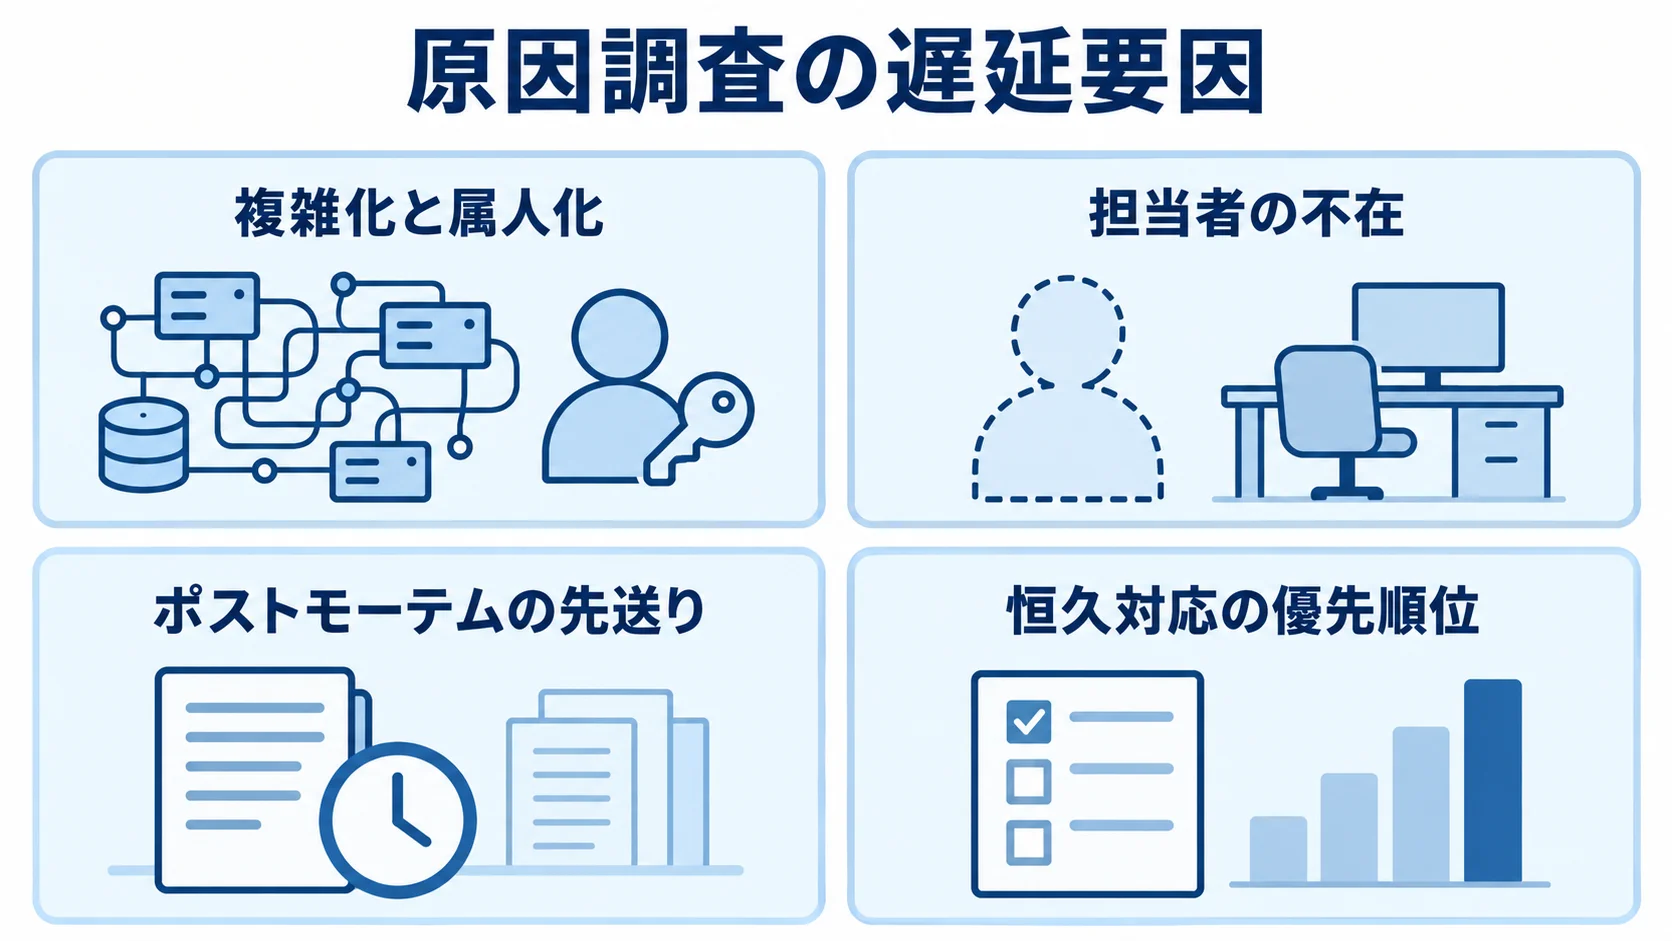
体制を整えても、遅延のリスクは残ります。そのため、起こりやすい要因を事前に把握し、対策を運用フローに組み込んでおきます。
ブラックボックス化・属人化による調査停滞
システム知識が一部の人に偏ると、障害発生時の初動や現状把握が遅れます。
- 複雑化と属人化:最も多い遅延要因です。長年の運用や改修で構造が複雑になり、内部構造や障害履歴を知る人が限られます。
- 担当者の不在:障害時に有識者がいないと初動が滞り、退職や異動後は現状把握に想定以上の時間がかかることもあります。
- 平時の備え:構成、ログの読み方、障害履歴を文書化し、特定の個人に依存しない調査体制を作ります。
ポストモーテムの先送りと再発防止策の形骸化
原因究明と恒久対応は、仮復旧を済ませた後も続きます。そのため、両方を最後まで管理します。
- 第2の遅延要因:仮復旧後の安心感から、ポストモーテムの実施を先送りすることがあります。
- 記憶の薄れ:解決後72時間以内の分析が遅れると、時系列や判断の背景を再現できず、分析が表面的になるおそれがあります。
- 第3の遅延要因:原因特定後も優先順位が曖昧だと恒久対応が遅れ、同じ原因の障害が再発しかねません。
- 実行管理:検証を対応フローに組み込み、恒久対応に担当者と期限を割り当てて、進捗を定期的に確認します。
まとめ
ITシステム原因調査の開発期間や納期は、重大度別の目安と工程の時間配分を踏まえて考えます。
初動は15〜30分以内、暫定復旧は1時間から1営業日、根本原因の特定は72時間以内が目安です。
恒久対応は数日から数ヶ月かかることがあり、他の開発案件との優先順位で予定が決まります。ツールは初動を早められます。一方で、根本原因の分析は人のプロセスにも左右されます。
構成図やログの整備、ポストモーテムの型と時間枠の設定は、調査の質を保ちながら納期を縮める方法です。
属人化やポストモーテムの先送りを防ぐ対策も、運用フローに組み込みます。
自社での対応が難しければ、原因調査を含む保守運用のアウトソーシングも検討できます。
アウトソーシングを使う場合は、複数の会社にシステム構成と求める対応スピードを提示し、相談します。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。