
ITシステム原因調査のPoCは、ツールの検証、プロセスの試行、非本番環境での安全な疑似障害検証を段階的に進めることで、自社に合う体制を見極められます。
全体像は、ITシステム原因調査の完全ガイドもご覧ください。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
原因調査プロセス導入前のPoCの全体像
ITシステム原因調査は、障害や不具合が起きたときにログやメトリクスを分析して、根本原因(RCA:Root Cause Analysis)を突き止める実務です。なぜなぜ分析やポストモーテムを使い、再発防止策を策定するところまでを含みます。
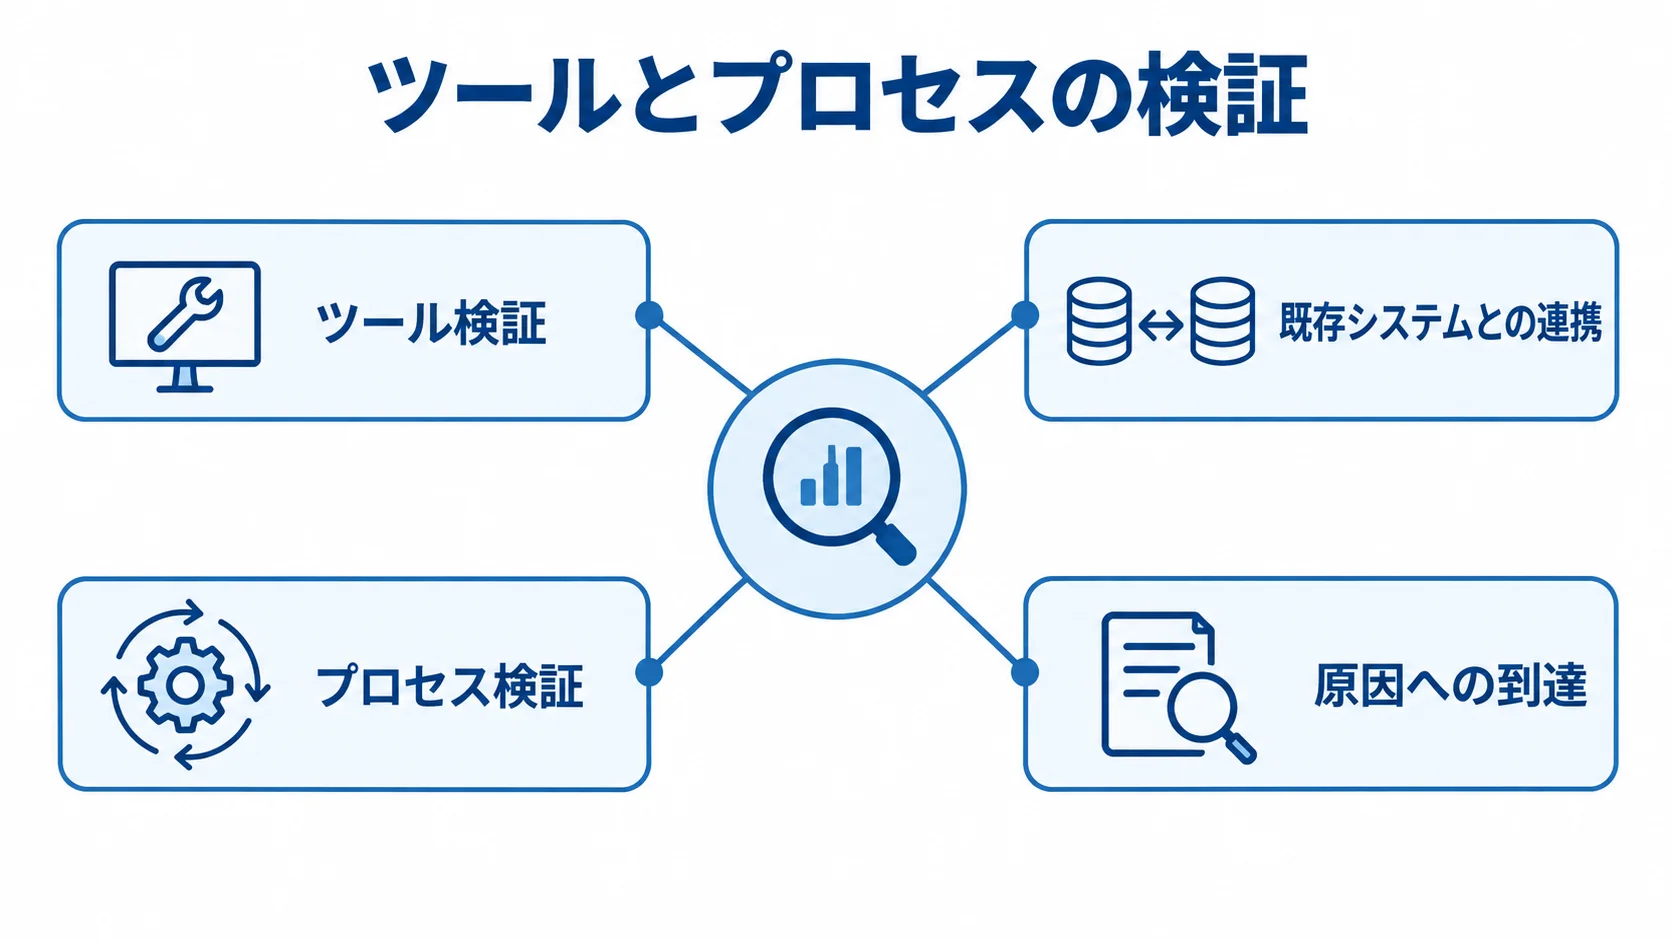
原因調査のPoCでは、ツールとプロセスの2つを検証します。両方を並行して試すことで、実効性の高い体制づくりにつながります。
ツール検証では、インシデント管理ツールや監視・ログ分析基盤を実環境で試し、既存システムとの連携やアラート通知が期待どおりかを確認します。
プロセス検証では、なぜなぜ分析やポストモーテムの進め方を試します。小規模なチームや過去の障害を題材に、自社の組織文化に合う形を探ります。
ツールは、ベンダーの無料トライアルを使うと低コストで検証を始められます。プロセスは社内シミュレーションや小規模インシデントで試行します。
「ツール検証」と「プロセス検証」の2つの軸
原因調査体制の構築を成功させるには、ツールとプロセスの両方をPoCの検証対象に含めることが欠かせません。どちらか一方だけを検証すると、調査が滞るおそれがあります。ツールとプロセスでは、確認する対象そのものが異なります。
- ツール:ログ検索や相関分析を支援する環境
- プロセス:担当者が原因を特定する進め方
ツールだけを導入した場合、障害時に誰が何をどの順番で確認するかが決まらず、使いこなせないことがあります。一方で、プロセスだけを整えても、ログの検索や相関分析に手作業の時間がかかり、なぜなぜ分析に進む前に疲弊することがあります。
PoCで両方を小さく試すと、自社に合う組み合わせを見極められます。さらに、本導入後の定着率を左右する要素も確認できます。
PoCで確認すべきゴール設定
PoCを始める前に、何を確認できれば成功とみなすかを決めておきます。評価する内容は、ツールとプロセスに分けて設定します。
- ツール:連携、通知、検索・分析にかかる時間
- プロセス:原因への到達、所要時間、改善への反映
ツール検証では、既存の監視対象システムと問題なく連携できるか、アラートがメール、Slack、Teamsなど想定した経路へ正しく届くかを確認します。
ログの検索・相関分析にかかる時間も、手作業と比べてどれだけ短縮できるかを評価します。
プロセスでは、なぜなぜ分析で本質的な原因に届いたかを見ます。あわせて、ポストモーテムの所要時間や、参加者の声がテンプレートの改善につながったかも評価します。
ゴールが曖昧だと、「もう少し試す」という状態が続き、本導入の判断が先延ばしになりがちです。
ツール導入のPoC・トライアル期間
原因調査を支えるツールの多くは、本契約の前に無料トライアルで実環境での動作を確認できます。そのため、低リスクなPoCの第一歩として活用できます。
トライアルの対象には、インシデント管理ツールや監視・ログ分析基盤があります。
無料トライアル期間の目安
無料トライアルでは、実際の監視対象と連携させ、疑似アラートで通知の経路や内容を確かめます。期間中に見る範囲は、事前に決めておくのが望ましいです。
- 動作確認:導入初日から稼働できるか
- 連携確認:既存の監視ツールとの接続
PagerDutyのようなSaaS型のインシデント管理・自動化ツールでは、14日間の無料トライアルが一般的な水準です。
導入の進め方を示すガイドとして、「利用開始するための20日間のステップ」のような指標が用意されることもあります。
トライアルは、導入初日の稼働や既存ツールとの技術的な障壁を見極める期間です。本番運用で起きるすべての障害パターンを、トライアルだけで検証できるわけではありません。
監視対象を絞ったスモールスタート検証
トライアル期間を最大限に活かすには、影響度の高い重要システム数台に対象を絞る方法が有効です。最初からすべての監視対象システムを含めず、設定や運用との相性を確かめます。
- 作業量:通知経路やアラート閾値の調整を少なくできる
- 確認範囲:使い勝手と既存フローとの相性
対象を絞ると、ツールの基本的な使い勝手や既存運用との相性を短期間で見極められます。たとえば、通知が多すぎる、連携できないシステムがあるといった課題を洗い出せます。そのうえで、本契約の前に解消の見込みを立てると、本導入後の手戻りを防げます。
原因調査プロセス(ポストモーテム)のプロトタイピング手法
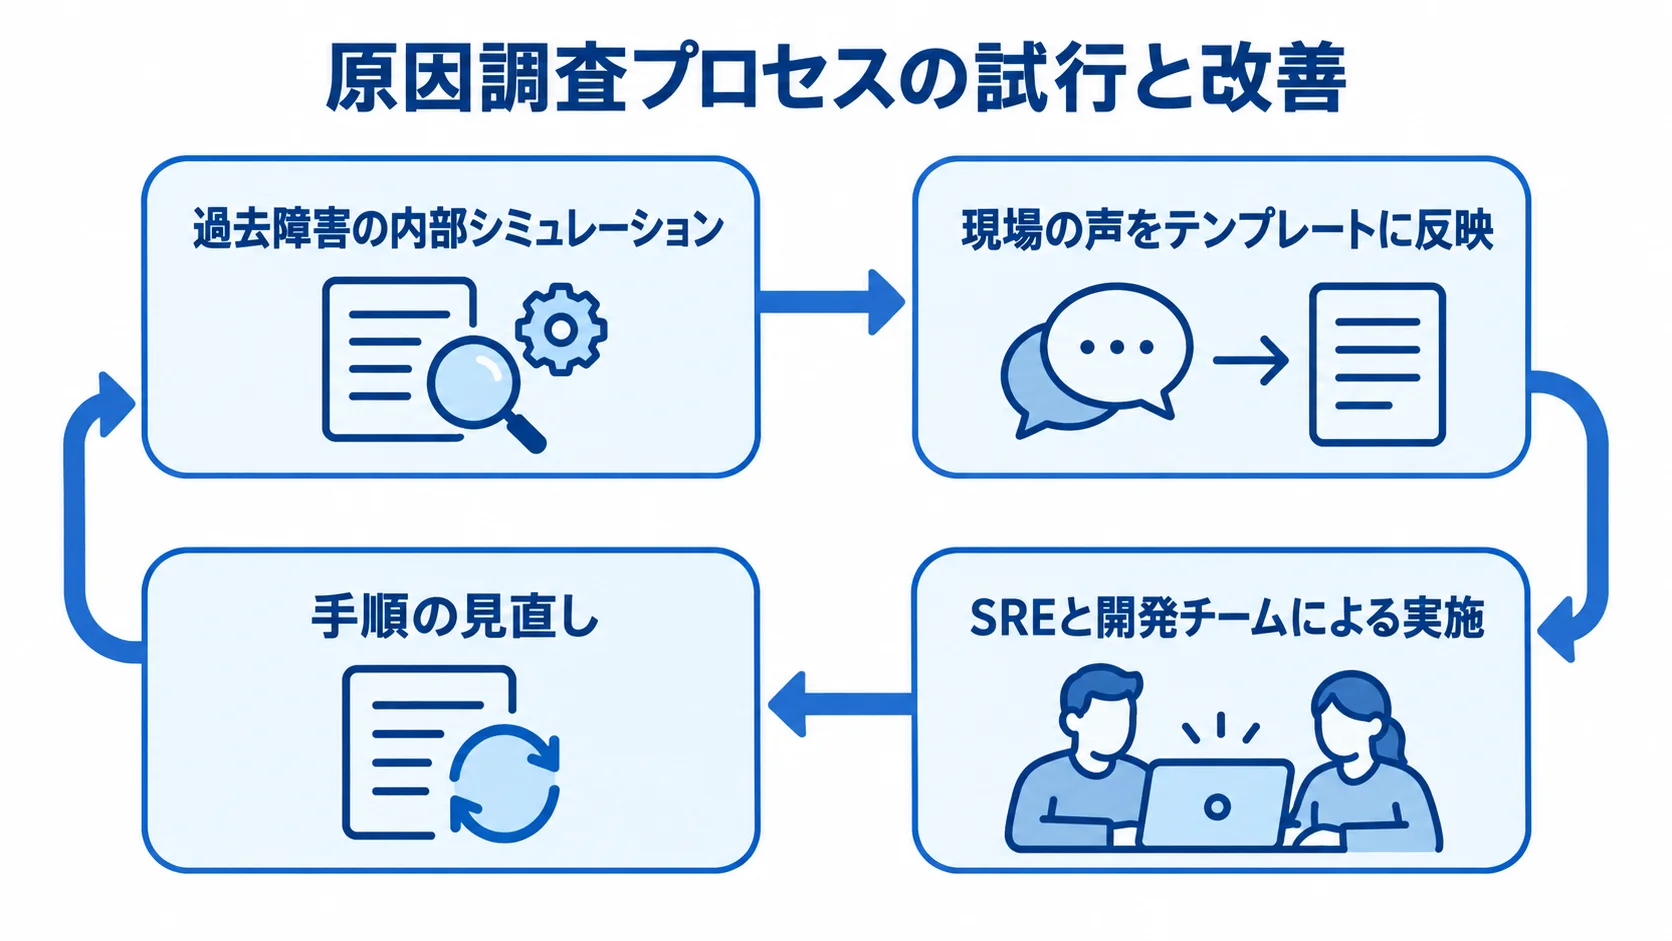
原因調査の質は、ツールだけでなくポストモーテムの進め方にも左右されます。そこで、プロセスそのものをプロトタイプとして小さく試し、改善を重ねる方法が有効です。実践事例でも、その有効性が示されています。
過去障害を題材にした内部シミュレーション
新しいテンプレートやフォーマットは、まず特定のチームで試し、成功体験を積み重ねてから広げます。最初から全社での運用を目指さないのが、この進め方の特徴です。
- 題材:チーム内で過去の実障害を振り返る
- 目的:テンプレートの使い勝手と不足点
あるSREチームは、メモリ不足によるシステムダウンなど、過去に起きた障害を新しいテンプレートに沿ってシミュレーションしました。
実際の障害対応の緊張感がない状態で試せるため、使い勝手や不足項目を落ち着いて確認できます。このシミュレーションが、プロトタイピングの第一段階です。
フィードバックによるテンプレート改善と合同実施
内部シミュレーションで出た声をテンプレートに反映し、一定の完成度になったら、実障害を題材にした合同実施へ進みます。
- 改善例:Slack上のやり取りや再発防止策を記録
- 次の段階:SREと開発チームによる実施
改善点をテンプレートに反映していくと、実際の運用に耐える形へ磨き上げられます。
ある企業では、合同実施に計2時間かかりました。内訳は、説明と分析に1時間、対策と学びの整理に1時間です。「2時間では長すぎた」という声を受けて、さらに手順を見直しました。
対象や関係者を段階的に広げながら改善を重ねることが、原因調査プロセスを組織に定着させる現実的な進め方です。
非本番環境での安全な検証(カオスエンジニアリング等)
原因調査の進め方は、実際に障害を経験しないと検証しにくい面があります。
この課題に対する先進的な方法として、意図的に疑似障害を起こして弱点を探すカオスエンジニアリングが注目されています。
「制御された実験」としての疑似障害注入
カオスエンジニアリングは、計画した「制御された実験」として行うものです。当てずっぽうにシステムを壊す方法ではありません。
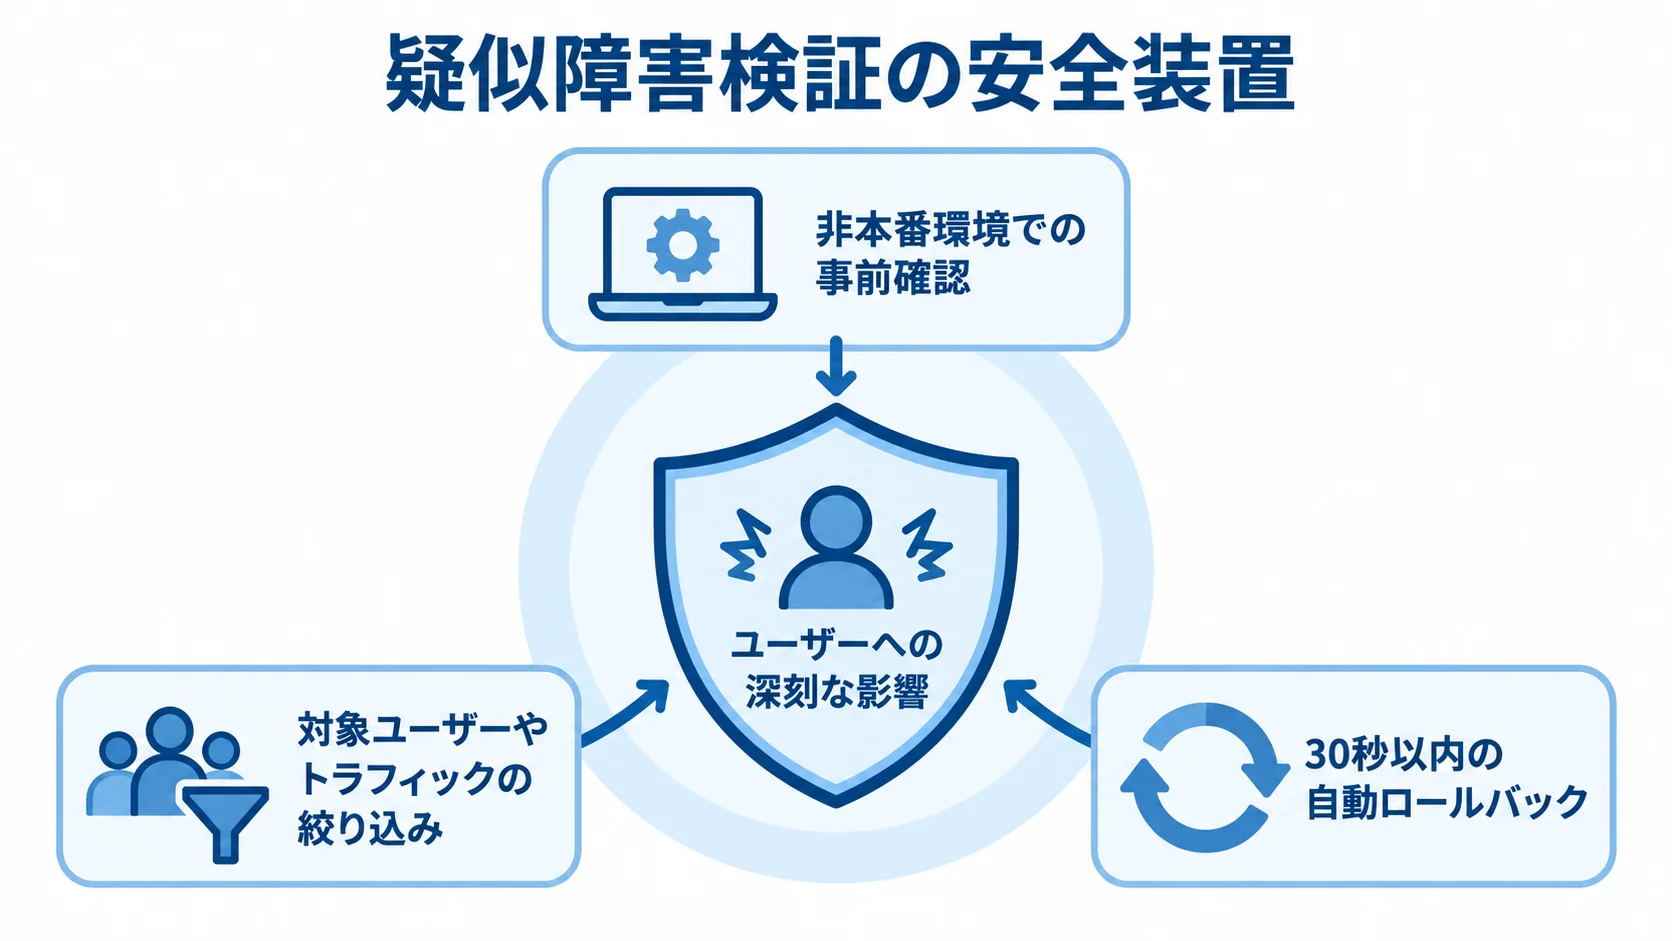
- 開始環境:非本番環境での事前確認
- 検証内容:検知と担当者の一次切り分け
影響範囲は、段階的に広げていきます。
ネットワーク遅延やサービス停止を注入して、監視ツールがそれを検知するかを確認します。また、担当者が決められたプロセスで一次切り分けできるかも試せます。実際の障害を待たずに、検知や初動対応を事前に検証できることが、この方法の利点です。
影響範囲の最小化と自動ロールバック
本番環境に近い環境でカオスエンジニアリングを行う場合も、リスクを抑える安全装置が欠かせません。
- 影響の限定:対象ユーザーやトラフィックの絞り込み
- 停止条件:異常時に自動ロールバックする条件
その手段には、カナリアリリースやサーキットブレーカーがあり、影響を数パーセントの範囲に抑えます。これは、爆発半径(ブラストレディウス)を最小化するという考え方です。
異常を検知した際には、30秒以内に自動ロールバックする基準を設けます。そうすることで、ユーザーに深刻な影響が及ぶ前に検証を止められます。
先進事例では、AIエージェントがCI/CDパイプラインのデプロイごとに疑似障害を注入します。この仕組みは、システムの回復力を自律的に検証します。その結果、平均復旧時間(MTTR)を65%削減した実績も報告されています。
非本番環境で安全な検証を重ねると、実際の障害時に原因調査のプロセスが機能するかを、PoCとして事前に確かめられます。
PoCを成功させるポイント
原因調査のPoCは、検証だけで終わって本導入に至らない場合もあります。
PoCを次の段階へつなげるには、開始前の準備と実施中に押さえたい点があります。
本導入判断の基準の事前合意
PoCを始める前に、本導入を判断する状態を関係者間で合意しておきます。終了後も検証を続けるだけの状態を避けるためです。
- 評価時期:14日間や20日間などの区切り
- 判断内容:本導入、見送り、追加検証のいずれか
トライアル終了後に「もう少し検証したい」となれば、PoCが長引き、原因調査体制の構築が停滞するおそれがあります。
そこで、連携の可否、通知の正確性、対応時間の短縮効果など、事前に決めた確認項目を評価します。あわせて、その場で判断する機会も設けておきます。
現場フィードバックの段階的な取り込み
ポストモーテムの試行事例が示すとおり、原因調査の手順は一度で完成するものではなく、現場で使った声を取り込みながら磨いていきます。
- 小さく試行:限られたチームでの開始
- 範囲を拡大:改善後の他チームとの合同実施
対象や関係者を広げる循環が、原因調査の手順を無理なく組織に定着させます。
PoCでは完璧な仕組みを急がず、小さく試して素早く改善する姿勢を関係者で共有しておきます。この姿勢が、原因調査体制を根付かせる要点です。
まとめ
ITシステム原因調査のPoC・プロトタイプ・モックアップ開発では、ツールとプロセスの両方を検証します。
インシデント管理ツールの多くは、14日間程度の無料トライアルを提供します。そのうえで、監視対象を絞れば低リスクで試せます。
原因調査プロセスは、SREチーム内で過去障害を題材に試し、現場の声を反映してテンプレートを改善します。その後、他チームとの合同実施へ段階的に進み、対象を広げます。
非本番環境で疑似障害を注入すれば、実際の障害を待たずに原因調査プロセスを事前検証できます。
開始前に判断基準を明確にし、現場のフィードバックを取り込みながら小さく試して素早く改善することが、本導入につながります。まずは無料トライアルや小規模なチーム内シミュレーションから始められます。
▼全体ガイドの記事
・ITシステム原因調査の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。