
ITシステムサーバー監視の導入期間は、監視ツール、対象サーバーの規模、環境によって、数十分から数週間まで変わります。所要時間を大きく左右するのは、ツールの選定と、手作業で設定するかクラウドの標準機能を使うかの違いです。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
サーバー監視導入プロジェクトの開発期間の全体像
「ITシステム保守監視」は、SLA設計やアラート対応の委託体制全般を指します。
一方で、サーバー監視は機材寄りで、インフラの健全性を数値で捉えます。具体的には、サーバーが稼働中か、ディスクが満杯になるまで何日か、EC2が自動増減に追従するかを確認する領域です。
構築期間は、対象が物理サーバーか仮想サーバーか、監視ツールの選択によって変わります。まず、ツール別・環境別の構築時間から、開発期間の相場観を押さえておきます。
手作業中心で組むか、クラウドの標準機能を使うかによっても、同じ監視を始めるまでの時間は数十分から数週間まで変わります。
監視ツール別に見る構築所要時間の目安
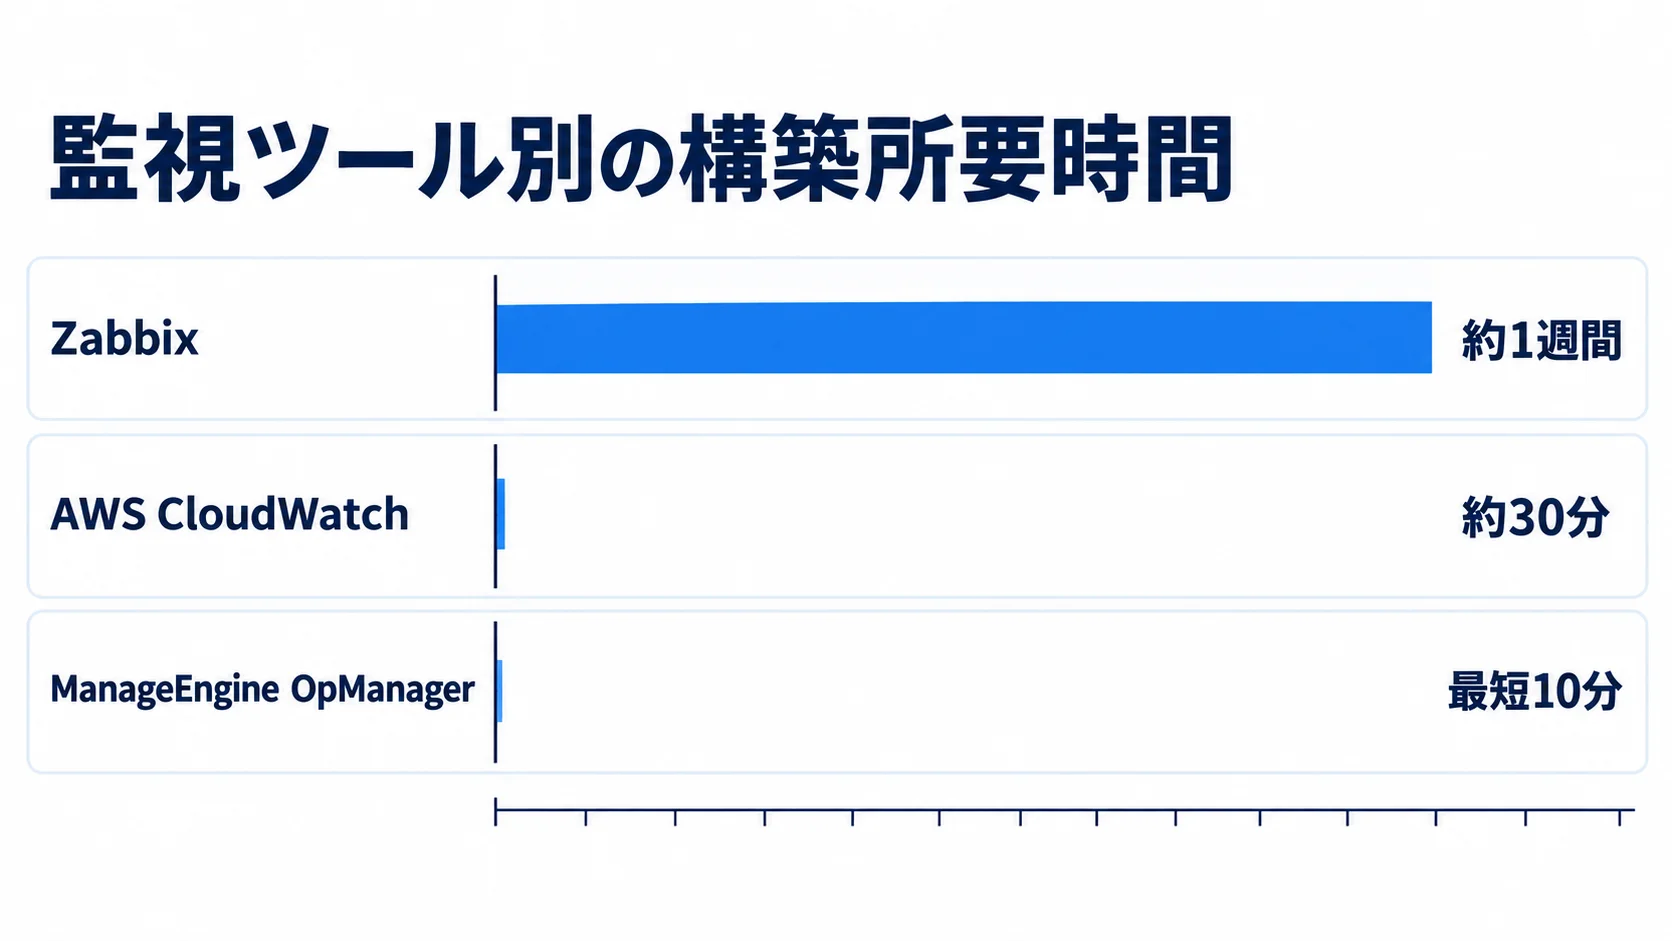
ツールの選定は、サーバー監視の開発期間を大きく左右する判断です。ツールごとに操作方法が違い、導入にかかる時間にも差があります。
- Zabbix:小規模案件(〜50台程度)でも、手作業の初期構築に約1週間かかったインフラエンジニアの実例があります。
- AWS CloudWatch:AWS環境だけであれば、約30分で構築から監視開始までできます。
- ManageEngine OpManager:インストールから最短10分で監視を始められるとされています。
- Mackerel:有料機能をすべて2週間無料で試せるトライアルがあり、簡単なコマンドで検証できます。
ZabbixはOSSです。オンプレミス監視では、設定ファイルやCPU・メモリ・ディスクなどの項目、アラート通知を手作業で設定します。
ManageEngine OpManagerは、物理サーバーやネットワーク機器を含む幅広い対象を監視できます。
また、CloudWatchはAWS標準機能のため、コンソールで設定できます。選ぶツールによって所要時間に桁の差が出るため、その差を計画の出発点として扱います。
サーバー台数「50台」が示す期間感の分岐点
監視対象の50台は、推奨ツールとスケジュールを考える際の分岐点とされています。
- 数台〜50台未満:Zabbixを手作業で設定しても、約1週間で構築できる範囲に収まります。
- 50台超:手動設定中心のツールは管理が煩雑になりやすいため、別の方式も検討の対象になります。
中・大規模の環境では、ホスト課金制SaaSのDatadogや、Prometheus + Grafanaなどが候補になります。ただし、これらの具体的な導入期間を示す一次情報は限られています。
台数が増えるほど、監視項目の設計やツール移行の検討にかかる期間も伸びると見込むのが現実的です。そのうえで、自社の監視対象が50台のどちら側にあたるかを最初に把握しておくと、スケジュールの精度が上がります。
工程別スケジュールと期間配分
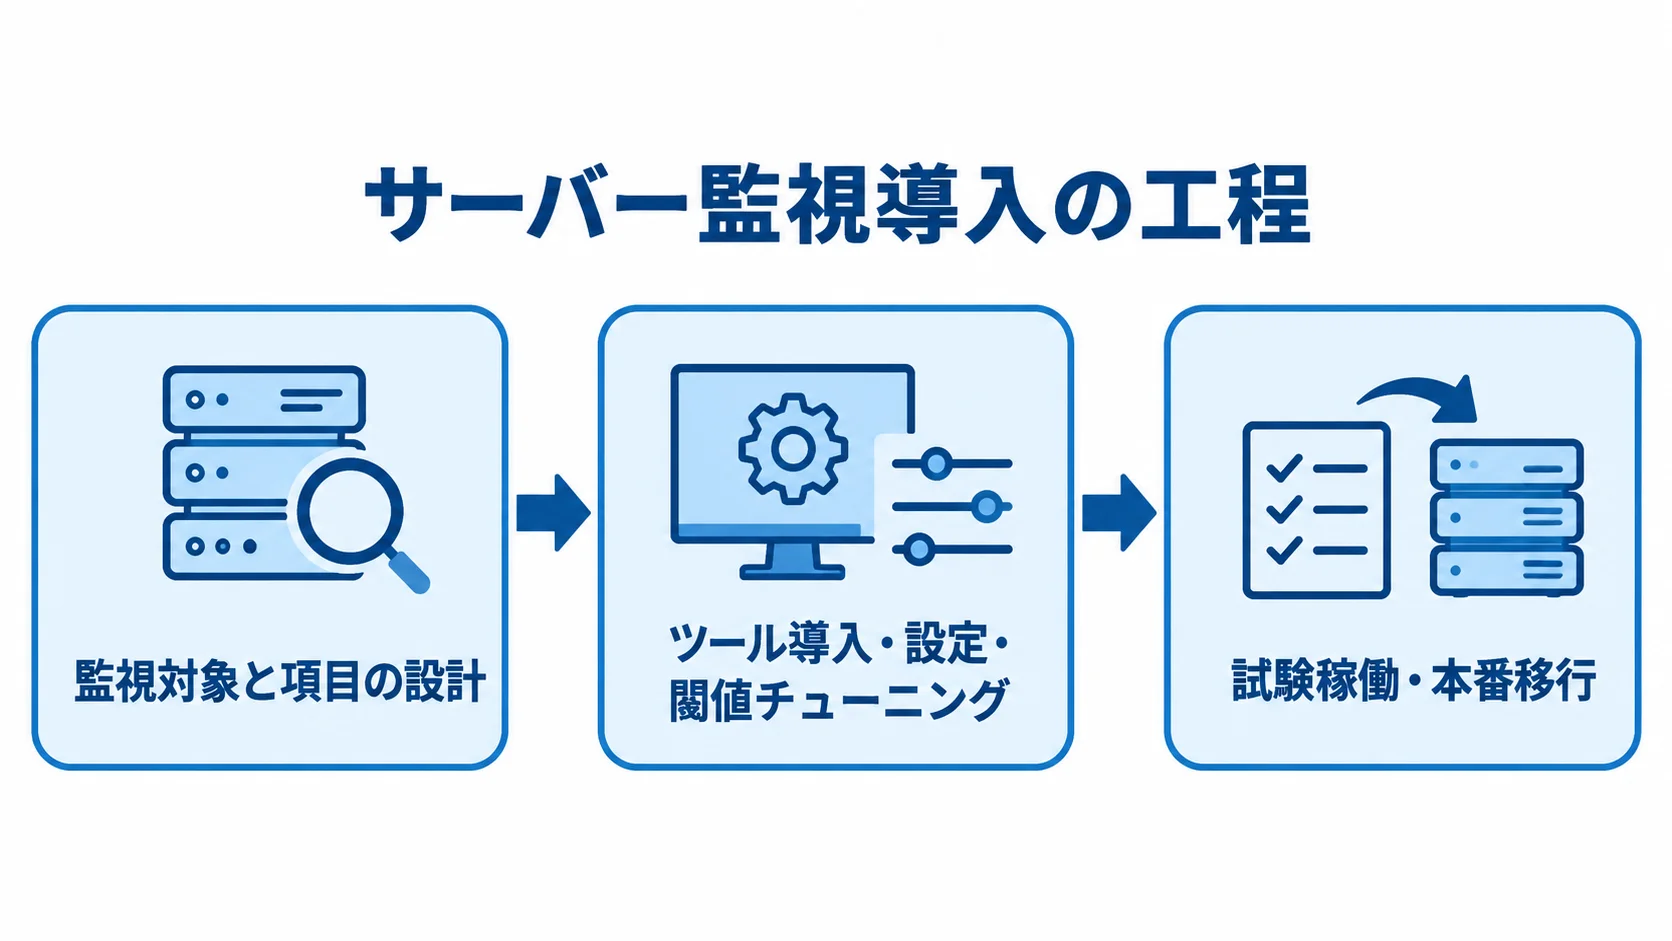
導入は3つの工程で進み、まず監視対象と項目を設計します。次に、ツールを導入して設定し、閾値を調整します。最後に、試験稼働を経て本番へ移行します。
監視の対象はハードウェア、OS、ミドルウェアにまたがるため、各工程で何を決めるかを把握しておくと、遅延を防げます。
監視対象の棚卸し・監視項目設計フェーズ
最初に、物理サーバーと仮想サーバーの一覧を作り、それぞれのOSとミドルウェアを洗い出します。
監視項目は、対象のレイヤーによって変わります。
- ハードウェア:CPU使用率、メモリ使用量、ディスク容量、ネットワークトラフィック。
- OS・ミドルウェア:プロセスの死活、ログ、特定サービスの稼働状況。
一覧には、LinuxやWindows Server、Web・DB・APサーバーといった稼働中の種類も含めます。
オンプレミスとクラウドが混在すると、レイヤーごとに監視範囲やメトリクスの粒度が異なるため、物理サーバーだけの場合より設計期間が長くなる傾向があります。
設計が曖昧なままだと、導入後に必要な項目が取れず、手戻りが起こります。そのため、レイヤーごとの項目を丁寧に定義しておくことが、結果として納期の短縮につながります。
ツール導入・設定・閾値チューニングフェーズ
監視項目が決まったら、サーバーにエージェントを入れて、ダッシュボードとアラートの閾値を設定します。この段階の所要時間は、前に見たとおり、選んだツールによって大きく変わります。
- Zabbix:対象サーバーごとに、設定ファイルを手作業で記述する必要があります。
- CloudWatch:クラウドのコンソール操作で設定を完了できます。
デフォルトの閾値をそのまま使わず、瞬間的なCPU使用率の上昇では通知しないよう調整します。たとえば、一定時間上昇が続いた場合に通知する設定にします。
閾値の調整には、実際のサーバーの稼働パターンを一定期間観察する時間も必要です。
複数レイヤーの項目を並行して設定できるか、担当者を分けられるかによっても、期間は変わります。
試験稼働・本番移行フェーズ
設定後は、障害を想定した試験を行い、検知と通知が正しく動くかを確かめます。
- サーバーに負荷をかけるか、LANケーブルを抜いて擬似障害を起こします。
- 異常の検知と、メール、Slack、Teamsなどの通知先へのアラート到達の確認。
- 試験で問題がなければ本番へ移行し、台数が多い場合は一部のサーバー群から段階的に切り替えます。
試験を省いて本番へ移行すると、障害時にアラートが届かないという致命的な事態を招きかねません。このため、試験に充てる時間は惜しまないようにします。
この段階的な移行は、リスクを抑えながらスケジュールを進める手段です。
本番後に監視項目や閾値を大きく変えると、その分コストが高くつきます。
試験稼働に時間を割くかどうかが、その後の運用品質を左右します。
オンプレミスとクラウド(AWS EC2等)で変わるスケジュール
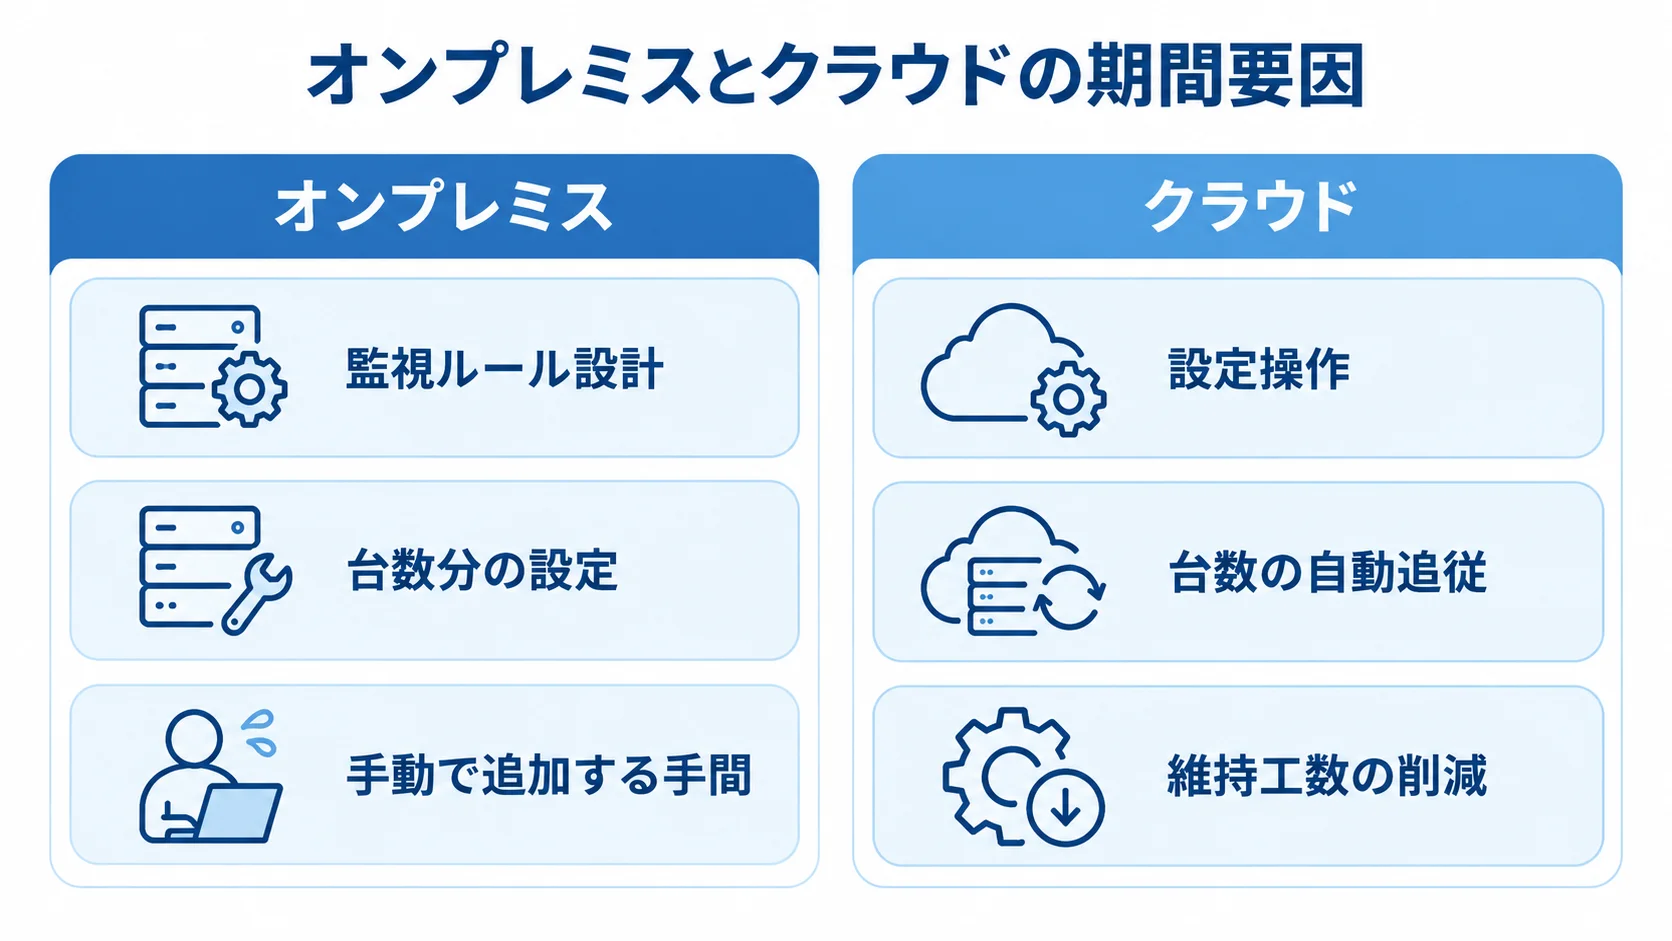
スケジュールは、監視対象がオンプレミスかクラウドかによっても変わります。構築の手間に加え、サーバー台数が変動したときの追従性も両者で異なります。
オンプレミスサーバー監視の期間要因
オンプレミスの物理・仮想サーバーでは、ZabbixなどのOSSを使うケースが多くあります。要件定義、テンプレート作成、監視ルール設計には、多くの時間と人手が必要です。
- 台数分の設定:対象が増えるほど作業が積み重なり、構築期間も線形に近い形で伸びます。
- ハードウェア固有の監視:ディスクのSMART情報など、経年劣化や故障の予兆を捉える項目の設計も必要です。
オンプレミス中心のサーバー監視は、同じ台数でもクラウド中心の場合より構築期間が長くなる傾向があります。
クラウド(AWS EC2等)サーバー監視の期間短縮効果
AWS EC2などでは、CloudWatchのようなクラウドネイティブツールを使えば、設定操作だけで短い期間に監視を始められます。
- 台数の自動追従:CloudWatchなどは、増減するEC2を監視対象へ自動で組み込みます。
- 維持工数の削減:台数変更のたびに監視設定を手動で追加する手間を省けます。
この仕組みは、導入期間だけでなく、運用が始まったあとの維持工数も短くします。
Zabbixなどオンプレミス向けのツールでは、オートスケーリングへの追従設定が非常に難しいという技術的な課題も指摘されています。クラウド中心であれば、選定の段階でクラウドネイティブなツールを優先するのが、スケジュール短縮の面でも合理的です。
納期を短縮する具体的な方法
監視の品質を保ちながら導入期間を縮める代表的な方法には、クラウド型のツールを使う方法と、範囲を絞って始める方法があります。
クラウドネイティブ・SaaS型ツールによる手作業時間の削減
予算が許す場合は、構築工数の大きい無料OSSより、設定が簡単でクラウド連携に優れた有料ツールを選びます。
- AWS中心:CloudWatchが候補になります。
- マルチクラウド・大規模環境:Datadogを候補として検討します。
- 設定操作:GUIやドラッグ&ドロップでアラートを作れる、ノーコード・ローコード対応も検討の対象です。
クラウド側の機能と密に連携するツールを使えば、構築期間を大幅に縮められます。手作業の時間をサービス利用料に置き換えるこの考え方は、納期が限られる案件に有効です。
特に、GUI操作で設定できるツールを選ぶと、設計と設定の手間を省けるため、納期の短縮にもつながります。
スモールスタートと段階的な監視対象拡大
第二の方法は、全サーバーや全メトリクスを対象にせず、範囲を絞って始めることです。運用しながら改善していく進め方は、導入時の失敗を避けられるとされています。
- 基幹業務に関わる重要サーバー数台から、ハードウェアの死活監視を始めます。
- 稼働が安定したら、OS・ミドルウェアのリソース監視へ広げます。
- その後、監視対象のサーバー台数を段階的に増やします。
多機能なツールに合わせて過剰な設定をすると、項目が膨大になって導入の障壁となり、全体のスケジュールが延びることがあります。
段階的な進め方なら、設定ミスが起きても影響の範囲を限定できます。停止できない対象を扱うサーバー監視とは、相性のよい進め方です。
納期遅延の典型要因と対策
綿密に計画しても、サーバー監視の立ち上げには遅延のリスクが残ります。起こりやすい要因を先に把握し、対策をスケジュールや体制に組み込んでおくことが重要です。
監視ルール設計への工数集中(オンプレミス特有)
特にオンプレミス型では、監視ルール設計や要件定義に人手と時間がかかり、遅れが出ることがあります。
複数レイヤーの項目をすべて手作業で設計・設定すると、小規模な組織やIT人材の少ない企業では、つまずきやすくなります。
- 工期の確保:監視項目の設計に、十分な期間と工数をあらかじめ割り当てます。
- テンプレートの活用:標準の監視項目や既製のダッシュボードを利用します。
- 並行作業:物理とクラウドで項目の粒度が違う場合は、レイヤーごとに担当者を分けます。
設計の負担を分けておけば、工数の集中を避けられます。
専門知識不足と過剰な機能設定によるつまずき
監視指標の選定や分析には、ネットワーク、OS、クラウドの専門知識が求められます。初学者や非IT部門が中心のチームでは、項目設計に加えて、閾値調整やアラート条件の設定でもつまずくことがあります。
もう一つの遅延要因は、最初から多機能な監視を目指して、複雑な設定や運用手順を組み込んでしまうことです。
複雑な条件分岐を急いで設定した際に、重要なエラーログが通知されず、発見が数時間遅れた実例もあります。
- 知識が不足する場合:GUI中心で直感的に操作できるツールを選びます。
- 設定を始める場合:監視設定をシンプルに保ち、運用しながら段階的に精緻化します。
この方針は、プロジェクトの開始時にチーム全体で共有しておくのが有効です。
まとめ
サーバー監視の構築時間は、ツールによって大きく異なります。Zabbixは小規模の案件でも約1週間、CloudWatchは約30分、OpManagerは最短10分が目安です。
監視対象50台を分岐点にして、規模に応じたツールとスケジュールを検討します。工程は、対象と項目の設計、ツールの設定、試験稼働、本番移行の順に進みます。
オンプレミスのサーバーは、監視ルールの設計に時間がかかります。一方、クラウドのサーバーはオートスケーリングに自動で追従し、運用開始後の工数も減らせます。
納期を縮めるには、クラウドネイティブ・SaaS型ツールとスモールスタートが有効です。また、設計の工数集中や専門知識の不足への対策も、計画の段階で組み込んでおくことが大切です。
ここまでで、ITシステムサーバー監視の開発期間・スケジュール・納期を、構築時間、工程配分、納期短縮策と遅延対策の面から見てきました。具体的な日程を相談する前に、物理・仮想サーバーの構成とクラウドの利用状況を整理しておきましょう。そのうえで、複数の開発会社や監視サービス会社に見積もりを取ることをお勧めします。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。