
ITシステムサーバー監視のフルスクラッチ開発は、監視要件と人材、運用体制を見極めたうえで、OSS基盤と既製ツールを組み合わせれば独自要件に対応できます。
OSSで構築する場合の特徴と課題、既製SaaSとのTCO比較、向いている企業の条件を取り上げます。全体像は、次の完全ガイドもご覧ください。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
サーバー監視における「フルスクラッチ」の定義
ITシステムサーバー監視では、物理・仮想サーバーのCPUやメモリ、ディスク、ネットワークに加え、OS・ミドルウェアのプロセス死活を常時計測し、異常を検知するとアラートを発報します。
フルスクラッチは、監視エージェントの配置からメトリクス収集、アラート判定、通知までを自社要件に合わせて構築する手法です。構築の方法には、AWS CloudWatchやDatadogなどの既製SaaSを使わずに作る方法と、OSSを基盤に設定や機能を独自に拡張する方法があります。
物理サーバーの台数や機種、仮想化基盤、オンプレミスとクラウドの比率は企業ごとに異なります。そのため、標準機能で満たせない監視要件がある企業には、フルスクラッチが選択肢になり得ます。
OSSを用いた自社独自のサーバー監視基盤構築
ZabbixやPrometheus + GrafanaなどのOSSを基盤に、自社環境に合わせて監視基盤を構築する方法です。ライセンス費用は無料(0円)ですが、サーバーの構築から各物理サーバーの設定、アップデート、トラブル対応まで自社で担います。
- Zabbix:設定項目が多く、監視項目やアラート通知を手作業で設定する必要があります。
- Prometheus + Grafana:モダンな構成として人気ですが、学習コストは高めです。
Zabbixは小規模案件(〜50台)でも、初期構築に約1週間かかった実例があります。さらに、どちらの方法もコマンド操作に慣れたエンジニアが必要で、構築と運用の責任は自社が負います。
SaaS型監視ツールとの構造的な違い
SaaS型ツールは、OSSの自社構築と比べて、費用のかかり方や導入後の運用に違いがあります。
- Datadog:1ホストあたり月額15ドル前後のサブスクリプションです。
- AWS CloudWatch:ログ取り込み1GBあたり0.76ドルなど、利用量に応じて課金されます。
- 導入の手軽さ:GUIとテンプレートを使い、初日から稼働できます。
- クラウド連携:CloudWatchはEC2のオートスケーリングに自動追従します。
この自動追従により、クラウド中心の環境では構築や運用の手間を大きく抑えられます。
情シス人員が限られる企業では、OSSの運用に時間をかけるより、有料SaaSのほうがTCOを抑えられる傾向があります。このため、両者の運用負担の違いを理解し、ゼロから作る必要があるかを判断することが出発点になります。
OSS自社構築の技術要件とメリット・デメリット
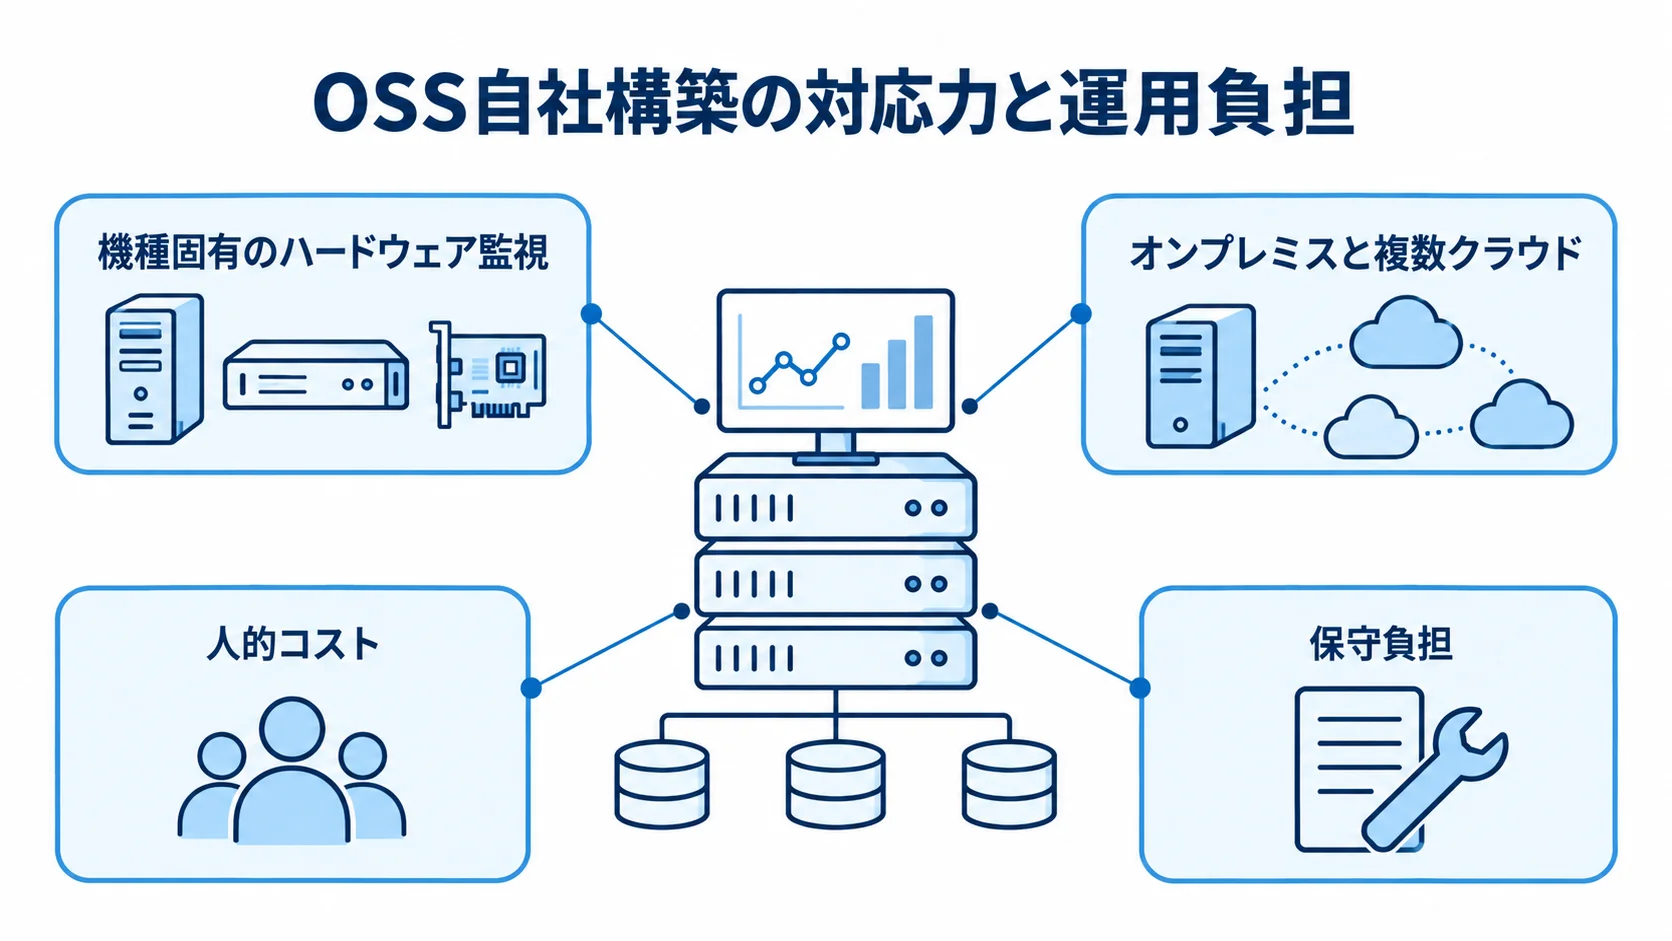
OSSで監視基盤を自社構築すると、既製品にはない利点が得られる一方で、相応の負担も生じます。そのため、技術要件を踏まえて、自社で現実的に運用できるかを確かめておく必要があります。
メリット—無限のカスタマイズ性とハイブリッド環境への対応力
最大の利点は、無限のカスタマイズ性によって、自社固有のサーバー構成に完全に合わせられることです。
- 独自要件への対応:機種固有のハードウェア監視や独自ミドルウェアの死活監視を組み込めます。
- 環境の統合:オンプレミスと複数クラウドを自社ルールで一つの仕組みにまとめられます。
たとえば、特定ベンダーのRAIDコントローラの状態を監視対象にできます。既製ツールの従量課金が大規模環境で割高になった企業にとって、こうした対応は既製品では代えにくい価値になります。
デメリット—極めて高い人的コストと継続的な保守負担
自社構築で継続して発生する負担は、大きく人的コストと保守の二つに分けられます。
- 人的コスト:技術者の確保や学習、構築に大きな負担がかかります。
- 保守負担:環境変更への追従と、継続的な保守費用を自社で抱えます。
ツールの選定や監視サーバーの構築、監視対象1台ごとの設定ファイル作成には、高い技術力が必要です。そのため、専門エンジニアの確保も必須で、初期構築や学習に多くの工数がかかります。作業の一つひとつが積み重なるため、構築までに時間を取られます。
物理サーバーの機種やOS、クラウドのインスタンスタイプが変わるたびに、監視設定も合わせて変える必要があります。SaaSであればベンダーが担う更新やクラウドAPIの仕様変更への対応も、自社構築では自社の責任になります。この責任の範囲は、導入の意思決定の際に見落とされがちです。
オンプレミス/クラウド混在環境での自社構築の課題
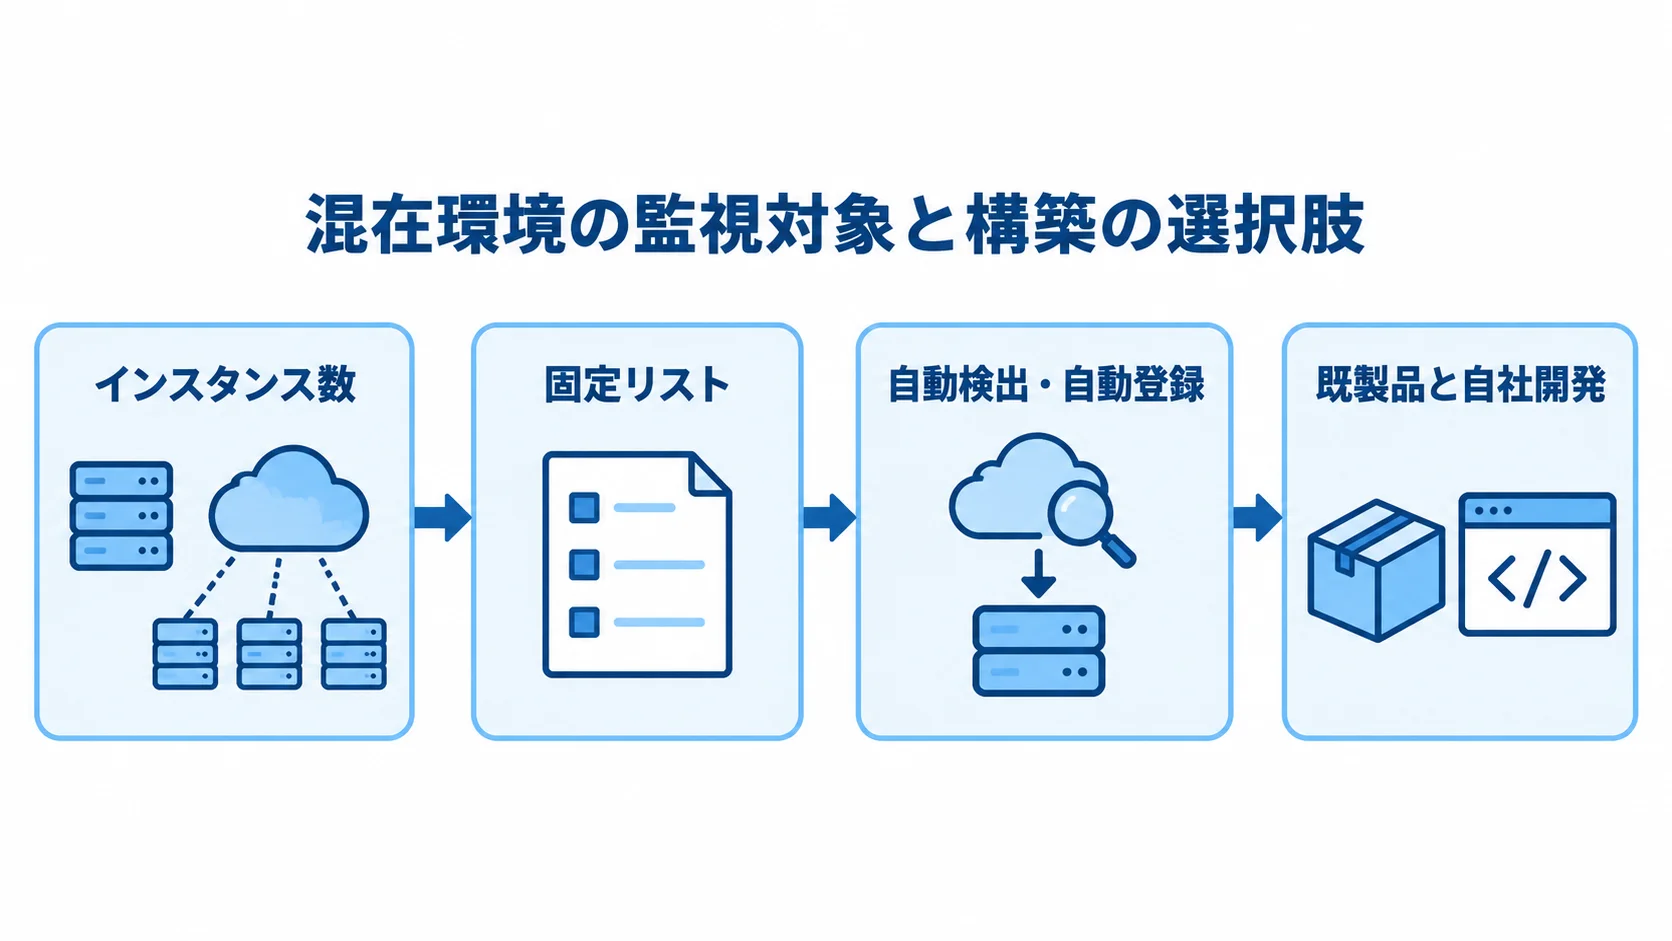
フルスクラッチで自社構築する場合、オンプレミスとクラウドが混在する環境では、設計に特に注意が必要です。そのため、この環境に固有の課題を事前に把握しておくことが、構築後の運用破綻を防ぐうえで欠かせません。
オートスケーリング対応の技術的ハードル
クラウド環境でオンプレミス向けのツールを使う場合、インスタンスの増減に合わせて監視を続けることが課題になります。
- 対象数の変動:クラウドは需要に応じてインスタンス数が動的に増減します。
- 固定管理との相性:監視対象を固定リストで扱うZabbixなどでは、EC2自動スケーリングへの対応が難しくなります。
自動追従させるには、クラウドAPIと連携する自動検出・自動登録の仕組みを独自に開発する必要があります。こうした開発には相応の技術力が求められ、片手間で実現できるものではありません。
ハイブリッド/マルチクラウド環境における現実的な選択
混在環境では、マルチクラウド対応SaaSの利用と、既製機能を活かした自社構築が選択肢になります。
- 既製SaaS:Datadogなどは複数インフラを横断して把握できる設計です。
- 独自構築:全レイヤーを作らず、既製ライブラリやOSSエージェントを活用します。
- 開発資源の集中:独自の価値を出すアラート判定や通知フローに絞る形です。
ハイブリッドやマルチクラウド環境では、マルチクラウド対応SaaSとの相性がよいとされています。統合ダッシュボードや自動検出は、独自開発では再現しにくいためです。このため、既製品と自社開発を組み合わせる進め方が現実的です。
既製SaaS型ツールとのTCO比較と実例・失敗例
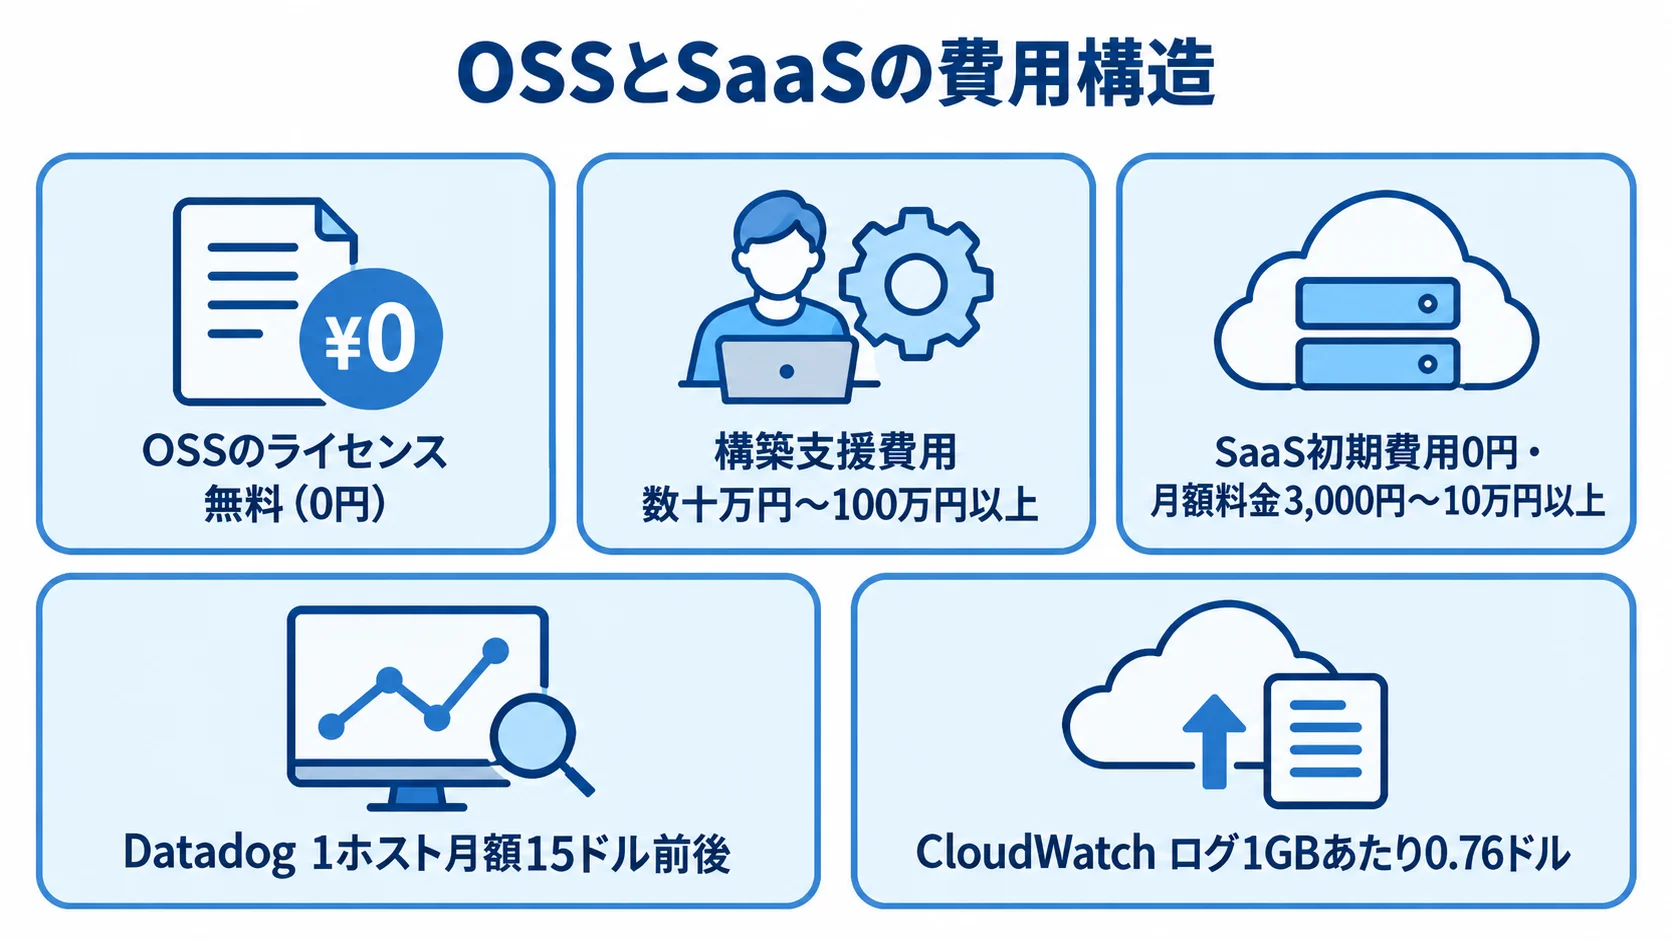
TCOでは、初期のライセンス費用だけでなく、構築・保守費用や運用人件費も含めて比較します。あわせて、費用の構造と、実際に構築を試みた事例や失敗例を見ておきましょう。
TCO比較の考え方
OSSとSaaSは、初期費用、運用費用、台数が増えたときの負担を分けて比較します。
- OSSの費用:ライセンスは無料(0円)ですが、構築・保守・トレーニング費用がかかります。
- 構築支援:大規模・高可用性の案件ではSIer費用がかかり、導入総額が数十万円〜100万円以上の場合があります。
- SaaSの相場:初期費用0円、月額3,000円〜10万円以上が目安です。
- 従量課金:Datadogは1ホスト月額15ドル前後、CloudWatchはログ1GBあたり0.76ドルなどです。
- 台数と期間:増設や長期保存でSaaSのランニングコストは膨らむ一方、OSSのライセンス費は増設しても変わりません。
数百台規模でSaaSの従量課金が月額数十万円に達する場合は、数年単位のTCOで自社構築のほうが安くなる分岐点があると考えられます。
自社構築の実例と失敗例
構築工数の実例に加えて、運用が破綻した失敗例も報告されています。運用体制とアラート設定で押さえたい注意点を見ていきます。
- 構築期間:小規模案件でZabbixの構築に約1週間かかった実例があります。
- 運用体制の失敗:未経験者中心のチームでは、設定変更のたびに専門知識が要り、エスカレーションと人件費が増えました。
- アラート設定の失敗:条件分岐のミスで重要なエラーログが通知されず、障害発見が3時間遅れました。
アラート設定の失敗の事例では、監視対象の設定ファイルや監視項目、アラートを、すべて手作業で実装しました。
技術力のあるチームが正しく設計・運用すれば、自社の要件に合った強い監視基盤になります。一方で、体制が伴わないと、障害対応の遅れやコスト増を招くリスクがあります。
フルスクラッチが向いているケース・向いていないケース
フルスクラッチには向く場合と向かない場合があるため、自社の状況に照らして見極める必要があります。
向いているケース
フルスクラッチが適しているかは、専門人材、独自要件、SaaS課金との関係で判断できます。
- 専門人材:Linux、ネットワーク、クラウドAPIに精通したチームを内製で維持できます。
- 独自要件:大規模な監視・自動化や、物理サーバー・ハイブリッド環境に合う基盤を、自社の責任で構築・運用したい企業が対象です。
- 費用:大規模環境でSaaS課金が見合わない場合は、OSSを使ってライセンス費を無料(0円)に抑えることを検討する価値があります。
向いていないケース
自社構築に向かない条件は、人材と監視規模に加えて、クラウド運用や担当者の継続性にもあります。
- 人材不足:OSS設定で本来の業務が滞る中堅・中小企業には、SaaSや外部委託が推奨されます。
- 標準的な監視:小規模で死活・リソース監視が足りる場合は、開発費や保守負担に見合う利点がありません。
- クラウド中心:AWS EC2などクラウドサーバー中心でオートスケーリングが頻繁なら、自動追従の自社開発に費用がかかるためSaaSが現実的です。
- 人員継続性:専任のインフラ・運用エンジニアを継続確保できない企業には不向きです。
担当者が退職または異動した後に、後任が独自システムを引き継げず、ブラックボックス化するリスクがあります。止められないサーバー監視では、このリスクが特に深刻です。
リスクを抑えるには、導入を決める前に、物理サーバーの世代交代やクラウド側の仕様変更に、何年にもわたって追従できる体制を保てるかを、冷静に自問しておきましょう。
まとめ
監視ツール自体をゼロから作るケースはまれで、実務ではZabbixやPrometheus + GrafanaなどのOSSを用いた自社基盤構築が中心です。
既製品では難しい物理サーバー固有の監視や、複数クラウドを統合する要件に応えられる点が、自社構築の強みです。一方で、EC2の増減への追従は難しく、高い技術力を持つ人材を継続して確保することも課題です。
専門人材を内製して独自の監視を求める企業には有力な選択肢ですが、人材が不足している企業や、クラウド中心で標準的な監視で足りる企業には、SaaSや外部委託が現実的です。
まず、自社の適性を見極め、サーバー構成や保有人材を洗い出したうえで、既製ツールと自社開発の役割を分けて、段階的に検討しましょう。そのうえで、複数の開発会社に相談しながら、最適なサーバー監視の方法を探ることをお勧めします。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。