
サーバー監視の検証は、見た目、検知・通知の動作、工数削減効果の順に確かめると、本格導入の失敗を防げます。段階ごとに何を確かめるかを押さえておくと、小さく始めて導入判断につなげられます。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
サーバー監視におけるモックアップ・プロトタイプ・PoCの違いと定義
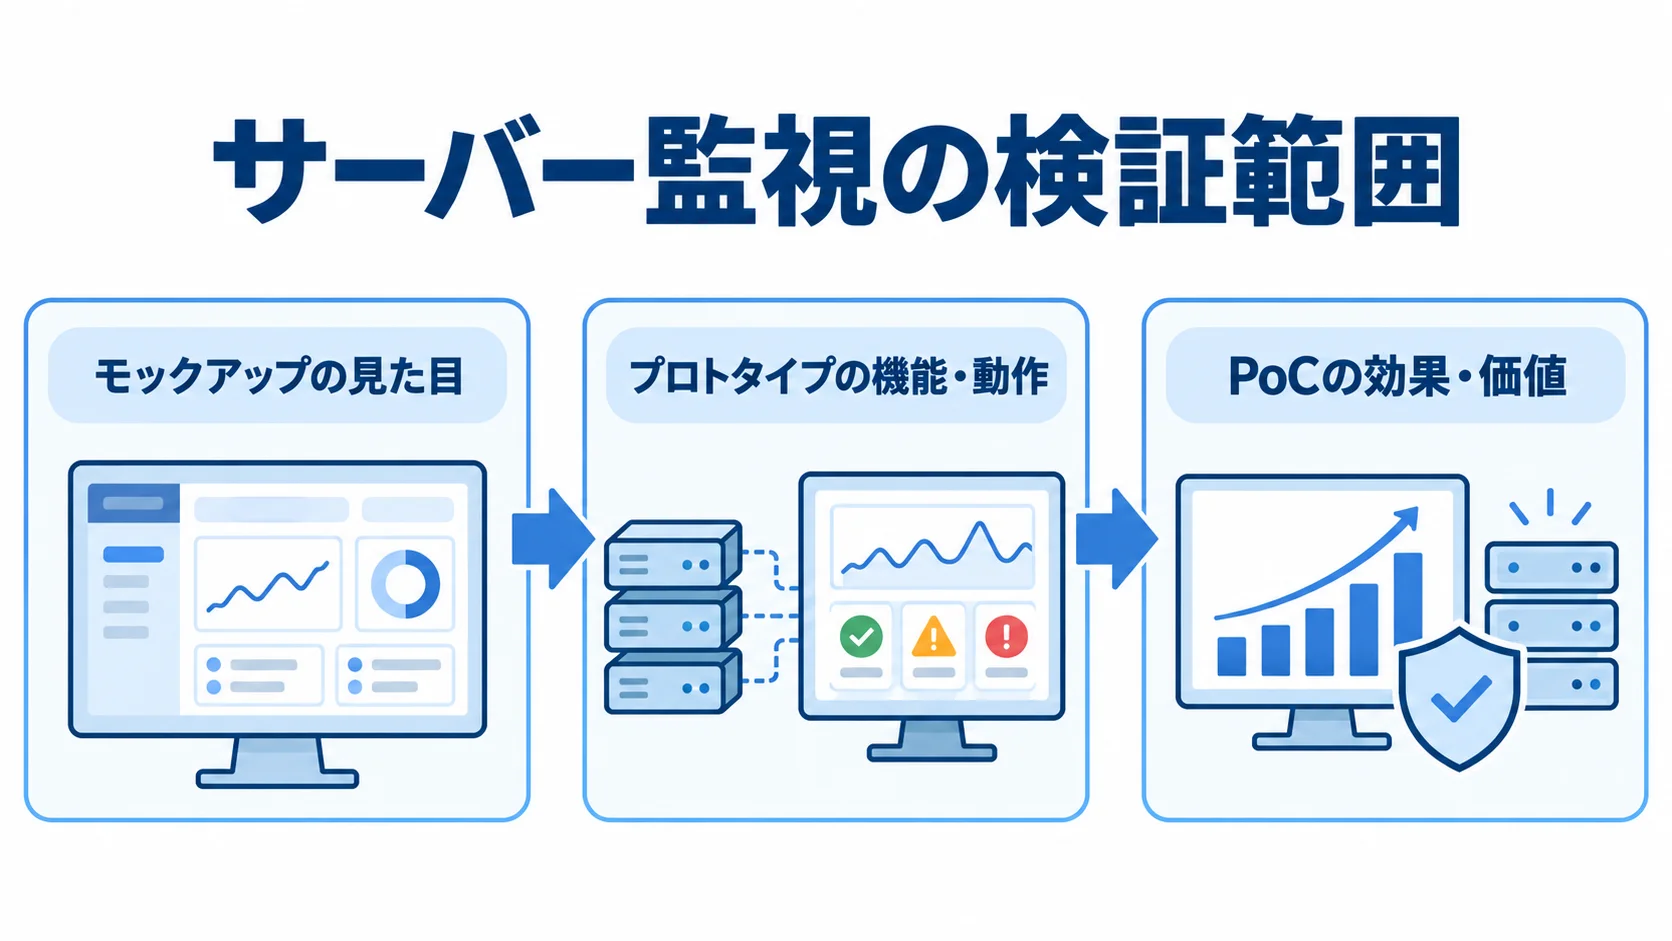
モックアップは見た目、プロトタイプは機能・動作、PoCは効果・価値を検証します。段階を踏んで確かめる範囲を広げるほど、検証の深さと再現性が増していきます。
モックアップでは、動かない画面や通知を使い、UIや文面が現場の人に見やすく伝わるかを確かめます。プロトタイプでは、一部の物理サーバーやEC2にエージェントを導入し、CPU・メモリ・ディスクの取得と、OS・ミドルウェアの死活検知を試作環境で確認します。
PoCでは、監視の自動化によって、手作業のサーバー確認工数や、障害の検知・復旧時間がどれだけ減るかを検証します。見た目の合意から一部サーバーの動作確認を経て、効果とコストを見て導入を判断する流れです。
トライアル期間の目安
SaaS型ツールでは、無料トライアルを使って自社環境で機能を確かめる方法が一般的です。たとえば、Mackerelは有料機能を2週間無料で試せます。
- Mackerel:簡単なコマンド入力で、実サーバーの監視を始められます。
- OpManager:パッケージ型で、社内の検証環境でもインストール後最短10分で監視を開始できます。
- Datadog・New Relic:トライアル中に機能制限なく、操作性や通知精度を試せます。
トライアル期間は、3段階の検証を一気通貫で進める場として使えます。最初の数日はUIと通知形式を確認し、続く1週間程度で物理サーバーやEC2にエージェントを導入して検知・通知を試します。終盤には工数削減効果を測ります。
検証段階でのツール比較の視点
オンプレミス向けのOSSとクラウドネイティブツールを並行して試すと、自社環境との適合性を比べられます。
- 物理サーバー:小規模に試す候補はZabbixです。
- AWS EC2:小規模に試す候補はCloudWatchです。
構築の手間と検知精度を比べて、対象ごとに使うツールを決めます。複数の候補を検証の初期から試すと、向き不向きが見えてくるため、本導入後の後悔を防げます。
ハイブリッド環境では、レイヤーごとに異なるツールを組み合わせて運用する前提を、検証の段階で固めておきます。使い分けのルールを先に決めておけば、導入後の現場の混乱を避けられます。
オンプレミス/クラウド(AWS EC2等)特有の検証ポイント
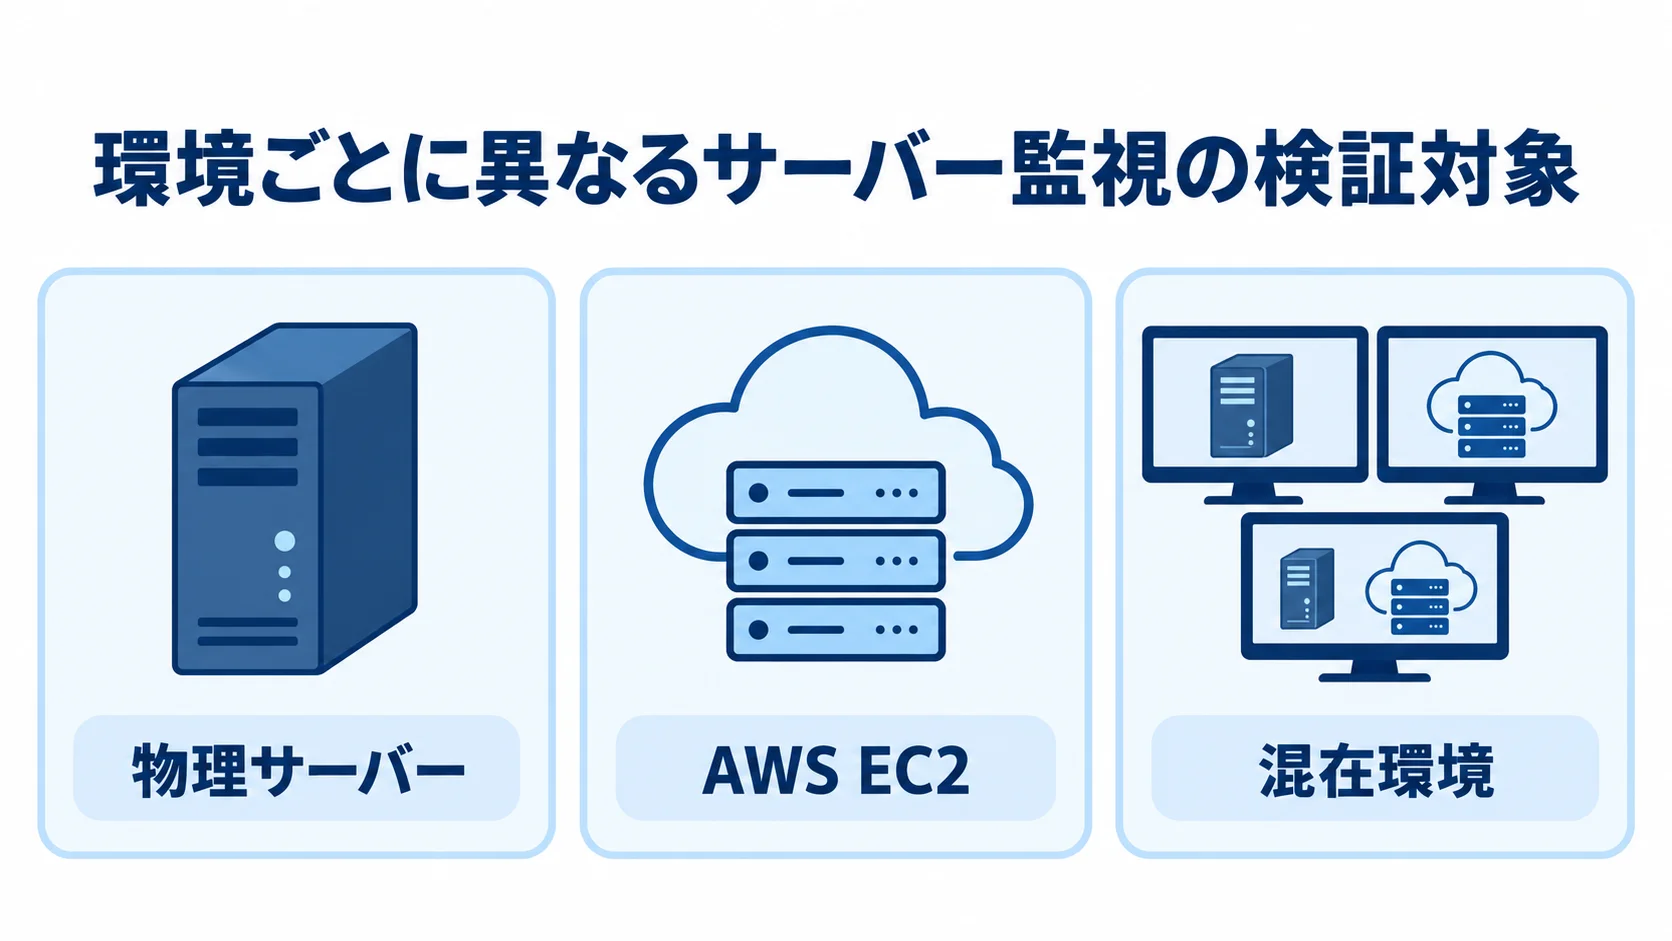
試作検証では、対象がオンプレミスの物理サーバーかクラウドのEC2かで、確認すべき点が大きく変わります。環境ごとの観点を押さえておくと、導入後に想定外のトラブルを防げます。
オンプレミス物理サーバーの検証ポイント
Zabbixなどのエージェントを対象サーバーに入れ、CPUやメモリ、ディスク使用量が正しく表示されるかを確認します。Syslogの表示とホスト名の取得も、あわせて確かめます。
- 故障予兆:ディスクのSMART情報と電源ユニットの状態を取得できるか。
- 設定工数:設定ファイルを手で記述する作業量。
- 環境の使い分け:オンプレミスとクラウドでツールを分ける必要性。
1台あたりの工数を実測しておくと、本導入時の全体スケジュールを見積もりやすくなります。また、Zabbixでクラウドの自動スケーリングに対応させる設定は、非常に面倒だとする技術的な指摘もあります。
クラウド(AWS EC2)サーバーの検証ポイント
EC2では、AWS標準のCloudWatchエージェントを対象インスタンスに導入するのが定石です。コンソール上の設定だけで約30分で監視を始められ、複数の設定を短期間で試せるのが強みです。
- 自動追従:増減したEC2が、自動で監視対象に加わるか。
- ログ量:取り込み量に応じて課金されるため、ログ量を見積もって想定外の請求を招かないかを見る。
- 横断表示:複数の監視系統を一つのダッシュボードにまとめて表示できるかを試す。
CloudWatchなどのクラウドネイティブツールは、自動追従を標準機能として備えています。一方で、Zabbixを使う場合は設定が面倒だという指摘があるため、実際にインスタンスを増減させて目視で確かめます。
さらに、物理サーバーをZabbix、クラウドをCloudWatchで監視すると、障害時に複数の画面を確認する必要が出て、初動が遅れることがあります。外部連携ツールやダッシュボードで一か所にまとめて見られるかを試し、混在環境をどう把握するかを決めます。
ダッシュボード・アラート閾値のプロトタイピング
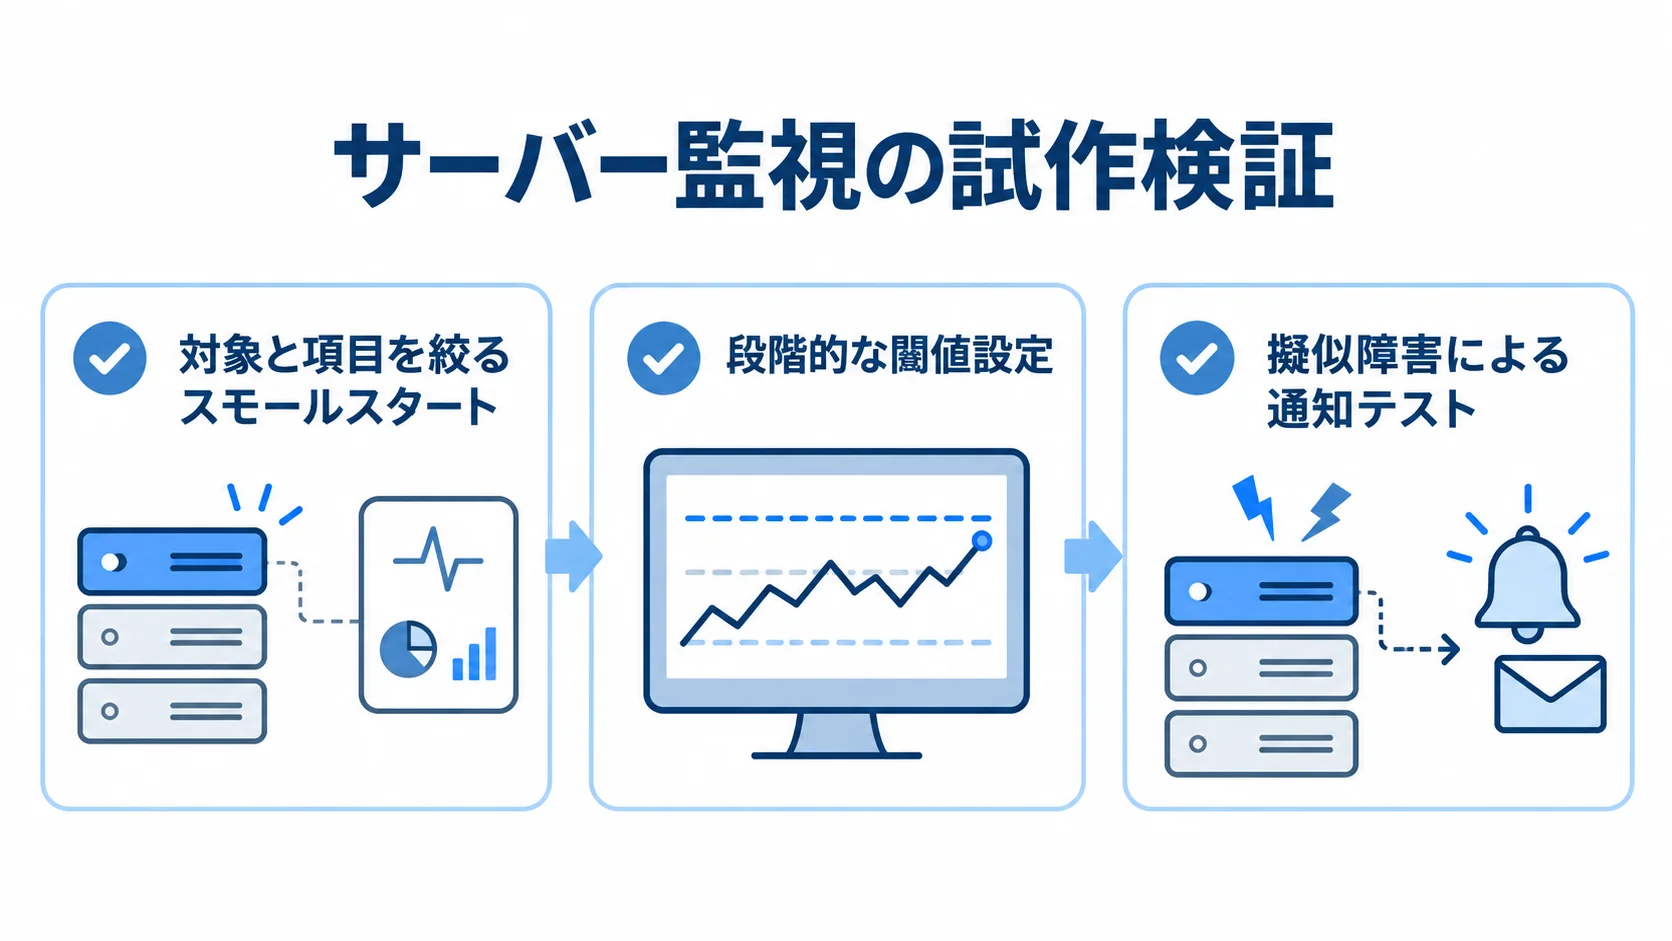
まずは対象と項目を絞るスモールスタートで、ダッシュボードの見え方と閾値を調整します。たとえば、基幹ルーターや重要サーバーなど数台を対象にします。
最初は、業務停止につながる機器の死活をPingで監視します。一度に多数のメトリクスを加えると、閾値を検証する項目が増えて、検証が長引きます。
CPUとメモリ、ディスクは、優先度の高い項目から段階的に追加します。ネットワークトラフィックは、その後に加えます。
段階的な閾値設定の具体例
閾値は一つの値で決めず、深刻度に応じて複数の段階を設けます。実際の監視サービスにある仕様を例に挙げます。
- Load Average(1CPUあたり):警告は4以上、軽度障害は8以上、重度障害は12以上。
- ディスク・Inode使用量:警告は80%超、軽度障害は90%超、重度障害は95%超。
- メールキュー:警告は500件超、軽度障害は1000件超、重度障害は2000件超。
各段階の意味は、Load Averageなら軽度遅延、重度遅延、通信断の可能性を示します。ディスクとInode、メールキューでも、同じように深刻度を分けます。
負荷を意図的にかけて通知を確かめると、通知が多すぎることや、重大な異常が埋もれてしまうことを本番前に防げます。
擬似障害による通知テスト
セットアップ後は、LANケーブルを抜いたりサービスを止めたりして、障害を意図的に起こします。
- 検知:障害をツールが正しく検知できるか。
- 通知:設定したメールやSlack、Teamsにすぐ届くかどうか。
物理サーバーだけでなく、クラウドでも同じ試験を行います。EC2上のミドルウェアを停止して、CloudWatchや試作ツールの検知と通知を確かめます。
ダッシュボードの見え方、段階的な閾値調整、擬似障害による通知テストを丁寧に行うことで、本番後にアラートが鳴らない、通知が届かないといった見落としを防げます。
本格導入への移行判断基準とよくある失敗
検証のあとで本格導入に進むか見送るかは、判断基準を事前に決めます。導入を成功させるために、よくある失敗も把握しておきます。
チームの技術レベルとの適合性という判断基準
運用担当者のスキルとツールの複雑さが合っているかは、移行判断で重要な基準になります。実際に、設定ファイルや正規表現の知識が要るZabbixを、インフラ未経験者が中心のチームに導入した例があります。
その結果、設定を変えるたびにエスカレーションが発生し、運用コストが増えたという事例が報告されています。判断にあたっては、GUIで直感的に操作でき、属人化を防げるかも見ておきます。
- 環境との親和性:特殊な仮想化基盤やIoTなど、非対応のツールもあるため、必要な項目を監視できるか。
- 拡張性:将来の監視対象の増加に耐えられるか。
- 支援体制:日本語サポートの有無。
- 検知精度・SLA:擬似障害で意図した異常を漏れなく検知できたか。
- ROI:導入・運用費用を上回る工数を削減できるか。
検知精度やSLA、ROIは、数値や条件をあらかじめ決めておきます。検証結果を見てから都合よく解釈するのを防ぐためです。
検証フェーズでよくある失敗
検証中は、条件設定の誤りや閾値の未調整、設計工数の膨張が失敗につながります。
- 条件設定ミス:「特定語を含むログのみSlack通知」などで誤設定し、重要エラーの発見が3時間遅れた例があります。
- 閾値の未調整:調整しないまま監視範囲を広げると「アラート地獄」になり、正常な通知が頻発して、重大な通知も無視されます。
- 設計の長期化:オンプレミス型や高カスタマイズ性のツールで設計に時間と人手をかけ、初期段階で検証がつまずく場合があります。
段階的な閾値設定と擬似障害テストを組み込んだうえで、現場の担当者にも確認してもらいます。通知の見た目や文面について出た意見は、取り入れます。
また、プロトタイプの段階でも擬似障害を体験してもらい、フィードバックを反映すると、失敗を避けやすくなります。
まとめ
モックアップで見た目を、プロトタイプで検知・通知の動作を、PoCで工数削減や障害の検知・復旧時間への効果を確かめます。トライアル期間も、この段階検証を進める場として使えます。
オンプレミスとEC2では確認項目が異なり、クラウドでは自動増減への追従を実機で確かめる必要があります。閾値を段階的に設定し、擬似障害で通知を試すことで、本番後の見落としを防げます。
本導入は、チームの技術レベル、検知精度・SLA、ROIを事前に定めたうえで判断します。小さく検証し、現場を巻き込んでおくことが、手戻りの抑制につながります。
全社導入にすぐ踏み切らず、小さく検証して確度を高めます。そのうえで、物理・クラウドそれぞれの特性を踏まえた手順をパートナーと設計し、手戻りを抑えた投資判断につなげます。
▼全体ガイドの記事
・ITシステムサーバー監視の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。