
Kerasのシステムは、AIモデルに加えてデータの準備や業務画面、監視までを組み合わせ、業務で使える状態にしたものです。業務KPIとデータを確かめ、PoCで検証してから本番化・運用へ進めると、AIを業務で使えます。
各テーマの詳細は、関連記事もご覧ください。
▼関連記事一覧
・Kerasのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Kerasのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Kerasのシステム開発の見積相場や費用/コスト/値段について
・Kerasのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Kerasのシステムの概要
業務で使うシステムは、AIモデルを業務で使える状態に組み立てたものです。Keras単体は、そのモデルを作るための開発基盤にあたります。
Keras 3では、JAX、TensorFlow、PyTorchの中からバックエンドを選べます(出典:Keras公式「About Keras 3」、2026年確認)。
業務パッケージではなくAI開発基盤という位置づけ
Kerasは、画像や数値、文章などからパターンを学び、分類・予測・検出を行うモデルを開発するための基盤です。販売・在庫・顧客管理の機能を備えた業務パッケージではありません。
そのため、利用企業は、データの取得元や業務画面、権限を別途設計します。通知や結果の確認手順も、あわせて決めておく必要があります。モデルだけが完成しても現場で使えない事態を避けるため、発注時には業務システム全体の設計力も確かめます。
違いを理解せずに依頼すると、学習用の画面があっても既存システムと連携できないことがあります。
Kerasのメリットと注意点
Kerasは、モデルの構造や学習処理を読みやすく記述しやすいAPIです。Sequential APIは層を順に重ね、Functional APIは複数入力や分岐、残差接続に対応します。
独自のレイヤーや学習手順は、サブクラス化によって拡張できます。一方で、簡潔なコードであっても、データ品質や業務要件を解決するわけではありません。
正解ラベルが曖昧だと精度を評価できず、学習時と本番時のデータ傾向が違えば精度は下がります。Kerasを選ぶことと、AIシステムの成功は、別々に判断する必要があります。
Kerasのシステムの活用領域と構成
活用の方法は、正解データや評価方法を用意できる業務ほど明確になります。データの性質に合わせてモデルを設計し、推論の結果を既存の業務へ組み込んでいきます。
特に大切なのは、モデルの種類を先に決めるのではなく、自動化や支援をしたい判断から逆算することです。
画像検査・異常検知への活用
外観検査では、良品と不良品の画像を学習し、傷や欠け、汚れ、形状の違いを検出できます。異常検知では、正常データを中心に学び、通常と異なる状態を知らせます。
照明やカメラの角度、製品の個体差によって判定が揺れるため、撮影条件と再学習のルールも要件に含めます。AIが不良とした画像を人が確認し、その結果を学習データへ戻す運用も有効です。
確信度が低いケースを人の確認に回せば、誤判定の影響を抑えながら導入効果を測れます。また、完全な自動化だけを目標にしない進め方もあります。
需要予測・レコメンド・文書分類への活用
販売数量や問い合わせ件数の時系列データがあれば、需要予測や人員配置を支援できます。その際は、予測日、許容誤差、外れた場合の修正担当をあらかじめ決めておきます。
顧客の閲覧履歴や購買履歴から、商品やコンテンツを提案するレコメンドにも応用できます。文書分類では、問い合わせや申請書を分類し、契約書の確認対象を抽出できます。
需要予測には平均絶対誤差、画像分類には適合率・再現率など、業務上の損失に合う評価指標を設定します。
本番システムの構成要素
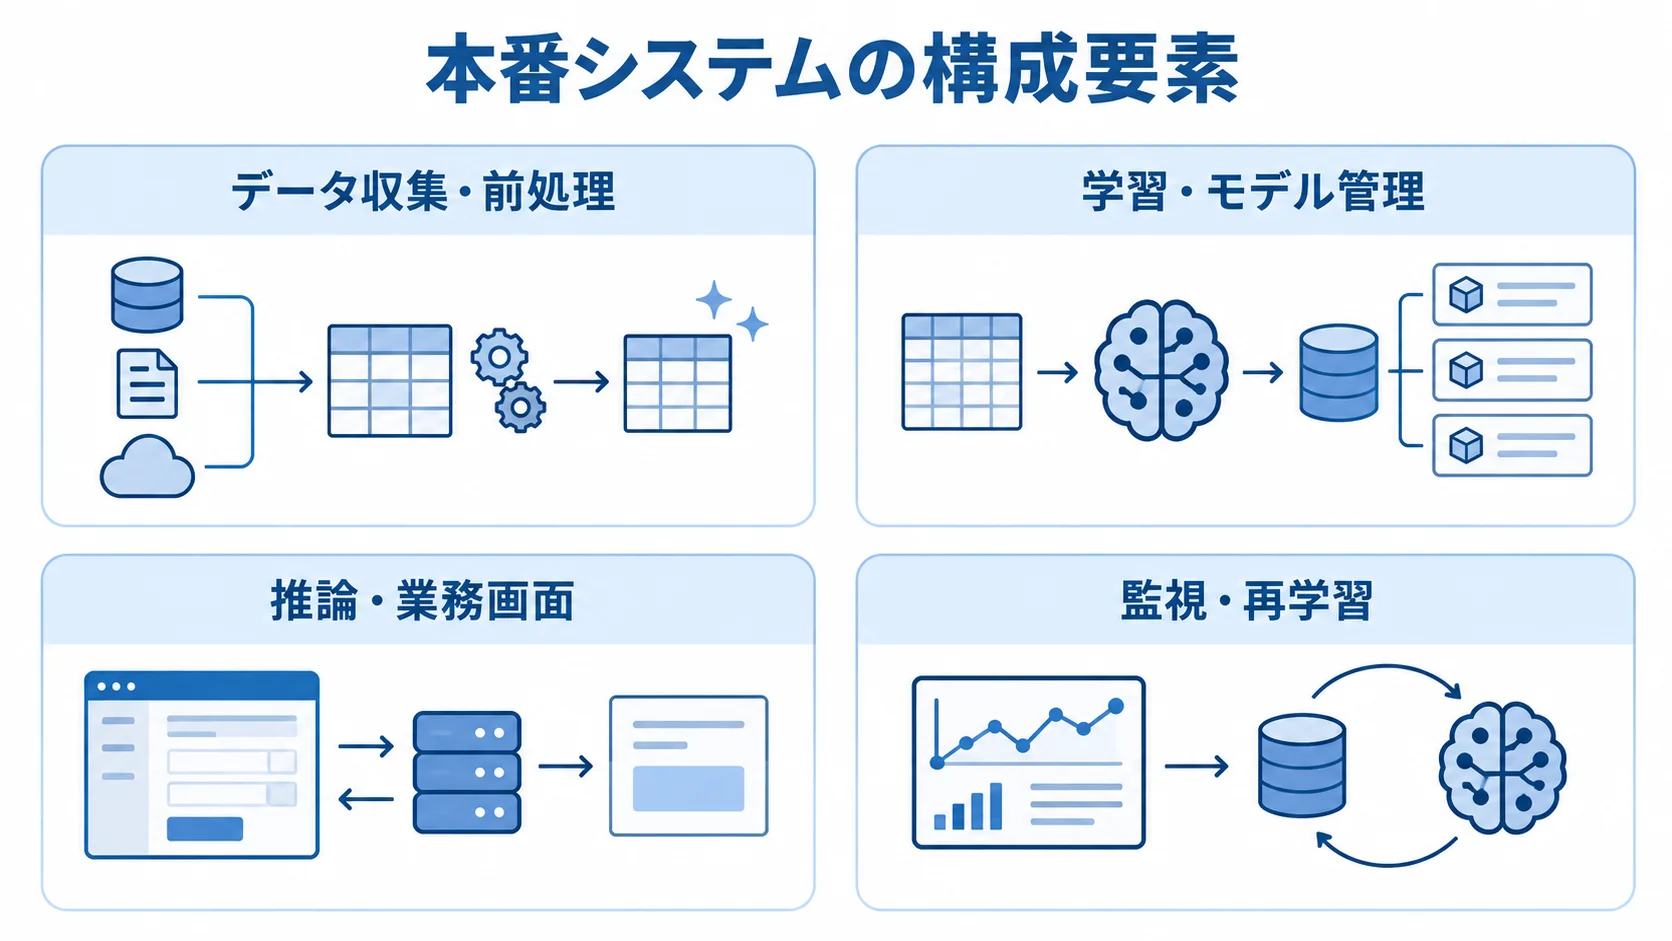
本番システムは、データの取り込みから監視・再学習までの4つの要素が、一つの流れでつながって成り立っています。
- データ収集・前処理:業務データを安全に取り込み、欠損・重複・形式の違いを整えます。
- 学習・モデル管理:実験条件と評価結果の記録、採用モデルの登録。
- 推論・業務画面:APIが判定結果と確信度を返し、画面で業務利用を支えます。
- 監視・再学習:稼働に加え、入力データの偏りと精度劣化の追跡。
業務画面には、入力値、判定日時、モデルのバージョンを表示します。担当者の確認状況も表示しておくと、後から結果を説明しやすくなります。
Keras 3と他の機械学習基盤の選び方
Keras 3は、モデルの書き方を共通化しながら、既存の資産やGPU・TPU、デプロイ先に合わせてバックエンドを選びたい場合に適しています。
バックエンドは、開発チームの経験と既存のデータパイプラインを踏まえて選びます。既存モデルの移行や本番の推論要件も、合わせて評価します。
JAX・TensorFlow・PyTorchの選び方
3つのバックエンドは、それぞれ向いている場面が異なります。既存の環境や処理要件に照らして、どれを優先するかで候補が決まります。
- JAX:高速な数値計算や大規模な並列処理を重視する場合の候補です。
- TensorFlow:既存のデータ処理や提供環境を使いたい場合に検討できます。
- PyTorch:研究コードやデータローダーとの接続を重視する場合に向く基盤です。
Keras 3は標準レイヤーで共通化しやすい一方で、専用処理や独自演算が増えると移植性が下がります。同じ検証データを使い、学習時間や推論速度を比べます。メモリ使用量と再現性も、あわせて確認します。
将来バックエンドを変える可能性があるなら、共通APIを使い、依存ライブラリとバージョンを固定しておきます。代表的なモデルで移行テストも行います。
学習済みモデルと独自モデルの使い分け
モデルの選び方は、学習データの量と、自社データへの依存度によって変わります。
- 学習済みモデル:データが十分でない場合に、追加学習の候補になります。
- 独自モデル:自社の画像や文章に強く依存する場合に適しています。
Keras 3には、画像、自然言語、音声向けの事前学習モデルなどがあり、初期検証を短縮できる可能性があります(出典:Keras 3公式ページ、2026年確認)。
利用するときは、ライセンスや学習データの由来を確かめ、商用利用と再配布の条件も確認します。
独自モデルでは、追加データの収集とラベル付けに費用がかかります。必要な精度とデータの入手しやすさをもとに選びます。
Kerasのシステム開発の進め方
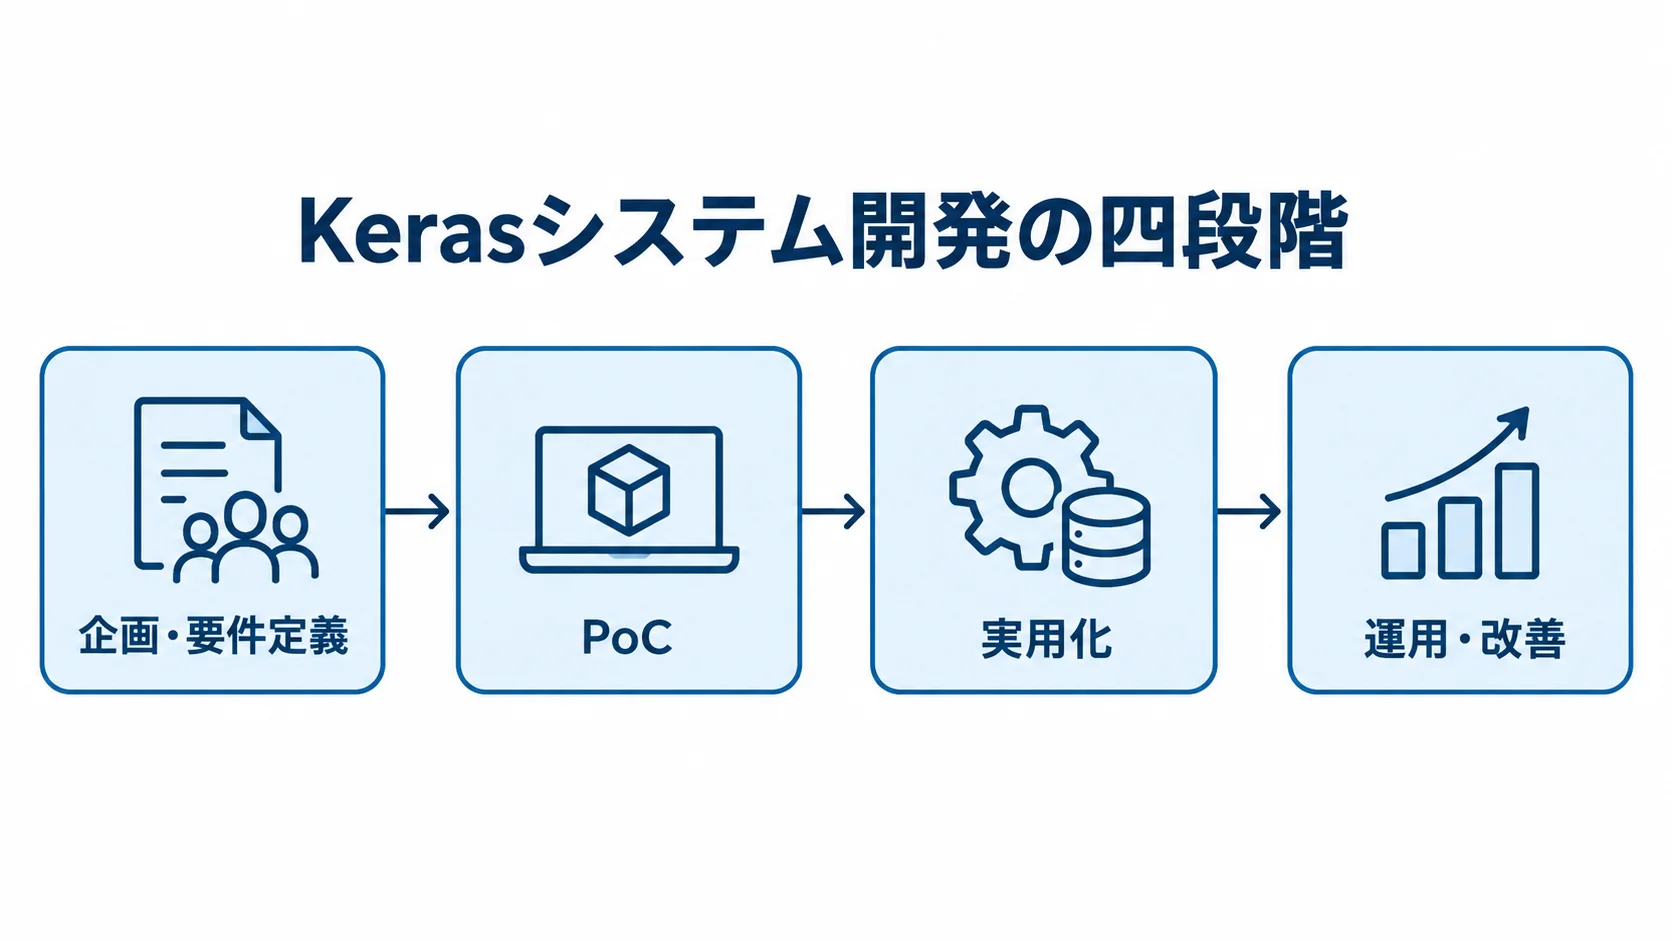
開発は、目的とKPIを決める企画、データとモデルを検証するPoC、本番システムを作る実用化、運用・改善の四段階に分けて考えられます。
精度だけをPoCで確かめ、連携やセキュリティを後から加える進め方ではなく、本番化の条件を早い段階で定めます。
企画・要件定義での業務KPIとデータの決め方
企画では、予測・分類・検出する対象、結果を使う人と時点、削減したい時間を文章にします。たとえば、検査時間を半分にする、問い合わせの一次分類を一定割合自動化する、欠品を減らすといった形で、業務KPIに落とし込みます。
また、正解ラベルや許容できる誤判定を決めます。AIが判断できない場合の人手による確認手順も、あわせて決めておきます。
データは件数だけで判断せず、期間や欠損、重複の状況を確かめます。ラベルの一貫性や、個人情報・機密情報が含まれるかも確認します。データを取り出せない、ラベル担当者がいない、過去と現在の業務が違うといった場合は、モデル開発より先にデータ整備を計画します。
PoCでの小さな検証と継続条件
PoCでは、課題を絞り込み、比べられるデータと基準を用意してから検証します。
- 代表的なデータを使い、一つの業務課題に絞って、簡易な手法とKerasのモデルを比べます。
- 評価データは学習に混ぜず、現場の偏りのほか、応答時間や処理件数も測ります。
- コードとデータ定義、評価結果を成果物に含め、再現手順と残課題も加えます。
終了時には、続行・再設計・中止の基準を数値で確認します。再現率が目標に届かない場合は追加データを集め、応答時間が規定を超える場合はモデルを軽量化します。
業務効果が小さい場合には、画面や運用を見直します。モデルが動いたことだけで、PoCの成功と見なさないことが大切です。
本番化でのAPI・認証・監視・再学習の組み込み
本番化では、業務システムとの連携、判断時の確認、継続的な監視と更新を設計します。
- APIと認証:業務画面などとつなぐ際の権限設定と、障害時の対応。
- 人による確認:業務判断に影響する結果を、確定前に確認できる仕組み。
- 監視と再学習:稼働状況と入力傾向の追跡、必要に応じた再評価。
APIには、利用者ごとの権限と入力検証を設けます。タイムアウトや再試行の扱い、障害時の代替手順、操作ログも決めておきます。
監視対象は精度と入力分布、欠損率です。推論件数や処理時間、エラー率も、あわせて追います。正解の結果を回収できる場合は、月次や四半期などの周期で再評価します。
再学習したモデルを本番へ反映する前に、承認手順を作っておきます。モデルとコードは、依存ライブラリや設定値と一緒に管理し、以前のモデルへ戻せる状態を保ちます。
Kerasのシステム開発費用の目安
Keras自体のライセンス費用は基本的に不要です。ただし、AIシステム全体の開発費はかかります。
Kerasだけを対象にした公的な統計は確認できません。そのため、以下の金額は、2025〜2026年に公開されたAI・業務システムの相場を工程に当てはめた推定です。
実際の金額は、データ量や連携数、精度要件によって変わります。セキュリティや運用体制も、金額を左右します。
▶ 詳細はこちら:Kerasのシステム開発の見積相場や費用/コスト/値段について
規模別の費用と期間の目安
金額と期間は、小規模な検証から本番規模の開発まで、段階によって大きく変わります。ここに示す範囲は、開発規模ごとの目安です。
- 小規模PoC:100万〜500万円、期間は1〜3か月です。
- 実用化・中規模:500万〜1,500万円、期間は3〜6か月程度です。
- 本番・大規模:1,500万〜5,000万円以上、期間は6〜12か月以上になる可能性があります。
小規模PoCでは、データの確認と前処理、1モデルの学習を想定し、評価画面と限定的な推論APIも加えます。実用化では、データ加工とモデル改善を進めたうえで、業務画面や既存連携、権限・ログを加えます。
大規模では、複数のモデルや拠点を扱うことや、高可用性と監査ログが加わる場合があります。さらに、再学習や厳格なセキュリティ、基幹連携が必要になることもあります。
一般的なAI開発の相場も、数百万円から数千万円まで幅があります(出典:2025〜2026年公開のAI開発費用相場、複数資料を比較した推定)。
費用の内訳とランニングコストの分け方
初期費用と運用費は分けて考え、固定費と従量費の違いも確認します。
- 初期費用:企画・要件定義、データ準備・設計、開発・実装、テスト・リリースが含まれます。
- 運用費:クラウド、GPU、ストレージ、監視、脆弱性対応、再学習、問い合わせ、障害対応が含まれます。
初期費用の配分の目安は、企画・要件定義が10〜12%、データ準備・設計が22〜24%です。モデル開発・アプリ実装は48〜50%、テストは15〜17%程度になります。ただし、固定の比率ではなく、見積もりを比べる際の目安として使います。
保守費は、初期開発費の年15〜25%程度を目安に置く方法があります。なお、再学習の頻度やサポート時間によって変わります。
学習時だけGPUを使う構成と、常時推論する構成では料金が異なります。そのため、月額の固定費と従量費を分けて考えます。
Kerasのシステム開発会社・ベンダーの選び方
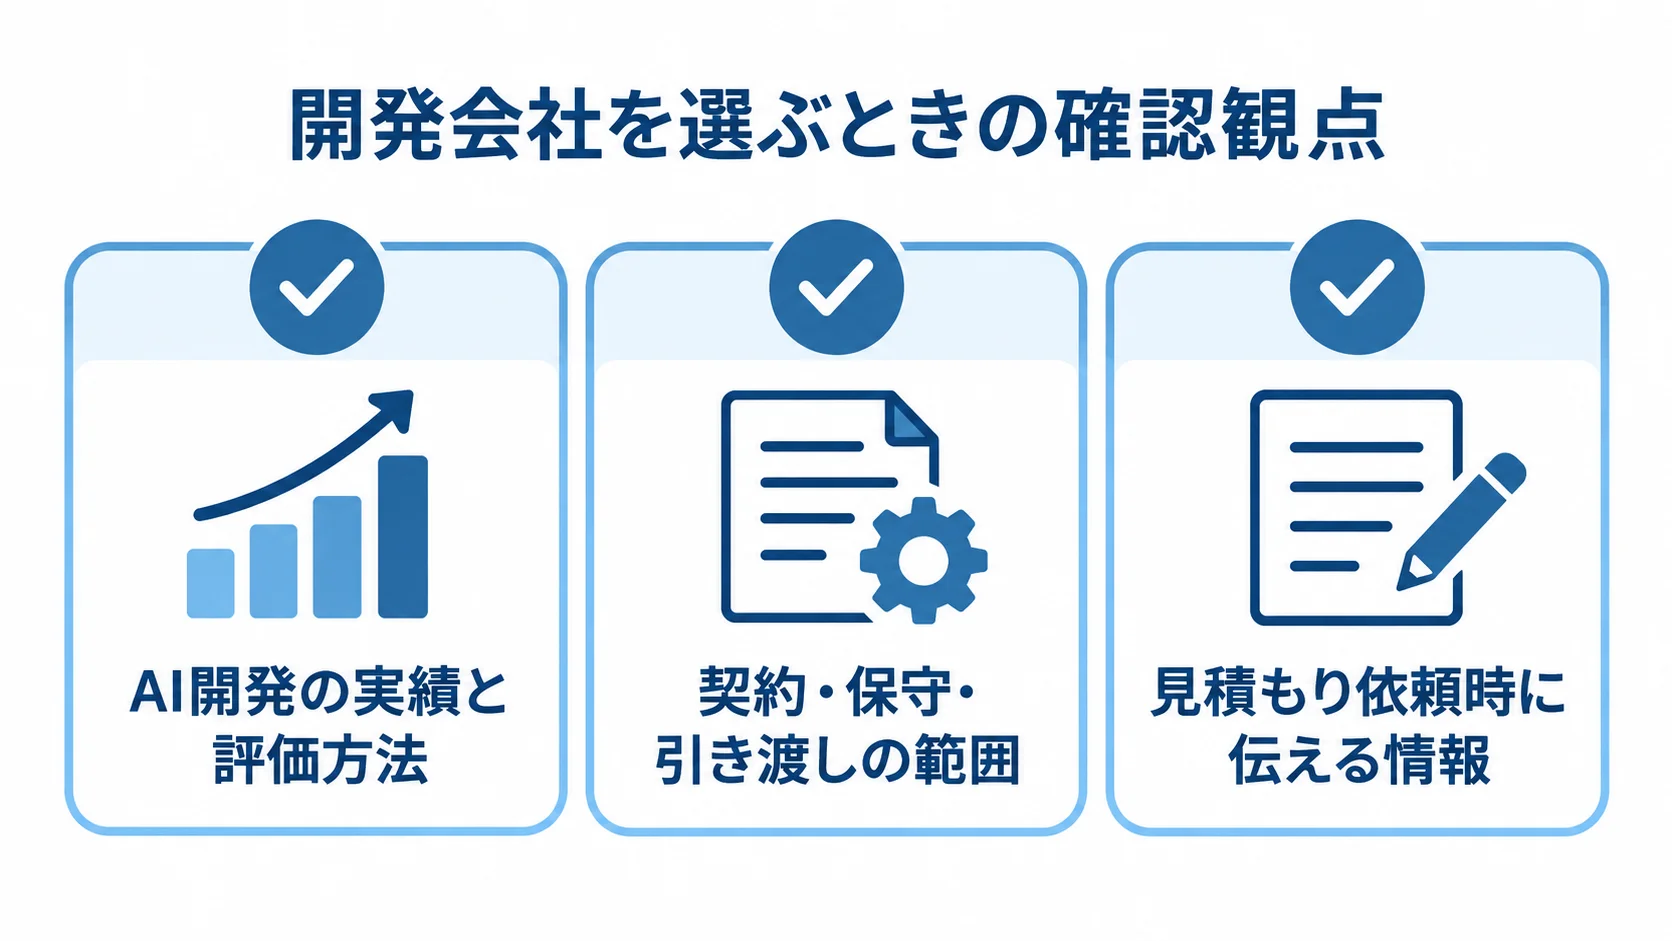
開発先は、Kerasの実装力に加えて、業務課題の定義、データ整備、本番運用まで担えるかどうかで選びます。
企業名や実績の多さは参考にしつつ、提案への回答と成果物の範囲を比べます。保守体制や、契約でどこまでを誰が受け持つかも、あわせて見ます。
AI開発の実績と評価方法
実績の中身と、技術の選び方を説明できるかを確かめます。
- 実績:データの種類、モデルの目的、評価指標を見たうえで、本番利用と導入後の改善まで確かめます。
- 提案内容:利用技術の理由と、変更時の影響を説明できるかどうか。
匿名化した画面や評価レポートを見せてもらい、PoCから本番へ移行した経験を尋ねます。ただし、Keras案件でも同じ業務やデータ形式で再現できるとは限らないため、類似性も確かめます。
提案書には、Kerasのバージョン、バックエンド、学習・推論環境を明記してもらいます。データの保管場所や評価方法も、あわせて書いてもらいます。納品物と再学習の扱いも、提案書に入れてもらいます。
別のバックエンドやモデルへ変える場合の影響も分かれば、将来の選択肢を残せます。
契約・保守・引き渡しの範囲の明文化
納品物に含める範囲として、ソースコードやモデルファイル、学習済み重みを確認します。学習データやラベル定義も、納品物に含めるかを確かめます。環境・インフラ設定、テスト結果、操作手順についても、範囲を決めておきます。
第三者ライブラリや学習済みモデルを使う場合は、商用利用と改変、再配布の条件を確認します。契約終了後の利用条件も、あわせて確かめます。
保守では、精度劣化の検知や再学習の回数、脆弱性対応の時間を定めます。障害連絡先やバックアップ、復旧目標も決めておきます。判定ミスの調査担当や、ログをもとにした再発防止も、責任の範囲に含めます。
見積もり依頼時に伝える情報
相見積もりで条件をそろえるため、依頼時に伝える情報を整理します。
- 業務条件:目的、対象業務、利用者数、希望納期
- データ条件:件数、期間、ラベルの有無、機密情報の扱い
- システム条件:希望精度、許容応答時間、既存システムの情報
データをすぐ渡せない場合は、サンプルや項目一覧、匿名化した分布を用意します。「Keras必須」とする場合は、バックエンドを固定する理由や、別の方式との差も確認します。
業務成果を優先するなら、Kerasを使わない選択肢も比べてみます。費用や運用負担が、業務に見合った水準に収まる場合があります。
▶ 詳細はこちら:Kerasのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Kerasのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:Kerasのシステム開発の発注/外注/依頼/委託方法について
Kerasのシステムに必要なセキュリティと法務対策
AIシステムでは、Webセキュリティに加えて、学習データやモデルファイル、推論結果を守る必要があります。また、利用目的やデータの権利は設計と契約に反映し、誤判定への対応と委託先の責任も、あわせて決めておきます。
経済産業省が2026年3月に公開した「AI事業者ガイドライン第1.2版」は、リスクに基づいてAIの開発・提供・利用を管理する考え方を示しています(出典:経済産業省「AI事業者ガイドライン第1.2版」、2026年)。
モデルファイルと依存環境の安全な管理
モデルの出所と実行環境を確認し、システム側の安全対策も整えます。
- モデルの確認:提供元、ハッシュ値、署名、利用目的の確認
- 環境の固定:関連ソフトのバージョン固定と、各環境の再現
- システム保護:権限や秘密情報、通信、ログの適切な管理
信頼できないファイルは、本番で無条件に読み込まないようにします。
Kerasのリリース情報には、モデル読み込みやHDF5関連の修正が含まれています。そのため、本体と周辺ライブラリの更新方針を定めておきます(出典:Keras公式リリース一覧、2025〜2026年確認)。
Python、Keras、バックエンドのバージョンを固定します。GPUドライバとCUDAも固定して、開発・検証・本番の環境を再現できるようにします。
脆弱性スキャンや最小権限の付与も行います。秘密情報とネットワークの分離、ログの改ざん防止も、あわせて進めます。IPAは2026年に、AI利用者・開発者向けの情報を更新しています(出典:IPA「AIセキュリティ」、2026年確認)。
データの権利と説明可能性
データの権利と、AIの判断に関する説明や確認の仕組みを整えます。
- データ利用:収集や利用の条件の確認と、委託契約への反映
- 重要な判断:判断根拠、人の確認、異議申立てや訂正の手段の整備
個人情報や顧客情報、画像、文章、第三者の著作物を扱う場合は、収集目的や利用範囲、保存期間を確かめます。第三者提供や削除方法も、あわせて確認します。外部に委託する場合は、再委託の可否と、契約終了後の返却・消去も明記します。
人事、与信、医療、安全などの判断では、利用者に確信度や参考情報を示します。説明の程度は、用途のリスクと利用者の役割に合わせて決め、誤判定の影響を抑えます。
よくある質問(FAQ)
発注前によくある疑問に、費用や必要なデータ、開発会社への依頼、本番運用の面から直接答えます。
Kerasは無料で使えるので開発費も安くなりますか?
Kerasはオープンソースで、ライセンス費用は基本的にかかりません。ただし、開発費は別に必要です。
データ準備やモデル開発には費用がかかります。画面やAPI、テストの費用も必要になります。
さらに、クラウドや監視、保守にも費用がかかります。そのため、ライセンス費用と業務システム全体の開発・運用費は分けて考えます。
Kerasのシステム開発にはどのくらいのデータが必要ですか?
必要な件数は、画像のばらつきや分類数、異常の頻度によって変わります。目標精度やモデルの複雑さでも変わるため、一律には決められません。
代表データを抽出し、ラベル品質と分布を確認したうえで、小規模な検証により必要量を見積もります。異常データが少ない場合は、正常データ中心の検知と人の確認を組み合わせる方法もあります。
PoCだけを依頼しても本番システムへ移行できますか?
移行はできます。ただし、PoCの段階から本番化の条件を合意しておく必要があります。
コードの再現手順やデータ定義、評価結果を成果物に含めると、作り直しを減らせます。API仕様やモデル保存形式、監視項目、権限、ログも、あわせて含めておけます。
PoCと本番でデータが異なる場合は、本番用の検証期間を別に確保します。
KerasとTensorFlowやPyTorchはどちらを選ぶべきですか?
常に優れた一方があるとは限りません。判断では、既存資産や担当者の経験、データ処理を見ます。GPU環境や推論要件も、あわせて検討します。
Keras 3は複数のバックエンドを選べるため、Keras APIでモデルを共通化しながら比較できます。代表モデルで性能と保守性を検証し、将来の移行コストも含めて判断します。
まとめ
Kerasのシステムは、モデルだけでなく、データ基盤や推論API、業務画面を組み合わせて、業務で使える状態になります。認証やログの管理、監視と再学習も、あわせて設計することが大切です。
Keras 3では、JAX、TensorFlow、PyTorchの中からバックエンドを選べます。成功を左右するのは、業務KPIとデータ品質、誤判定時の運用、本番化を見据えた設計です。
Kerasのシステム設計の要点
費用は、ライセンス料だけでなく、データ準備からセキュリティ、保守までを合算して考えます。小規模PoCで検証してから、本番化の条件を明確にして進める方法もあります。
本文で示した目安では、小規模PoCが100万〜500万円、実用化が500万〜1,500万円、大規模開発が1,500万〜5,000万円以上です。
開発先は、評価指標やAPI、監視の面から比べます。契約や引き渡し、再学習の扱いも、あわせて比較します。
最初に整理するチェック項目
着手前には、目的とKPI、対象データ、正解ラベルを整理します。評価指標や、誤判定時の人手確認も決めておきます。
推論APIやログ、再学習の方法に加えて、権利とSLAも確認項目に入れます。
整理した情報があれば、Kerasが適するか、別の方式がよいか、PoCから本番までの見積もりに何を含めるかを比べられます。
▼関連記事一覧
・Kerasのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Kerasのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Kerasのシステム開発の見積相場や費用/コスト/値段について
・Kerasのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。