
Kerasのシステム開発は、業務の課題を整理するところから始まり、技術の選定、設計・開発、テストを経て、段階的に稼働させ、運用に定着させるまで、6つの段階で進みます。Kerasが担うのはモデル部分なので、データ連携や業務画面、運用の仕組みも同時に整える必要があります。
▼全体ガイドの記事
・Kerasのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Kerasのシステムの全体像
Kerasのシステムとは、Kerasで開発したモデルを、業務で安全かつ継続的に使う仕組みのことです。Kerasをインストールしただけでは、この状態にはなりません。
Kerasは、ニューラルネットワークの構築、学習、評価、推論を扱うPython製のディープラーニングAPIです。業務画面やデータ連携を単体で提供するパッケージではありません。そのため、それらはKerasとは別に用意する必要があります。
Kerasが担う役割と向いている業務
Kerasを適用する業務は、扱うデータと解決したい課題を基に決めます。
- 画像処理:画像分類、外観検査、異常検知
- 予測・推薦:需要予測、レコメンド
- 言語・音声:文書分類、音声・自然言語処理
たとえば、製造現場で不良候補を画像から検出する場合は、モデルを作るほかに、業務として回る仕組みが要ります。画像の収集とラベル付けのほか、結果を確認する画面や担当者の承認も必要です。さらに、検査履歴の保存も欠かせません。
Keras 3は、JAX、TensorFlow、PyTorchをバックエンドに選べるマルチフレームワークAPIです。公式情報では、fit、evaluate、predictが、NumPyやPandasのほか、tf.dataやPyTorchのDataLoaderにも対応します(出典:Keras公式「About Keras 3」、2026年確認)。
既存のGPU環境や社内の技術資産に合わせて選べるのは利点ですが、依存関係や性能を検証する責任は残ります。
本番システムを構成する周辺機能
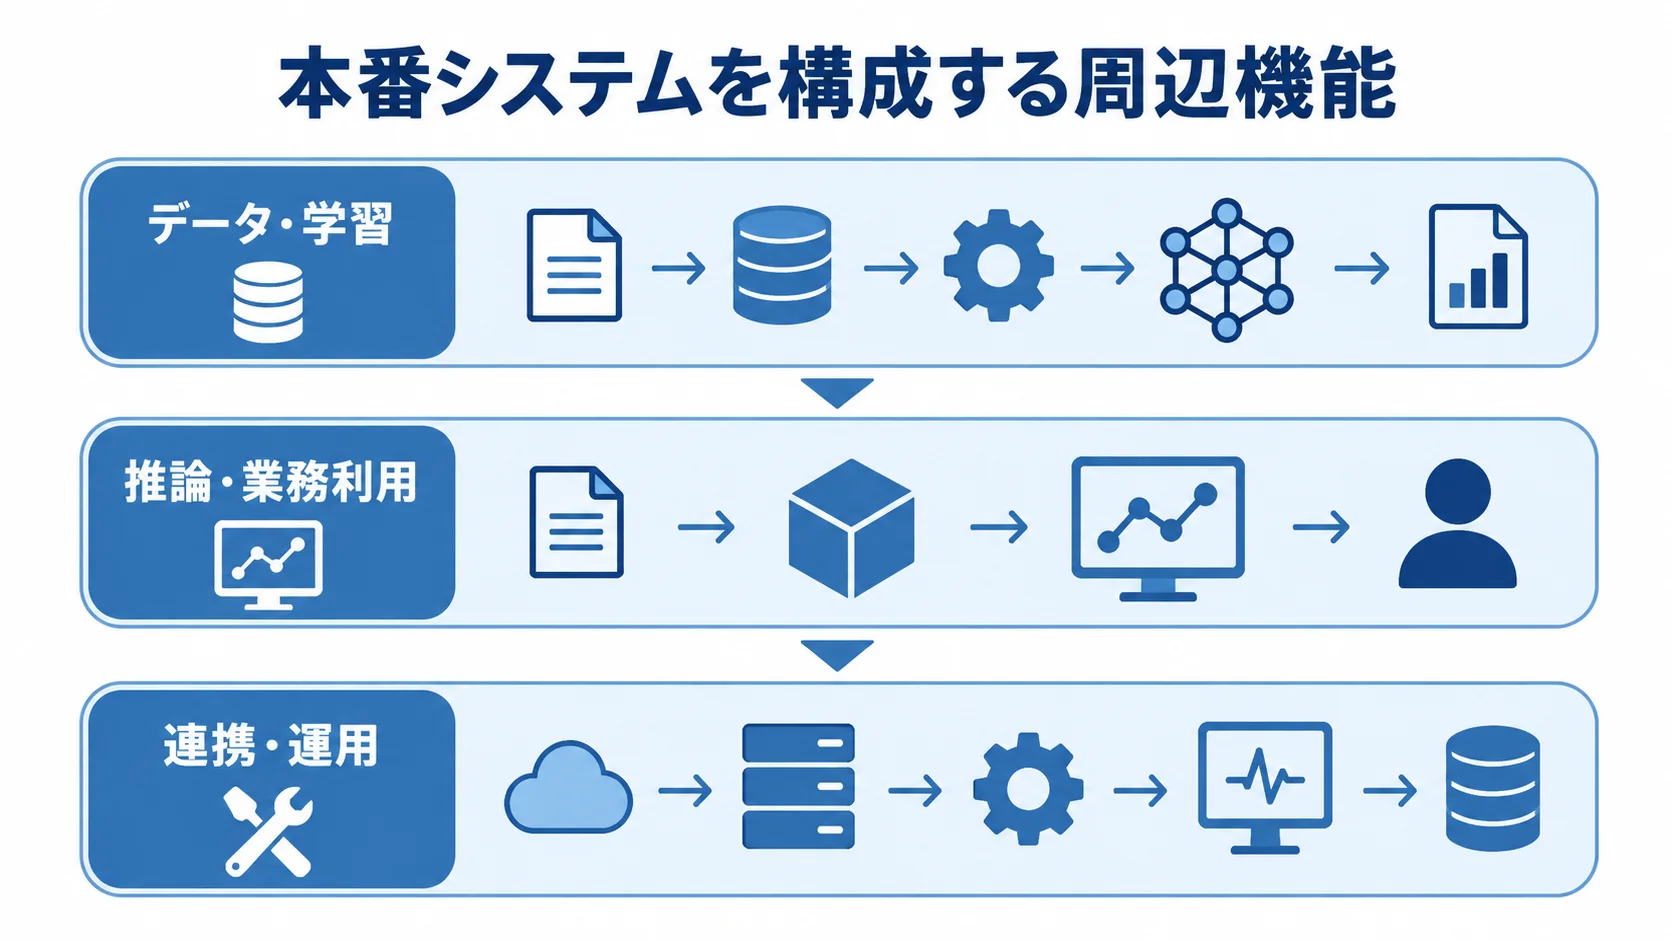
モデルを本番業務で使い続けるには、データ処理から監視まで、一連の構成を整える必要があります。
- データ・学習:データ収集、ETL、学習用データセット
- 推論・業務利用:Kerasモデル、モデルレジストリ、推論API、業務画面
- 連携・運用:ERPやCRM連携、監視、再学習基盤
データが届かない、応答が遅い、結果を確認されない状態では、モデルの精度が高くても業務システムとして機能しません。さらに、更新後の精度低下を検知する監視も必要です。
開発の出発点は、どの業務判断を、どのデータで、どれだけ改善するかです。Kerasを使うかどうかは、その答えを基に決めます。
次に、モデル候補はPoCで比べます。本番では、認証や権限、監査ログのほか、障害時の手動運用やモデルの差し替え方法も決めておきます。
Kerasのシステム開発の進め方と6フェーズ
開発は、要件整理から始めて、選定、設計・開発の順に進みます。その後は、次の3段階を順に進みます。
- テスト:業務データで精度・性能・安全性を検証する
- 稼働:段階リリースと手動への切り替えを準備する
- 定着:再学習と現場改善を運用に組み込む
各フェーズで残すものと判断基準を先に定めておくと、モデルの精度だけを追って業務導入が遅れる事態を防げます。
1. 要件整理:AIで解く業務とKPIの定義
まず、対象業務の現状と改善目標を言語化します。AIを導入すること自体は目的にならないため、何を改善したいのかを、まず言葉にしておきます。
KPIは、たとえば次のように決めます。
- 検査時間:検査員1人あたりの確認時間を30%短縮
- 欠品率:需要予測によって一定水準まで下げる
- 問い合わせ分類:担当者の確認付きで一次振り分けを自動化
正解ラベルがない業務では、ラベルをどう作り、その費用をどれくらい見込むかも要件に含めます。入力データについては、種類と件数を押さえたうえで、欠損や偏り、個人情報・営業秘密の有無も確認します。
さらに、正解ラベルの定義と、許容できる誤検知や見逃しの範囲を決めます。目標精度や応答時間、利用者と権限も、この段階で定めます。誤判定が出たときの人手確認と、既存システムとの連携方法も対象になります。
PoCの合否条件を先に決めておくと、「精度が良さそう」といった曖昧な評価を避けられます。
2. 選定:Keras・バックエンド・開発会社の比較
まず、既存のSaaSやAI APIで解決できるかを確かめます。そのうえで、独自モデルが必要な範囲だけをKerasで開発します。
- バックエンド:JAX、TensorFlow、PyTorchから選ぶ
- 運用体制:社内で運用を担える人材の有無
- 実行環境:GPUやデプロイ先への対応の有無
「流行しているから」という理由は選定の根拠として弱いため、業務要件との適合で説明できるようにします。開発会社には、Kerasの実績に加えて、データ品質調査、アノテーション設計、推論APIの経験を確かめます。さらに、MLOpsへの対応力も見ます。
セキュリティや業務画面、保守について、どこまで対応できるかも見ておきます。クラウドGPUの利用も含めて確かめます。提案書には、バックエンドの種類、モデルの評価指標、再学習の手順を明記してもらいます。
ソースコードやモデルファイル、環境設定の引き渡しは、どこまでかを確かめます。再委託の有無や、障害時のSLAも押さえておきます。
3. 設計・開発:モデルと業務システムの分離
学習と推論を分けておくと、モデルを更新した後も、どの工程で何が起きたかをたどれる構成にできます。さらに、業務アプリからモデルの内部実装を直接呼び出さない構成にしておくと、バックエンドやモデルを後から変更しやすくなります。
- データ処理:取り込み、前処理、学習、評価
- モデル管理:登録、承認、デプロイ
- 業務利用:推論結果を保存し、認証済みAPIで連携
開発中は、精度に加えて、処理時間やメモリ使用量、同時実行数を測ります。再試行、タイムアウト、ログの粒度も測定の対象です。判断理由の説明が必要な場合は、特徴量や判定根拠の表示方法も決めます。
データとモデルのバージョンを追えるようにし、学習データや承認者、本番反映の日時を記録します。
4. テスト:業務データによる精度・性能・安全性の検証
実運用で起きる欠損や季節変動も含めて、入力条件と評価方法を確かめます。
- 入力の違い:形式の違い、境界事例を試す
- 評価指標:適合率、再現率、F1スコア、混同行列など
- 安全性:情報保護、権限、依存ライブラリを調べる
見逃しが重大な不良検出では再現率を重視します。一方で、確認工数が問題となる分類では適合率を重く見るなど、誤りのコストに指標を合わせます。
セキュリティでは、個人情報のマスキングと、保存・通信の暗号化を確かめます。最小権限や管理者操作の監査ログも対象です。さらに、依存ライブラリの脆弱性やモデルファイルの改ざんも調べます。
Keras公式のリリース情報では、問題への修正が案内されています(出典:Keras公式リリース情報、2025〜2026年確認)。対象には、safe_modeや外部SavedModelのほか、HDF5の外部リンクや悪意あるメタデータに関する問題も含まれます。
信頼できないモデルファイルを無条件に読み込まないルールも、テストで確かめます。
5. 稼働:段階リリースと手動fallbackの準備
本番稼働は、まず対象部署や処理件数を絞って始めます。そのほか、初期はAI判定を参考表示にとどめ、担当者の承認後に業務を確定するシャドーモードも有効です。
- 段階リリース:利用範囲を限定してから広げる
- 手動への切り替え:想定外入力、API停止、精度低下、GPU不足時に従来の手作業へ戻す手順と責任者を決める
稼働の可否は、KPIの達成度やエラー率、応答時間を見て判断します。利用率や問い合わせ件数、手動修正率も併せて確認します。
ログに入力データをそのまま残すかどうかは、必要性と保管期間を基に決めます。
クラウドを使う場合は、学習のときだけGPUを確保し、推論はCPUやスケール設定も含めて比べます。そのため、使っていない時間の費用を抑えられる場合があります。
AWSはSageMakerでKerasの学習・デプロイを扱う公式情報を公開しています。クラウド上で環境をそろえる際の参考になります(出典:AWS公式ブログ、2019年)。
6. 定着:再学習と現場改善の運用への組み込み
AIシステムは、公開した時点で完成ではありません。データの傾向が変わると、同じモデルでも精度が下がります。そのため、再学習や現場の改善を運用に組み込んでおく必要があります。
- 精度の確認:月次や四半期などに精度、データ分布、誤判定の種類を確認する
- 再学習の管理:条件、データ承認者、評価環境、本番反映の承認者を決める
- 障害対応と共有:ロールバック手順と、操作や判定を覆す扱いを決め、誤判定の報告を現場に伝える
- 現場改善:データ追加ルールを現場で共有し、修正結果を次の学習データに回せれば、業務とモデルの両方を改善できる
- 引き継ぎ:コード、モデル、データ定義、構築手順、障害対応先を社内に残す
Kerasのシステム開発費用相場とコストの内訳
Keras自体はオープンソースで、ライセンス購入費は無料に近い水準です。一方で、業務システムの開発費は別途かかります。
ここに示す金額は、2025〜2026年公開の類似AIシステムの相場を、データ準備から本番運用まで含む案件に当てはめた推定です。Keras単独の公的統計から出したものではありません。
実際の金額は、データ量や連携数、精度要件によって変わります。また、セキュリティ条件やGPUの利用量も、金額に影響します。
規模別の初期費用と期間の目安
初期費用と期間は規模によって異なるため、推定レンジとその範囲に何が含まれるかを確かめます。
- 小規模PoC:100万〜500万円程度、1〜3か月程度
- 実用化・中規模:500万〜1,500万円程度、3〜6か月程度
- 本番・大規模:1,500万〜5,000万円以上、6〜12か月以上
小規模PoCは、代表データを確認し、1つのモデルを作って、限定的な推論APIと評価画面までを想定しています。全社向けの権限管理や、複数システムとの連携は通常含みません。
実用化・中規模では、データ加工やモデル改善に加え、APIや業務画面、既存システムとの連携まで含みます。
本番・大規模では、監査ログや再学習、高可用性への対応が重なると、上振れする場合があります。複数モデルや複数拠点、個人情報対応が加わる場合も、上振れの要因になります。
データが整い、用途を画像分類などに限定できれば、下限に近づく可能性があります(出典:リサーチノートに記載した2025〜2026年公開のAI開発・業務システム相場をもとにした推定)。
費用を左右する主な項目
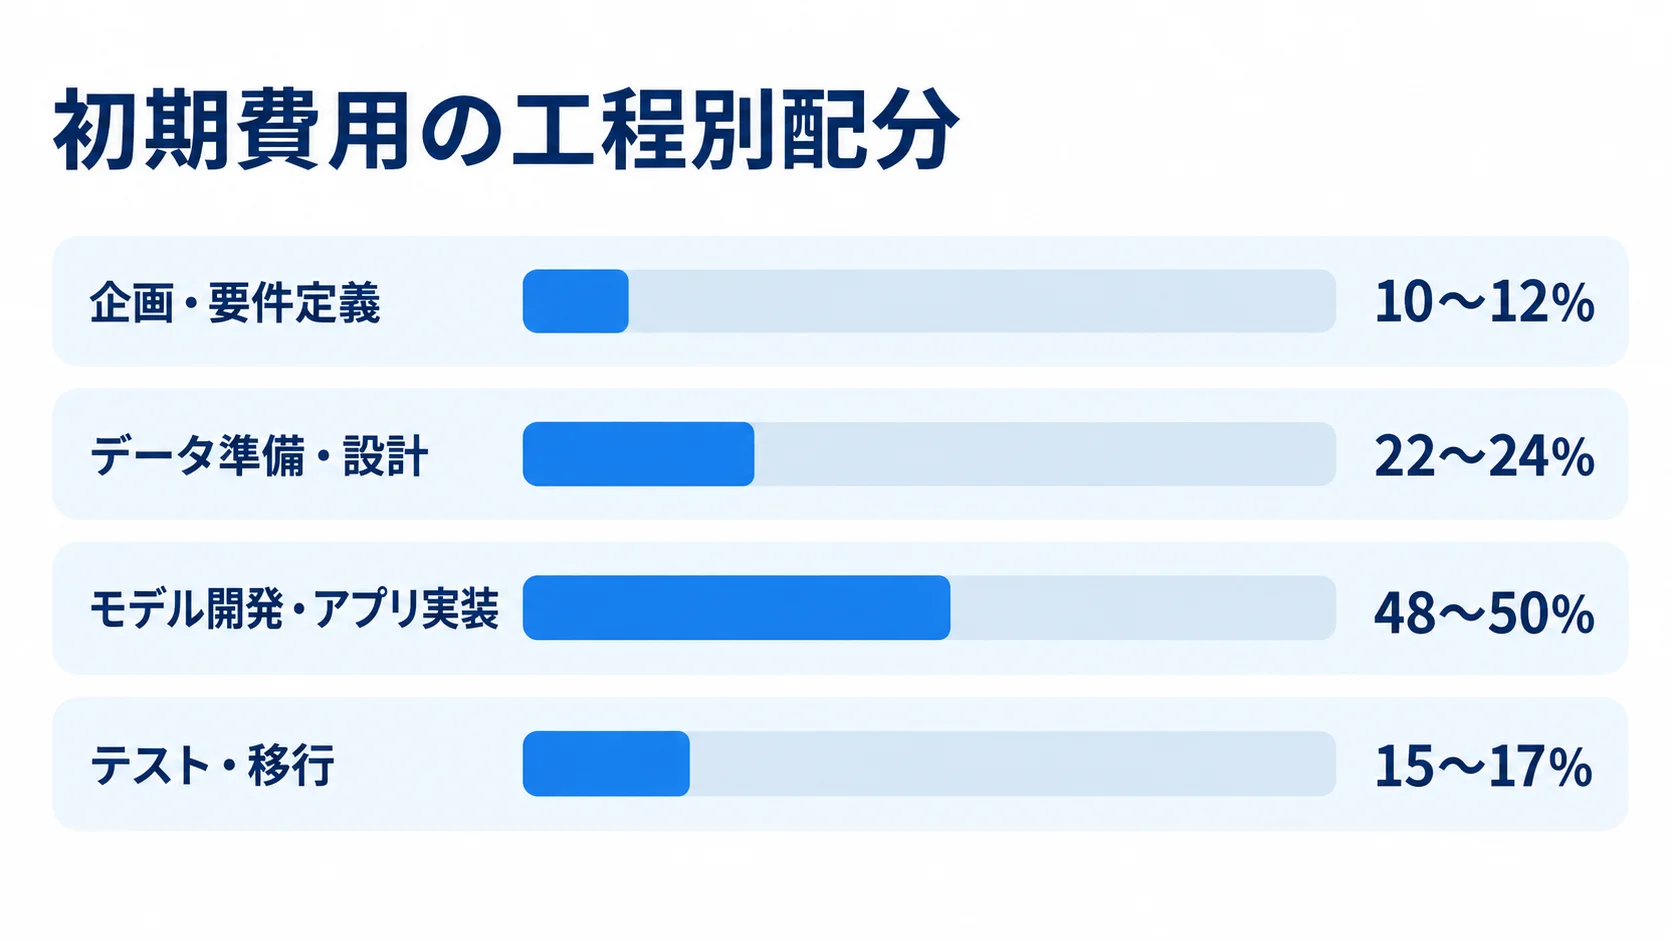
初期費用は、工程ごとに分けて見積もります。リサーチノートにある配分は、比べるときのたたき台になります。
- 企画・要件定義:10〜12%
- データ準備・設計:22〜24%
- モデル開発・アプリ実装:48〜50%
- テスト・移行:15〜17%
この配分は固定の比率ではありませんが、モデル部分だけ安く見せる見積もりを見分ける観点になります。
特に変動しやすいのは、データクレンジングやラベル付け、既存連携です。さらに、GPU環境や精度検証、画面と権限管理も、金額が変わりやすい項目です。
運用費は、初期開発費の年15〜25%程度を目安とします。内訳は、クラウド利用料や監視、脆弱性対応に分けて提示してもらいます。再学習や問い合わせ対応も、別項目として挙げてもらいます(出典:リサーチノートに記載されたAIシステム運用費の公開目安)。
開発費と月額費用が一つにまとめられると、導入後の予算を把握しにくくなります。
Kerasのシステム開発で見積もりを取る際のポイント
見積もりは、含まれる作業と別料金の条件をそろえて比べます。総額の安さだけを見ると、前提の違いを見落とすおそれがあります。
見積もりでは、モデル開発に加えて、データ抽出・加工やアノテーションが含まれるかを確かめます。APIや画面、認証、ログを含め、クラウドやテストも同じ前提で比べます。さらに、教育と保守まで含むかも確かめます。
発注前にそろえる資料と確認事項
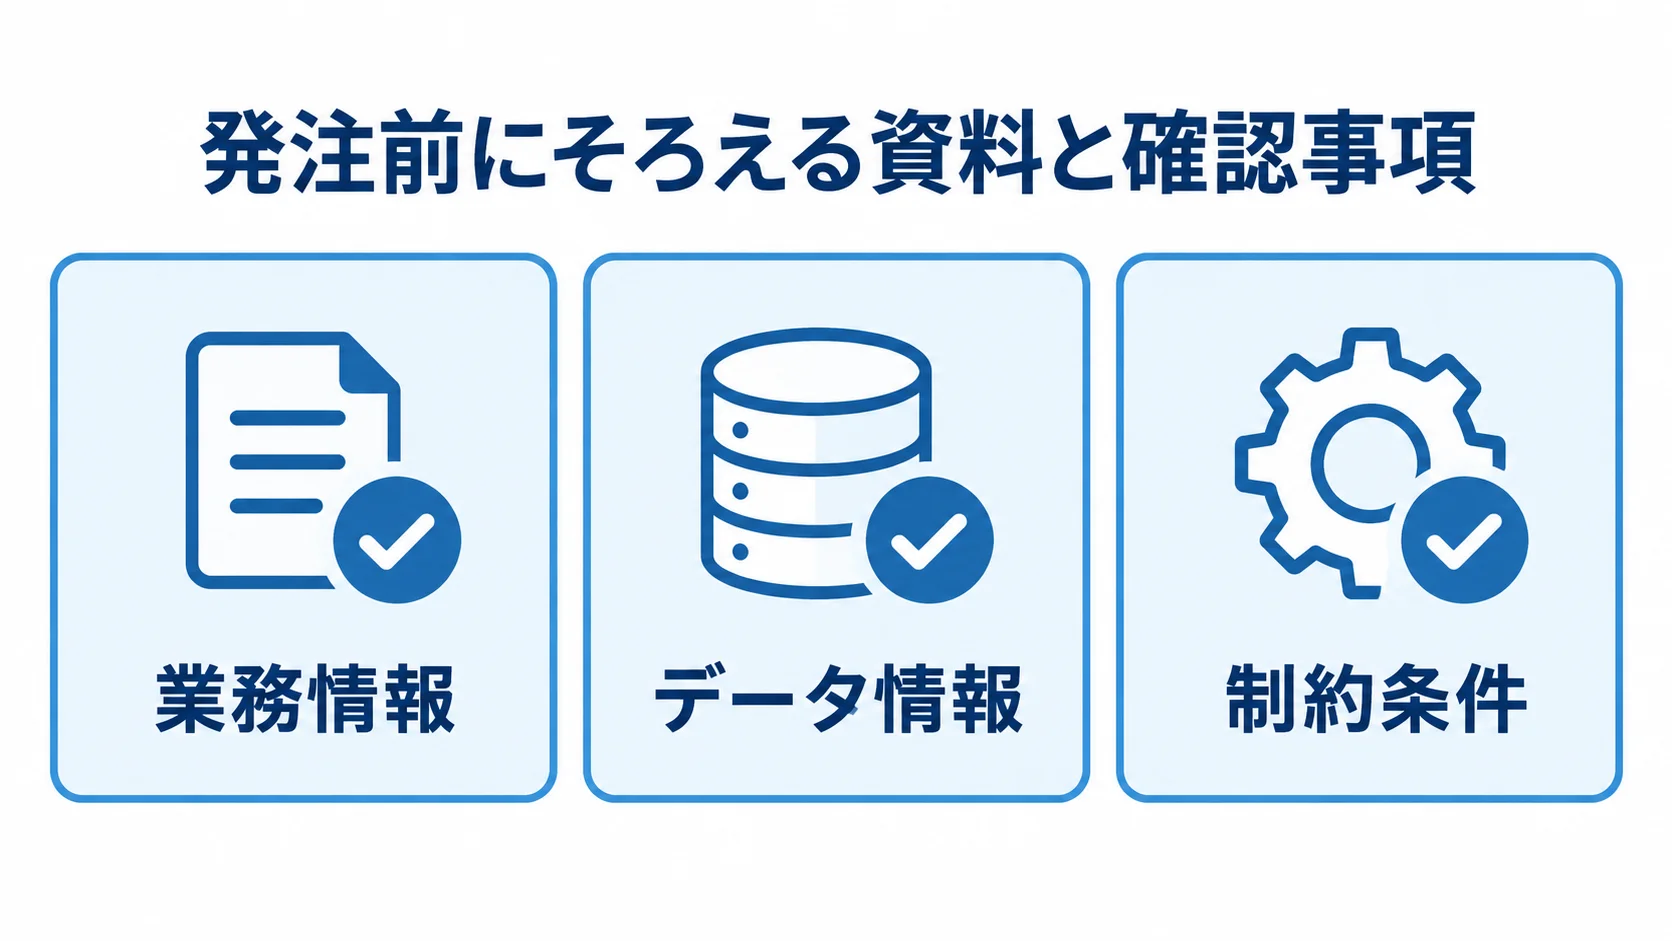
見積もりの前提をそろえるため、業務の流れとデータの実態を開発会社に共有します。
- 業務情報:業務フロー、利用者、現行システム、期待KPI
- データ情報:サンプル、件数と期間、正解ラベルの例
- 制約条件:誤判定の許容範囲、利用場所、個人情報、希望納期
実データを渡せない場合は、項目一覧や匿名化済みのサンプルでも構いません。ただし、実データとの違いは、見積もりの条件として残しておきます。
PoCと本番で納めるものは、分けて示してもらいます。PoCでは、評価レポートやモデル、検証用APIなどが対象になります。
本番では、設計書やテスト結果、運用手順が対象になります。監視設定やIaC、ソースコードも含まれます。さらに、モデルファイルやライセンス一覧も対象です。
納品物の所有権と、改変や再利用の範囲は、契約前に確かめます。学習データの利用目的や、再委託先への共有条件も対象になります。
開発会社を比較するチェックリスト
Keras導入後の運用まで見据えて、提案会社の技術経験と支援体制を確かめます。
- 技術経験:Keras 3と利用予定バックエンドの実務経験
- 対応体制:データサイエンスと業務設計の両方を扱う
- 運用責任:本番運用・保守まで責任を持てる
デモ画面の出来映えに加えて、異常データの扱い、目標精度に届かない場合の判断、モデル更新時の承認者を質問します。
提案には、複数の技術選択肢と採用理由を含めてもらいます。さらに、想定リスクや前提条件、除外事項、追加費用の条件も示してもらいます。
特定のクラウドやフレームワークに固定しすぎない構成も検討します。モデルをAPIとして差し替えられ、データと環境を引き継げる契約であれば、将来の内製化やベンダー変更にも対応しやすくなります。
よくある失敗と事前の対策
AI開発では、データ品質、PoCの評価、運用費用を初期計画に含めて検討します。
- ラベル定義の後回し:「データを集めれば精度が出る」と考える
- PoCの過信:PoCの精度を本番の成果と誤認する
- 運用費の漏れ:GPUや再学習の費用を見積もらない
対策として、代表データを事前に調べ、業務KPIに沿って評価します。手動fallbackや運用設計、費用の変動条件も、初期計画に入れておきます。また、モデルだけが納品され、運用方法がないという事態も防げます。
また、AIの利用目的やデータの権利、説明可能性は、法務や情シス、現場責任者と確かめます。事故時の連絡先や、委託先とどこまでを誰が受け持つかも、決めておきます。
経済産業省と総務省のAI事業者ガイドライン第1.2版は、2026年3月31日に公表されています。社内規程や委託契約を確かめる際の基準にできます(出典:経済産業省「AI事業者ガイドライン第1.2版」、2026年)。
Kerasのシステム開発でよくある質問
よくある疑問として、ライブラリの費用や、TensorFlowなどとの違いが挙がります。学習データの量や、PoCと本番の差も、よく尋ねられる点です。発注前にこれらの誤解を解いておくと、目的に合わない選定や、導入後の追加費用を抑えやすくなります。
Kerasを使うとライセンス費用はかかりますか?
Keras自体はオープンソースのため、ライセンスの購入費は無料に近い水準です。
ただし、データ準備やモデル開発、APIや業務画面の作成には費用がかかります。クラウドGPUや監視、保守も、費用の対象です。ライセンスとシステム全体の開発費は、分けて見積もります。
Kerasで業務システムを作るにはどの程度のデータが必要ですか?
必要な量は、用途や目標精度によって変わります。データのばらつきや正解ラベルの品質も影響するため、一律の件数は示せません。
まず、代表データを調べて、ラベルの一致度や欠損を確認します。そのうえで、小規模なPoCで学習曲線と誤判定を評価します。
データが少ない場合は、事前学習モデルやデータ拡張を使うほか、ルールとの併用や人手確認も含めて設計します。
PoCで動いたKerasモデルをそのまま本番利用できますか?
そのまま使えるとは限りません。PoCで精度を確認できても、本番には追加の対策が必要になります。
- アクセス管理:認証、権限、監査ログの整備
- 安定稼働:入力検証、負荷対策、障害時の代替手段の用意
- 継続運用:モデル更新と脆弱性対応の決め方
本番前には、実データで性能と安全性を検証し直します。そのうえで、段階リリースにより利用範囲を広げていきます。
Kerasのシステム開発会社は何を基準に選べばよいですか?
Kerasの実績に加えて、業務要件やデータ整備、モデル評価を一体で説明できるかを見ます。API・画面開発やMLOpsについても、同じ会社が受け持てるかを確かめます。セキュリティや保守まで含めて説明できるかが、選ぶ基準になります。
提案時には、バックエンドやGPU環境、納品物の引き渡しを確かめます。再学習とSLA、追加費用の条件も、確認が必要です。自社KPIに沿うPoC計画を提示できるかも見極めます。
まとめ:業務定着から逆算するKerasのシステム開発
開発開始前の最終チェック
着手前には、対象業務のKPIと代表データ、正解ラベルを確かめます。許容する誤判定の範囲と、PoCの合否条件も定めます。
利用者と権限、手動fallbackの扱い、費用の上限も定めます。6フェーズごとに納品物と責任者が定まると、本番運用へ進むかどうかを判断しやすくなります。
開発会社への相談時に共有する情報
相談時には、業務フローや現行システム、データの種類と件数を共有します。改善したい時間や品質、納期、セキュリティ条件も伝えます。
- データの提示:匿名化サンプルや項目一覧を示すと、Kerasの妥当性や周辺機能を見積もりに含めやすい
- 費用の範囲:データ準備、モデル開発、API、画面、連携、GPU、監視、保守を含めて確認する
- 小規模・実用化:PoCは100万〜500万円程度、実用化は500万〜1,500万円程度
- 本番・大規模:1,500万〜5,000万円以上
- 複数社への相談:前提条件と除外事項をそろえて比較する
Kerasを導入すること自体を目的にはせず、業務KPIと現場の判断を起点に開発を進めます。要件整理でデータとラベルを確かめたうえで、技術や開発会社を選びます。
設計・開発では、モデルと業務アプリを分けておきます。その後、テストから段階的な稼働、再学習を含む定着までを、一つの計画にまとめます。
▼全体ガイドの記事
・Kerasのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。