
Kubeflowのシステムは、機械学習の開発から監視までを一つの流れにまとめ、本番運用を支える基盤です。
導入が向く企業の条件や主要コンポーネントから、開発の進め方、費用、発注先の選び方までを順に説明します。各テーマの詳細は、下の関連記事で確認できます。
▼関連記事一覧
・Kubeflowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Kubeflowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Kubeflowのシステム開発の見積相場や費用/コスト/値段について
・Kubeflowのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Kubeflowのシステムの全体像
Kubeflowは、機械学習モデルの開発者と基盤運用者をつなぐOSSです。完成品として導入するものではなく、複数のサブプロジェクトやKubernetes周辺の機能を組み合わせ、企業ごとに構成して使います。
開発から運用までの一貫した流れ
一般的なAI開発では、データ準備から稼働後の監視までが、工程ごとに別々に管理されがちです。
Kubeflowでは、処理をコンテナとパイプラインで定義します。このため、同じ入力から同じ処理を再実行しやすくなります。また、手作業のコマンド入力を減らし、モデルの版やデータ、パラメータ、評価結果を追跡できます。
Kubernetesによる計算資源と実行環境の管理
Kubernetesは、コンテナの配置、CPU・メモリの割り当て、GPUノードの利用を担います。さらに、障害時の再起動やネットワーク分離も受け持ちます。
基盤設計には、コンテナや認証だけでなく、ストレージや監視、バックアップの設計も含まれます。
Kubernetesを本番運用中の企業ほど、導入効果を出しやすいです。一方で、未経験の組織では、学習期間と外部支援の費用を見込んでおく必要があります。
OSSであることと、システム費用の違い
KubeflowはOSSであり、ソースコードを利用することでライセンス費用を抑えられます。
- 基盤づくり:クラスタ設計、コンテナイメージ管理、データ接続が要ります。
- 資源と権限:GPU予約や権限設定に、人と時間がかかります。
- 継続運用:脆弱性対応、更新、障害対応の作業が続きます。
この違いを押さえておかないと、初期費用は低く見えても、運用後に予算が膨らみます。そのため、比較の対象はライセンス料金だけでなく、モデルを安全に本番へ届ける総保有コストです。
Kubeflowのシステムは自社に必要かどうかの判断
複数チームが複数モデルを継続して開発し、データと計算資源を統制しながら本番運用する企業には、有力な選択肢です。
単一モデルの短期検証や、Kubernetesの運用体制がない企業では、必要な機能だけのマネージドサービスが合理的な場合もあります。
導入効果が出やすい企業の条件
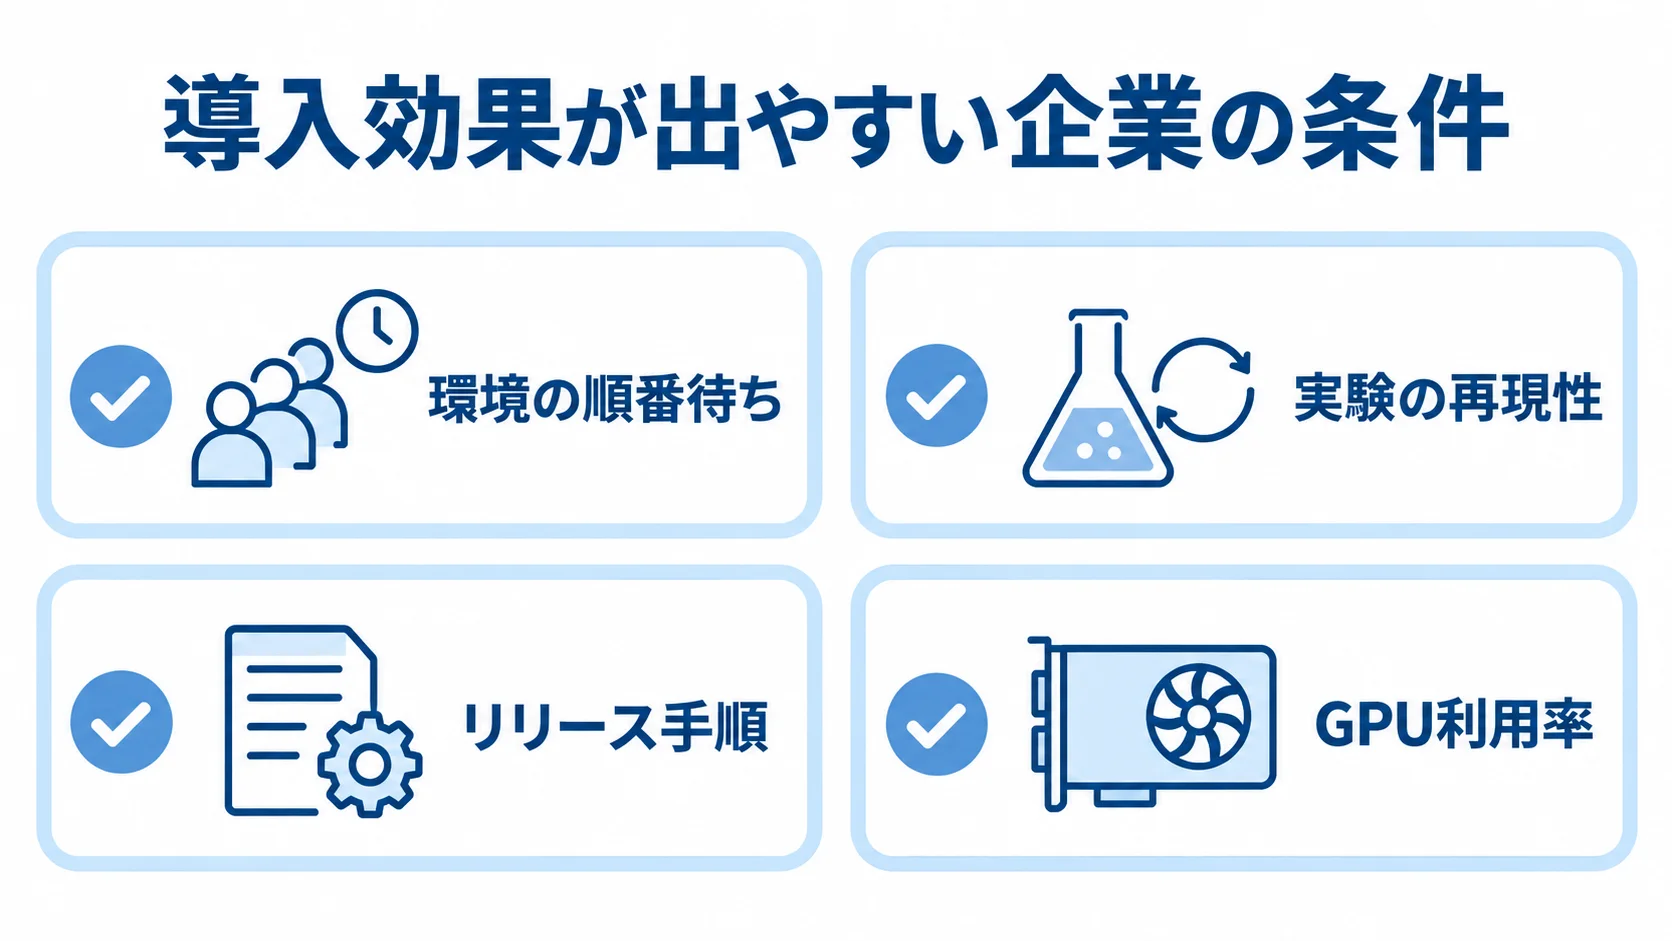
導入効果が出やすい企業には、機械学習の複数人チームがあり、学習環境や再現性に課題があります。
- 環境の順番待ち:学習環境の利用調整に時間がかかります。
- 実験の再現性:条件や結果を、チームで追いにくい。
- リリース手順:モデルを本番へ出す手順が定まっていません。
- GPU利用率:GPUの利用状況の把握や調整が難しい。
標準化したNotebookやパイプラインを提供すれば、基盤担当者への個別の依頼を減らせます。
データを社内や特定のリージョンに置く場合や、複数のクラウドとオンプレミスをまたぐ場合にも、移植性を重視した構成が役立ちます。
採用を急がない方がよいケース
次のような場合は、フル構成をすぐに作らない方が安全です。
- 要件が未定:モデルの業務要件が決まっていません。
- 利用者が少ない:一人または少人数で利用します。
- 学習頻度が低い:学習を月に数回しか行いません。
まず既存の分析環境やマネージドAIサービスで、モデルの価値を検証します。再現性や監査、推論の可用性、コスト配賦などに課題が出た段階で、Kubeflowを検討します。
Kubernetes管理者がいないまま本番基盤を作ると、開発者がインフラ障害も抱え、機械学習の開発速度が下がる場合があります。
導入前に決めるべきKPI
採用の判断は、Kubeflowを導入するかどうかより、業務の成果で測ります。
- 本番化:モデルを本番へ届ける日数。
- 学習:学習ジョブの待ち時間とGPU稼働率。
- パイプライン:再実行の成功率。
- 推論:レイテンシとモデルのロールバック時間。
たとえば、公開事例では、医療系の機械学習基盤で検証時間が最大10時間から20分未満になったと報告されています(出典: Kubernetes公式ケーススタディ、2019年)。なお、この数字をそのまま自社の目標にせず、現状の待ち時間を測って改善幅を定めます。
Kubeflowの主要コンポーネントと構成の種類
Kubeflowは、必要な機能を段階的に組み合わせられます。利用者、データ、モデルのライフサイクルに合わせて、範囲を決めます。
2026年のコミュニティ配布版は、Kubernetes 1.35以上を前提とします。リリースノートには、Pipelines 2.16.1、Trainer 2.2.0、KServe 0.18.0などが掲載されており、Hub 0.3.9も含まれます(出典: Kubeflow Community Distribution 26.03.1リリースノート、2026年)。
NotebookとPipelinesによる実験の再現
Notebooksは、データ分析やモデル開発を行うための環境です。
- ワークスペース:利用者ごとに独立して払い出します。
- 環境設定:依存ライブラリとCPU・GPUの割り当ての標準化。
- パイプライン:データ取得から成果物保存までの工程を、DAGで定義します。
Pipelinesは、実験条件と結果を記録します。コードで管理するため、担当者が変わっても再実行しやすく、失敗したステップも確認できます。
TrainerとKatibによる学習の大規模化
Trainerは、複数のGPUやノードを使う分散学習を、Kubernetes上で扱います。
- ジョブ設計:並列化や失敗時の再実行、リソース上限と優先順位を扱います。
- ハイパーパラメータ調整:Katibが、値の探索と早期停止を自動化します。
大きなモデルや大量データでは、候補となる実験を比較できます。さらに、精度や速度を上げるうえでは、GPUの台数に加えて、データの分割や通信のボトルネック、評価指標、学習結果の保存方法も検証します。
KServe・Hub・監視による本番への接続
本番提供、モデル追跡、監視には、それぞれ次の機能を使います。
- KServe:学習済みモデルをオンライン・バッチ推論に提供します。
- Hub:モデル、カタログ、メタデータを管理し、学習元データを追跡します。
- 監視基盤:メトリクスやログ、トレースとアラートから、精度低下やデータ分布の変化を検知します。
2026年版では、認証・認可テストやネットワークポリシーも強化されています。ただし、社内の権限設計と監視項目は、別途定義します。
Kubeflowのシステム開発の進め方
代表モデルのPoCでデータ取込から監視まで一周させ、技術課題と運用負荷を把握します。その結果をもとに、機能や可用性、監査、コスト配賦を追加します。
▶ 詳細はこちら:Kubeflowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義でのKPIと責任範囲の確定
要件定義では、モデルごとの構成と担当範囲、成果を測る指標をそろえます。
- 対象と利用条件:モデル、利用者、データ所在、学習頻度、推論方式を定めます。
- 品質と運用条件:許容停止時間、必要精度、監査要件を決めます。
- 責任範囲:基盤側が提供する機能と、データ・モデル開発側の責任範囲を明確にします。
- KPI:精度、再学習時間、リリース頻度、復旧時間、1回の学習コストを測ります。
毎週再学習する需要予測と常時応答する画像判定では、GPU、ストレージ、SLO、リリース手順が異なります。
PoCでの代表モデルによる一連の検証
PoCでは、機能を広げる前に、一つのモデルをデータ取得から推論まで通します。
- データ取得、前処理、特徴量生成を実装します。
- 学習、評価、成果物保存を行います。
- 推論エンドポイントを公開し、ログとメトリクスを集めます。
- 再現性、ジョブ再実行、GPU未使用時の自動停止を確認します。
最小構成で検証し、同じコミットとデータ版から同じ結果を再現できるかを確かめます。また、PoCを2〜4か月程度とする場合は、命名規則や権限、タグ、IaCの方針を先に決めておくと、作り直しを減らせます。
本番化での非機能要件と移行の仕上げ
本番運用に必要な仕上げは、移行の前に順番に進めます。
- マルチユーザー分離や認証、ネットワーク制御を追加し、バックアップと災害復旧も備えます。
- 監査ログや可観測性、脆弱性対応、モデル承認フローを整えます。
- モデル切替の段階リリース、シャドー推論、ロールバックを決めます。
- 学習データ欠損、GPUノード不足、モデル精度が閾値を下回る場合を想定し、障害訓練を行います。
完了条件として見るのは、画面が動くことより、再現可能な運用手順と担当者が決まっていることです。
Kubeflowのシステム開発費用と運用費用の相場
Kubeflow自体の導入価格は、一律に定められていません。そのため、ここで示すのは国内受託開発の見積もり初期値です。
業務システムの一般的な規模別相場に、Kubernetes・GPU・MLOps運用の工数を組み合わせています。
金額はモデル数や利用者数、GPU機種のほか、データ量、可用性、データ所在によって変わります。既存基盤との連携や保守時間にも左右されるため、PoCで実測して見積もりを更新します。
▶ 詳細はこちら:Kubeflowのシステム開発の見積相場や費用/コスト/値段について
▶ 詳細はこちら:Kubeflowのシステム開発の発注/外注/依頼/委託方法について
初期開発費の幅(300万円〜1億円超)
初期費用と期間は、基盤の規模や運用条件によって変わります。
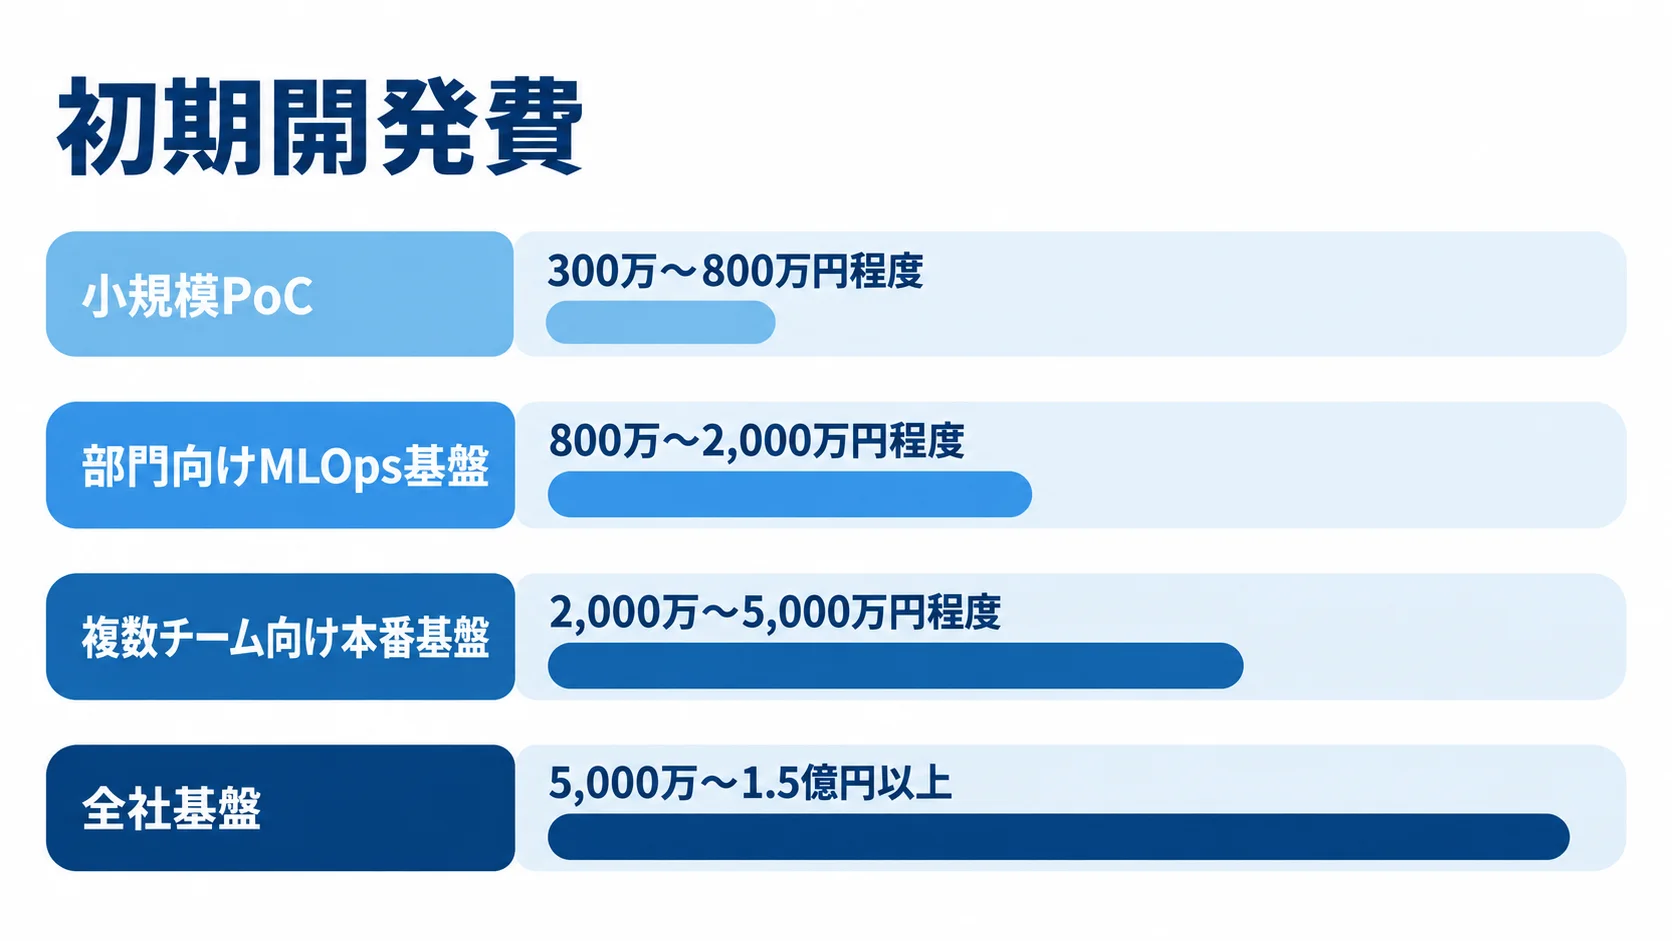
- 小規模PoC:300万〜800万円程度、2〜4か月。学習パイプライン一つが対象です。
- 部門向けMLOps基盤:800万〜2,000万円程度、4〜8か月。
- 複数チーム向け本番基盤:2,000万〜5,000万円程度、6〜12か月。SSO、権限分離、GPU、モデル管理、監視、CI/CD、既存データ連携を含みます。
- 全社基盤:5,000万〜1.5億円以上、12〜24か月以上となる場合があります。
全社基盤の金額は、複数クラスタやオンプレミスGPU、災害復旧、厳格な監査、24時間運用を含む場合の目安です。
費用の内訳(人件費・クラウド費・保守費)
見積もりでは、初期費用、人月単価、保守運用費を分けて確認します。
- 初期費用:要件定義、設計、実装、連携、テスト、文書、移行が対象です。
- 人月単価:中小80万〜120万円、大手SIer150万〜200万円程度です(出典: 業務システム開発の公開相場整理、2026年)。
- 保守運用費:初期開発費の年15〜25%程度を起点にします。
Kubeflowの開発では、プロジェクト管理やMLOpsに加え、クラウド、データ、機械学習の役割が必要です。そのため、単純な画面開発より人員構成が複雑になります。
保守の範囲は、アップグレードやCVE対応に加え、監視、障害対応、モデル再学習まで含みます。
GPUとノード稼働を中心にしたクラウド実費の管理
クラウド実費は、クラスタ管理料金と環境ごとの稼働費を分けて把握します。
- クラスタ管理:標準は1クラスタ・1時間0.10米ドル、拡張は0.60米ドルです(出典: マネージドKubernetes公式料金表、2026年)。
- 月額換算:730時間なら管理料金は約73米ドルまたは約438米ドルです。
- 別料金:ノードやGPU、ディスクの費用がかかります。ロードバランサやログ、IP、リージョン間通信も別途必要です。
- 開発環境:CPU中心で、月10万〜40万円が目安。
- 本番環境:CPU等は月30万〜150万円、GPU学習は月50万〜500万円以上が目安です。
アイドル時間を減らすための自動停止や、Spot・予約利用の可否も検討します。
Kubeflowのセキュリティと運用の確認事項
AI基盤では、学習データやコンテナ、認証情報、推論API、ログを、攻撃や誤操作から守ります。
ただし、配布版のセキュリティ機能に加えて、企業のデータ分類、権限、保管場所、監査方針は、自社で満たしていく必要があります。そのため、設計段階からセキュリティと運用を要件に含めます。
認証・認可とテナント分離の先行設計
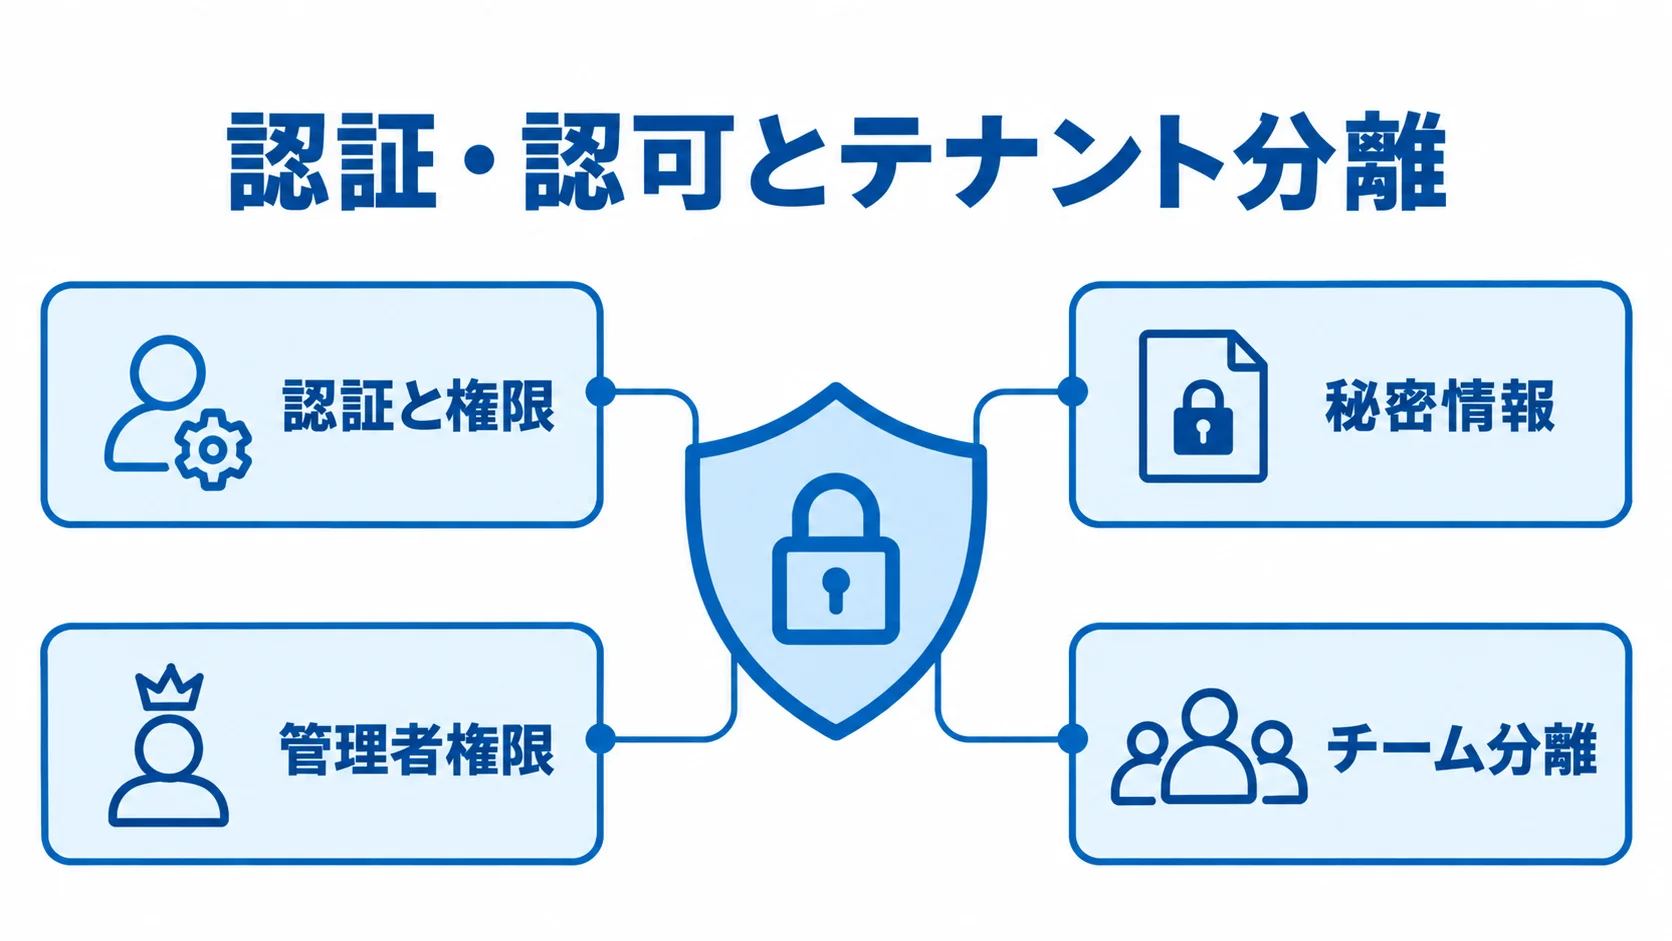
利用者認証に加えて、Namespace、データ、GPUへのアクセスを分けます。モデルや推論エンドポイントへのアクセスも、同じ考え方で分けます。
- 認証と権限:SSO、グループ、ロールを対応させます。
- 秘密情報:サービスアカウントと保管方法を定めます。
- 管理者権限:申請手順と期限を決めます。
- チーム分離:Namespace、ネットワークポリシー、オブジェクトストレージのバケット、モデルレジストリの権限を一貫させます。
テストでは、許可された操作ができることに加えて、別チームのデータが見えないことも確認します。
学習データとモデルのガバナンスの定義
学習前にデータの制約と扱いを確かめ、Kubeflow内に情報が残る経路も管理します。
- 対象データ:個人情報、機密情報、著作物、契約上の制限が含まれる場合があります。
- 台帳記録:利用目的、取得元、保存期間、削除方法、国外移転、第三者提供・委託を記録します。
- 利用範囲:個人情報保護委員会は、生成AIへの入力が目的達成に必要な範囲か確認するよう注意喚起しています(出典: 個人情報保護委員会、2023年)。
- 情報の残存:コピー、ログ、バックアップに個人情報が残らない設計にします。
監視・アップグレード・障害対応の日常業務化
導入時のバージョンを固定して終わりにはできません。公式案内のサポート期間も考慮しながら、更新と監視を続ける前提で運用します。
- サポート:継続更新を前提にします。
- 変更管理:互換性のある更新手順、検証用クラスタ、マニフェスト管理、脆弱性の優先度付け、ロールバック、変更承認を運用します。
- 稼働監視:CPU・GPU、ジョブ待ち時間、失敗率、推論レイテンシ、エラー率を見ます。
- モデルと費用:データドリフト、精度、費用上限も見える化します。
コミュニティサポートは、おおむね6か月のベストエフォートです。また、定期更新も推奨されています(出典: Kubeflow Community Distribution 26.03.1リリース案内、2026年)。
Kubeflowの開発会社/ベンダーの選び方
Kubeflowの開発会社やベンダーは、まずKubernetesの本番運用実績を確かめます。インストール経験は、その前段の確認項目です。
GPUやデータ基盤との接続、認証・認可、モデル監視、更新、障害対応を説明できるかも確認します。
ベンダーの種類は、クラウド事業者、商用ディストリビューション提供者、受託開発会社、運用サービス会社などに分かれ、役割が異なります。そのため、契約上の責任分界も比べます。
本番条件で見る導入実績
導入実績は、実際の本番条件に近い項目で確かめます。
- 利用規模:利用者数、モデル数、GPU規模、データ量を聞きます。
- 稼働実績:推論方式、稼働時間、障害件数、更新回数を確認します。
- 本番経験:PoCと24時間稼働する基盤の運用経験を区別します。
- 資料:匿名化した構成図、テスト計画、運用手順、障害報告のサンプルを見せてもらいます。
既存システムとのデータ連携やモデル承認フローの実装経験も、見積もりの精度に関わります。
提案書と見積書の責任分界の確認
提案書と見積書では、構成、作業範囲、契約上の責任を具体化します。
- 基盤構成:Kubeflowの版、Kubernetes、GPUの種類と台数を明記します。
- 周辺要件:ストレージやネットワーク、認証を確かめます。監視、バックアップ、テストも対象です。教育と納品物の扱いも、あわせて確かめます。
- 工程と範囲:要件定義から運用引き継ぎまで分け、対象外作業も書きます。
- 契約責任:再委託、ソース・IaCの所有権、文書更新、脆弱性対応期限、障害連絡経路を確認します。
「一式」や「標準構成」とだけ書かれた見積もりは、後から追加費用が発生しやすくなります。このため、工程別の記載がない場合は、追加費用の条件を契約前に確認します。
導入後の支援体制と撤退条件
運用継続と終了の両方について、担当や契約条件を確認します。
- 担当:クラスタ更新、精度判断、GPU費用管理の責任者を決めます。
- SLA:平日日中のみか夜間休日を含むか、初動時間と復旧目標を何分・何時間にするか定めます。
- 終了時の移行:データ、モデル、パイプラインの取り出し方法を確認します。
標準的なコンテナやGit、IaC、オブジェクトストレージの形式で引き継げる体制は、将来の移行リスクを抑えます。
▶ 詳細はこちら:Kubeflowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
Kubeflowのシステムに関するよくある質問
Kubeflowの導入では、費用や難易度に加えて、代替手段やクラウドの選択で迷う方が少なくありません。そのため、社内稟議やRFPの前に判断基準を確認します。
Kubeflowは無料で使えますか?
オープンソースとして利用でき、ソフトウェアのライセンス費用を抑えられます。ただし、Kubernetesの環境や、CPU・GPUノードは別途必要です。ストレージや通信、監視も、別途見込んでおきます。人件費や保守費も必要です。
「無料」が示すのはライセンス条件です。比べる際は、初期開発費や月額実費、更新を含めた総額で見ます。
Kubernetes未経験でもKubeflowを導入できますか?
導入は可能ですが、未経験のまま本番運用まで自社だけで担うのは難しくなります。導入する場合は、まず基礎を身につけ、次の手順で進めます。
- マネージドKubernetesや小規模環境で、コンテナ、Namespace、ストレージ、認証、ログを学びます。
- 外部支援を使う場合は、構築を任せたうえで、IaC、運用手順、障害訓練、更新計画を自社で引き継ぎます。
自社で引き継ぐことで、長期的な依存を減らせます。
クラウドとオンプレミスのどちらが向いていますか?
利用条件によって候補が変わるため、方式と総額を合わせて比べます。
- クラウド:計算資源を短期間で増減したい、運用を標準化したい場合に向きます。
- オンプレミス等:社外に出せないデータや既存GPUがある場合に候補です。
- 設備償却:長時間の定常稼働で設備を償却できる場合も、検討の対象になります。
比べる項目には、GPU稼働率や電力・冷却、保守要員があります。ほかに、増設期間、データ転送、災害復旧なども含まれます。なお、初期設備費だけでなく、5年程度の総額で判断します。
Kubeflow以外の選択肢を検討してもよいですか?
検討はできます。利用規模に応じて、必要な機能だけを用意する方法もあります。
- 小規模な利用:単一モデル、短期PoC、少人数では、必要機能だけの構成が早い場合があります。
- 代替方法:Notebook、学習ジョブ、推論APIだけのサービスを使うか、既存のワークフロー基盤に必要機能を足す方法もあります。
- Kubeflowを含めて比較:複数チーム・モデル、データ制約、オンプレミスGPU、可搬性、標準化が重要な場合です。
評価は、機能の数よりも、KPI、運用体制、5年総額で行います。
まとめ:Kubeflowの段階導入と運用設計
Kubeflowは、機械学習の開発から本番運用までをKubernetes上で標準化する基盤です。
複数チームや複数モデルを扱い、GPUを共有する企業ほど、価値を出しやすいです。実験の再現性、モデル監査、クラウドとオンプレミス間の可搬性が必要な場合も、候補になります。
OSSであっても、システム全体の費用は別に見込む必要があります。そのため、初期開発費やクラウド実費、GPU、保守、更新を予算に組み込みます。
採用判断の基準(KPI・体制・総額)
採用判断と導入範囲は、検証結果と運用条件を踏まえて段階的に決めます。
- 代表モデルで検証:データ取得から推論・監視まで行い、待ち時間、再現性、GPU稼働率、精度、費用を測ります。
- 本番要件を追加:SSO、権限分離、バックアップ、監査、障害対応、更新を整えます。
- 発注先を比較:運用引き継ぎ、SLA、脆弱性対応、ソースとIaCの所有権を確認します。
KubernetesとMLOpsの運用体制がない場合は、構築後の担当体制まで確認します。
次の一歩としての小さなRFPと費用検証
RFPには対象と運用条件をまとめ、PoCから本番化への見積もりを分けます。
- モデル、利用者、データ量、学習頻度、推論方式、目標KPIを1〜2ページに整理します。
- 許容停止時間とセキュリティ条件を記載します。
- 候補構成を比べ、PoC範囲と本番化の追加条件を分けて見積もります。
導入そのものを目的とせず、安全で再現可能な業務運用に向けて、段階的に選びます。
▼関連記事一覧
・Kubeflowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Kubeflowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Kubeflowのシステム開発の見積相場や費用/コスト/値段について
・Kubeflowのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。