
Kubeflowのシステム開発は、要件整理、選定、設計開発、テスト、稼働、定着の6フェーズで進みます。各フェーズの成果物と終了条件を先に決め、再現可能なAI運用につなげます。
費用は規模によって幅があるため、各フェーズの作業と見積もりの確認点を合わせて見ていきます。
▼全体ガイドの記事
・Kubeflowのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Kubeflowのシステムの全体像
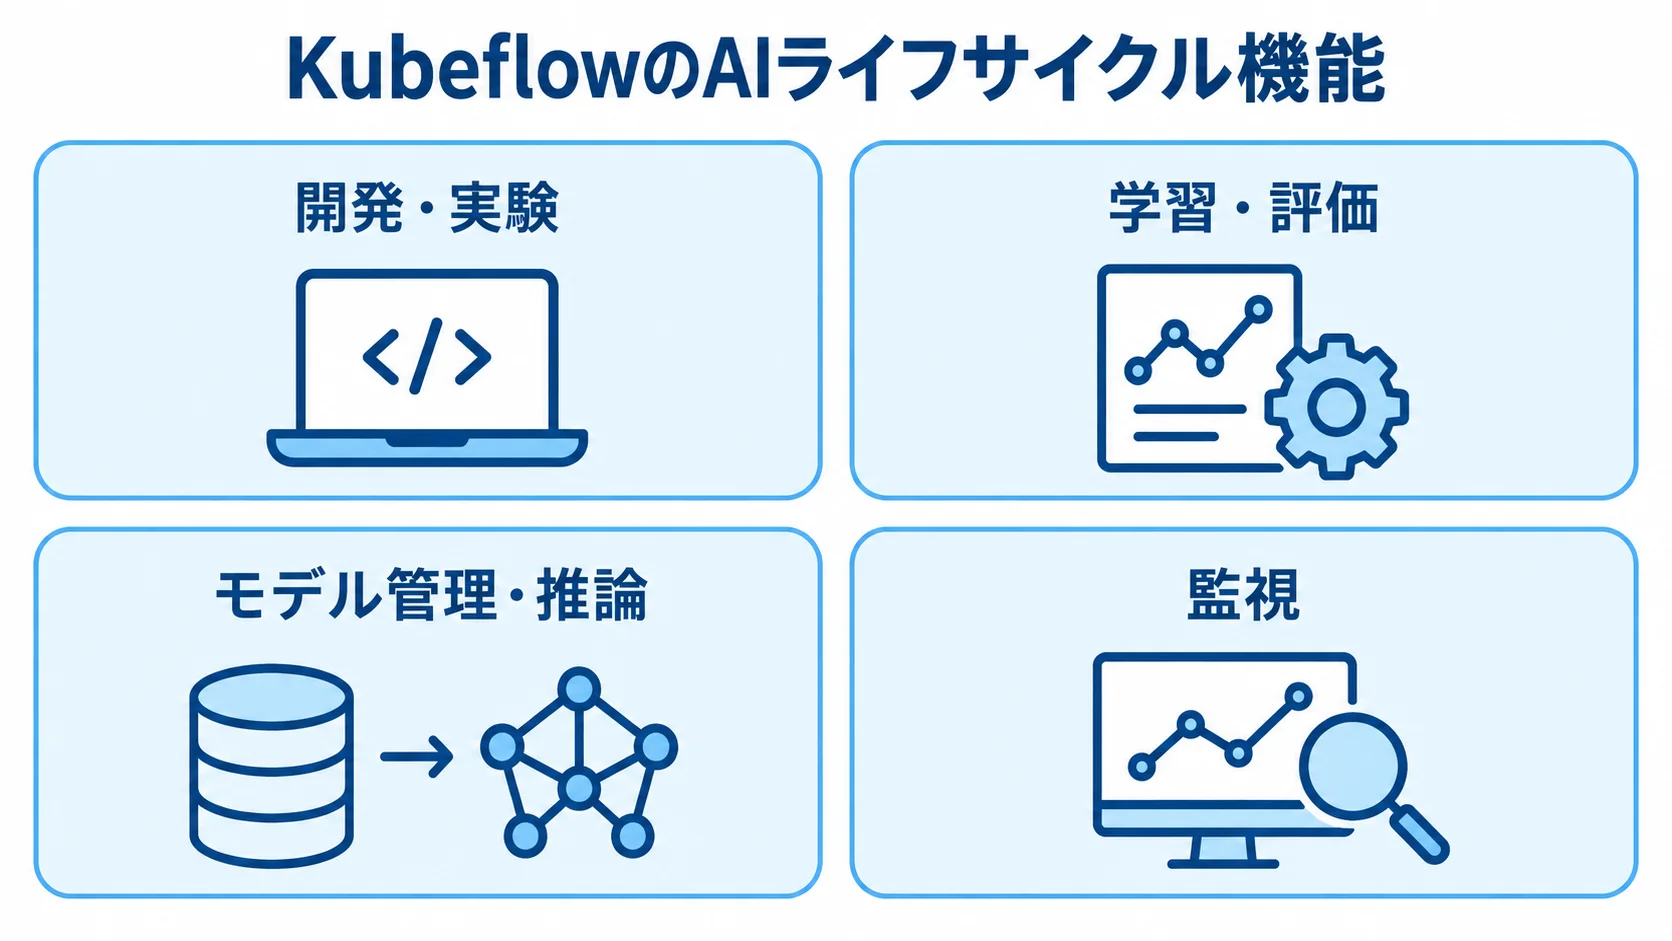
Kubeflowは、Kubernetesを土台に、機械学習の開発、学習、評価、モデル管理、推論、監視をつなぐオープンソース基盤です。
Kubeflowは完成品を一式入れるものではなく、Notebook、ワークフロー、分散学習、モデルサービングなどを周辺サービスと組み合わせて構成します。
構成には、データ準備やオブジェクトストレージ、コンテナレジストリが含まれます。さらに、メタデータデータベース、認証、監視も構成に入ります。そのため、導入前に「何を再現可能にし、何を本番運用したいか」を整理しておく必要があります。
主要コンポーネントのAIライフサイクルへの割り当て
開発会社は、AIライフサイクルの工程に合わせて、必要なコンポーネントを選びます。
- 開発・実験:Kubeflow Notebooksでの開発と、Katibでの調整
- 学習・評価:PipelinesでのDAG構成と、Kubeflow Trainerでの分散学習やLLMのファインチューニング
- モデル管理・推論:Kubeflow Hubでのメタデータや成果物の管理と、KServeでの推論
Kubeflow公式Architectureでも、コンポーネントをAIライフサイクルの各段階に対応づける考え方として示されています(出典: Kubeflow公式Architecture、2026年)。
すべてを最初から入れる必要はありません。たとえば、単一モデルの検証であれば、NotebookとPipelinesから始められます。
一方、複数チームでGPUやデータを共有する場合は、権限や監視も含めます。再実行や承認、監査、推論SLOが必要なときも、この範囲に入れます。そのうえで、後から機能を増やせる境界も設計書に残しておきます。
採用の必要性の判断軸(モデル数・チーム数・可搬性)
採用を判断するときは、運用規模、環境の可搬性、既存基盤との重複を見ます。
- 継続運用:複数チーム・複数モデルの学習、評価、配備
- 環境の可搬性:オンプレミスGPUや複数クラウドの利用
- 小規模検証:既存の運用体制とデータ移動の予定を踏まえた判断
- 既存基盤との重複:MLflow、Airflow、Ray、社内Kubernetesで不足する機能の確認
パイプラインをコードで管理すると、実験条件、データ、モデル、評価結果を追跡できます。
短期検証でモデルが1本だけの場合や、Kubernetes人材がいない場合は、マネージドAIも候補になります。さらに、データを一つのクラウドから動かす予定がない場合も、マネージドAIは短期間で始めやすいです。
候補としては、SageMaker、Vertex AI、Azure Machine Learningなどがあります。
Kubeflowのシステム開発の進め方
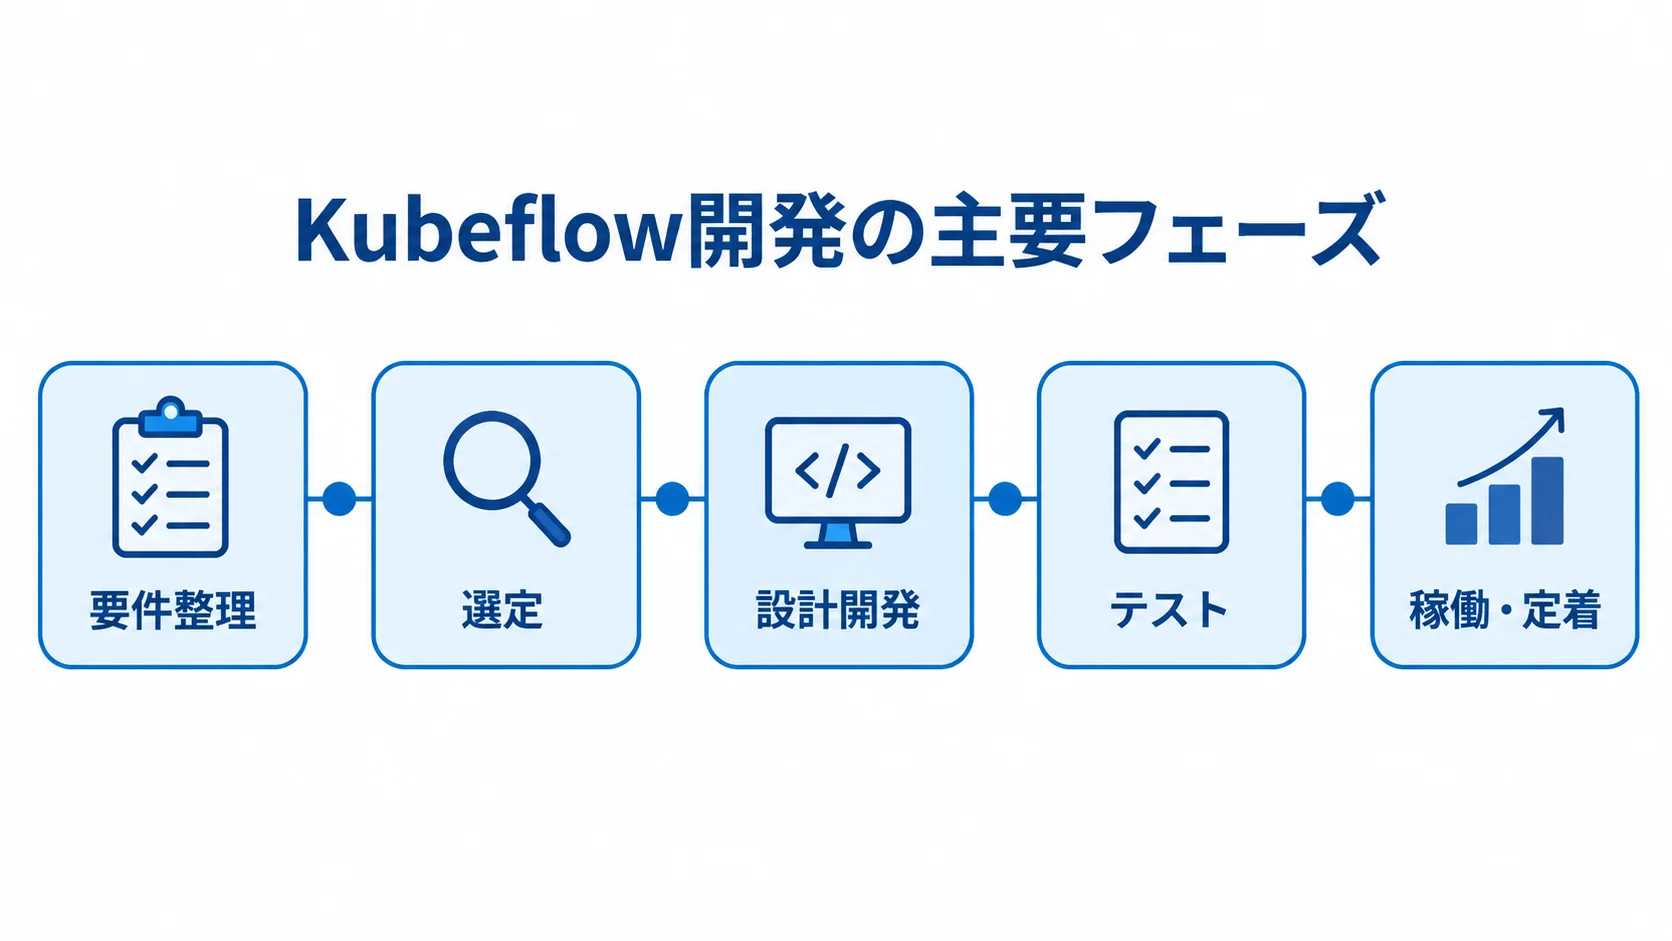
開発は、要件整理、選定、設計開発、テスト、稼働、定着の6フェーズに分けて進めます。各段階の成果物と、発注者が確認する終了条件は、先に決めておきます。
まず、代表モデル1本で、データ取込から監視までをつなぐ縦切りを早い段階で作ります。インストールだけでPoCを終わらせないよう、この縦切りをゴールにします。
フェーズ1:要件整理でAI業務とKPIを定義
まず、対象業務、利用者、モデルを一覧にします。データ元や学習頻度、推論方式、既存システム連携も、同じ一覧に書き出します。需要予測の場合であれば、売上・在庫・販促データの取込周期と、予測値を返す画面やAPIを決めます。
また、再学習を担当者が承認する条件も定めます。「AI導入」という言葉のままでは成果を測れないため、測定可能なKPIに置き換えます。
- 開発・再学習:モデル投入までの日数と再学習成功率。
- 品質・性能:推論レイテンシと誤判定率。
- 基盤運用:GPU稼働率と復旧時間。
学習データは、所有者と品質責任者を定めたうえで、個人情報や機密情報の有無と保存場所を確認しておきます。学習時と推論時のデータ量、欠損・遅延・再処理の許容範囲も、この段階で決めます。
本番後に困らないよう、RTO・RPO、利用者と権限、運用担当も決めておきます。国外へ出せないデータやオンプレミスGPU、監査ログの保存期間などは、要件定義書に明記します。
フェーズ2:選定でのクラウド・オンプレミス・構成範囲の比較
まず、AWS・Azure・GCPなどのマネージドKubernetesを使うか、オンプレミスやハイブリッド環境にするかを比べます。
クラウドは、GPUやネットワークを調達しやすく、ノードの増減も自動化できます。ただし、転送、ストレージ、監視、GPUの待機に継続費用がかかります。
オンプレミスは、データの所在と機器を制御しやすい一方で、GPUの調達や故障部品、容量計画、Kubernetesの更新を自社か委託先が担う必要があります。
候補構成は、運用要件と費用を比べられるよう、次の4案で揃えます。
- マネージドAI:クラウドのAIサービスを利用
- Kubernetes+Kubeflow:マネージドKubernetes上にKubeflowを構築
- 商用配布版:商用ディストリビューションの利用
- 必要なOSS:Kubeflow全体は使わず、必要な機能を組み合わせる
比較表には、認証(SSO・OIDC)やネットワーク分離、GPUの扱いを入れます。加えて、モデル登録、推論スケール、バックアップを比べ、脆弱性対応やサポートSLA、IaCの引き渡しも確認します。データの所在と運用体制に合うかは、この結果をもとに評価します。
採用は、公式の配布一覧に載っているかを根拠にせず、上の比較をもとに決めます。
フェーズ3:設計開発での再現性と責任分界の確保
設計では、データからモデルの運用まで、再現性と責任分界に関わる点を決めておきます。
- 基盤構成:データ、保存先、GPU、推論先、ログの流れの設計
- パイプライン:実行環境と成果物の版管理による再現性の確保
- 本番運用:評価、承認、推論、再試行、互換性の取り決め
学習データはデータレイクやDWHから取り込み、パイプラインの成果物はオブジェクトストレージに保存します。
Pipelinesは、コンポーネントをDAGで構成し、キャッシュ、再試行、成果物追跡を扱います(出典: Kubeflow Pipelines公式ドキュメント、2026年確認)。
各コンポーネントの入出力と実行環境は明示しておきます。そのうえで、依存ライブラリやベースイメージ、CPU・メモリ・GPUの要求、成果物の保存先を版管理します。
本番移行の基準、評価の合格ライン、承認者、ロールバック方法は、あらかじめ定めておきます。KServeでは、オンラインとバッチの推論を分けます。さらに、拡張やスケールゼロ、カナリアに加え、ヘルスチェックと認証も設計します。
Trainerでは、GPU機種とノード間通信を確認します。加えて、ジョブキュー、再試行、学習データのキャッシュも見ておきます。
Kubeflow 26.03.1では、Trainer 2.2.0やKServe 0.18.0などが案内されています。そのため、採用する版の互換性と移行手順は固定しておきます(出典: Kubeflow公式26.03.1 Release Announcement、2026年)。
フェーズ4:テストでの性能・再現性・安全性の検証
テストでは、本番相当の条件で、機能、再現性、性能、安全性を確かめます。
- 再現性:再実行、失敗後の再開、キャッシュ、成果物、評価の確認
- 性能:推論の遅延と同時数、GPU割当、待ち時間の測定
- 安全性・復旧:権限、通信、監査、バックアップ、障害の検証
画面やAPIの動作だけでなく、本番相当のデータ量も検証対象に含めます。推論では、P95・P99レイテンシや同時リクエスト数、タイムアウトを測ります。
推論の拡張・縮小と、旧モデルへの切り戻しを試験します。GPU割当やノード不足時の待ち時間も確かめます。さらに、学習ジョブのキャンセルやチェックポイントからの再開を測定します。
安全性の面では、Pod権限やSecrets、ネットワークポリシーを検証します。イメージの脆弱性と監査ログも対象です。バックアップの復元やクラスタ障害も試したうえで、条件と結果、未解決のリスクを記録しておきます。
26.03.1では、Pod Security Standardsのrestricted対応や、KServeの認証・認可テストが案内されています。ネットワークポリシーも改善されています(出典: Kubeflow公式リリース情報、2026年)。
標準機能の有無と、自社の境界要件への適合は、別に検証します(出典: Kubeflow公式リリース情報、2026年)。
フェーズ5:稼働での段階移行とロールバックの実施
稼働では、段階的に公開し、合格条件と復旧手順を確認します。
- 開発環境、検証環境、限定利用、本番全体の順で公開範囲を広げます。
- 既存モデルがあれば、旧モデルと並べて評価します。
- 学習データの取込時刻とモデル版を記録し、判断を後から再現できるようにします。
既存モデルや推論APIがある場合は、並行稼働やシャドートラフィックを使います。精度、遅延、費用、エラー率が合格基準を満たすかは、切り替え前に確認します。
切替手順書には、作業者と承認者、開始条件、停止時間を時系列で記します。監視項目や利用者への連絡、戻す条件、連絡先も、同じ手順書に入れます。
エラー率が合意値を超えた場合に備えて、旧エンドポイント、モデル、データパイプラインのどれを戻すかを決めておきます。
引き渡しでは、kubectlの手順に加えて、クラウドIAM、ストレージ、DNS、証明書、GPUノードの復旧手順も含めます。
フェーズ6:定着での運用と改善の習慣化
定着の段階では、役割分担、定期監視、更新、引継ぎの運用を整えます。
- 役割・監視:担当の分担と、基盤・モデルの状態の月次確認
- 更新・安全性:互換性確認から復旧までの定期運用
- 引継ぎ:IaC、監視、復元、連絡網、教育資料など8領域の確認
役割は、管理者、データサイエンティスト、アプリ担当、セキュリティ担当に分けます。
月次では、基盤の使用状況(CPU・メモリ・ストレージ、GPU稼働率)と、学習待ちやパイプライン成功率を確認します。さらに、推論遅延、モデル精度、データドリフト、クラウド費用を追跡します。
精度が低下したときに原因を切り分けられるよう、ログとメタデータの保持期間を決めておきます。切り分けの候補は、データ品質や特徴量の変化、コード変更、基盤障害です。
Kubeflowのコミュニティサポートは、おおむね6か月のベストエフォートです。そのため、継続的な更新と脆弱性対応が前提になります(出典: Kubeflow公式26.03.1 Release Announcement、2026年)。
定期更新では、まず互換性を確認し、マニフェストを更新します。更新の前には、バックアップとリリースノートの確認を行い、問題があればロールバックします。
引継ぎの対象は、IaCやイメージ、パイプラインです。さらに、モデル登録、監視、アラート、復元、連絡網、教育資料も含みます。
Kubeflowのシステム開発の費用相場とコストの内訳
Kubeflowの費用は、ライセンス以外の要素を合わせて決まります。要件、Kubernetesの構築、コンテナ化の作業に費用がかかります。連携、GPU、評価の作業も、費用の対象です。
安全対策とテストも費用の対象です。移行と引継ぎは、作業ごとに分けて見ます。
ここで示す金額は、一律の価格ではなく、業務システムの相場とKubeflow固有の工数から見た推定です。金額は推定にすぎないため、要件とクラウドの利用量はPoCで測り、本番前に再見積もりします。
PoCは300万〜800万円、本番基盤は2,000万〜5,000万円が目安
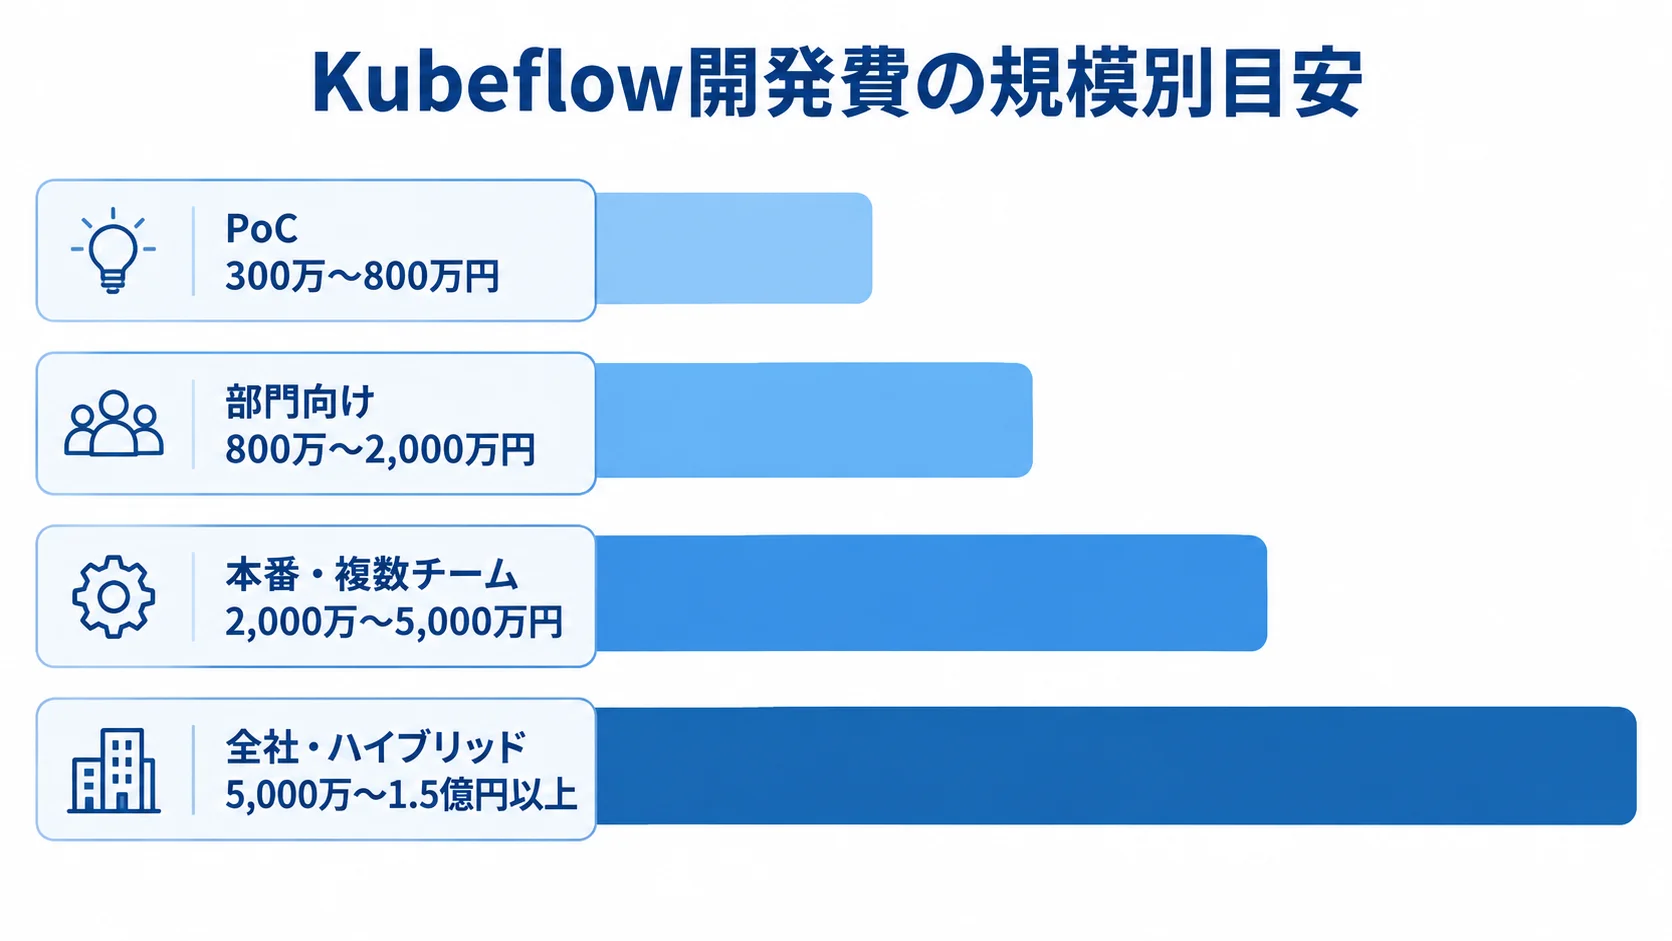
開発費は、PoCから全社・ハイブリッド基盤まで、規模によって幅があります。期間も含めて、規模別の目安を示します。
- PoC:300万〜800万円、2〜4か月程度。
- 部門向け:800万〜2,000万円、4〜8か月程度。
- 本番・複数チーム:2,000万〜5,000万円、6〜12か月程度。
- 全社・ハイブリッド:5,000万〜1.5億円以上、12〜24か月以上。
PoCは、1チームがCPU中心または限定的なGPUを使う想定です。Notebook、Pipelines、簡易推論、サンプルデータ、基本評価が含まれます。
部門向けの基盤には、SSOや権限、GPUに加えて、モデル管理と監視が含まれます。CI/CDと既存データ連携も入ります。
各レンジは、開発会社の体制や既存クラスタ、データ整備の状況によって変わります。
本番構成では、高可用性やマルチテナント、KServe、監査、移行、SRE設計を含めると、工数が増えます。
全社構成は、ハイブリッドやマルチクラウドになる場合があり、上記の範囲を超えることもあります(出典: NotebookLMリサーチノート「Kubeflowのシステム」、2026年)。
いずれも特定の会社の価格表ではなく、予算の範囲を決めるための目安です。予算計画を立てる際の前提として扱います。
クラウド・GPU・保守費と初期開発費の区別
発注側は、初期費用と分けて、クラウド利用、人員、保守の条件を確認します。
- クラウド:管理料のほか、ノード、GPU、保存、通信などの積算
- 人件費:担当する職種と、開発会社の人月単価による見積もり
- 保守:初期費用と分けたうえで、契約に含む作業の明確化
クラウド費は、クラスタやノード、GPUといった項目ごとに分けて見ます。ストレージ、ロードバランサ、IP、通信、ログ、バックアップも、同じように分けて積算します。
たとえば、AWS EKSは、標準サポートで1クラスタ・時間0.10米ドル、拡張サポートで0.60米ドルです。
730時間稼働させた場合、管理料だけで月約73米ドルまたは約438米ドルになります。EC2やEBS、IP、クロスAZ通信などは別料金です(出典: AWS公式Amazon EKS Pricing、2026年確認)。
GKEの管理料も、1クラスタ・時間0.10米ドルです。無料枠は、請求先アカウントあたり月74.40米ドル相当とされています。
StandardのノードはCompute Engineで、特定のハードウェアやアクセラレータは別課金です(出典: Google Cloud公式GKE Pricing、2026年確認)。
推定月額は、CPU中心の開発環境で10万〜40万円、本番のCPU・ストレージ・監視で30万〜150万円です。GPU学習を定常運用する場合は、月50万〜500万円以上の見込みもあります。
金額はリージョン、GPU機種、Spot・予約、稼働時間、転送によって変わります。そのため、上限額と自動停止を設定しておきます。
人件費は、担当範囲によって変わります。特に、PM、Kubernetes・クラウド、MLOpsをどこまで担うかで、金額が動きます。
ほかに、データ、機械学習、セキュリティの担当範囲も金額に関わります。
人月の目安は、中小開発会社で80万〜120万円、大手SIerで150万〜200万円程度です(出典: NotebookLMリサーチノート「Kubeflowのシステム」、2026年)。
保守運用は、初期開発費の年15〜25%をたたき台にできます。ただし、更新やCVE対応、監視、障害、再学習、クラウド利用料をどこまで含めるかは、契約で分けておく必要があります。
Kubeflowのシステム開発で見積もりを取る際のポイント
見積もりは、合計額だけで比べず、成果物、前提、除外事項、責任分界、受入条件まで確認します。「導入一式」と書かれていても、クラスタの構築だけで、連携や評価、推論、監視、移行、教育は含まれない場合があります。
発注側は、要件整理から定着までの作業と金額が対応する見積書を依頼します。
要件書に含めるデータ量・KPI・非機能要件
見積もりの前提をそろえるために、要件資料と成果物の範囲を明記しておきます。
- 業務・データ:モデル、頻度、利用者、データ量と増加量の提示
- 性能・制約:GPU、遅延、精度、RTO・RPO、保管地域の情報
- 成果物:設計、実装、評価、監視、移行、運用資料のどれを含めるか
候補の会社には、対象モデル数とチーム数、ピーク時に必要なGPU台数を明記します。あわせて、個人情報の扱いと既存システムとの接続も共有します。
匿名化したサンプルには、現実に近いレコード量と欠損・遅延を含めておきます。理想的なデータだけで進めると、後からクレンジングや再設計の費用が発生します。
見積書の成果物には、要件書や構成図、クラスタ・ネットワークが含まれます。さらに、モデル評価や推論、監視も対象になります。
ほかの対象は、権限表、Pipeline・コンテナ定義、復元です。テスト結果と移行、運用手順、教育資料も、見積もりに含めます。
評価指標と業務担当者の承認手続も、見積もりの範囲に入れます。
Kubeflowと業務アプリの両面からの会社評価
会社を比べるときは、技術力、契約上の責任、提案内容を同じ条件で確認します。
- 技術・体制:運用実績、担当者、再委託、対応時間
- 成果物・責任:コード、IaC、手順書、更新、保守範囲
- 提案条件:同じRFPでの前提、除外事項、品質保証の比較
Kubeflowに加えて、Kubernetesの本番運用やGPUの扱いを確認します。データ基盤、IAM・OIDC、コンテナの安全対策、監視、障害対応も見ておきます。
同規模の事例や担当技術者の役割、再委託の範囲、24時間対応の有無を確認します。アップグレードの責任と、ソースコード・IaC・手順書の引き渡し条件は、質問して明確にします。
公式ガイダンスを使う場合でも、受託開発や運用を誰が担うかは確認します。各社には同じサンプルデータを渡し、比べられるようにします。
本番の権限や監視、移行が別料金になっている提案や、要件定義・テストが極端に短い提案には注意が必要です。「OSSなので保守費は不要」という説明は、根拠を確認します。品質の保証者と方法を確かめたうえで、判断理由を議事録に残します。
GPU費・バージョン・データ権限のリスク管理
GPU費、バージョンの互換性、データ権限は、それぞれ別のリスクとして管理します。
- GPU費:稼働方法と性能・可用性を合わせた評価
- バージョン:互換性と更新時の支援内容の、契約での確認
- データ権限:閲覧、持出し、認証、削除の扱いの取り決め
常時起動のノードと、ジョブ時だけ使うノードは分けておきます。そのうえで、GPUのアイドル時間やキュー待ち時間、Spot・予約の適否を測ります。
Notebookを放置した場合に備えて、アイドル停止、利用時間の上限、プロジェクト別の費用配賦を設定します。
GPUの在庫や地域を価格だけで決めると、待ち時間や転送費が増える場合があります。そのため、性能と可用性も合わせて比べます。
Kubeflowと、Kubernetes、Istio、Knative、KServeの組み合わせに加えて、Python、GPUドライバ、イメージの互換性を確認します。
契約には、CVE対応や更新頻度、検証環境、緊急パッチ、障害時の窓口を明記します。
閲覧者、成果物の持出し、ログに含まれる個人情報、API認証、削除要求への対応を確認します。個人情報を扱う場合は、目的、委託、保存場所、削除、アクセス権を、設計と契約の両方に記します。
よくある質問(FAQ)
導入の規模、運用体制、費用について、発注前によくある疑問に答えます。
Kubeflowは小規模なAI開発にも必要ですか?
単一モデルの短期PoCで、利用者が1チームだけなら、マネージドAIや既存基盤のほうが合理的な場合があります。
複数のモデルやチーム、再現可能な学習、オンプレミスGPU、将来のクラウド移行が必要な場合は、一部導入の価値が出やすくなります。そのため、目的と運用できる人材を先に確認します。
Kubeflowは無料なので開発費も安くなりますか?
ソフトウェアに一律のライセンス購入費がないことと、システム総額が無料・安価になることは別の話です。
設計やGPU、ストレージには、人件費やクラウド費がかかります。ほかに、連携、権限、テストの作業も費用の対象です。さらに、更新、監視、障害対応の作業も含まれます。
そのため、初期費、月額の実費、保守費を分け、GPU稼働時間と自動停止の条件を確認します。
Kubeflowの開発会社には何を確認すればよいですか?
実績件数に加えて、Kubernetes、GPU、データ基盤の担当者を確認します。IAMや監視の担当者も、それぞれ確かめておきます。更新と障害対応は、誰が受け持つかを分けて確認します。
PoCの成果物、本番条件、テスト範囲、IaCやコードの引渡し、再委託、保守SLA、クラウド費の上限も尋ねます。同じ要件書とサンプルを渡し、提案の前提と除外事項をそろえて比べます。
まとめ
Kubeflowのシステム開発は、要件整理、選定、設計開発、テスト、稼働、定着の6段階で進みます。まずは代表モデル1本で、取込から評価・推論・監視までをつなぎ、再現性や運用負荷、GPU稼働率、費用を測ります。
測った結果をもとに、複数チーム、高可用性、マルチテナント、監査、DRへと段階的に広げます。
採用判断の軸は成果と運用体制
採用は、モデル規模と運用条件で判断します。そのうえで、初期費用と継続費用を分けて見積もります。
- 小規模:単一モデルなら、マネージドAIが適する場合があります。
- 組織運用:複数チーム・モデル、GPU、可搬性、再現性を求める場合に、Kubeflowの価値が高まります。
- 初期費用:PoCは300万〜800万円、部門基盤は800万〜2,000万円です。
- 大規模構成:本番は2,000万〜5,000万円、全社は5,000万〜1.5億円以上です。
クラウド、GPU、保守、更新は別枠にし、前提と変動要因を見積もりに残しておきます。
要件書と代表モデルを用意したPoCの開始
PoCの前に、要件、終了条件、運用責任を整えておきます。
- 業務、データ量、KPI、利用者・権限、推論SLO、GPU、保存場所、RTO・RPOを1枚にまとめます。
- 候補会社へ同じ条件で相談し、PoC終了条件に再実行、評価、負荷、監視、復元、概算クラウド費を含めます。
継続運用の責任者と予算を先に決めておくと、本番後の定着まで進めやすくなります。
▼全体ガイドの記事
・Kubeflowのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。