
LightGBMのシステム開発は、回帰・分類・ランキングから業務判断に合うものを選び、必要なデータと画面を設計して進めるのが基本です。
モデルの精度だけでなく、入力データの品質や処理時期も設計の対象になります。
▼関連記事一覧
・LightGBMのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・LightGBMのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・LightGBMのシステム開発の見積相場や費用/コスト/値段について
・LightGBMのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
LightGBMのシステムの全体像
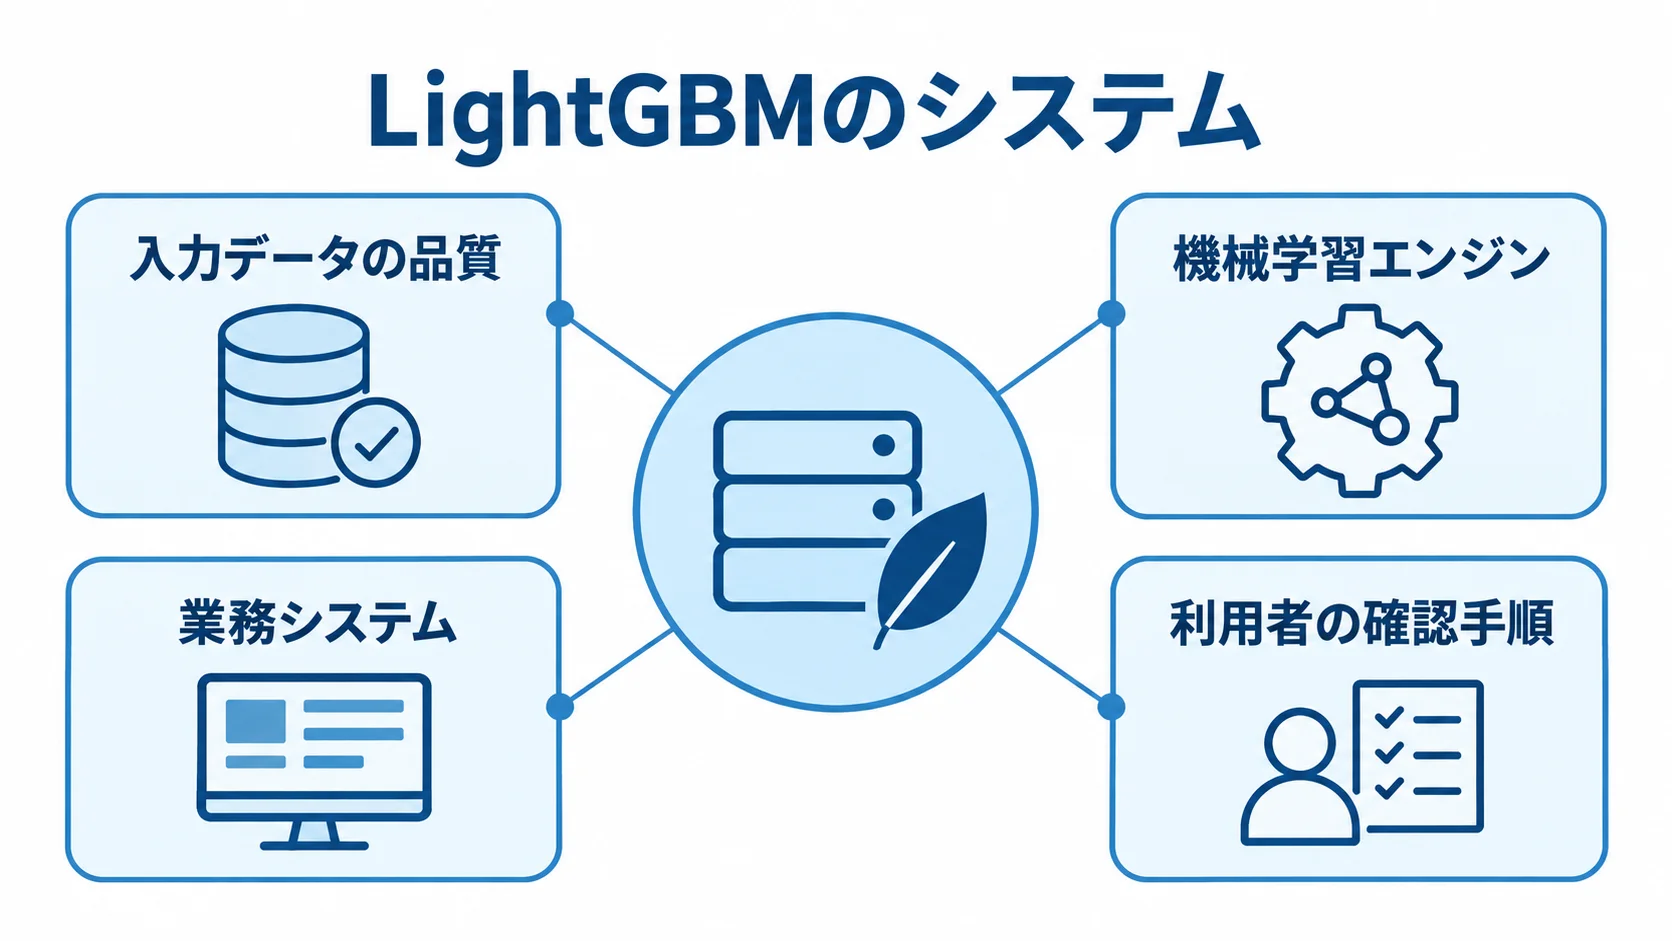
LightGBMのシステムは、予測結果を返すモデルと、その前後で動く業務システムで構成されます。そのため、利用者の確認手順やログ、権限、障害時の対応も、モデルと一体で設計しておく必要があります。予測の精度に加えて、入力データの品質や処理時期も、同じ設計の対象になります。
LightGBMを組み込む位置
LightGBMは業務画面そのものではなく、予測や分類を担う機械学習エンジンとして組み込みます。たとえば、販売実績、在庫数、曜日、季節、販促情報から商品ごとの需要を予測し、在庫管理画面に表示できます。さらに、発注候補の作成やアラート通知までつなげると、業務で使えるシステムになります。
データから予測結果までの流れ
予測結果が業務に届くまでは、データの準備から結果の記録まで段階を追って進みます。
- データの準備:基幹、顧客管理、販売管理、IoT機器などからデータを集め、欠損値や異常値を確認して特徴量を作ります。
- 結果の届け先:学習済みモデルで推論し、結果を画面・API・帳票・通知へ渡します。
- 実行の構成:学習と推論は分けることが多く、夜間に再学習して日中はAPIで予測する構成や、一定間隔でバッチ予測する構成が現実的です。
- 結果の記録:予測結果を後から検証できるよう、モデルの版、学習対象期間、使用した特徴量、評価結果を記録しておきます。
LightGBMのメリットと限界
導入効果は、性能上の利点とデータに起因する限界の両方から見極める必要があります。
- 表形式データ:高速な学習・推論を行え、大規模データや複数の特徴量も扱えます。
- 公式資料の特徴:低メモリ、高速処理、並列・分散・GPU学習、大規模データ対応です(出典:LightGBM公式ドキュメント、2026年閲覧)。
一方で、データが少ないと過学習しやすく、学習データに偏りがあれば予測も偏ります。そのため、導入すれば必ず高精度になるとは限りません。そこで、単純なルールや移動平均、別のモデルと比べて導入効果を確かめます。
LightGBMのシステムの種類と活用例
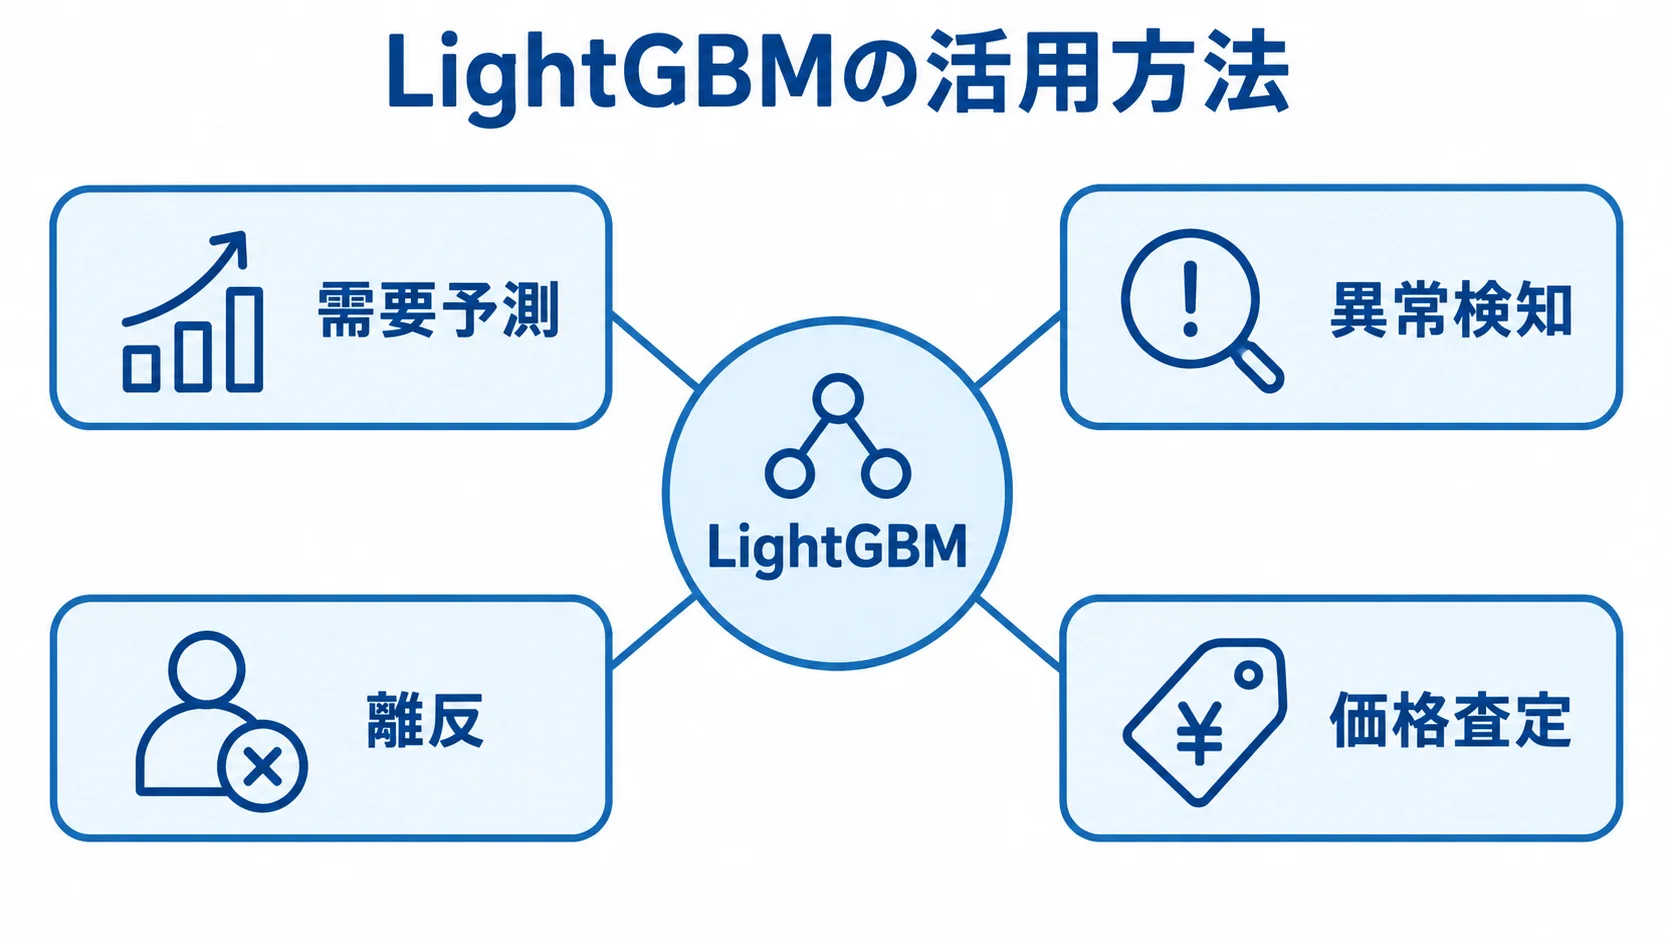
LightGBMの活用方法は、何を予測するか、そして予測後にどの業務アクションにつなげるかで整理できます。予測の型には、数値を予測する回帰、発生確率や区分を判定する分類、優先順位を決めるランキングがあります。業務判断に応じて選ぶと、必要なデータと画面が明確になります。
需要予測・売上予測のタイプ
需要予測では、予測の単位と型、そして予測値の使い方によって、設計の中身が変わります。
- 需要予測の単位:商品、店舗、地域、日付などの単位で、将来の販売数量や出荷量を推定します。
- 予測の型:数値を予測する場合は、回帰が使えます。
- 現場の知見:過去実績に、曜日や祝日、販促の情報を加えると、現場の経験則を特徴量に反映できます。価格、天候、在庫切れの有無も加えられます。
- 発注量への接続:予測を発注量へ直結させる場合は、納期と最低発注数を加味し、安全在庫と廃棄リスクも組み込みます。
- 採用の方法:予測値は自動で採用せず、担当者が確認できる候補にする設計が安全です。
異常検知・離反・審査スコアのタイプ
異常やリスクを予測する用途では、検出したあとに担当者が確認する負担も含めて設計します。
- 異常検知:設備の温度・振動、取引の金額・頻度、アクセス時間帯から、通常と異なる状態を検出します。
- 離反・審査:顧客や申込の属性から、一定期間内の事象確率を計算します。
- 判定基準:正解率だけでなく、見逃しと誤検知のどちらを重く見るかを決めます。
- 運用設計:対応可能な件数に合わせて閾値を決め、スコアの根拠を画面で確認できるようにします。
価格査定・作業時間・品質予測のタイプ
適用例を選ぶ際は、予測できる項目と、現場での使い方の両方を考えます。
- 予測対象:価格査定、加工時間、配送時間、品質スコアを予測できます。
- 査定画面:予測価格、類似データ、主な寄与要因、担当者の修正値を示し、業務への定着を促します。
国土交通省の空き家推定システム設計資料では、複数の行政データを統合し、欠損値を含むデータを扱うためにLightGBMが採用されています(出典:国土交通省のシステム設計資料、2026年閲覧)。
適用の可否は、データと運用要件から判断します。
LightGBMのシステム開発の4段階の進め方
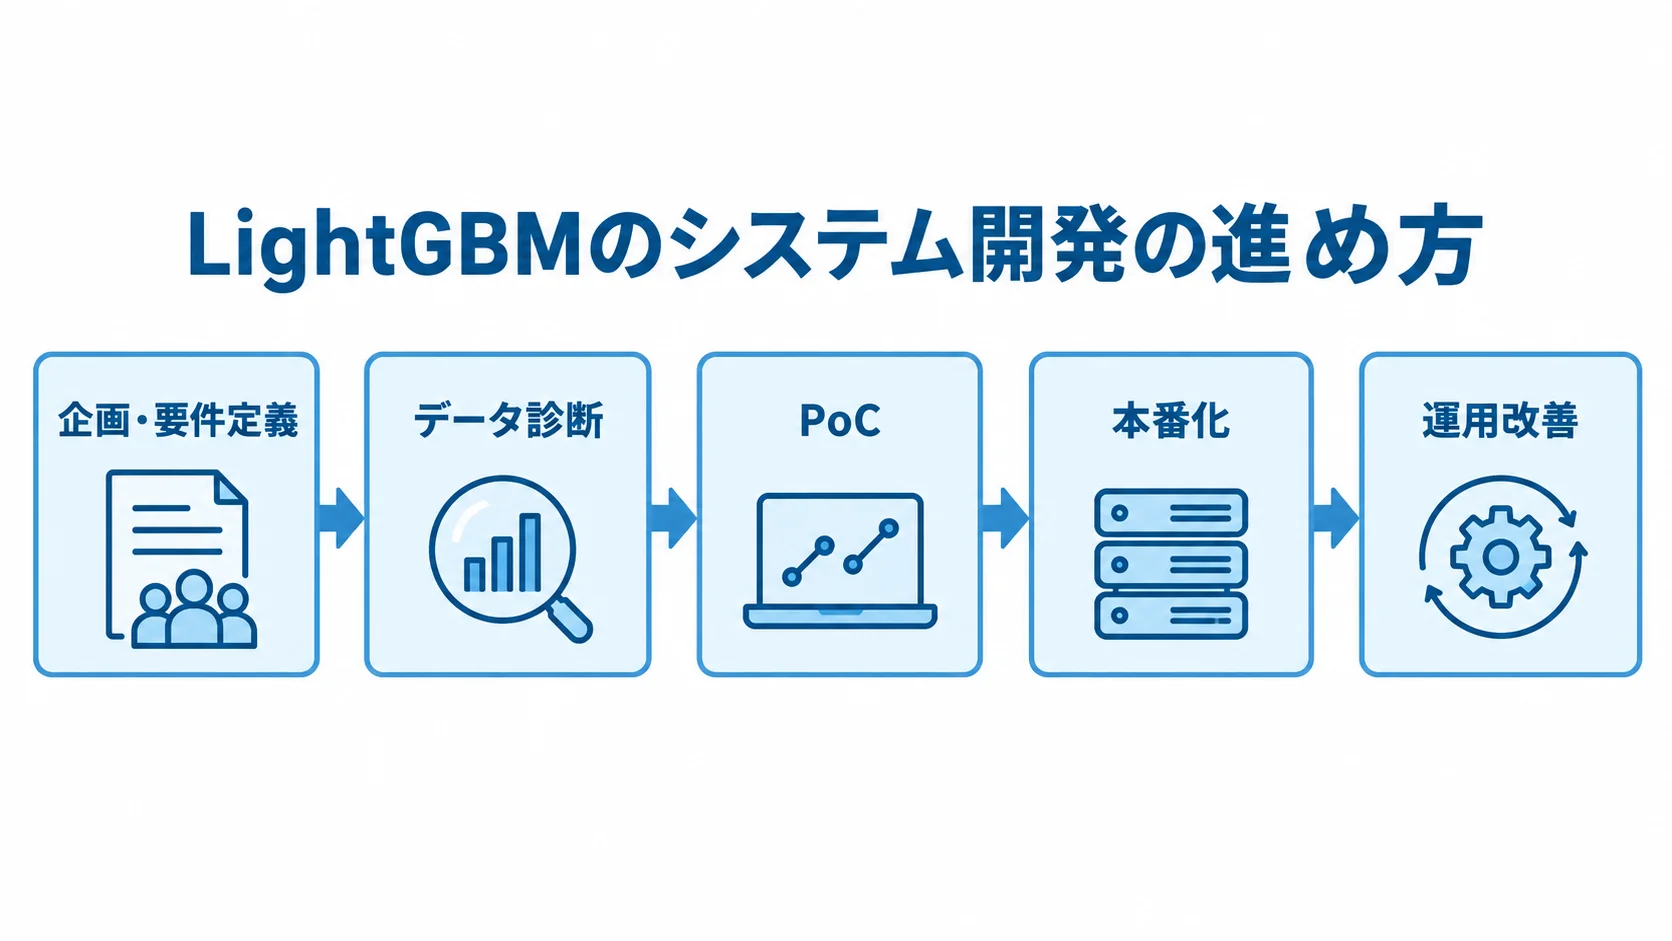
開発は、業務課題とデータの実現性を確かめてから段階的に進めます。
最初に大規模な画面や全社連携を作ると、データ不足やKPIの曖昧さが後で発覚しやすくなります。
発注側と開発会社は、段階ごとに判断点を置きます。
最初は企画・要件定義とデータ診断、次にPoC、最後に本番化と運用改善です。
▶ 詳細はこちら:LightGBMのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
企画・要件定義での目的とKPI
企画・要件定義では、予測で改善する判断を先に決め、それに合う要件と運用の決め事をそろえます。
- 判断の改善点:予測でどの判断を改善するかを決め、たとえば欠品率や廃棄率を下げる、査定時間を短縮するなどの形で業務KPIを具体化します。
- 要件の中身:予測対象、頻度、許容誤差を要件に含めます。
- 運用の決め事:利用者と承認者、手動へ戻す条件も、あわせて決めておきます。
- 数値目標:需要予測の誤差を10%以内にすると決めるだけでは不十分です。
- 優先順位:繁忙期と通常期のどちらを重く見るか、欠品と過剰在庫のどちらを避けるかは、事前に合意しておきます。
データ診断とベースライン比較
モデルを作る前に、データの状態と比較の基準をそろえておく必要があります。
- データ条件:期間、件数、粒度、欠損率、重複、更新頻度、ラベル、個人情報を確認します。
- データ整合性:商品コードや日付定義の不一致、結果ラベルの未登録をモデル開発前に解消します。
時系列データでは、未来の情報が学習側に混ざるデータリークを避ける必要があります。過去のデータで学習し、未来のデータで評価します。
比較の基準には、単純なルールや移動平均を使います。従来手法やLightGBM以外の候補とも比べ、採用効果を数字で確かめます。
PoCでのモデルと業務フローの検証
PoCでは、モデルの処理結果が出るかに加えて、実務で使えるかも確かめます。
- 検証作業:前処理、特徴量作成、学習、評価、簡易的な結果確認を行います。
- 評価指標:回帰はMAEやRMSE、分類は適合率・再現率・AUCなどから業務損失に合うものを選びます。
数値が良くても、担当者が説明を理解できない、アラートが多い、結果が必要な時刻に届かないといった場合は、本番化の価値がありません。予測を見た担当者の判断と、その記録の方法を、小さな画面や帳票で確かめておきます。
本番化・テスト・運用改善
本番化後も安定して使えるよう、実装から切替後の運用まで見通します。
- 実装:データ連携、学習ジョブ、推論APIまたはバッチ、画面、権限、監査ログ、通知、バックアップを整えます。
- テスト:欠損、異常値、未知カテゴリ、連携遅延、件数急増、モデル停止時を確認します。
- 監視と再学習:入力・予測値の分布、欠損率、誤差、処理時間を監視し、再学習の計画を作ります。
- 精度低下時:自動判断を続けず手動運用へ切り替え、現場のリスクを抑えます。
LightGBMのシステム開発費用相場とコストの内訳
LightGBMはオープンソースで、公式リポジトリではMITライセンスで公開されています(出典:LightGBM公式リポジトリ、2026年閲覧)。
ライセンス費は抑えられても、システムとしての費用は別に発生します。データ整備、モデル開発、業務システム連携の費用に加えて、クラウドの利用料がかかります。また、テスト、監視、保守にも費用がかかります。
金額は、2026年時点の企画・見積もり用の税別目安です。データの状態や連携本数に加えて、セキュリティ要件や利用者数によっても金額が変わるため、予算を決める前に個別見積もりを取ります。
▶ 詳細はこちら:LightGBMのシステム開発の見積相場や費用/コスト/値段について
段階別の費用と開発期間の目安
費用と期間は段階によって異なります。見積もりの範囲を確認するときは、次の目安を参考にします。
- 企画・データ診断:50万〜150万円程度、2〜6週間。
- PoC:200万〜500万円程度、1〜3か月。
- 小規模本番:500万〜1,500万円程度、3〜6か月。
- 中規模案件:1,500万〜5,000万円程度、6〜12か月。
- 全社規模:5,000万円以上になる場合があります。
PoCには、前処理、特徴量作成、モデル比較、評価、簡易画面などが含まれます。一方、小規模本番では、データ連携1〜2本と学習・推論、APIまたはバッチを実装します。加えて、管理画面や権限、テストも実装します。
複数部門や基幹連携、データ基盤を含み、モデル監視や再学習、監査ログも含む場合は、中規模の目安になります。
全社データや高可用性、リアルタイム連携まで求めると、5,000万円以上になることもあります。
移行や教育まで含めると、範囲はさらに広がります。
モデル以外の工程にかかる費用
見積もりは、工程ごとの費用とデータ処理の範囲を分けて確認します。
- 工程:要件定義、データ診断、設計・環境構築、実装、テスト、移行・教育、保守を分けます。
- 費用配分の目安:要件定義10〜12%、設計・環境22〜24%、実装48〜50%、テスト15〜17%です。
- 配分の記載があれば、モデル部分だけが安く見える見積もりを判別しやすくなります。
- 既存データのクレンジングやコード統合に工数がかかる場合もあります。
- 画面数より、データソース数、更新頻度、例外処理を確認します。
見積もりに権限やログ、精度検証の回数が含まれているかも見ておきます。
クラウド費用と保守費用
月額費用の目安は、稼働方式と可用性、監視や再学習の範囲によって異なります。
- 低頻度のバッチ:計算資源、保存領域、ログ、監視込みで月1万〜10万円程度の構成もあります。
- 常時稼働APIなど:高可用性、複数環境、詳細監視、頻繁な再学習を含め月10万〜50万円以上の場合があります。
費用は、データ量や処理時間、稼働時間によって変わります。
リージョンや冗長化の有無も影響するため、利用予定のクラウド料金計算ツールで試算します。
保守運用費は、初期開発費の年15〜25%程度を見込む見積もりが多いです。障害対応に加えて、モデル評価やデータ項目の変更が含まれるかを確認します。再学習や脆弱性対応も対象になるかを、あわせて確かめます。
LightGBMの開発会社・ベンダー・サービスの選び方
依頼先は、LightGBMを使えるかに加えて、データを業務システムへ実装し、運用まで担えるかを確かめます。
精度を示す資料では、既存システムとの接続や障害時の手動運用は判断できません。利用者教育やデータ変更への対応力も、資料だけでは見えてきません。
候補先には、同じ要件資料を渡します。そのうえで、成果物や体制、費用と保守範囲を同じ基準で比べます。
モデル開発会社とシステム開発会社の違い
依頼先の得意分野をつかんでおくと、必要な担当者や体制を選ぶ目安になります。
- モデル開発会社:特徴量、評価指標、ハイパーパラメータ、説明可能性の検証が得意です。
- システム開発会社:認証、権限、API、画面、既存DB、テスト、移行、保守を設計しやすい傾向です。
両方の知識を持つかに加えて、データサイエンティストと機械学習エンジニア、データエンジニアの連携を確認します。業務側PMとのつながりも見ておきます。
必要に応じて、モデル担当と業務システム担当を組み合わせる方式も選べます。
提案と見積もりで確認する項目
提案と見積もりを比べられるよう、依頼時の情報と確認項目をそろえておきます。
- RFP:予測対象・期間、データの所在・更新頻度、利用者、業務KPI、希望処理時間を記載します。
- 個人情報、既存システム連携、想定運用体制も伝えます。
- 提案:ベースライン、評価方法、適用外ケース、再学習条件、監視項目、障害時の代替手順を確認します。
- 見積もり:一式表記を避け、診断、前処理、モデル、API・バッチ、画面、クラウド、テスト、教育、保守に分けます。
- 成果物:ソースコード、学習済みモデル、特徴量定義、パラメータ、評価結果、インフラ設定、運用手順を含めます。
スクラッチ・マネージド基盤・パッケージの比較
方式は、データ量や推論頻度、社内の運用力、将来の拡張をもとに選びます。
- スクラッチ:柔軟ですが、学習・推論・監視・再学習を整備します。
- マネージド基盤:標準機能を使えますが、利用量に応じた費用が発生します。
- パッケージ:短期間で始めやすく、業務との適合確認が必要です。
スクラッチは、Pythonで独自に組み込む方式です。マネージド基盤では、サービス固有の設計も必要になります。
パッケージは、既存の需要予測や異常検知機能に組み込んで使う形です。その際は、データ形式と業務フローとの合い方を見ます。
▶ 詳細はこちら:LightGBMのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:LightGBMのシステム開発の発注/外注/依頼/委託方法について
LightGBMのシステム開発で失敗しない要件・リスク対策
モデル開発が終わっても、システムは完成したとはいえません。本番後に問題になりやすいのは、データの変化や予測の誤り、権限の不備です。さらに、説明の不足や契約上の責任分界も挙がります。
非機能要件と運用要件は、早めに決めておきます。AIを補助として使うか、人の判断を置き換えるかによって、検証と承認の厳しさも変わります。
データ品質とデータリークの管理
精度が低いときは、アルゴリズムより先にデータを確認します。まず、項目の定義や単位、タイムゾーンを点検します。そのうえで、欠損の意味や重複、外れ値を見直し、ラベルの作り方も確かめます。
学習時と本番時では、同じ前処理を行う必要があります。未来の売上や結果確定後の情報が混ざると、検証のときだけ精度が高く見えるデータリークが起きます。
データは取得時点を保存し、時系列に沿って検証します。さらに、2025年のAIセーフティ評価ガイド改訂でも、データ品質などが重要な評価観点とされています(出典:AIセーフティ・インスティテュート、2025年)。
精度指標と説明可能性の業務要件
回帰では平均絶対誤差や二乗平均平方根誤差、分類では適合率、再現率、AUCなどを候補にします。ただし、採否は指標の数値だけで決めません。
- 業務の数値への置き換え:許容できる金額差や見逃し件数、確認可能なアラート数へ置き換えます。
- 寄与の確認:SHAPなどを使って特徴量の寄与を確かめる方法もあります。
- 説明の設計:重要な特徴量を表示するだけでなく、担当者が誤入力や異常条件に気づき、判断を修正できる情報として設計します。
セキュリティ・法務・契約の事前確認
機微なデータを扱う開発では、取り扱いの条件と責任の所在を、事前に合意しておく必要があります。
- 情報管理:個人・取引・医療・金融データを扱う場合、持ち出し、保存期間、権限、暗号化、ログ、削除方法を確認します。
- 権利帰属:学習データ、特徴量定義、モデル、コード、インフラ設定、テストデータを契約に明記します。
- 責任と費用:障害・誤判定時の責任、再学習費用、精度保証、終了時のデータ返却を確認します。
- 最終判断:判断を誰が行うか契約と運用手順で明確にします。
2026年4月公表の手引きでは、AIの利用形態に応じて、補助・支援型と依拠・代替型という考え方が整理されています(出典:経済産業省「AI利活用における民事責任の解釈適用に関する手引き」、2026年)。
LightGBMのシステムに関するよくある質問
データ量や生成AIとの違い、PoCの扱いで迷うことは少なくありません。
内製か外注かの判断も、考えどころになります。そのため、初回相談やRFPの前に整理しておくと、確認する項目が見えやすくなります。
LightGBMのシステム開発にはどれくらいのデータが必要ですか?
必要なデータ量は、一律の件数では決められません。予測対象の複雑さや特徴量の数、正解ラベルの偏りによって変わります。
- 時系列と誤差:時系列の長さや、業務上許容できる誤差も関係します。
- 過去データの整理:過去データを洗い出し、学習用・検証用・本番想定に分けて、基準と比べます。
- データが少ない場合:モデルを複雑にしすぎず、特徴量を絞ります。そのうえで、交差検証や正則化を行い、現場のルールとの併用も検討します。
LightGBMと生成AIはどちらを選ぶべきですか?
技術を選ぶときは、扱うデータと、業務で実現したい機能から判断します。
- LightGBM:表形式データから数値や確率を安定して予測する用途に有力です。
- 生成AI:文章・画像・音声の生成や自然言語の対話が中心なら候補です。
- 併用:両者は併用でき、予測結果を業務画面に表示し、生成AIで説明文や問い合わせ対応を補助できます。
目的やデータ形式を比べて選ぶのが基本です。さらに、誤りの影響、説明責任、運用費も見ておきます。
PoCで高い精度が出れば本番導入できますか?
PoCの精度だけでは、本番導入を決められません。
- 本番との条件:本番と同じデータ取得条件や処理時間を確かめます。
- 運用の確認:欠損の扱い、権限、監査ログも確認します。
- 利用者と成果物:利用者の判断手順を確かめ、業務KPIが改善するかを検証します。成果物には、適用外のケースと再学習の条件も含めます。
- 切り替えの基準:精度低下をどう検知するか、手動運用へどう切り替えるかを定めておくと、本番化の判断材料がそろいます。
LightGBMのシステムは内製と外注のどちらが向いていますか?
開発体制は、社内にある専門性と、プロジェクトで補いたい役割から考えます。
- 内製:分析・機械学習・クラウド・業務システム運用の担当者がおり、継続改善に工数を割ける場合に向きます。
- 外注:部署間の定義差、複雑な連携、監視経験の不足、短期実証が課題なら進めやすい方法です。
最初のデータ診断とPoCを外部の知見で進め、本番運用は段階的に内製へ移す方法もあります。
契約時には、引き継ぎ資料や教育の範囲を明確にします。ソースコードやモデル、運用手順も、どこまで渡すかを決めておきます。
LightGBMのシステム開発に関するまとめ
大切なのは、モデル単体の精度よりも、データ収集から業務判断、運用改善までを一つの仕組みとして考えることです。
まず課題とKPIを定め、次にデータ診断と基準比較を行います。そのうえでPoCで実現性を確かめ、そのあとに本番化します。
この記事の要点
LightGBMは、表形式データを扱う予測エンジンです。需要予測や異常検知に適しています。価格査定や離反予測にも使えます。
高速な学習や低メモリの利点がある一方で、データ品質や過学習、データリークは管理が必要です。精度低下と説明責任にも備えます。
費用は、ライブラリの価格ではなく、システム全体で決まります。データ整備や連携、画面、監視、保守まで含めて見積もる必要があります。企画・診断から大規模な本番まで、数十万円から数千万円以上の幅があります。
相談前に確認する項目
相談の前に比較の基準と依頼条件をそろえておくと、提案の内容を判断しやすくなります。
- 依頼先の比較:実績に加え、データ診断、業務連携、モデル監視、再学習を比べます。
- 説明可能性、セキュリティ、契約、保守の範囲も確認します。
- 依頼前の整理:予測対象、対象データ、更新頻度、KPI、許容誤差をまとめます。
- 利用者、既存システム、予算、希望時期も整理し、提案と見積もりの精度を高めます。
小さく検証して業務効果を確かめ、段階的に広げていくことが、定着への近道です。
▼関連記事一覧
・LightGBMのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・LightGBMのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・LightGBMのシステム開発の見積相場や費用/コスト/値段について
・LightGBMのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。