
LightGBMのシステム開発は、要件整理から定着までの6つの工程を順に進めます。工程ごとに完了条件を決めて次へ進むことが、本番業務への定着につながります。
▼全体ガイドの記事
・LightGBMのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
LightGBMのシステム開発の全体像
LightGBMは業務システムそのものではなく、表形式データから予測値やスコアを算出する予測エンジンです。そのため、開発の成否はモデル精度に加え、運用の設計で決まります。
入力データを安定して集められるか、予測結果を誰がどの業務で使うかを、発注側と開発会社があらかじめ設計しておく必要があります。さらに、予測が外れたときに人がどう判断するかも、両者で決めておきます。
LightGBMのシステムの概要
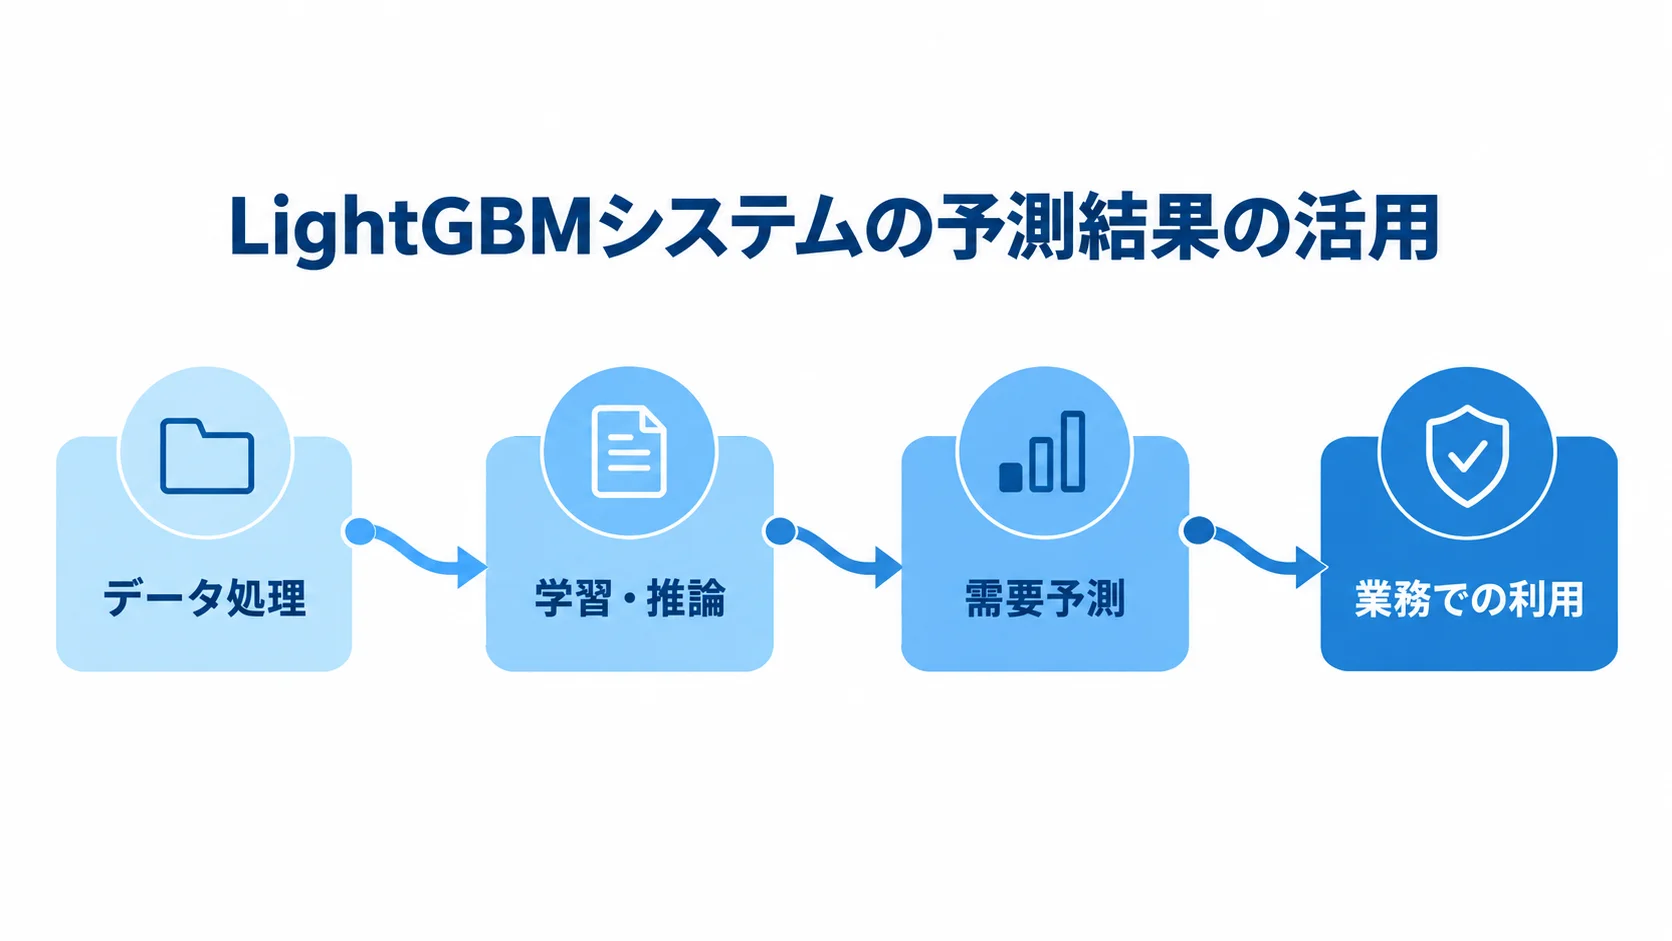
LightGBMのシステムは、データの収集・加工から予測結果を業務で使うまでをつなぐ仕組みです。
- データ処理:基幹システム、CRM、POS、IoT、気象情報などを集め、前処理と特徴量作成までを受け持つ部分です。
- 学習・推論:LightGBMの学習と推論を、業務アプリケーションに組み込む工程です。
- 需要予測:販売実績、曜日、季節、販促、天候から、商品別・拠点別の需要量を算出します。
- 業務での利用:在庫発注画面に結果を表示し、担当者が発注量を承認して初めて業務システムとして機能します。
国土交通省の空き家推定システム設計資料では、データ特性と運用要件を踏まえてLightGBMを採用しています。その理由は、欠損値を含むデータに柔軟に対応できる点などです(出典: 国土交通省「空き家推定システム LINKS SOMA システム設計資料」)。この事例からも分かるとおり、アルゴリズム名だけで判断せず、実際のデータの欠損や運用条件を先に確認することが大切です。
必要な構成要素と業務へのつなぎ方
発注側と開発会社は、業務のリアルタイム性や予測結果の使い方に合わせて、システムの構成を決めます。
- 基盤:データ連携・加工、学習ジョブ、モデル保管、業務画面を揃えた土台です。
- 運用機能:権限管理、ログ、監視、再学習の仕組み。
- 推論方式:在庫予測は夜間バッチで足りる場合があり、異常・不正検知にはイベント後のAPIが必要です。
- 説明性:審査や営業支援では、予測値に加えてSHAPなどで寄与特徴量を示すことが役立ちます。
ただし、寄与度は因果関係を証明しません。そのため、画面では「参考情報」と位置づけ、最終判断者と承認ルールを決めて残しておく必要があります。
要件整理では、予測の頻度と許容遅延を決めます。さらに、1日あたりの件数と、停止時に手作業で行う範囲も決めておきます。それらが決まると、構成の検討を進めやすくなります。
LightGBMのシステム開発の進め方
開発は6フェーズに分けて、要件整理から定着まで順に進めます。各フェーズで何を決めるかは、下の見出しごとに説明します。各フェーズの完了条件を発注側と開発会社で決め、前工程で未確定の事項を次工程へ持ち越さないようにします。
精度目標と業務KPIは分けて定義します。そのうえで、PoCの成果を本番化の判断に使える形にそろえておく必要があります。
フェーズ1:要件整理で決める予測対象と成功条件
「何を予測するか」だけでなく、「予測によってどの業務判断を改善するか」まで言葉にしておく必要があります。たとえば需要予測では、欠品率や廃棄率を指標にします。
また、解約予測では接触対象の抽出後の継続率を、異常検知では見逃し件数や確認時間を指標にします。経営指標と現場指標の両方を設定します。精度の向上そのものを目的にすると、現場が使わない高精度モデルを作る危険があります。
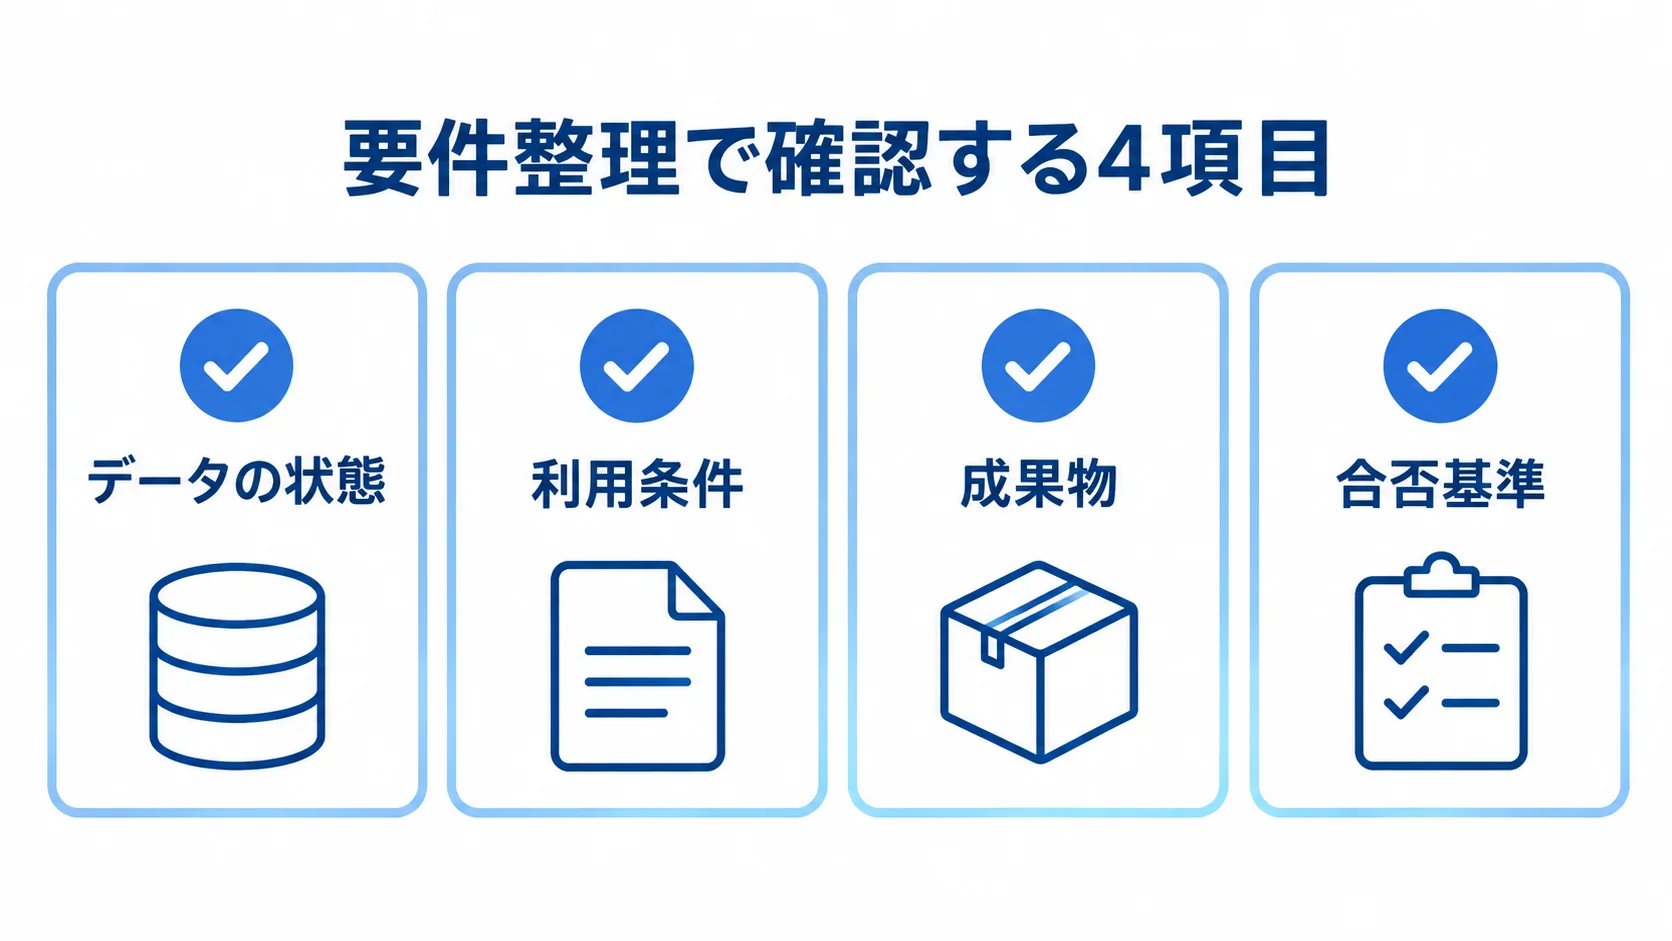
要件整理では、予測対象の粒度、予測 horizon、更新頻度を確認します。加えて、許容遅延と正解ラベルを押さえます。さらに、対象外条件と許容誤差も明らかにします。
- データの状態:保有部署、期間、欠損率、重複の有無。
- 利用条件:個人情報、利用目的、外部データのライセンス。
- 成果物:業務フロー図、KPI定義、データ項目一覧。
- 合否基準:リスク一覧とPoCの合否基準。
フェーズ2:モデルと実行基盤の選定
モデルと実行基盤は、用途に合うかどうかと、運用の条件に合うかどうかの両面から選びます。
- 比較候補:既存ルール、移動平均、XGBoost、ランダムフォレスト。
- 適する用途:表形式データで学習速度や精度を重視する場合は、有力な候補です。
- 別方式の検討:時系列の長期依存や画像・音声・自然言語が主目的なら、他方式が適する場合があります。
- 実行基盤:用途と運用条件に合う基盤を比べます。
少量データでは、leaf-wise成長による過学習に注意が必要です。また、ベースラインを下回る場合には、LightGBMを無理に採用しない判断も大切です。
実行基盤は、Pythonでのスクラッチ実装や、AWS SageMakerなどのマネージドML基盤から選べます。DatabricksなどのMLOps基盤や、既存パッケージへの組み込みも選択肢になります。
AWS公式資料では、SageMaker AIのLightGBMはCPUの単一・複数インスタンス学習に対応しています。また、メモリを十分に確保できる汎用インスタンスが推奨されています(出典: Amazon Web Services「LightGBM – Amazon SageMaker AI」、2026年確認)。
GPUを前提にせず、基盤は学習時間と推論件数で比べます。さらに、可用性と運用担当者のスキルも比較の対象にします。
フェーズ3:データ・モデル・業務連携の設計開発
設計では、データ、モデル、業務連携それぞれの定義を揃えるとともに、運用で残す記録も決めます。
- 特徴量仕様:学習用と本番推論の入力定義。
- 学習・検証データ:時系列データはランダム分割ではなく時系列順に分け、実運用に近い期間で評価する。
- モデル条件:目的関数、評価指標、num_leaves、max_depth。さらに、min_data_in_leaf、学習回数、正則化、早期停止を記録します。
- 評価指標:分類は正解率・適合率・再現率・AUC、回帰はMAE・RMSE・業務上の誤差許容率を使い分ける。
学習時だけ使える未来の情報が混ざるデータリークは、検証の精度を実際より高く見せてしまいます。そこで、後から同じ結果を再現できるよう、モデルのバージョン、学習データの期間、パラメータ、評価結果を保存しておきます。
APIのタイムアウトや重複リクエスト、入力欠損が起きたときの動きを、事前に決めておきます。モデル未登録やクラウド障害の場合も、対応を決めておく必要があります。予測できないときは、直近の実績や手動入力へ切り替えるフェイルセーフが欠かせません。
個人情報や機微なデータを扱う場合は、アクセス権限、暗号化、マスキングを設計書と契約書の両方に記載します。さらに、保存期間、監査ログ、国外移転の有無も、同じ書類に含めます。
フェーズ4:精度だけでなく業務シナリオのテスト
テストでは、モデル精度に加えて、業務シナリオとシステムの受入条件を確かめます。
- 試験範囲:単体、データ連携、モデル評価、画面・API。さらに、権限、性能、障害時も含める。
- 業務シナリオ:入力異常の検知や根拠表示、承認後の発注、アラートの重複を確かめる。
- テストデータ:過去の繁忙期や異常値を含め、本番の弱点を探す。
- 受入条件:テスト期間のMAEが基準モデル以下、欠損率が設定値を超えたら警告、API応答が業務上許容する時間内とする。
- 承認条件:担当者が予測理由を確かめたうえで承認できること。
誤検知を減らすと、見逃しが増える場合もあります。そのため、現場責任者とリスクの優先順位を合意してから、合否を判定します。
フェーズ5:段階的な稼働によるリスクの抑制
稼働では、範囲を絞ったうえで段階を踏んで自動化を進めます。
- 1拠点・1商品群・1業務などに範囲を絞り、予測を表示するシャドーモードで始める。
- シャドーモードで現場判断とモデルの差を確かめ、安定したら承認支援へ広げる。
- 十分な根拠がそろった処理だけを自動化する。
稼働を判定するときは、精度の平均値だけでなく、拠点・商品・顧客層ごとの偏りも見ます。あわせて、予測値の分布や入力欠損率、データ更新遅延も追います。
推論エラーと処理時間は、ダッシュボードで監視します。異常が起きたときの連絡先と復旧手順も、決めておいてください。
再学習を自動化する場合でも、評価に失敗したモデルを本番へ出さないための承認ゲートが必要です。
フェーズ6:監視と教育による現場への定着
本番後は、精度低下の要因を把握したうえで、監視・教育・改善を続けます。
- 精度低下の要因:季節、商品・顧客構成、業務ルール、入力元システムの変化。
- 継続監視:データドリフト、予測分布、実績との誤差、再学習の結果。
- 切替条件:再学習または人手確認へ移る条件。
定着のためには、運用手順書に監視担当者と確認頻度を書きます。閾値と対応期限も、同じ手順書に落とし込みます。
現場の担当者には、モデルの仕組みより先に、次の3点を教育します。予測値は何を意味するか、どの条件で信頼度が下がるか、異常時はどの画面で手動対応するかです。
導入後1か月、3か月、6か月の時点で、利用率、判断時間、業務KPIを振り返ります。問い合わせや誤操作の状況も、あわせて見ます。
振り返りの結果をもとに、特徴量や画面を改善します。モデルは、納品したあとも業務の改善サイクルに組み込んで育てていくことが大切です。
LightGBMのシステム開発の費用相場
LightGBMはオープンソースのため、ライブラリ導入費だけで大きな金額になるわけではありません。費用は、データ診断、特徴量設計、連携の範囲で決まります。加えて、画面やクラウド、テスト、監視、保守も費用に関わります。
以下の金額は税別の目安で、データの状態、可用性、セキュリティ要件、外部委託範囲によって変わります。
企画・PoC・本番化ごとの費用目安
費用帯は、工程と本番システムの規模によって異なります。
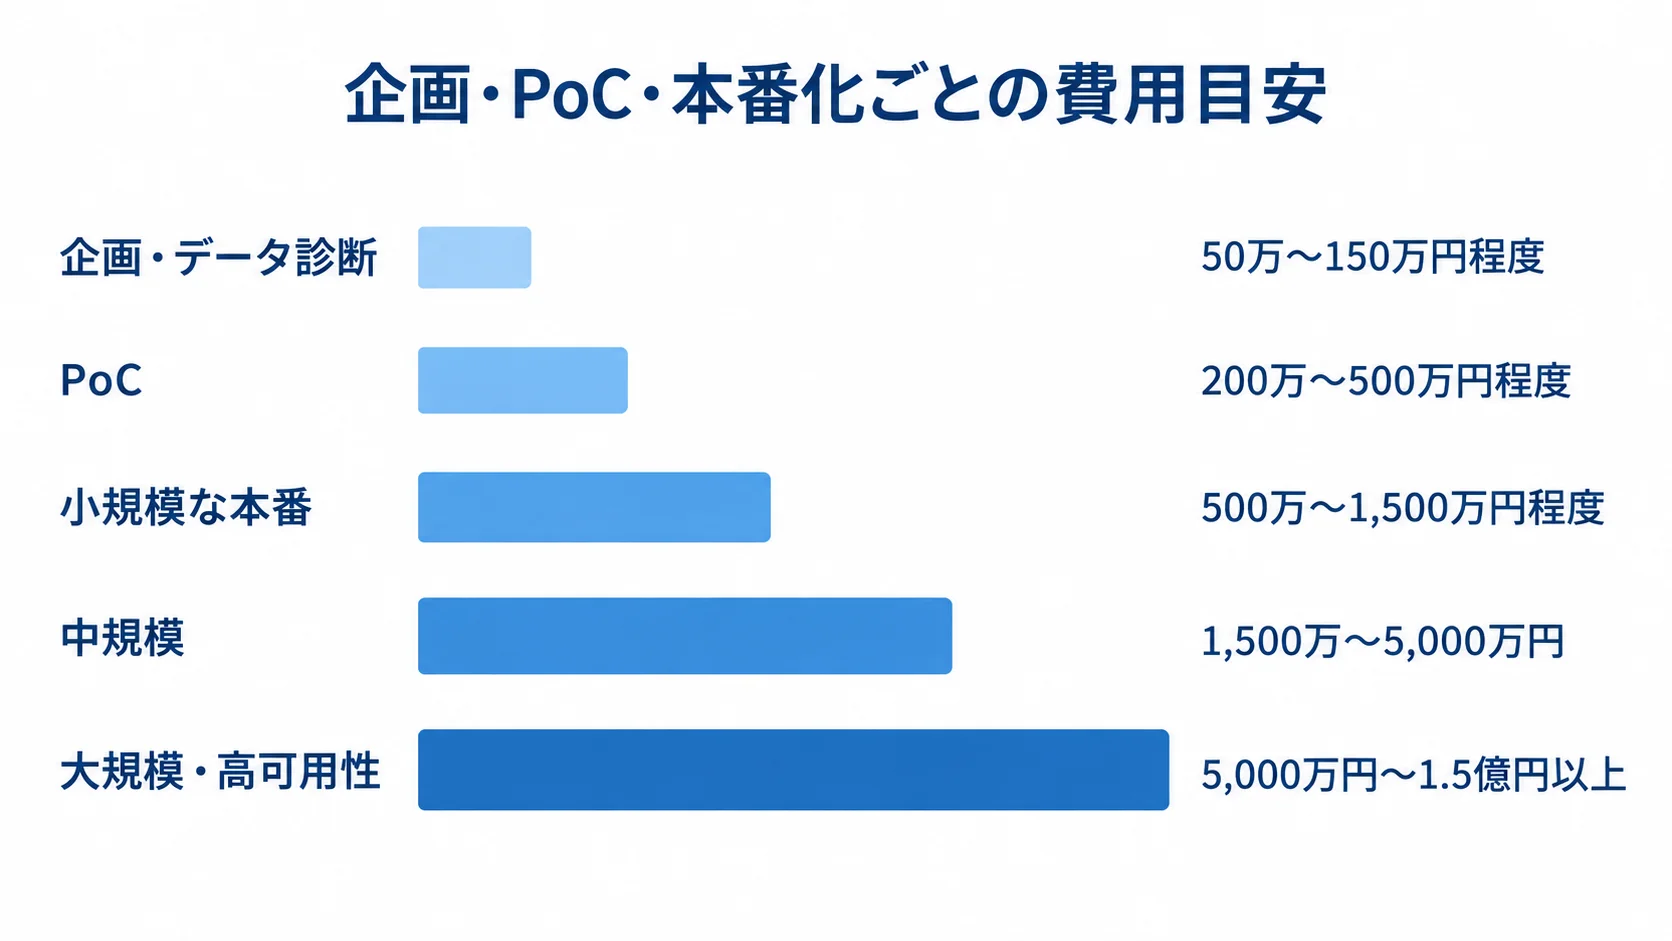
- 企画・データ診断:50万〜150万円程度、2〜6週間。目的、KPI、データ、欠損・ラベル、簡易ベースラインを確かめる。
- PoC:200万〜500万円程度、1〜3か月。前処理、特徴量、複数モデル比較、精度評価、簡易画面を含むことが多いです。
- 小規模な本番:500万〜1,500万円程度。データ連携1〜2本、APIまたはバッチ、簡易管理画面を想定する。
- 中規模以上:中規模は1,500万〜5,000万円、大規模・高可用性は5,000万円〜1.5億円以上。
AI異常判定システムの公開事例で示された200万〜500万円程度は、個別案件の参考値です。一般的な料金表としては扱えません。
中規模以上では、複数の部門や拠点を対象にするほか、DWHや基幹連携、監査ログ、再学習が加わります。大規模・高可用性では、冗長化や移行、教育も含めて範囲を分けて見積もります。
クラウド費用と保守運用費の見方
クラウドと保守の費用は、使い方と委託範囲に応じて見積もります。
- 低頻度のバッチ:月1万〜10万円程度という推定レンジ。
- 常時APIなど:監視や高可用性を含めて、月10万〜50万円以上という推定。
- 保守運用:初期開発費の年15〜25%程度を見込むことがあります。
- 保守範囲:問い合わせ、監視、月次再学習、障害対応、改善、セキュリティパッチの範囲を確かめる。
クラウド費用は、学習頻度と推論方式、データ量によって変わります。稼働時間や監視の有無も影響します。ここに挙げた推定レンジは、特定のクラウドの一律料金ではありません。
AWS SageMaker AIは、利用するサービスやインスタンスに応じた従量課金です。料金ページでは、AWS Pricing Calculatorによる構成別の試算を案内しています(出典: Amazon Web Services「Amazon SageMaker AI pricing」、2026年確認)。
見積書には、リージョンとインスタンスタイプ、稼働時間を記載してもらいます。保存量とログ量も、見積書に含めてもらいます。
保守運用費は、業務システム全般の相場をLightGBM案件に読み替えた目安です。そのため、対象業務に合わせて範囲と金額を確かめておきます。
保守運用費では、再学習の担当者も確かめてください。さらに、データ追加や業務ルールの変更を保守範囲に含めるかどうかは、初期費用と分けて整理します。
LightGBMのシステム開発で見積もりを取るポイント
モデル開発費だけを比べると、判断を誤るおそれがあります。金額は、データの状態や画面・API、監視と再学習の自動化で変わります。障害時の手動運用も、金額を左右します。
依頼の前に、最小構成と本番構成を分けたRFPを作っておきます。そのうえで、各社に同じ前提で提案してもらいます。
RFPに書くべき要件とチェックリスト
RFPには、対象業務と利用者、予測対象と予測期間を記載します。加えて、更新頻度、データ項目と量、保有期間、正解ラベルも盛り込みます。
目標KPIと許容誤差を明示します。さらに、画面やAPIの応答時間、想定件数も含めます。
開発・本番環境の分離、権限、暗号化、監査ログも、RFPに示します。
バックアップや障害時の切り戻し、再学習の条件、運用担当者の体制も、開発会社に伝えます。成果物の範囲は契約書にも記載します。
- 開発成果物:ソースコード、学習済みモデル、特徴量定義。
- 運用成果物:データ加工処理、インフラ構成、Infrastructure as Code。
- 確認資料:テスト結果、評価レポート、運用手順書、第三者OSS一覧。
学習済みモデルや学習データの権利と、再利用の可否は、はっきりさせておきます。退職者や委託先のアクセス、契約終了時のデータの返却と消去も、あらかじめ定めておきます。
開発会社を比較する質問
LightGBMのモデル開発だけでなく、本番システムへの組み込みと運用までの実績も確かめます。候補会社には、次の内容を質問します。
- モデル運用:監視項目と再学習の承認方法。
- システム連携:データ連携方式と既存システムとのAPI。
- 支援範囲:説明可能性、障害時の代替運用、セキュリティレビュー。
- 契約後:引き渡し後の支援期間。
公開事例の数字は参考情報として扱い、自社データで小さく検証します。業界やデータ条件が違うため、同じ改善を前提にしないことが大切です。
2026年4月公開のAVILEN事例では、LightGBMの時系列モデルに気象・発電データを統合しています。さらに、予測誤差を2%以上改善したと紹介されています(出典: 株式会社AVILEN「AIによる高精度な電力需給予測システムの構築」、2026年)。
これは電力業界の個別事例で、自社でも同じ改善が得られるとは限りません。比べるときは、業界とデータ粒度、ベースラインを揃えます。評価期間と改善の定義も、同じ基準で確かめます。
失敗しやすい見積もりと対策
PoCの精度だけで本番化できると考えるのは、よくある失敗です。検証の内容と、本番後の成果条件は分けて整理します。
- PoCの限界:手作業のデータ整備や分析者の判断に依存する場合があります。
- 本番化の準備:毎日のデータ取込、欠損・遅延検知、業務連携の見積もり。
- PoC見積もり:本番化の判断、パイプラインの試作、運用課題を洗い出す作業を含める。
- 成果条件:精度目標に加え、再学習や監視、改善回数、SLA、どこまでを誰が受け持つかを合意する。
将来のデータの変化や業務側の入力変更を、完全に予測することは難しいものです。そのため、精度の数字だけを成果保証として扱うことは避けます。
経済産業省が2026年に公表した手引きでは、AIの開発・提供・利用に関わる当事者の予測可能性を高める考え方が整理されています(出典: 経済産業省「AI利活用における民事責任の解釈適用に関する手引き」、2026年)。
法務とセキュリティ、業務の責任者は、早い段階から検討に加えておきます。
よくある質問
費用や期間のほか、データ量、精度、ライセンス、PoCから本番への移行について、よくある質問に答えます。
LightGBMの導入にはライセンス費用がかかりますか?
LightGBMはオープンソースのため、ライブラリ自体の導入費が開発費の中心にはなりません。一方で、データ加工やモデル開発、API、画面の開発には費用がかかります。クラウドや監視、保守にも、費用が発生します。
第三者ライブラリも含めて、ライセンスの一覧を確かめます。ソースコードと学習済みモデルの利用条件も、契約前に整理しておく必要があります。
学習データが少なくてもLightGBMを使えますか?
使える可能性はありますが、少量データでは評価のばらつきが大きくなります。その理由は、LightGBMのleaf-wiseな木の成長が、少量データで過学習しやすいためです。
max_depthやnum_leavesなどを制御し、交差検証や時系列分割で安定性を確かめます。データを増やせない場合は、単純なルールや既存手法を基準にします。そのベースラインと比べて、導入効果が見込めるかを先に判断します。
PoCから本番システムへ移行する判断基準は何ですか?
移行を判断するときは、モデル指標が目標を満たすことに加えて、次の点も確かめます。
- 業務効果:業務KPIの改善見込み。
- データ:データ更新の安定性。
- 運用体制:現場の利用意向と運用担当者。
- 障害・費用:障害時の代替手順と費用対効果。
PoCでの手作業を本番でも続けるなら、データ連携や監視の費用を含めて、再見積もりが必要です。そのうえで、1つの業務・拠点でシャドーモードを行います。実績と予測の差を確かめてから段階的に広げるのが安全です。
本番稼働後は何を監視すればよいですか?
入力データの欠損率や値の範囲、更新の遅れを監視します。加えて、予測値の分布や実績との誤差も見ます。また、APIのエラー率、応答時間、モデルのバージョンも対象です。
正解データが後から確定する業務では、一定期間後に実績と照合して、再学習の条件を判定します。さらに、異常時の通知先と、手動運用への切り替え条件も決めておきます。ここまで決めて初めて、監視が業務の安全策として働きます。
まとめ
LightGBM開発は、要件整理から定着まで6フェーズを順に進めます。LightGBMは表形式データの予測エンジンとして有力な選択肢です。
本番で使い続けるには、データ連携や特徴量定義、既存業務との接続を設計します。さらに、説明可能性や監視、再学習、手動時の代替運用も、設計の対象に入れます。
開発を成功させる要点
成功には、精度の高いモデルだけでなく、予測対象と業務KPIを設定することが必要です。さらに、現場が使える画面と判断ルールも用意します。
入力データ、モデル、業務アクションを一つの運用として管理します。異常時の手動対応や再学習の承認、受け持つ範囲の分担も決めておくと、導入後の不安を減らせます。
最初に行うべきアクション
まず対象業務とデータを整理し、検証から本番化へと段階的に進みます。
- 対象業務を一つに絞り、過去データの期間、粒度、欠損、ラベルを洗い出す。
- ベースライン、必要な連携、現場利用者、PoCの合否基準を一覧にする。
- データ診断から相談できる開発会社へRFPを渡し、小さく検証してから本番化する。
この順で進めると、費用とリスクを管理しやすくなります。
費用の目安は、企画・データ診断が50万〜150万円程度、PoCが200万〜500万円程度です。本番は小規模で500万〜1,500万円程度、中規模以上で1,500万〜5,000万円程度です。
これらは公開情報や業務システム全般の相場を、LightGBM案件に読み替えたレンジで、確定金額ではありません。データ診断と小さなPoCで、KPIと運用課題を見極めます。
RFPでは、開発費とクラウド費、保守費を分けて比べます。権利と受け持つ範囲も、あわせて見ます。
発注の前には、モデル精度だけでなく、データ品質やセキュリティ、障害時の手動運用を確かめます。
モデルの更新や成果物の引き渡し、現場教育も、事前に決めておきます。そのうえで、自社業務にどう組み込み、どの判断を改善したいかを明確にし、開発会社と実現方法を具体化してください。
▼全体ガイドの記事
・LightGBMのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。