
機械学習基盤の発注は、現状分析と要件定義、限定PoC、本番基盤構築、運用移行の順に進めると、継続利用につながります。
各段階で何を決め、誰が担うかを、ひとつずつ見ていきましょう。全体像は、次の案内にある完全ガイドで確認できます。
▼全体ガイドの記事
・機械学習基盤開発の完全ガイド
AIシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
機械学習基盤の発注・外注の範囲
機械学習基盤は、データを使ってモデルを作る開発環境と、モデルを安全に使い続ける運用環境を合わせたものです。
モデル開発だけを発注すると、データ連携や版管理、推論API、監視、障害時の切り戻しが抜けやすくなります。
データから運用までを含む発注範囲
機械学習基盤の発注では、開発から本番運用までに必要な作業を、一続きの範囲として書き出します。
- 学習用データを加工し、アルゴリズムを選び、評価指標を確かめてAIモデルを作る。
- 毎日または毎月届くデータを取り込み、同じ条件で特徴量を作り、承認済みモデルをデプロイする。
- 予測精度や入力データの変化を確認する。
- 発注書やRFPでは、精度目標に加えて、データパイプライン、実験管理、モデルレジストリ、推論方式、監視、ログ、再学習手順を成果物に定める。
たとえば、教育・スクール事業の離脱予測では、成績、出欠、学習履歴、教材利用状況を連携し、月次でモデルを更新します。
また、自動採点や学習者への推薦では、誤判定が評価や学習機会に影響します。そのため、教師や管理者が確認・訂正できるHuman-in-the-Loopも要件に含めます。
外注で補える専門性と本番運用の経験
外注を検討するときは、必要な専門知識と引き継ぎの対象を、契約前に書き出しておきます。
- データ・機械学習:データエンジニア、機械学習エンジニア
- 基盤・統制:クラウドアーキテクト、セキュリティ担当
- 推進:プロジェクトマネージャーを必要な期間だけ組み合わせる
- 本番運用:権限管理、監査ログ、CI/CD、ドリフト監視、障害対応の知見
- 引き継ぎ:設計書、データ辞書、運用手順、テスト結果、コード、モデル版管理情報
モデル開発の経験があっても、本番運用まで担当した社内人材は限られます。
丸投げすると、ノウハウが社内に残らず、契約終了後に再学習や障害対応が難しくなります。そのため、引き継ぎと研修も契約範囲に含めます。
発注形態の選び方
発注形態は、業務要件の確定度、社内の技術責任者、委託範囲を基準に決めます。調査・PoC・本番化を分け、各段階の成果を確認しながら進める方法が適しています。
構想から運用までを一括で任せる形態
専門人材が社内に少なく、要件整理の段階から任せたい場合は、一括外注が向きます。委託先は、データを洗い出し、ユースケースを選び、クラウドを設計します。そのうえで、モデル開発から業務画面、監視、保守までを管理します。
大手SIerや基盤構築の経験がある開発会社で使いやすい形態です。
不確実なデータ品質やモデル精度まで固定価格で約束すると、変更費用が増える場合があります。そのため、要件定義、PoC、本番構築、運用移行ごとに受入条件と中止条件を設けます。
クラウドとMLOpsを使った部分委託
マネージドサービスを使う場合は、自社と委託先の担当範囲を分けて決めます。
- 基盤の選択肢:AWS SageMaker、Azure Machine Learning、Google CloudのVertex AI
- 自社で管理:データや業務アプリ
- 委託する範囲:基盤設計、パイプライン、監視
クラウドの標準やデータウェアハウスが決まっている企業では、構築期間を短くしやすくなります。
Google Cloudの公式資料によると、Vertex AIには学習やパイプラインが用意され、Model Registry、Feature Store、モデル監視も備えています。
AWSの公式料金ページによると、Processing、Feature Store、Training、リアルタイム推論、バッチ変換などは、利用量に応じて課金されます。
常時稼働するサービスの有無によって、料金と担当範囲が変わります。そのため、委託先に構成図と月次費用の試算を作ってもらいます。
内製と外注を分ける共同開発
社内にプロダクト責任者やデータ担当がいる場合は、業務要件とデータ定義を自社で持ち、基盤設計・実装や難しいモデル開発を委託できます。
自社が意思決定を担い、委託先が専門性を補う形なので、内製化やベンダー切り替えにも対応できます。
共同開発では、コードの管理場所やレビュー方法などの進め方に加えて、意思決定者と承認者を決めます。議事録と決定事項も納品物に含め、設計判断が記録されない事態を防ぎます。
RFPと要件整理の記載項目
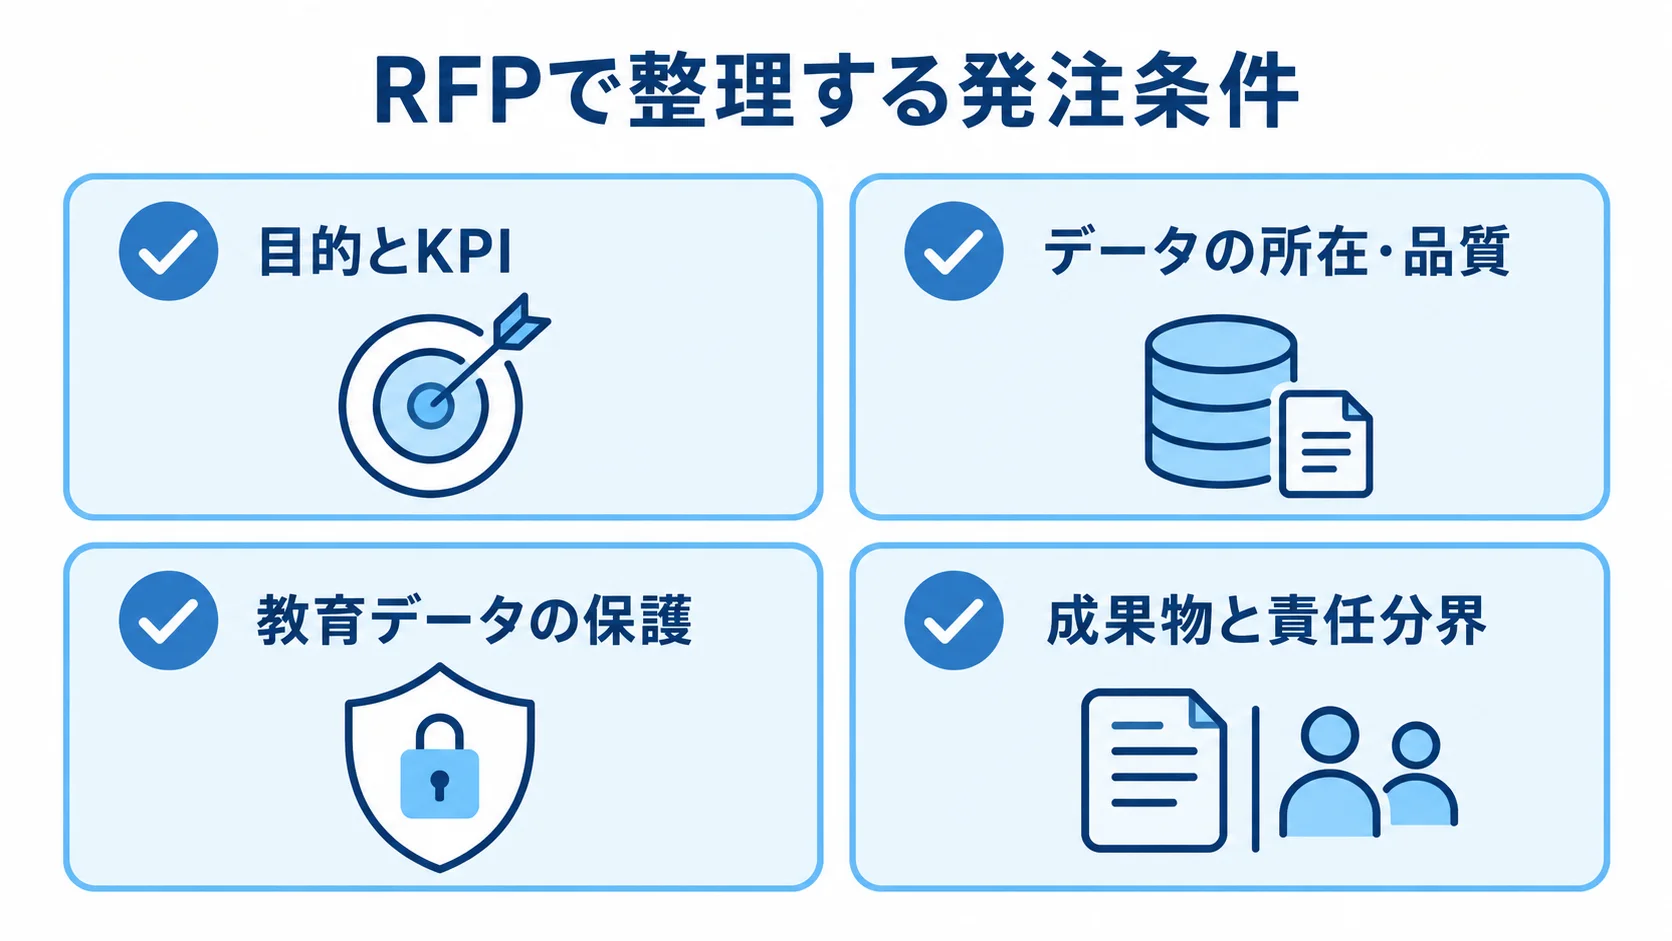
RFPは、同じ前提で提案・見積してもらうための発注条件書です。目的や対象業務、データ状態に加えて、利用者、セキュリティ、希望日程、予算の考え方、納品物、保守体制を項目ごとに分けて書きます。未確定の事項も明記します。
精度以外も含む目的とKPI
RFPには、「何のモデルを作るか」より「どの業務をどう変えるか」を書きます。そのうえで、導入前後で測れるKPIを定めます。
精度だけを成功条件にすると、現場での確認しにくさや予測までの遅さを見落とします。
- KPIの例:離脱予測は離脱率やフォロー対象の発見数、答案採点は講師の採点時間、教材推薦は利用率や継続率
- PoCの判断基準:目標値と、本番化を見送る基準
- 測定項目:評価指標、現場利用率、1件あたりの処理時間、担当者の確認時間、月額クラウド費用、誤判定の修正時間
機械学習は、データを確認して初めて実現可能性が分かります。そのため、事前に測定方法まで決めておくと、提案を比較しやすくなります。
データの所在・品質と個人情報の扱い
RFPでは、データの状態と個人情報の扱いを、次の観点から書き出します。
- 所在と形式:システム名、形式、件数、更新頻度、保管場所、保有者
- 品質とラベル:欠損・重複の状況、ラベル作成者
- 連携対象:LMS、学籍・成績、出欠、CRM、教材、答案、講師記録。方式と名寄せの扱いも書く
- 紙・PDF:OCR、目視確認、匿名化、ラベル付けを見積対象にする
- 教育データの保護:保存地域、暗号化、権限、監査ログ、バックアップ、再委託、二次利用
文部科学省は令和7年3月の「教育情報セキュリティポリシーに関するガイドライン」で、教育現場に応じた対策を示しています。そのうえで、RFPでは準拠するかどうかに加えて、アクセスできる人、記録する操作、記録期間まで具体的に書きます。
成果物と責任分界の一覧
納品範囲には、設計から運用、研修までの成果物を含めます。
- 設計・基盤:要件定義書、データフロー図、データ辞書、クラウド構成図、IaCや設定ファイル
- 開発・運用:学習・推論パイプライン、実験ログ、モデルレジストリ、API仕様書、監視ダッシュボード
- 検証・引き継ぎ:テスト計画と結果、運用手順書、障害時の復旧手順、研修資料
再現性や保守性を保つには、モデルそのものに加えて、設計や手順などの成果物もそろえる必要があります。
- 担当の分担:データ提供、アノテーション、クラウドアカウント、脆弱性対応、モデル承認、リリース判断、アラート一次対応、障害復旧、再学習
- 精度低下時:原因調査の担当者、再学習の時期、本番反映の承認者
発注・外注の工程の順序
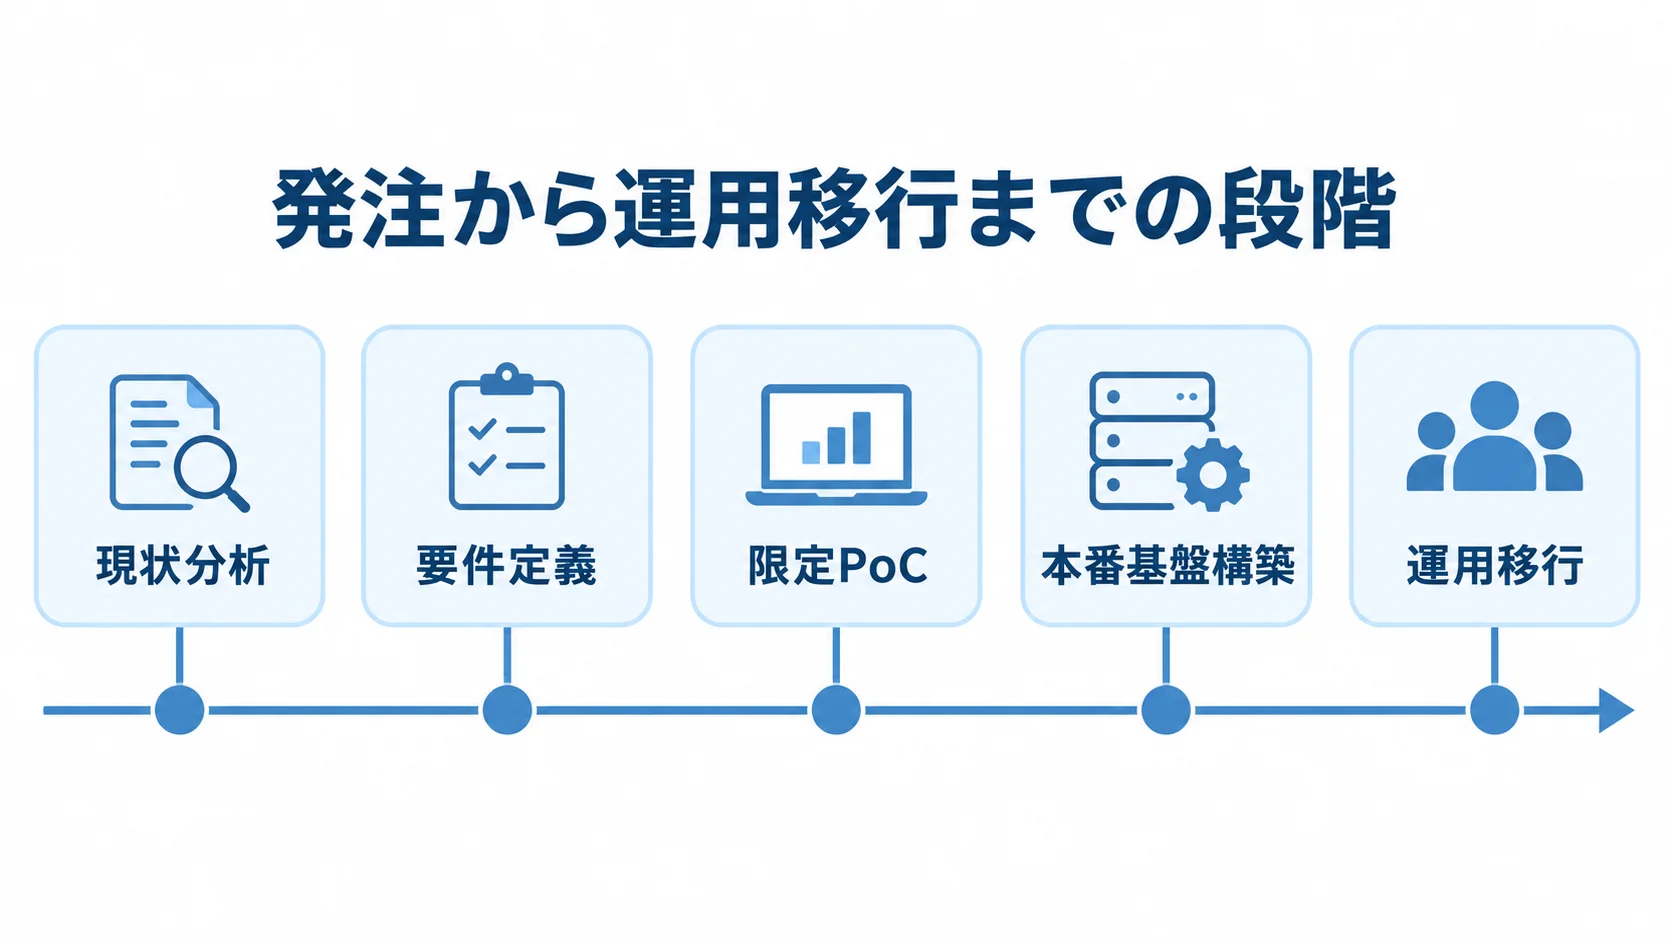
工程は、現状分析と要件定義から始まり、限定PoCと本番基盤構築を経て、運用移行へ順に進みます。まず、現状分析と要件定義で発注条件を固めます。各段階で分かったデータ品質や業務評価を次の条件に反映すると、過剰投資と手戻りを抑えられます。
現状分析と要件定義で固める発注条件
最初に関係者を集め、目的と制約を確認します。
- 参加者:業務責任者、現場利用者、情報システム、セキュリティ、法務、データ管理者
- 既存環境:システムのAPI、CSV出力、データ更新、権限、ネットワーク、契約中のクラウド
- 実現性と見積:使えるデータ、ラベル作成者、業務で許容できる誤りを確認する
- 要件定義:ユースケース、KPI、データ項目、セキュリティ分類、非機能要件、運用体制を文書化する
- 承認:受入基準、未決事項、リスク一覧を成果に含め、社内の意思決定者が承認して優先順位を決める
ここで前提をそろえておくと、見積精度の向上につながります。
小規模PoCによるデータと業務効果の検証
PoCは、1校や1学年、1教科、1業務などに範囲を限って、モデルの実現性と現場の使いやすさを確かめます。精度だけでなく、推論表示までの時間や担当者の確認・修正時間も測ります。
あわせて、予測の説明に必要な情報、再現可能な学習手順、1か月分の処理費用も評価します。なお、NotebookLMのリサーチでは、現状分析から限定PoCを経て本導入へ進む順番が有効と整理されています。
Classiの自動作問では、制作時間が24%、制作費が38%削減された事例があります。ただし、個別の事例はそのまま当てはめず、自社の導入前の指標と比べます。
本番化と運用移行の進め方
本番化から運用移行までは、次の順で仕組みを整えます。
- 本番化ではデータ取り込み、学習、モデル承認、段階リリース、APIまたはバッチ推論、権限、バックアップ、監視、アラート、ロールバックを整備する。
- 運用移行ではマニュアルを渡し、アラート訓練で精度低下、入力欠損、推論遅延、費用急増、権限エラーを想定する。
- 訓練では、誰が何分以内にどの画面を確認し、どこへ連絡するかを決める。
- 旧モデルへ戻す条件も確かめる。
データ分布の変化や、推論結果が業務システムへ届かない事態に備えるには、開発環境のコードを本番へ移す以上の準備が要ります。
運用保守を外注する場合は、受付時間やSLA、月次レポートを決めます。さらに、再学習の回数と追加費用も決めておきます。
請負と準委任の使い分け
成果物と完成条件が明確な工程は請負、不確実性が高く作業や検討を依頼する工程は準委任を基本にします。機械学習は、データ確認の前に精度や工数を確定しにくいため、工程ごとに契約を分けます。
成果物と受入条件を固められる工程の請負契約
請負は、合意した成果物を完成させ、発注者が検査・受入をする工程に向きます。仕様と基準を決めやすい、データ連携や画面、APIなどに使いやすい契約です。
権限設定やテスト、文書も、仕様と基準を定められるなら請負の対象になります。契約書と仕様書には、納期や検査期間、修補、知的財産権などのほか、再委託や秘密保持も記載します。
「高精度モデル」という書き方では、完成条件が曖昧なままです。そこで、モデルを請負の対象にする場合は、対象データと評価用データ、指標、測定手順を定めます。さらに、許容範囲や再現条件、基準に届かなかった場合の追加検証や中止の扱いも決めておきます。
調査・検討・専門人材の支援での準委任契約
準委任は、専門家による調査や設計、分析、開発支援のように、作業内容と稼働に対して報酬を払う形です。データ品質の確認やクラウド方式の比較のほか、実現可能性調査やPoCの仮説検証にも使えます。
稼働時間を消化するだけで終わらないよう、月次計画や成果報告、判断待ちの事項、次月の仮説を、設計資料やコードとあわせて確認します。
発注者は、委託先の担当者に直接指示を出さず、契約上の責任者を通じて依頼と承認を行います。
調査の準委任と本番構築の請負の組み合わせ
工程の不確実性に応じて、準委任、請負、保守契約を組み合わせます。
- 契約形態:調査・要件定義・PoCは準委任、本番構築は請負、運用保守は月額準委任または保守契約
- 工程間の引き継ぎ:PoC後に本番範囲を見直し、責任が切れないよう資料と意思決定の期限を決める
- 契約前の確認:モデルやコードの権利、学習データ利用、生成物の再利用、OSSライセンス、クラウドアカウント、終了時のデータ削除・エクスポート
- ガバナンス:経済産業省のAI事業者ガイドライン第1.2版は2026年3月31日公表。委託契約で最新の方針との整合を確認する
機械学習基盤の外注費用相場
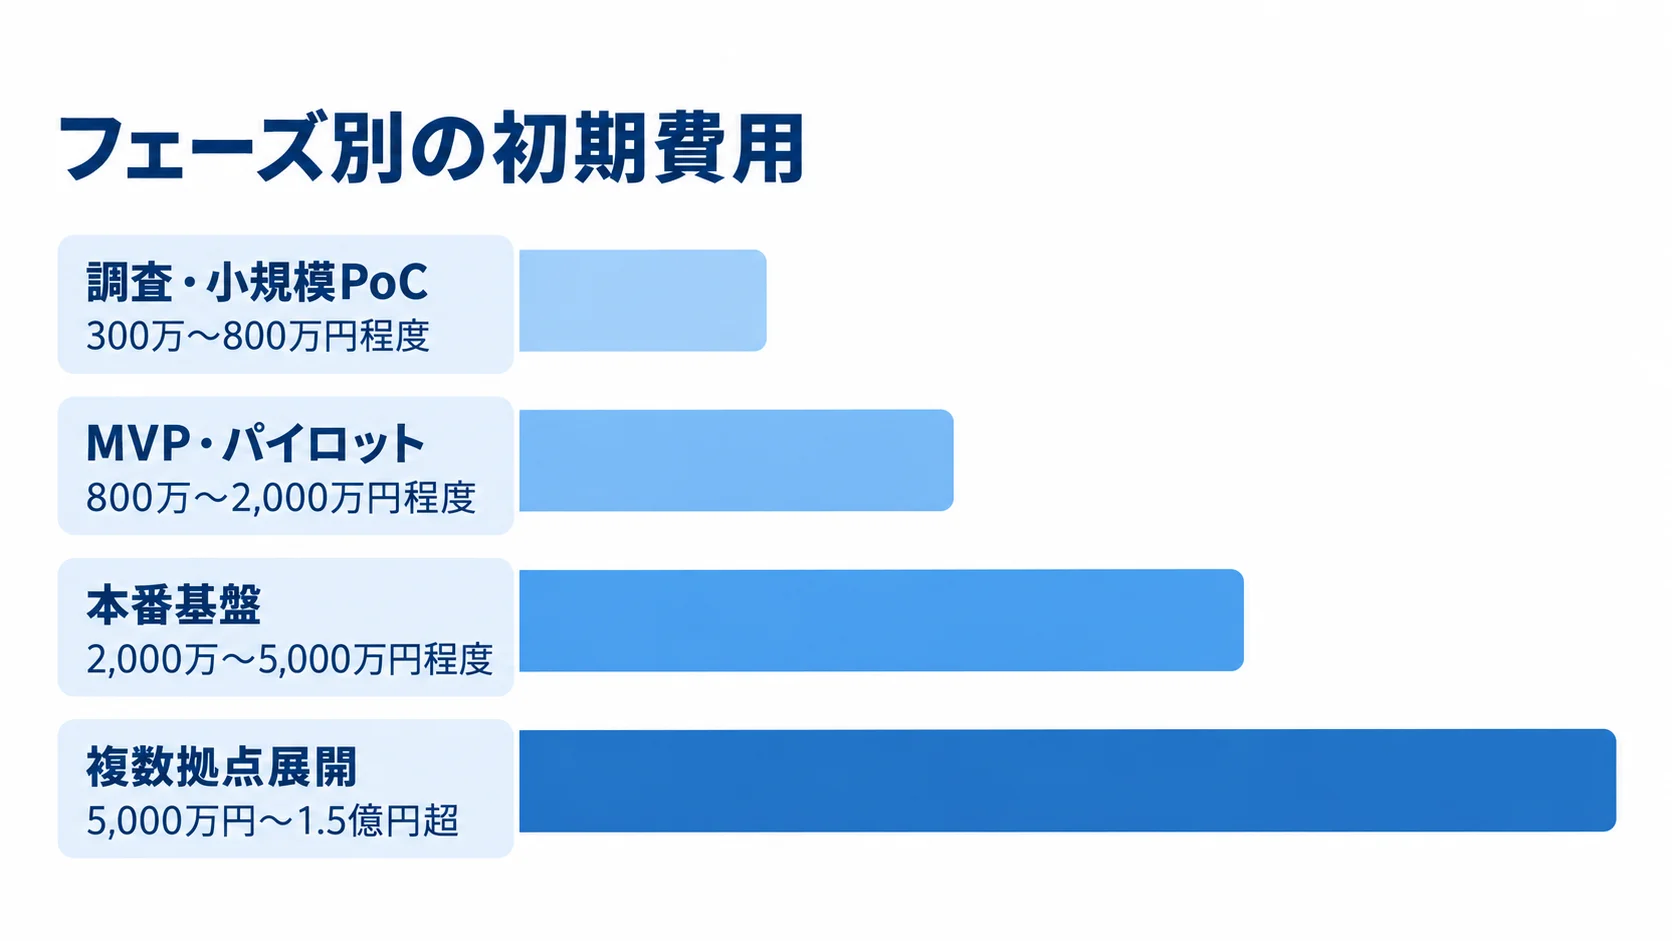
国内の機械学習基盤の受託開発では、規模やデータ状態をまたいだ統一の価格表は、ほとんどありません。ここに示すのは、教育向けAIアプリやデータ分析基盤、MLOps導入などの類似案件から作った、予算取り用の推定レンジです。
この金額は目安であり、モデル数や連携数、データクレンジングによって変動します。インフラの条件と対象範囲も、金額を変えます。
- 閉域網:閉域接続や冗長化を含むかどうか
- GPU:常時稼働させる計算環境の有無
- 業務画面:見積に含める画面の範囲
- 保守時間:保守に必要な作業の時間
フェーズ別の初期費用の幅(300万円台〜1億円超)
初期費用は、フェーズと導入規模によって幅があります。予算を取るときは、次のレンジを目安にします。
- 調査・小規模PoC:1ユースケースで評価画面まで、300万〜800万円程度
- MVP・パイロット:1〜2モデル、データ連携、簡易API、初期監視を含み800万〜2,000万円程度
- 本番基盤:複数モデル、レジストリ、CI/CD、権限・監査、業務画面を含み2,000万〜5,000万円程度
- 複数拠点展開:閉域接続・冗長化・移行・24時間運用込みで5,000万円〜1.5億円超
これらは類似案件からの推定値で、公開された一律の相場ではありません。特に、紙やPDFの電子化、名寄せ、ラベル付け、既存の学務システムとの連携がある場合は、モデル開発の前段で費用と期間が大きくなることがあります。
クラウド・GPU・保守のランニング費用
運用費は、項目ごとに分けて把握します。
- 計算資源:GPUを含む計算環境
- データ保管・連携:ストレージ、転送、データベース
- 可用性:ログ・監視、バックアップ
- 提供・運用:API、保守人員
小規模なクラウド構成は、月50万〜300万円程度が推定レンジです。保守や常時稼働のGPU、リアルタイム推論の有無で変わるため、開発費とクラウド利用料を分けて示してもらいます。
Azure Machine Learning自体に追加料金はありません。ただし、計算資源以外にBlob StorageやKey Vaultを使う場合も料金が発生します。また、Container RegistryやApplication Insightsなどにも利用料が発生します(出典:Microsoft「価格 – Azure Machine Learning」、2026年確認)。
同ページの例では、10台のVMで100時間の学習が1,196米ドル、10台を30日間終日稼働させる推論が8,611.20米ドルです。これは米国西部2の例で、契約やリージョン、為替、割引によって変わります。そのため、自社の料金計算ツールで再計算します。
作業項目と前提条件に分けた見積書の確認
見積書では、要件定義やデータクレンジング・OCR、クラウド・ネットワーク、モデル開発を、それぞれ独立した項目にします。さらに、アプリ・APIとMLOps・監視は別の項目で示してもらいます。加えて、セキュリティ審査、移行・研修、保守運用の費用も、分けて示してもらいます。
各項目では、担当者、工数、期間を見ます。そのうえで、次の条件も確認します。
- 成果物:納品される範囲
- 前提:見積の前提となる条件
- 対象外の作業:見積に含まれない作業
- 追加料金の条件:別料金になる条件
たとえば、データ整備やテスト、障害対応、研修などが別料金だと、見積が安くても総額が増えることがあります。
見積が高いときは、不要な常時稼働のGPUや過剰な冗長化、使われないリアルタイムAPIがないかを確認します。判断は、金額そのものより、前提をそろえた総保有コストで行います。
機械学習基盤の委託先選定と見積比較
委託先は、AI実績に加え、データ連携やクラウド、セキュリティ、業務アプリ、運用保守の担当範囲で比べます。クラウド提供会社と、設計・開発・運用を請け負うSIerは役割が異なるため、提案範囲を確かめます。
構成図とデモによる実装力の確認
委託先の実装力は、設計とデモで確かめます。
- 構成図:データ取り込み、学習、承認、デプロイ、推論、監視、再学習
- 管理と検知:レジストリ、実験管理、本番モデルの版、欠損や分布変化の検知画面
- 提案・実演:匿名化した設計例やPoCデモで、業務要件を技術へ落とす力
- Microsoft環境:Microsoft 365、Entra ID、社内人材との親和性
- Google・AWS等:Google Workspace、BigQuery、AWS基盤、校務ネットワーク、閉域接続との親和性
OSSを使う提案では、KubernetesやMLflowなどの更新、脆弱性対応、障害時の担当者も確かめます。
教育データや機微情報を扱える体制
教育データを扱う提案では、情報保護と人による確認の仕組みを確かめます。
- 対象情報:生徒・保護者情報、成績、出欠、答案、学習履歴
- アクセス管理:個人情報の処理環境、本番データへのアクセス承認と記録
- データ保護:匿名化、最小権限、環境分離、監査ログ、保存期間、削除手順
- 人による確認:誤判定の説明と教師が推薦・採点を確認する画面
- 判断の記録:判断理由の記録、訂正データの次回学習への利用ルール
提案の説明が精度の高さだけで終わる場合は、運用時に誰がどこまで受け持つかを追加で質問します。
同じRFPによる複数社の見積比較
各社には、同じRFPとデータ概要、納期条件、前提をそろえて提案を求めます。比較表には、要件への対応や初期・クラウド・保守の費用、開発期間、社内工数を並べ、成果物、除外項目、リスク、追加費用の条件も書き込みます。
順位は、前提が現実的か、未確定の事項を明示しているかを見て決めます。あわせて、面談には実装と運用の担当者にも参加してもらい、データ品質や監視、障害対応、引き継ぎを確かめます。
見積の差が大きいときは、データ整備やセキュリティ審査、テスト、保守、クラウドの常時稼働の有無を照らし合わせます。
機械学習基盤の外注で起きやすい失敗と対策
失敗は、アルゴリズムの選び方より、目的の曖昧さやデータ品質、担当範囲の決め方、運用設計の不足から起きやすくなります。そのため、失敗の条件を事前に言葉にして、契約と計画に反映します。
データ不足によるモデル評価止まり
過去データの不足、ラベル定義のばらつき、欠損や重複、システム項目の変更があると、精度を正しく測れません。そのため、発注前にサンプルで、データの状態を調べておきます。
欠損率や重複率、期間、対象者数、ラベル一致率を確かめます。問題が残る場合は、PoCの目的をモデル完成からデータ整備と評価設計へ切り替えます。
PoCコードをそのまま本番へ移す失敗
ノートブック上のモデルをそのまま移すと、権限や再現性、テスト、監視、ロールバックが不足しがちです。そのため、PoCを始めた時点から、コードとデータの版管理、評価データの分離、モデル登録、APIまたはバッチの条件、ログ出力を設計しておきます。
本番化しないPoCでも、将来の判断に必要な実験記録を残しておきます。
運用担当と再学習の責任者の未決定
精度が落ちたとき、委託先は開発完了を、社内は保守範囲を前提に考えがちで、対応が止まることがあります。そのため、運用設計書で担当と確認事項を明確にしておきます。
- 再学習とリリース:ドリフト確認者、調査閾値、学習データ承認者、リリース担当
- 月次確認:利用状況、精度、遅延、費用、インシデント
- 費用管理:学習、ストレージ、推論、監視、モデル管理にかかる費用
AWSは、Savings Plansで最大64%の削減可能性を掲載しています(出典:AWS「SageMaker料金」、2026年確認)。
利用量を確約する契約のため、ワークロードの安定性を確かめてから選びます。
停止できるGPUやバッチ化できる推論、ログの保存期間も含めて管理します。
短期PoCや利用量が変動する案件では、マネージドサービスが始めやすい選択肢です。SageMaker、Azure Machine Learning、Vertex AIなどを利用できます。
よくある質問(FAQ)
発注では、費用や技術のほかに、社内体制や契約後の運用についての質問もあります。
機械学習基盤の外注は最低いくらから相談できますか?
一律の最低金額はありません。調査やデータの洗い出し、小規模PoCは、予算取り用の推定レンジで300万〜800万円程度です。
データの状態や連携数が分からないままでは、金額を断定できません。そのため、有償の現状分析を依頼し、その結果をもとに本番構築を再見積もりする方法が安全です。
クラウドとオンプレミスはどちらを選ぶべきですか?
短期PoCや利用量が変動する案件では、マネージドサービスが始めやすくなります。SageMaker、Azure Machine Learning、Vertex AIなどを選べます。
閉域接続や保存地域、既存ネットワーク、常時稼働のGPU、社内人材を考慮に入れます。機微情報を外部に出しにくい場合や、負荷が一定の場合は、専用環境やオンプレミスも比べます。
機械学習の専門家が社内にいなくても発注できますか?
発注はできますが、社内には業務責任者と意思決定者が必要です。目的や許容できる誤判定、データ利用の可否、モデル出力の最終承認者は、発注者側で決めます。
将来の運用に備えて、設計書と研修を納品範囲に含めます。
見積比較で一番重視すべき項目は何ですか?
初期費用の安さより、同じ範囲で比べられているかを重視します。そのうえで、データ整備からクラウド費用、保守までの範囲を各社でそろえます。セキュリティ審査やテスト、監視、障害対応、引き継ぎも、同じ範囲に含めて比べます。
成果物と、どこまでを誰が受け持つかを確認し、業務や運用の担当者が提案に加わっているかも判断材料にします。
まとめ
機械学習基盤の発注では、データ整備、クラウド、MLOps、監視、セキュリティ、保守運用までを、ひとまとまりの仕組みとして考えます。
調査やPoCは準委任、本番構築は請負、運用は保守契約に分けると、責任範囲を整理しやすくなります。
RFPには、目的とKPI、データの所在と品質、個人情報の扱い、権限や監査ログを書きます。さらに、成果物や受入条件、引き継ぎ、クラウド費用、再学習と障害対応の担当者も記載します。
複数社の見積を同じ前提で比べ、継続利用できる設計と運用体制まで確認します。
▼全体ガイドの記事
・機械学習基盤開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。