
機械学習基盤は、データ管理、モデル開発、運用を支え、AIを継続して使う土台です。再現性や安全性、運用時の精度低下には、GPUとモデルの用意に加えて、基盤の整備が必要です。
基盤の機能と種類、開発の進め方、費用、安全な運用、開発会社の選び方を解説します。詳細は、下の関連記事で確認できます。
▼関連記事一覧
・機械学習基盤開発の進め方/やり方/流れや方法/手法/工程/手順
・機械学習基盤開発でおすすめの開発会社/ベンダー6選と選び方
・機械学習基盤開発の見積相場や費用/コスト/値段について
・機械学習基盤開発の発注/外注/依頼/委託方法について
AIシステム開発の種類・工程・費用・会社選定までの全体像については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
機械学習基盤の全体像
機械学習基盤は、データ基盤、開発環境、モデル管理、提供環境、運用管理を組み合わせた仕組みです。利用者の目に入るのは予測画面や推薦機能ですが、その裏側では、データを正しく集めて同じ条件で学習を再現しています。さらに、承認済みのモデルだけを安全に提供する流れも整えられています。
機械学習基盤の定義
機械学習基盤とは、学習用データからモデルの運用までを継続的に扱う共通環境です。
- データ管理:取り込み、前処理、特徴量の作成を行う
- モデル開発:実験、学習、評価を記録する
- 提供と運用:デプロイ、推論、監視、再学習を扱う
モデルのファイルや推論APIだけを作る場合とは異なり、「誰が、いつ、どのデータとコードで、どの評価結果のモデルを作ったか」を追跡できる点が大切です。
教育分野では、学習時間、正答率、出欠、成績、教材の閲覧履歴、講師の指導記録などを扱います。学校や教室ごとに形式が違うと、名寄せ、欠損補完、OCR、匿名化といった前処理が必要になります。モデルの精度を高める前に、利用目的とデータの正確性を決めることが、基盤づくりの出発点です。
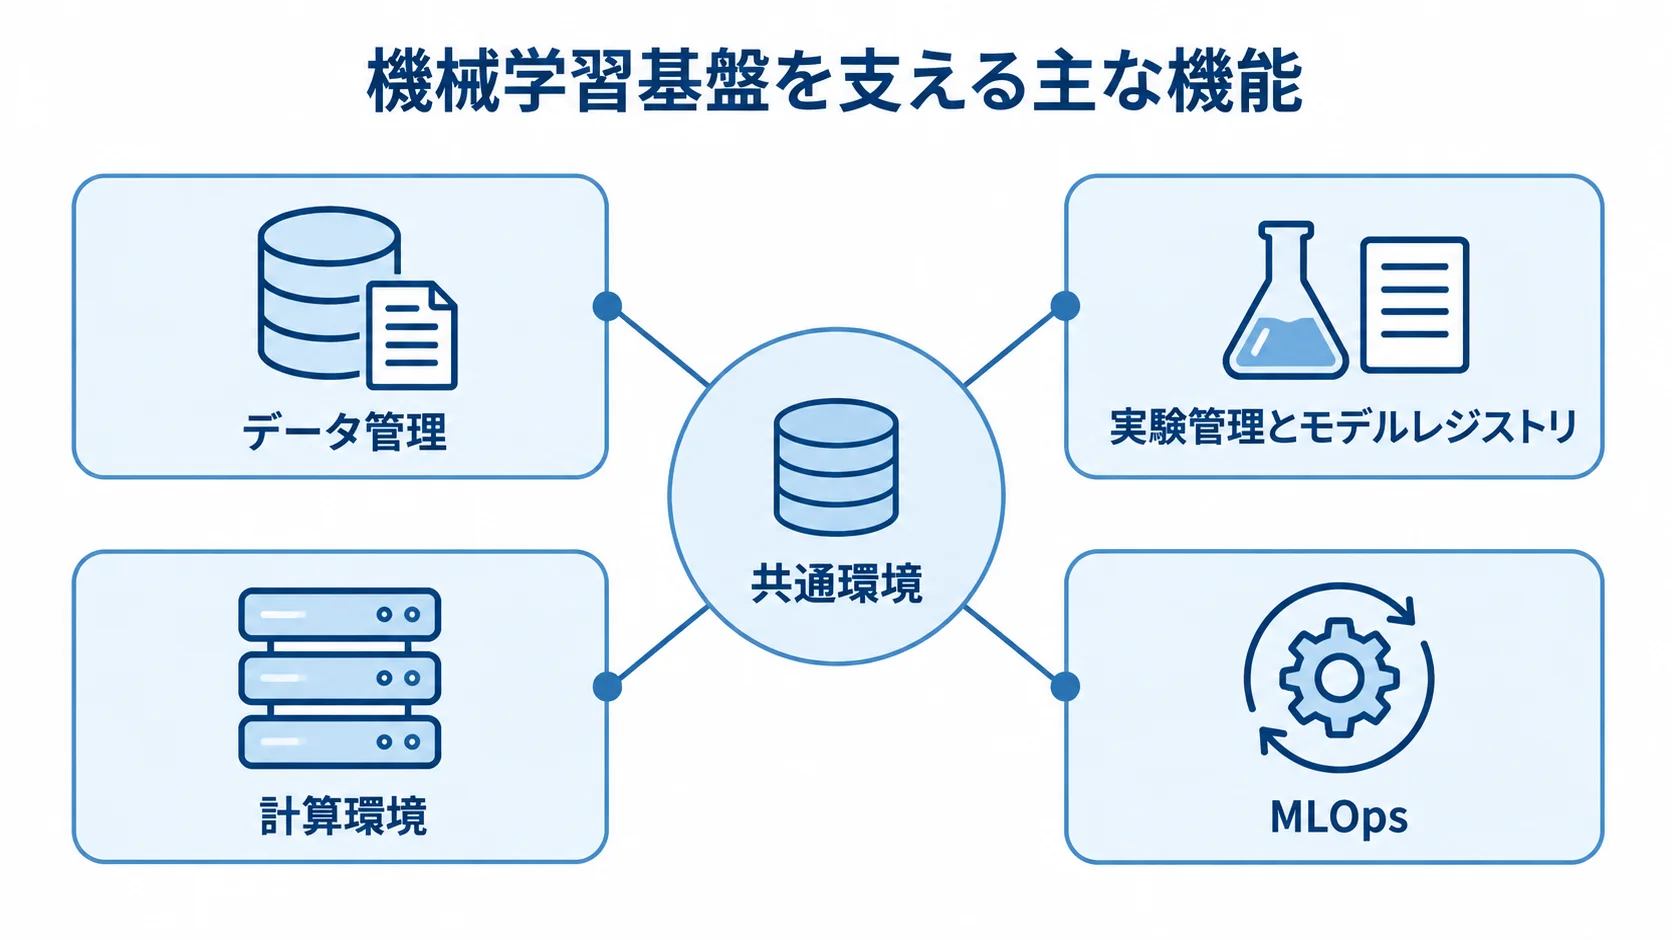
機械学習基盤を構成する主な機能
機械学習基盤には、データから運用までを支える機能が必要です。
- データ管理:データの取り込み・蓄積と、利用条件の記録
- 実験管理とモデルレジストリ:データセット、コード、評価指標、版の記録
- 計算環境:学習用のCPU・GPUと推論環境
- MLOps:学習・承認・公開の自動化と、稼働状況の監視
データ基盤では、LMS、学務システム、CRM、教材管理、テスト結果などのデータを集めます。収集にはAPI、CSV、ETLを使い、データレイクやデータウェアハウスに保存します。
データの所有者、利用目的、保存期間、アクセス権限、削除方法を記録しておくと、監査や問い合わせに答えやすくなります。
モデルレジストリでは、使用データ、コード、ハイパーパラメータ、評価指標、モデルの版を記録し、再現性を確保します。
推論では、バッチ推論で足りる処理とリアルタイムAPIが必要な処理を分けて、性能と費用を個別に調整します。
MLOpsでは、データの更新を検知して、学習・評価・承認・デプロイを自動化します。さらに、異常時に前のモデルへ戻せる状態も作ります。
精度やデータドリフト、推論遅延、エラー率などを監視すると、業務の変化に合わせて基盤を運用できます。利用状況やクラウド費用、異常アクセスも対象になります。
機械学習基盤でできることと種類
機械学習基盤の種類は、何を作るかだけでなく、どこまでを共通化するかで決まります。利用頻度が低い単発の分析なら簡易な環境で足りる場合がありますが、複数のモデルを長期運用するなら、データ・実験・デプロイ・監視を共通化した基盤が必要です。
教育・スクール領域の活用例
教育現場では、学習者の状況把握や授業運営を支えるために、次のような活用ができます。
- 離脱予測:学習時間などを基に、つまずきを見通す
- 教材推薦:学習者ごとに教材を提示する
- 答案の自動採点:採点の作業を支援
- 問い合わせ分類:内容の種類を判別
- 傾向・異常の分析:成績や受講状況を調べる
たとえば、単元別の正答率からつまずきを予測し、講師に確認対象を示す仕組みが考えられます。ただし、予測結果を生徒への処遇に直結させず、講師や管理者が根拠を確かめて最終判断できる設計にします。
公開されている教育関連の導入事例には、オンライン授業の運用基盤を整えたことで、指導者の作業工数を約7割削減し、導入から1年で100校以上へ展開した例があります(出典: クラウド事業者の教育分野導入事例、確認日: 2026年8月)。
こうした成果は、モデルの精度だけで生まれたものではありません。要因は、利用ログを集め、現場の確認フローを残し、複数拠点へ広げられる基盤を先に整えたことにあります。
クラウド・専用環境・OSSの違い
利用環境は、データの扱い方や運用体制に応じて選びます。
- クラウド:必要な時間だけGPUを使える
- 専用環境・オンプレミス:外部へ出しにくい情報や閉域接続に対応
- OSS:自由度と移植性を確保
クラウドのマネージド型では、学習環境、モデル管理、パイプライン、監視を短期間で組み合わせられます。PoCや利用量が変動する案件に向いています。ただし、データ転送、常時稼働する推論サーバー、ログ保管、ストレージの費用が積み上がるため、利用量を把握しておくことが欠かせません。
専用環境やオンプレミスは、機微情報を外部へ出しにくい場合や、閉域接続、既存ネットワークとの統合が厳しい場合に検討します。自社で管理する場合は、GPUの調達や故障対応、容量計画が要ります。脆弱性対応や運用担当者の確保も伴います。
OSS方式では、アップデートや障害対応も自社の責任になります。そのため、導入費だけでなく、運用人材の費用も含めて比べることが大切です。
機械学習基盤の開発の進め方
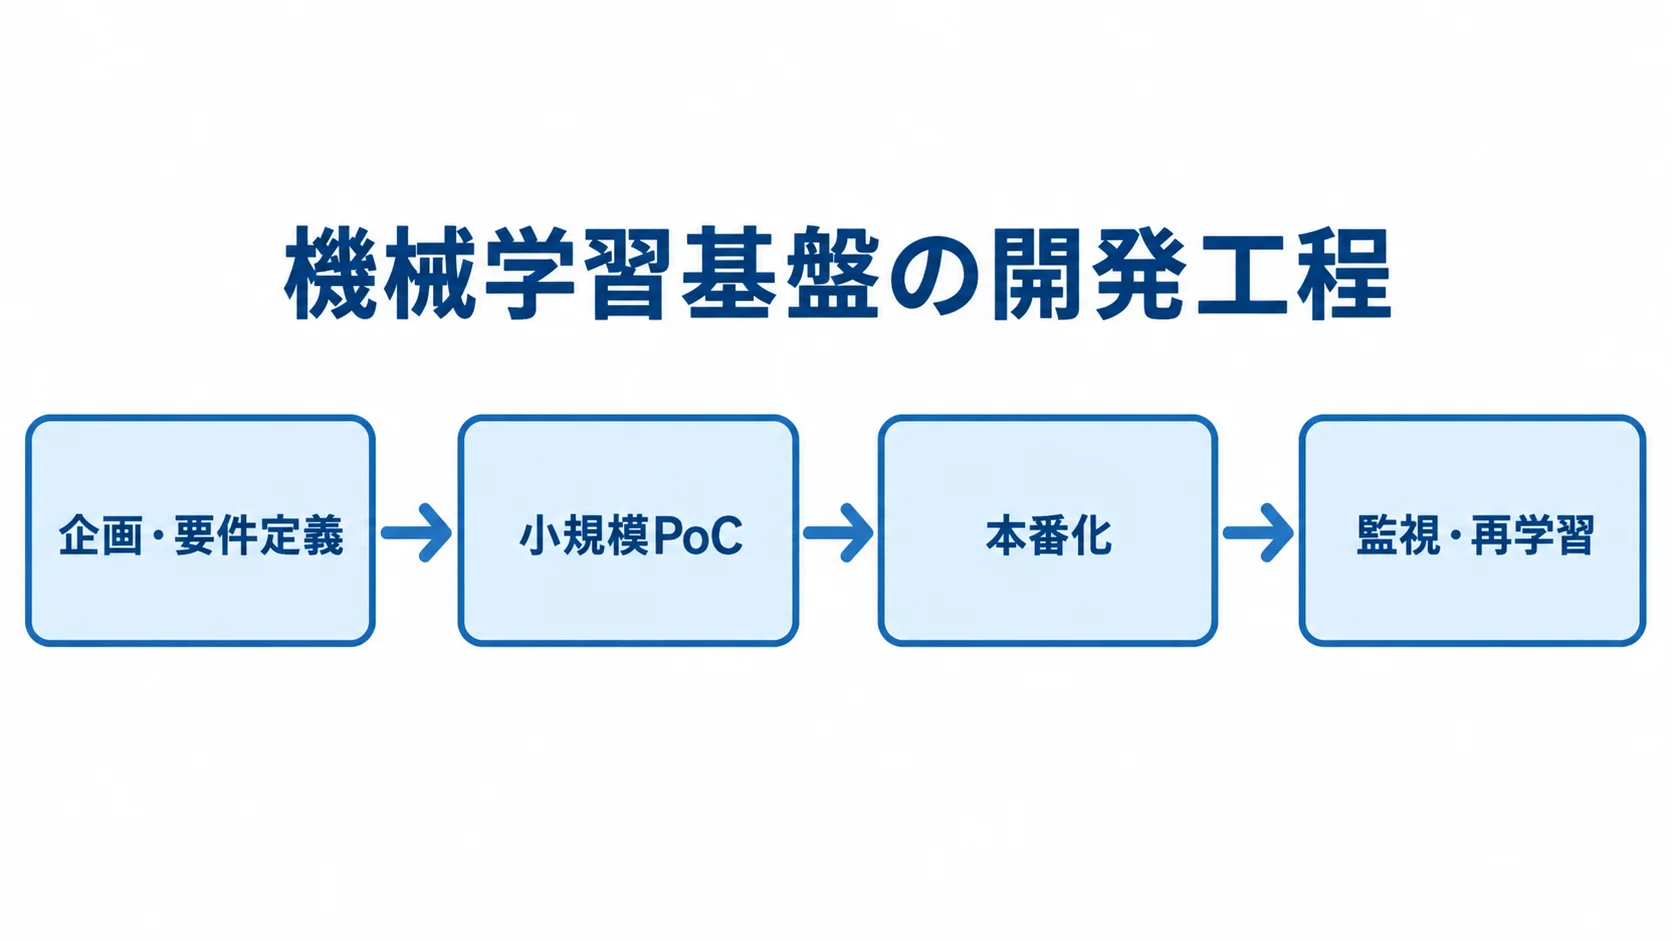
機械学習基盤を最初から全社共通の大規模システムとして作ろうとすると、要件が膨らみがちです。そのため、まず業務上の目的と評価方法を決め、限られた範囲で検証します。そのうえで、再利用できる機能を見極めてから、本番基盤へ広げるのが現実的です。
▶ 詳細はこちら:機械学習基盤開発の進め方/やり方/流れや方法/手法/工程/手順
企画・要件定義とデータ棚卸し
企画・要件定義では、改善する業務とデータの状態を順に確認します。
- 改善する業務を決め、導入前後で測れるKPIを設定する
- データの品質、利用条件、既存システムとの連携を洗い出す
KPIには、離脱率、学習時間、正答率などを使います。採点時間や問い合わせ対応時間も指標に含めます。
精度だけを目標にすると、現場で使われない高性能モデルを作るおそれがあります。そのため、講師の確認時間や誤判定の訂正時間も評価します。
データごとに、所有者、利用目的、保存期間を確かめます。欠損やラベル品質、個人情報、連携方式も確認します。紙やPDFがあれば、電子化の精度と費用も見積もります。
複数拠点で同じ生徒が別IDで登録されている場合、名寄せのルールがないとデータの一貫性が崩れます。データが不足しているときは、モデル開発より先に収集の設計を行います。
小規模PoCで成功条件を検証
PoCでは、対象を絞って、データと現場運用の課題を早めに確かめます。
- 対象:1校、1学年、1教科、または講師向けの1業務
- 評価:機械学習指標と現場での利用状況
- 中止条件:データ不足や運用上の問題を事前に定める
対象を絞ると、データ欠損や現場での使いにくさを早く発見できます。正解率や再現率に加えて、利用率や作業削減時間を評価します。誤判定の修正時間、説明できる割合、1件あたりの推論費用も見ておきます。
成功条件と同時に、中止条件も決めておきます。一定期間で必要なラベル数を集められない場合や、現場の確認時間が減らない場合は、本番化を急ぎません。説明できない予測が多い場合や、個人情報の利用目的を整理できない場合も、本番化は急ぎません。
PoCでは、モデルに加えて、データ仕様書や評価結果、監視項目を残しておきます。運用手順や次段階の費用見積もりも含めると、稟議や本番設計につながります。
本番化・監視・再学習
本番化では、公開管理、安全対策、人による確認の仕組みを設けます。
- 公開管理:承認済みモデルを段階リリースし、異常時は戻す
- アクセス保護:API認証、権限分離、バックアップの整備
- 人による確認:低信頼度の予測を教員や管理者へ回す
教育評価の予測や自動採点では、Human-in-the-Loopを組み込みます。出力をそのまま確定させず、人が確認できる設計にすることが安全です。
運用後は精度低下を待たず、データ分布や推論遅延を監視します。未入力、エラー率、費用の変化も対象です。学年や教材、試験制度が変わると、特徴量が使えなくなる場合があります。
再学習の頻度や承認者を決めておくと、担当者が変わっても運用が止まりにくくなります。テストデータや公開手順、障害時の連絡先も決めておきます。
機械学習基盤の費用相場と開発期間
機械学習基盤の費用は、モデルの数やデータの整備状況、GPUの利用量で大きく変わります。ほかにも、連携システム数や閉域接続が影響します。画面開発や監視・保守の範囲によっても変わります。
国内の受託開発には統一された公開価格がほぼないため、次の金額は、教育向けAIアプリやデータ分析基盤、MLOps導入の類似案件をもとにした、予算取り用の推定値です。正式な見積もりは、データの洗い出しと要件定義が終わった後に作り直す必要があります。
▶ 詳細はこちら:機械学習基盤開発の見積相場や費用/コスト/値段について
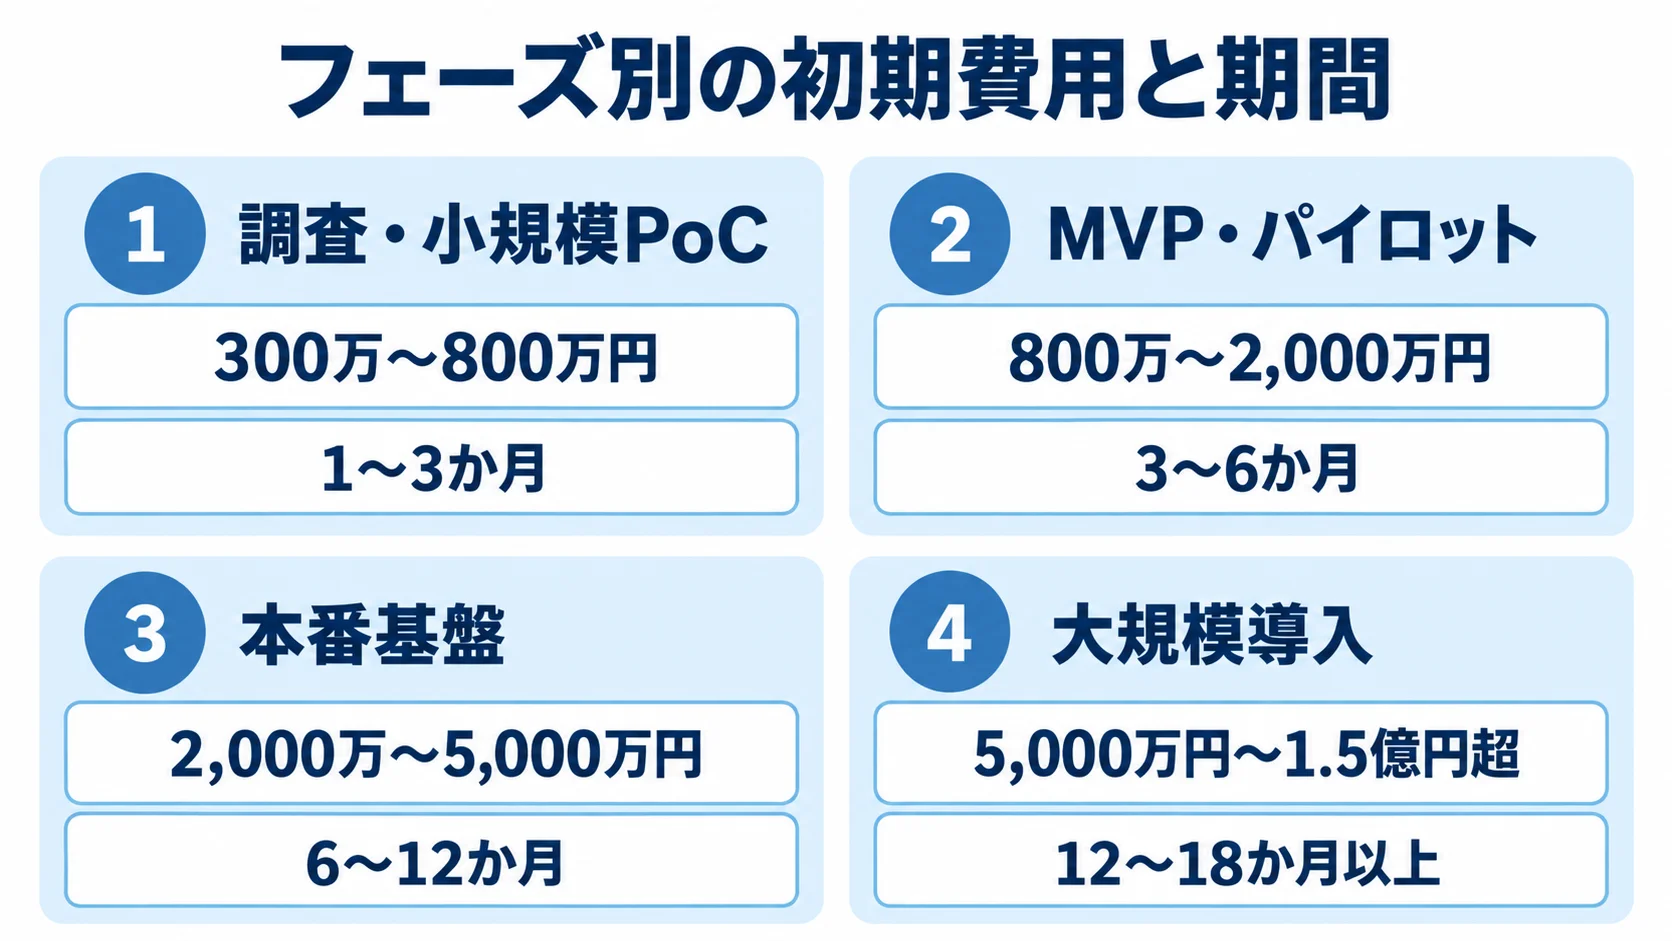
フェーズ別の初期費用と期間
初期費用と期間の推定レンジは、フェーズと構築範囲によって異なります。
- 調査・小規模PoC:300万〜800万円、1〜3か月
- MVP・パイロット:800万〜2,000万円、3〜6か月
- 本番基盤:2,000万〜5,000万円、6〜12か月
- 大規模導入:5,000万円〜1.5億円超、12〜18か月以上
PoCは1ユースケースを対象とします。一方、MVPやパイロットは、データ連携、1〜2モデル、簡易API、監視の初版を含みます。
本番基盤は、複数モデルとモデルレジストリ、CI/CDを含む想定です。さらに、権限・監査や業務画面までを含みます。
大規模導入は、複数校や大規模組織を横断する想定です。閉域接続や冗長化まで含みます。さらに、既存システム移行と24時間運用も対象です。
紙データの電子化や複雑な名寄せがある場合は、データ整備費がモデル開発費を上回ることもあります(出典: 国内公開案件の類似価格帯とクラウド各社の公式料金表、2026年8月確認)。
クラウド・GPU・保守のランニングコスト
小規模なクラウド構成の運用費は、月50万〜300万円程度が目安です。ただし、開発保守を含む場合もあるため、見積もりでは対象を確かめます。費用は、利用量と運用範囲の決め方で変わります。
- 利用量:データ保管量、推論回数、GPU稼働時間
- 運用環境:監視、バックアップ、ネットワーク転送
- 保守:問い合わせ対応や開発保守の範囲
GPUを常時起動する環境と必要時だけ起動する環境では、同じモデルでも月額費用が大きく異なります。
機械学習サービスの利用料のほかにも、料金がかかります(出典: 主要クラウド事業者の機械学習サービス公式料金情報、2026年8月確認)。対象には、仮想マシンやオブジェクトストレージ、鍵管理などが含まれます。コンテナレジストリやログ・監視も対象です。
GPUを学習時だけ起動し、可能な推論はバッチ化します。また、ログの保存期間やストレージ運用を定め、予約や割引制度を使う方法もあります。
見積書では、要件定義、データクレンジング・OCR、クラウド・ネットワークを、費用の項目として分けてもらいます。モデル開発、アプリ・API、MLOps・監視も作業ごとに示してもらうと、稼働後の監視や再学習の費用まで見えて、予算超過を防ぎやすくなります。セキュリティ審査、移行・研修、保守運用も、別に記載してもらいます。
機械学習基盤のセキュリティ・法務・ガバナンス
成績や出欠、学習履歴、答案、顔画像などを扱う機械学習基盤では、精度以前に、データを適切に扱えることが前提です。導入時だけでなく、モデルの再学習に過去データを使う場合も、利用目的と同意・契約の範囲を確認します。
教育情報を扱う場合は、利用目的とアクセス権限、暗号化を要件に含めます。保存地域や委託先も要件として扱います。さらに、監査ログ、削除・返却方法、インシデント時の連絡体制も決めておきます。
教育データを守るアクセス制御と監査
文部科学省の「教育情報セキュリティポリシーに関するガイドライン(令和7年3月)」は、教育現場の情報資産を守る方針や運用を整理しています(出典: 文部科学省、2025年)。教育データの守り方は、誰が何を見られるかを決めることから考えます。
- 権限分離:管理者、分析担当、講師、委託先で役割を分ける
- 識別情報:個人情報と分析IDを分け、対応表へのアクセスを限定する
- 監査ログ:データ閲覧、モデル公開、予測修正を記録する
- 技術対策:持ち出し制御、暗号化、多要素認証を行う
- 運用確認:秘密情報、バックアップ、保存期間、復旧目標を見ておく
教育データを適切に管理することで、万一情報が漏えいした際の影響を抑えられます。秘密情報の安全な保管と、バックアップの復元テストも確認します。
仕様書には、対象範囲とログ保存期間、監視者を記載します。さらに、アラートの通知先や障害時の復旧目標も盛り込みます。
説明可能性と人による最終判断
予測は、データの偏りや環境の変化によって誤ることがあります。本人への影響が大きい判断では、根拠を確かめて、人が最終判断できるようにします。
- 予測の根拠:主な特徴量と信頼度の表示
- 参照情報:参照時点とモデルのバージョンの明示
- 人の修正:講師や管理者が結果を直せる画面
教育評価、進級、支援対象の判定では、予測を唯一の根拠にしない運用が必要です。また、AI事業者ガイドライン第1.2版は、2026年3月に公開されました。同版は、役割ごとのリスク対応を示しています(出典: 経済産業省・関係機関「AI事業者ガイドライン(第1.2版)」、2026年)。
ガイドラインの内容は、そのまま要件にせず、自社の利用目的やデータ、影響範囲に当てはめて落とし込みます。苦情対応と説明責任も含めます。
開発会社/ベンダーの選び方
機械学習基盤の発注先は、モデルを作れるかだけでなく、データ整備や既存システムとの連携まで確かめて選びます。MLOpsやセキュリティ、業務への定着、運用保守も判断材料になります。
実行基盤を提供する事業者と、要件定義から業務アプリまで構築する受託会社では、得意な範囲が異なります。そのため、必要な役割を分けて比べることが大切です。
対応範囲と類似案件の実績
提案では、対応範囲と自社に近い案件の経験を確認します。
- 構築範囲:データ連携、前処理、特徴量管理、モデル開発、評価
- 運用範囲:API、監視、再学習、運用引き継ぎ
- 類似実績:CSV中心、複数拠点、個人情報や閉域接続の案件
「AI開発が得意」という説明だけでなく、自社に近い状況の経験を尋ねます。導入件数やモデルの種類だけでなく、改善したKPIや運用年数、障害時の体制も確かめます。
匿名化画面やデータフローの例、評価レポート、運用手順も見せてもらいます。教育領域では、講師や管理者と要件を詰めた経験も判断材料です。
提案・見積もりで確認する項目
RFPには、業務・データ、性能、セキュリティ、契約の前提を書きます。
- 業務・データ:対象業務、データ項目、連携方式、想定ユーザー数
- 目標・性能:更新頻度、目標KPI、許容誤判定、応答時間
- 保護・運用:保存地域、アクセス権限、監査ログ、SLA
- 費用・成果物:費用上限、成果物の所有権
- 契約終了:データの返却方法
ここまで書けない場合は、有償の要件整理やデータの洗い出しを依頼し、前提を揃えてから本開発を発注します。提案書では、標準機能と追加開発を分けてもらいます。利用するOSSや外部サービス、将来の乗り換え方法も示してもらいます。
月額クラウド費用の監視担当、GPU停止時の通知、再学習の承認者も確認します。複数社を比べる場合は、価格だけでなく、実装範囲や運用負担、セキュリティ、拡張性を同じ条件で評価します。
▶ 詳細はこちら:機械学習基盤開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:機械学習基盤開発の発注/外注/依頼/委託方法について
よくある質問
機械学習基盤を検討する際によくある疑問に答えます。答えは自社のデータ量や利用目的で変わるため、製品選びにそのまま使わず、要件定義の確認項目として役立ててください。
機械学習基盤は小規模な会社でも必要ですか?
必要ですが、最初から大規模な共通基盤を構築する必要はありません。利用頻度が低い場合やモデル数が少ない場合は、マネージドサービスや既存の分析環境が選択肢になります。
まずは、データの版管理や評価記録、アクセス制御、簡単な監視から始める方法が現実的です。将来の再利用に備えて、データ項目とモデルの管理方法は初期から揃えておきます。
クラウドとオンプレミスはどちらが良いですか?
短期間のPoC、利用量の変動、GPUを必要な時だけ使いたい場合はクラウドが向いています。データを外部へ出しにくい、閉域接続が必須、既存設備を活用したい場合は専用環境やオンプレミスが候補になります。
実際には、識別情報を分離してクラウドで学習し、機密性の高い処理を専用環境に置くなど、要件に応じた組み合わせを検討します。
PoCから本番化までにどのくらいかかりますか?
小規模なPoCは1〜3か月、データ連携と簡易APIを含むパイロットは3〜6か月、本番基盤は6〜12か月が一つの目安です。
ただし、紙・PDFの電子化、複数システムの名寄せ、個人情報の審査、閉域ネットワークの構築がある場合は延びます。モデルの精度だけでなく、現場で使えることと運用体制が確認できた段階で本番化を判断します。
機械学習基盤では精度を何%にすれば成功ですか?
成功の基準は、用途ごとに決める必要があります。見逃しを減らしたいのか、確認作業を減らしたいのか、誤判定の影響を抑えたいのかで、適切な指標と許容値が変わります。
たとえば講師の確認対象を絞る用途なら、予測の正しさだけでなく、確認時間、利用率、低信頼度の割合、誤判定を修正できる割合を合わせて評価します。
まとめ
機械学習基盤は、データの収集と整備から、モデルの評価と公開、推論、監視、再学習までを継続して回す共通環境です。GPUやモデル単体とは異なります。さらに、教育領域では、成績や学習履歴のデータ管理、人が確認できるHuman-in-the-Loop、複数拠点へ広げる連携設計が重要です。
開発は、目的とKPIの整理、データの洗い出し、小規模PoC、本番設計、段階導入の順に進めます。費用の推定レンジは、PoCで300万〜800万円、本番基盤で2,000万〜5,000万円です。
大規模導入は5,000万円〜1.5億円超が目安です。データ整備、GPU、クラウド、監視、保守を分けて見積もります。
開発会社やベンダーは、モデル精度だけでなく、データ連携、セキュリティ、運用、再学習まで確認して選びます。費用について、どこまでを誰が受け持つかも確かめておきます。
▼関連記事一覧
・機械学習基盤開発の進め方/やり方/流れや方法/手法/工程/手順
・機械学習基盤開発でおすすめの開発会社/ベンダー6選と選び方
・機械学習基盤開発の見積相場や費用/コスト/値段について
・機械学習基盤開発の発注/外注/依頼/委託方法について
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。