
機械学習基盤の開発は、目的とデータを整理してから小さく検証し、設計・テスト・稼働へ進む流れです。再学習と責任分界まで整えておくと、本番運用につながります。
▼全体ガイドの記事
・機械学習基盤開発の完全ガイド
AIシステム開発の工程ごとの進め方と注意点については、無料ホワイトペーパー「AIシステム開発の完全ガイドブック」で詳しく解説しています。
機械学習基盤の全体像
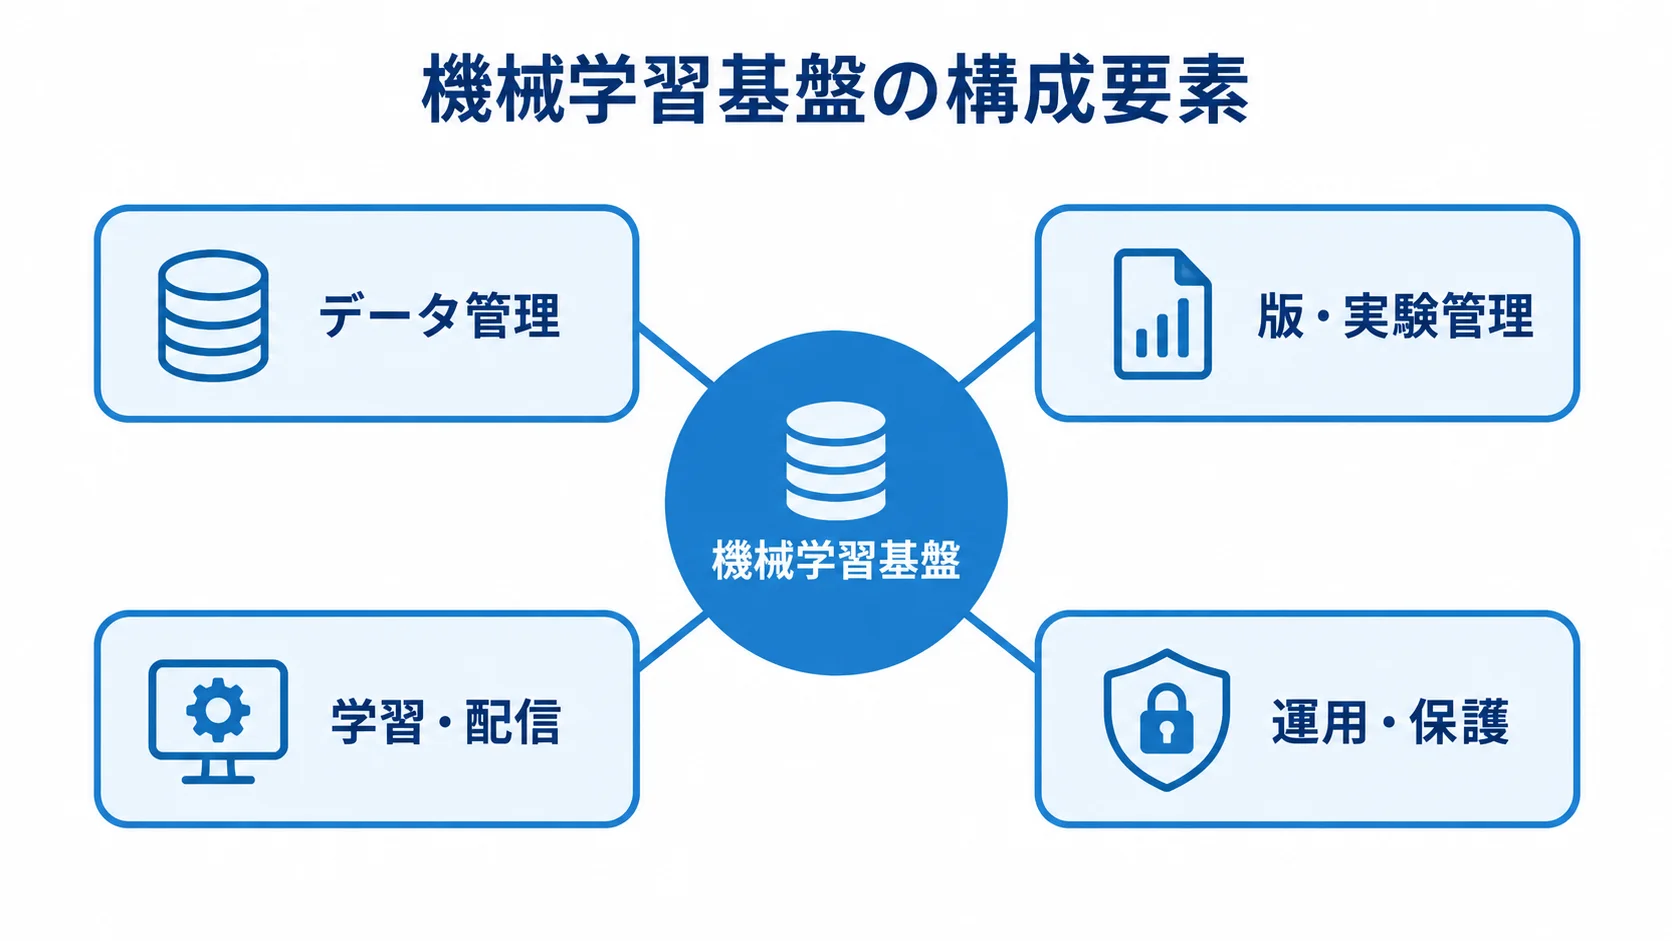
機械学習基盤は、業務データを取り込み、分析用に整え、モデルを作成・評価して業務システムへ安全に届ける共通環境です。稼働後は状態を監視しながら、更新を止めずに運用します。さらに、同じデータとコードから結果を再現し、問題の原因を追跡できる点も価値です。
AIアプリ・GPUサーバーとの違い
AIアプリ、GPUサーバー、機械学習基盤は、それぞれ担う役割が異なります。
- AIアプリ:利用者が触る画面やAPI
- GPUサーバー:学習や推論を行う計算資源
- 機械学習基盤:データ連携、特徴量・実験・モデル管理、配備、監視、権限管理を担う運用土台
- 離脱予測の例:LMSや成績システムから週次で取り込み、検査後に承認モデルを配置し、教員が確認できる状態にする
PoCでは、ノートブックで精度を確認して終わりがちです。一方で、本番ではデータ更新、版の切り戻し、精度低下時の判断者も決めておく必要があります。
この担当の線引きが曖昧だと、モデル開発会社とインフラ会社の間で担当が抜けかねません。そのため、稼働後に追加費用が発生しがちです。
機械学習基盤に必要な構成要素
データ準備から配信・運用までをつなぐ構成要素を、最低限次のとおり設計します。
- データ管理:取り込み・蓄積、加工・品質検査
- 版・実験管理:特徴量・データセットの版、実験、モデルレジストリ、データとモデルの組み合わせ、評価指標、承認者を記録
- 学習・配信:学習・推論環境を用意し、APIまたはバッチで配信
- 運用・保護:監視、ログ、権限、暗号化、バックアップを整備
- 教育データ:利用目的、保存期間、アクセス範囲、匿名化の要否を決める
版や実験の記録があれば、誤判定時に利用データを追跡できます。教育分野では、学習時間、正答率、出欠、答案、講師記録などを扱います。
文部科学省の「教育情報セキュリティポリシーに関するガイドライン」は、令和7年3月に改訂されています(出典: 文部科学省「教育情報セキュリティポリシーに関するガイドライン」、2025年)。
学校や教育委員会が関わる場合は、ネットワーク分離、アクセス制御、監査ログを確認します。さらに、外部サービスへの持ち出し条件も、要件整理の段階で決めます。
機械学習基盤開発の進め方と6フェーズ
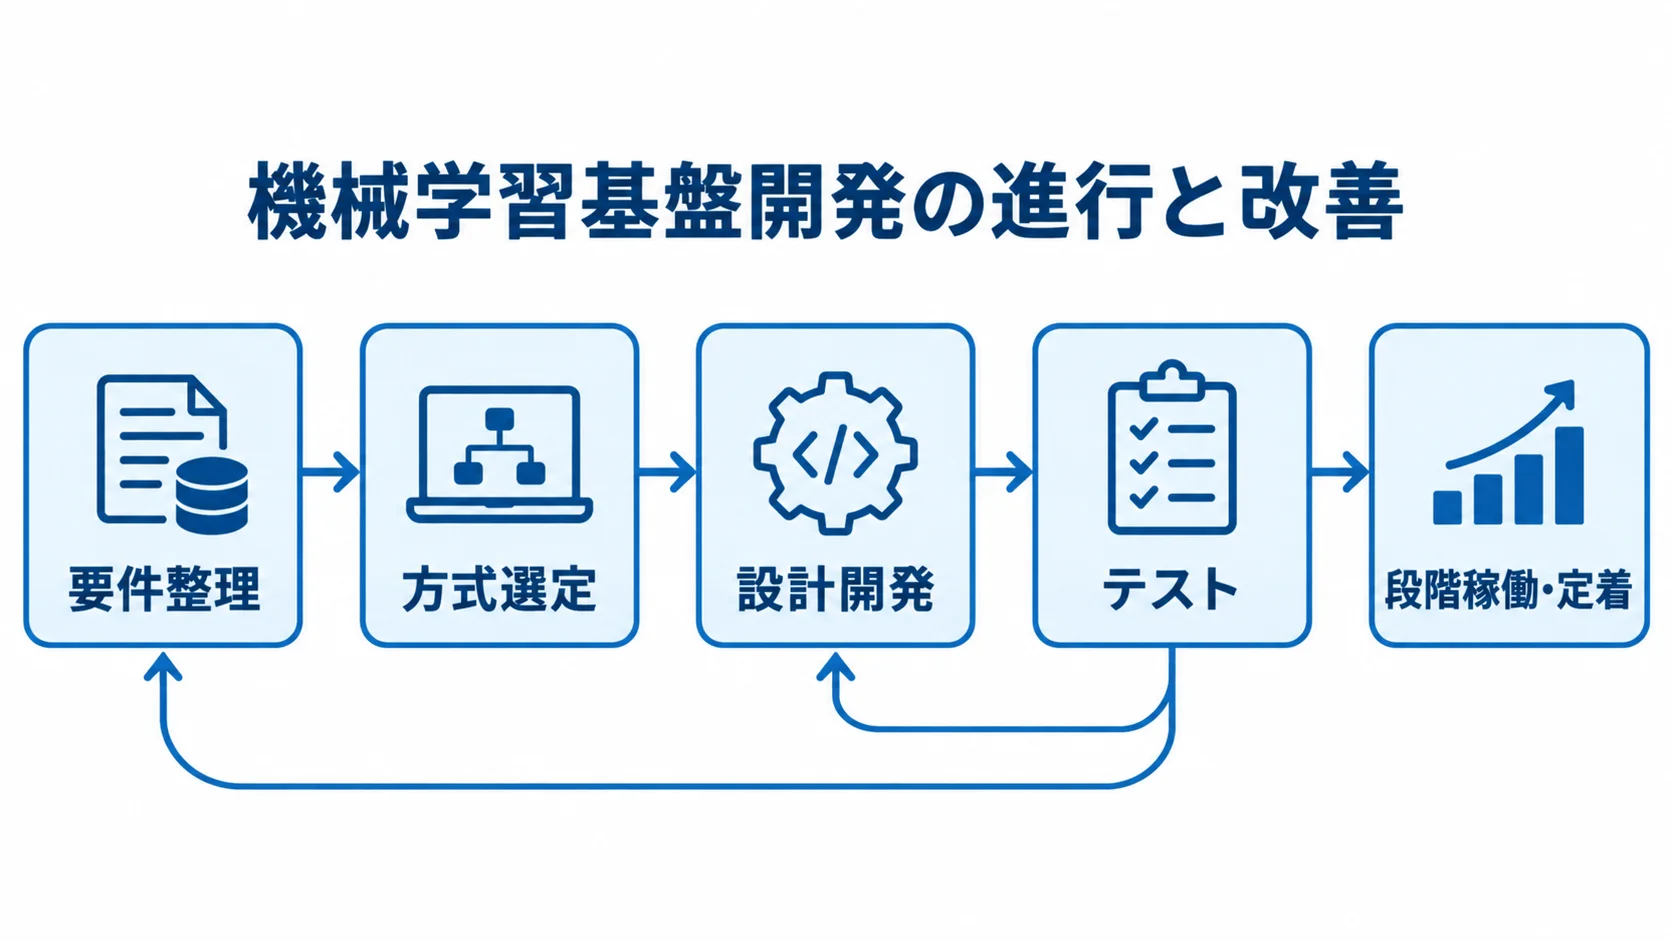
まず目的とデータの状態を確かめ、限定した検証から本番へ広げます。最初から大規模なデータレイクやGPUクラスターを作る必要はありません。
6つのフェーズを進めながら、テストで見つかったデータ品質の問題は要件や設計へ戻します。こうした反復型の開発によって、後戻りの費用を抑えます。
フェーズ1:要件整理で決める目的・KPI・データ責任者
解決する課題を一文で定義することから始めます。課題の例は、離脱兆候の把握、答案採点の確認時間の削減、教材推薦の候補作成の効率化です。
- KPI:精度に加え、確認時間、利用率、介入後の継続率、誤判定の訂正時間、1件あたりの推論費用
- 業務・データ:対象業務、利用者、判断者、成功条件、許容できない誤り、所有者、連携元、更新頻度
- 運用条件:保存期間、個人情報、応答時間、障害時の代替手段
- 承認手順:自動採点や成績予測ではHuman-in-the-Loopを明記
- 紙・PDF:OCR、名寄せ、ラベル付けも要件に含める
フェーズ2:クラウド・パッケージ・OSS・オンプレミスの選定
既存環境との接続性と運用体制を基準に、方式ごとの適性を比べます。
- 既存製品:AWSのSageMakerなど既存環境との親和性を比べる
- 接続性:校務網、ID管理、認証、閉域接続、ログ、移行を確認
- 短期PoC:モデル数が少なければマネージドサービスを候補にする
- 複数校:モデルやデータの更新標準化にはパイプライン、レジストリ、監視、権限管理を重視
- 専用環境:機微情報やGPUの管理条件に応じて専用環境も比較する
候補の例として、BigQueryやGoogle Workspaceとの連携を重視するならVertex AI、Microsoft製品との親和性を重視するならAzure Machine Learningが挙がります。
比べる際は、校務ネットワークやMicrosoft 365、Google Workspace、ID管理方式を一覧にし、認証、閉域接続、ログ連携、データ移行のしやすさを見ます。
機微情報を外部に出しにくい場合や、GPUを常時自社で管理したい場合は、オンプレミスも候補になります。その場合も、機器の保守、脆弱性対応、拡張費まで含めて比べます。
フェーズ3:データ・モデル・MLOpsの設計開発
データの設計からモデルの段階リリースまで、次の流れで進めます。
- 取得から蓄積、加工、学習、評価、登録、配備、推論、監視、再学習までを図示する。
- データレイクやデータウェアハウスの格納先、データセットの版、特徴量の定義を決める。
- 学習コードの置き場所と、モデルレジストリでの承認状態を定める。
- 推論APIかバッチ処理かを選ぶ。オンライン推論と1日1回のバッチでは、可用性と費用が変わります。
- 1校、1学年、1教科、講師業務の一つなどに開発対象を絞る。
- コード、データ、ハイパーパラメータ、評価指標、モデル版を紐づけて、再現できる実験を本番の候補にする。
- CI/CDでテスト済みのパイプラインを動かし、承認済みのモデルを段階的にリリースして、手作業と事故を減らす。
フェーズ4:データ・モデル・業務フローのテスト
データ、モデル、業務操作を確かめ、合格条件と本番移行の扱いを決めます。
- データ連携で欠損、重複、形式違い、遅延、異常値、個人情報混入を検査する。
- 学習に使っていないデータで精度、再現率、適合率、誤差、グループ別の偏りを評価する。
- 業務上の許容水準を決め、説明性、処理速度、費用も本番条件にする。
- 利用者が予測結果を確認・修正し、差し戻しや再実行をできるか試す。
- 空データ、遅延、低信頼度、権限外アクセス、旧モデル復帰、クラウド障害を試す。
- 合格条件と未解決課題を文書化し、PoC成功と本番移行承認を分ける。
フェーズ5:段階稼働と監視・ロールバックの整備
まず対象を限定して稼働し、監視や修正、切り戻しの体制を整えてから利用を広げます。
- 対象校や担当者を限定したカナリアリリースから始める。
- 精度、推論結果、データドリフト、欠損率、遅延、エラー率、利用回数を監視する。
- GPU・ストレージ使用量と月次費用も監視し、通知先、一次対応者、判断期限、旧モデルへの復帰手順を定める。
- 教師や担当者が結果を修正し、次の学習データに反映できる仕組みを用意する。
- 重要な判断には人の承認を残し、定型的な前処理や通知から自動化する。
AWSの教育事例では、オンライン学科教習に顔認識を組み込み、指導員の工数を約7割削減したと報告されています。さらに、開始から1年間で100校以上へ展開したとの報告もあります(出典: AWS「ミナミホールディングス株式会社」導入事例、公開資料)。
現場の業務を理解してから仕組みを作ることが、稼働後の利用拡大につながります。
フェーズ6:再学習・研修・責任分界の定着
担当と更新のルールを決め、利用者が判断と改善を続けられる運用にします。
- 責任分界:更新、品質検査、評価、承認、障害対応、ベンダー連絡をRACIなどで整理
- 再学習:頻度は固定せず、精度低下、データ変化、制度改定、教材更新を契機にする
- 変更管理:モデルカードと履歴を残し、変更時期と内容を追跡
- 利用者支援:研修、操作マニュアル、判断例、誤判定窓口、月次KPIレビューを用意
- 活用:先生が予測を鵜呑みにせず、本人への声かけや指導計画に使う
利用率が低い場合は、入力の手間、画面の導線、通知頻度、現場にとってのメリットを見直します。
機械学習基盤の費用相場とコストの内訳
価格は、モデルの種類、既存データの整備度、連携システム数、GPUの有無で変わります。さらに、閉域ネットワークや監視・保守の範囲も影響します。
国内では、統一された公開価格がほぼありません。そのため、ここに示すのは、教育向けAIアプリ、データ分析基盤、MLOps導入の類似案件から整理した、2026年時点の推定レンジです。
これはあくまで予算取りの目安です。正式見積では、要件整理とデータ棚卸しの結果を見積もりに反映します。
初期開発費の見込み程度と期間
検証の範囲と本番に求める要件によって、初期費用は変わります。小規模PoCから複数校・大規模の段階へ進むほど、金額も期間も大きくなります。
- 小規模PoC:300万〜800万円程度、1〜3か月程度
- MVP(Minimum Viable Product):800万〜2,000万円程度、3〜6か月程度
- 本番基盤:2,000万〜5,000万円程度、6〜12か月程度
- 複数校・大規模:5,000万円〜1.5億円超、12〜18か月以上となる可能性
小規模PoCの金額は、調査・棚卸しと、1ユースケースで評価画面を作る場合の目安です。ただし、紙・PDFの電子化、名寄せ、正解ラベル作成が必要な場合は、同じ費用や期間に収まらないことがあります。
MVPやパイロットは、1〜2モデル、データ連携、簡易API、初期監視を含みます。一方で、本番基盤には、複数モデル、レジストリ、CI/CD、権限・監査、業務画面が含まれます。
小規模PoCの段階では、データを継続して取得できるか、現場が結果を使うかを判断します。
特に、複数校や大規模組織で閉域接続、冗長化、データ移行、24時間運用が必要な場合は、前述の費用・期間となる可能性があります。
いずれも確定価格ではなく、ノートの類似案件調査に基づく推定です。
クラウド・GPU・保守のランニングコスト
開発保守込みの小規模クラウド構成は、月50万〜300万円程度が推定の目安です。運用人員を含む場合もあるため、クラウド利用料だけの固定額ではありません。見積もりでは、基盤とデータ・監視・保守を分けて考えます。
AWS SageMakerは、オンデマンドやSavings Plansなど、利用量に応じて課金される方式です(出典: AWS「SageMaker 料金」、2026年確認)。
- 利用量:常時稼働GPU、学習データ量、推論回数、転送量
- 運用:ログ保持、監視、バックアップ、脆弱性対応
Azure Machine Learning自体の追加料金はありません。ただし、仮想マシン、Blob Storage、Key Vault、Container Registry、Application Insightsなどは別途課金されます(出典:Microsoft Azure「Azure Machine Learning の価格」、2026年確認)。
AWSでは、学習、ホスティング、ノートブック、ストレージ、データ処理、監視の費用を分けて確かめます。
予算超過を防ぐための設計
予算超過を抑えるには、稼働や保管の設定を利用状況に合わせ、総保有コストで比べます。
- GPU・推論:学習時だけGPUを起動し、リアルタイム不要ならバッチ化
- 環境・保存:データとログの保存期間を決め、開発・検証・本番を分ける
- 課金管理:安定処理量なら予約・割引を比較し、実験環境に予算アラートを設定
- 総額:初期費用、月額、保守、データ整備を1年または3年で比較
最安の構成は、障害対応や再学習の工数を増やす場合があります。
評価ログを削りすぎると、精度劣化の原因を調べられなくなります。
機械学習基盤の見積もりを取る際のポイント
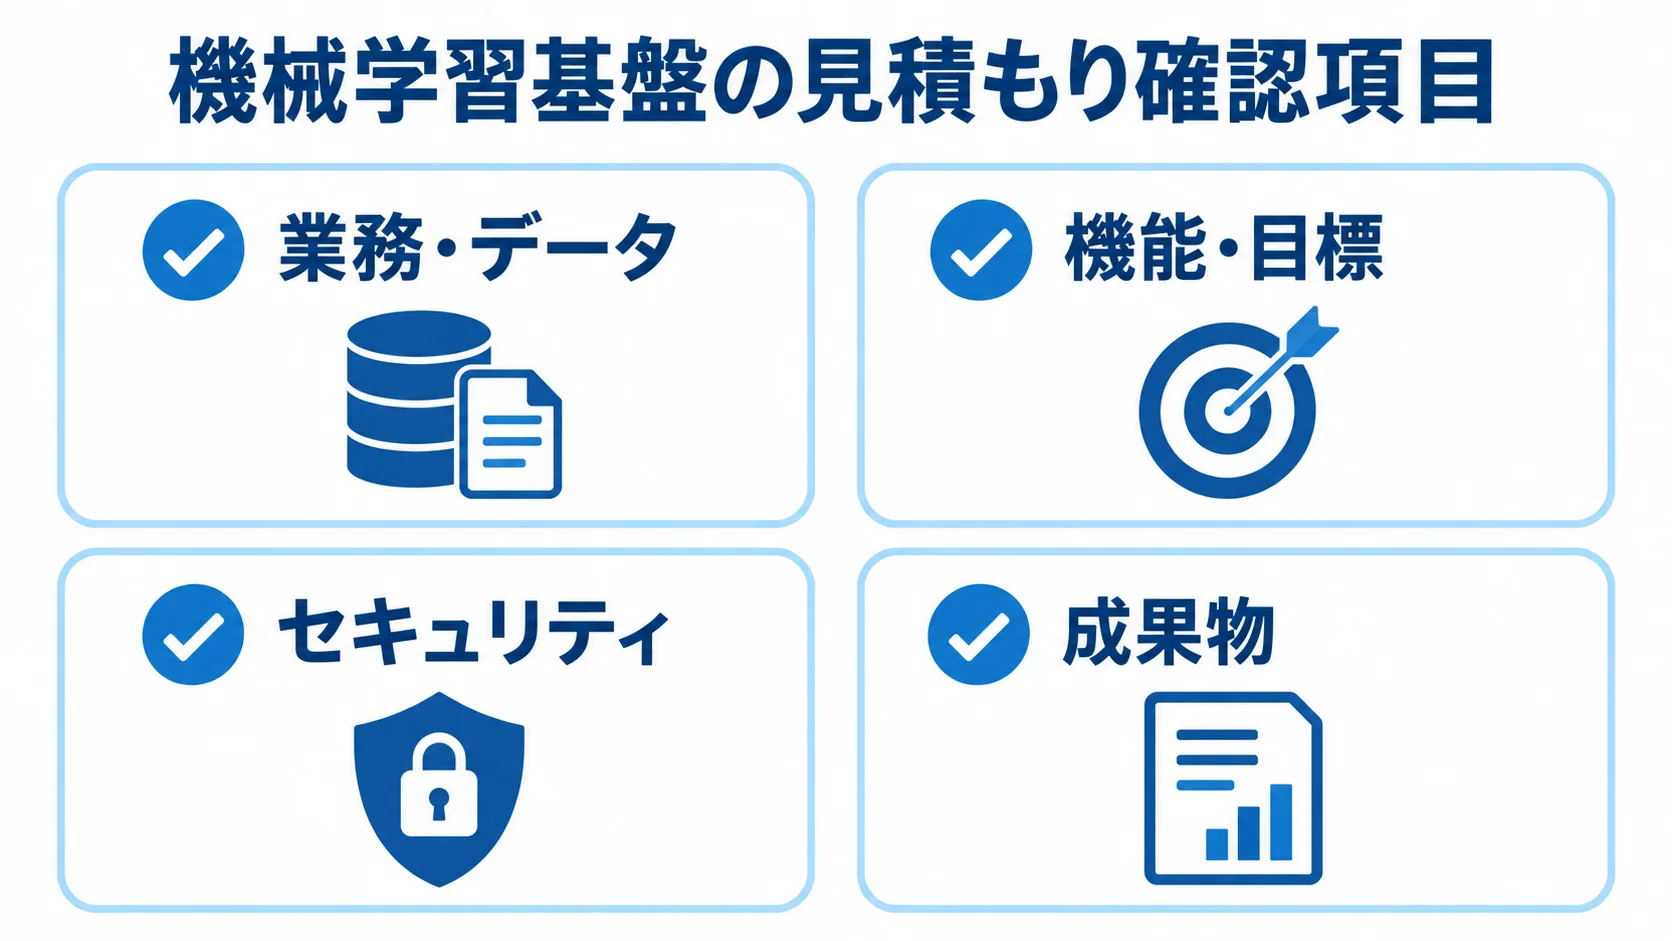
機能一覧だけで依頼すると、データ整備、審査、移行、研修、運用費が後から追加になりがちです。そのため、作る範囲、対象外、運用者、本番移行の条件は、発注前に書面で決めておきます。
見積依頼書の記載項目
業務・データ、必要機能、セキュリティ、成果物と引き渡し範囲は、依頼書に明記します。
- 業務・データ:目的、対象業務、利用者数、データ種類・量・更新頻度、既存システムと連携方式
- 機能・目標:モデル数、推論方式、目標KPI、許容遅延、想定期間
- セキュリティ:条件、保存地域、アクセス権、監査ログ、バックアップ
- 教育機関:学籍・成績・出欠・教材・答案・講師記録のうち扱うもの、紙・PDFの量
- 成果物:成果物一式、引き渡し条件、納品後の所有者
成果物には、ソースコード、データ定義書、品質ルールを含めます。特徴量定義、学習手順、評価報告書、モデルカードも加えます。
API仕様、監視画面、運用手順書、研修資料に加えて、復旧手順や、アカウントとモデルの引き渡し条件も指定します。
各成果物について、見積範囲内か別料金か、納品後の所有者は誰かを確認します。
開発会社の比較観点
価格だけでなく、支援範囲と運用力を比べることが大切です。
説明力のある会社を2〜3社程度選びます。
クラウドベンダーは実行基盤やマネージドサービスを提供します。一方、受託SIerや開発会社は、要件整理、連携、画面、運用設計まで支援します。
- 役割:クラウドベンダーと受託SIer・開発会社の支援範囲
- 責任分界:提案書で分担図と対象外を示せるか
- 実績・設計:類似業界・データの実績、PoC後の本番移行、MLOps、閉域接続、権限管理
- 運用体制:障害対応、再学習、精度監視、担当者の継続性
東京理科大学の事例では、オンプレミス環境から閉域ネットワーク経由でGoogle Cloudへデータを置いています。あわせて、IP制限とIAM認証を組み合わせています(出典:Google Cloud「Tokyo University of Science Case Study」、2022年公開資料)。
同事例では、Vertex AIや可視化ツールで分析しています。特に、教育データを扱う場合は、データの流れとアクセス制御を具体的に説明できるかを確かめます。
見積もりの抜け漏れと契約リスクの防止
契約の前に、費用、作業範囲、データ保護、誤判定時の役割を確認しておきます。
- 費用:固定・従量費、上限、予算アラート、クレンジング、OCR、ラベル作成
- 作業範囲:改修、接続、審査、診断、移行、研修、保守、再学習を項目化
- 成果・データ:保証範囲、保存・委託・再委託、二次利用・削除、通知、ログ期間、権利を契約で定める
- 誤判定:説明者、訂正者、業務判断を止める担当を明確にする
安価な提案でも、これらが対象外になっていると、稼働後の追加費用やリスクが大きくなります。
よくある質問(FAQ)
発注前には、技術選択、PoCの範囲、データの扱い、費用、運用責任について質問が寄せられます。
機械学習基盤は最初から本番規模で作るべきですか?
最初から本番規模で作る必要はなく、1ユースケースに限定したPoCから始める方法が現実的です。
PoCでは、データ取得、権限、評価指標、監視、業務での承認を最低限確認しておき、本番化できない使い捨ての構成を避けます。
精度だけでなく、作業時間の削減、利用率、誤判定時の修正時間、月額費用を見て、継続するかを判断します。
AWS・Azure・Google Cloudとオンプレミスはどれを選べばよいですか?
既存のID管理、データ分析、ネットワーク、運用人材との相性で選びます。短期PoCや利用量が変動する場合は、マネージドサービスが候補になります。閉域接続やデータ持ち出しの制限が強く、GPUを専用で管理する場合は、オンプレミスや専用環境も候補になります。
初期費用だけでなく、保守人材、更新、脆弱性対応、バックアップ、障害復旧、将来のモデル数まで比べます。
モデルの精度が高ければ機械学習基盤は成功ですか?
成功かどうかは、精度だけでなく、現場で使い続けられるかで決まります。具体的には、現場が結果を使い、誤判定を確認・修正し、データ更新と再学習を続けられる状態が必要です。
費用と応答時間が許容範囲に収まって初めて、業務に定着したと判断できます。
教育評価に関わる出力は、参考情報として扱います。そのうえで、先生や管理者が最終判断できる仕組みを残します。
まとめ:小さく検証し、運用まで見据えた機械学習基盤の設計
モデルを作る前に、目的とKPI、データの所有者、利用範囲、現場の承認フローを決めておきます。
要件整理、選定、設計開発、テスト、稼働、定着の6フェーズに区切って進めます。1校・1業務・1モデルなど小さく検証すると、本番移行の条件が明確になります。
発注前に確認するチェックリスト
発注前に要件・運用・成果物を整理し、見積もりの抜けがないかを確認します。
- 要件:業務とKPI、データ量・品質・頻度、個人情報、連携先、環境選定理由
- 運用:評価、承認・ロールバック、監視、再学習、費用上限、担当者
- 成果物:納品物と権利
- 見積項目:要件定義、データ整備、クラウド・ネットワーク、モデル、API・画面、MLOps・監視
- 追加項目:セキュリティ審査、移行・研修、保守運用も分けて提示
最初の一歩:データ棚卸しと限定PoC
本番移行を見据えて、無理のない検証範囲と判断条件を定めます。
- 高価なGPU環境や多数のモデルをそろえる前に、既存データを棚卸しする。
- 負担を減らせるユースケースを一つ選び、成功条件と中止条件を決めて検証する。
- 結果から将来のデータ量、利用者数、セキュリティ要件、再学習頻度を見積もる。
- 本番へ段階的に広げ、精度、費用、説明可能性、利用率、運用負荷を管理できる会社を選ぶ。
▼全体ガイドの記事
・機械学習基盤開発の完全ガイド
▼開発を相談する前に読みたい無料ホワイトペーパー
・AIシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。