
Meilisearchを使ったシステムは、検索方式、データ連携、権限設計によって、検索体験と運用のしやすさが変わります。
機能と基本構成、開発の進め方、費用、運用の4つの面から、発注前に確認したい点を順に説明します。各テーマの詳細は関連記事もご覧ください。
▼関連記事一覧
・Meilisearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Meilisearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Meilisearchのシステム開発の見積相場や費用/コスト/値段について
・Meilisearchのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Meilisearchのシステムの概要
Meilisearchは、Webサイトや業務アプリに検索機能を組み込むためのオープンソースの検索エンジンです。
Meilisearchは、顧客や商品を管理するDBの代わりにはならず、検索向けに整えた文書をインデックスに保持する専用サービスです。
正本データを検索用に変換する仕組み
検索用のデータは、業務データベースやCMSで行われた変更を、連携ジョブまたはWebhookで受け取って反映します。役割は、次のように分けて考えます。
- 検索用に登録:データをインデックス用に変換し、バックエンドAPIから画面へ返す流れ
- 正本を維持:商品名や型番、説明、カテゴリ、価格、在庫、公開状態を検索用にまとめても、正本は業務DBのまま
- 表示項目を分ける:検索結果に出す項目と、詳細画面で正本から取り直す項目
速さだけでなく検索体験を改善する狙い
プレフィックス検索や誤字許容、ランキングを組み合わせられます。さらに、フィルターやファセット、ソート、地理検索も、同じ検索に組み込めます。
公式Glossaryは入力途中の検索を50ミリ秒未満で返す用途を紹介しています(出典: Meilisearch公式Glossary、2026年8月確認)。ただし、実際の応答時間はデータ量やクエリ、ネットワーク、インフラに左右されます。そのため、速度だけでなく、利用者が目的の情報へ届くかも評価します。
Meilisearchでできることと、できないこと
導入の可否は、利用者が何を検索し、どの情報を見られるかで決まります。
Meilisearchと正本の役割分担が、検索速度とデータの信頼性を支えます。
全文検索には向くものの、取引確定や在庫の正確な引き当てといった処理は担いません。
全文検索・サジェスト・絞り込みの得意分野
文字を手がかりに候補を探す検索は、商品や記事、求人の一覧に組み込めます。FAQやマニュアル、問い合わせ履歴にも使えます。部品番号の検索にも向きます。
入力に応じたサジェスト、価格帯やカテゴリのファセット、発売日や在庫順のソートを、一つの検索画面にまとめられます。検索後に条件を足して絞り込む業務では、この組み合わせが活きます。
ランキングルールへの業務知識の反映
検索結果は、ヒット語数や誤字、語の近さを段階的に評価して並びます。属性の優先順位も、評価に加えられます。
そのほか、ソートや語の位置、完全一致性も検索結果の評価に加わります。
- 優先度:商品名や型番を、説明文より上位に置ける設定
- 公開状態:公開中の情報を上位に出せる設定
- 在庫状況:在庫切れの商品の順位を下げる設定
変更後は代表クエリで結果を再確認します。担当者の感覚だけで判断しないよう、クリック率やゼロ件率も記録します。
基幹データベースや認可機能との違い
データ管理と閲覧制御は、Meilisearch単体では担えない役割です。
- 正本データ:インデックスを最新に保っても正本の更新は保証されず、差分同期の失敗で古い情報が表示される点
- 閲覧制御:検索キーだけでは閲覧可否を判断できないため、バックエンドでの認証・認可が必要
- 業務処理:取引確定や在庫の正確な引き当てなど、トランザクション処理の範囲外
Meilisearchの基本アーキテクチャとデータ連携
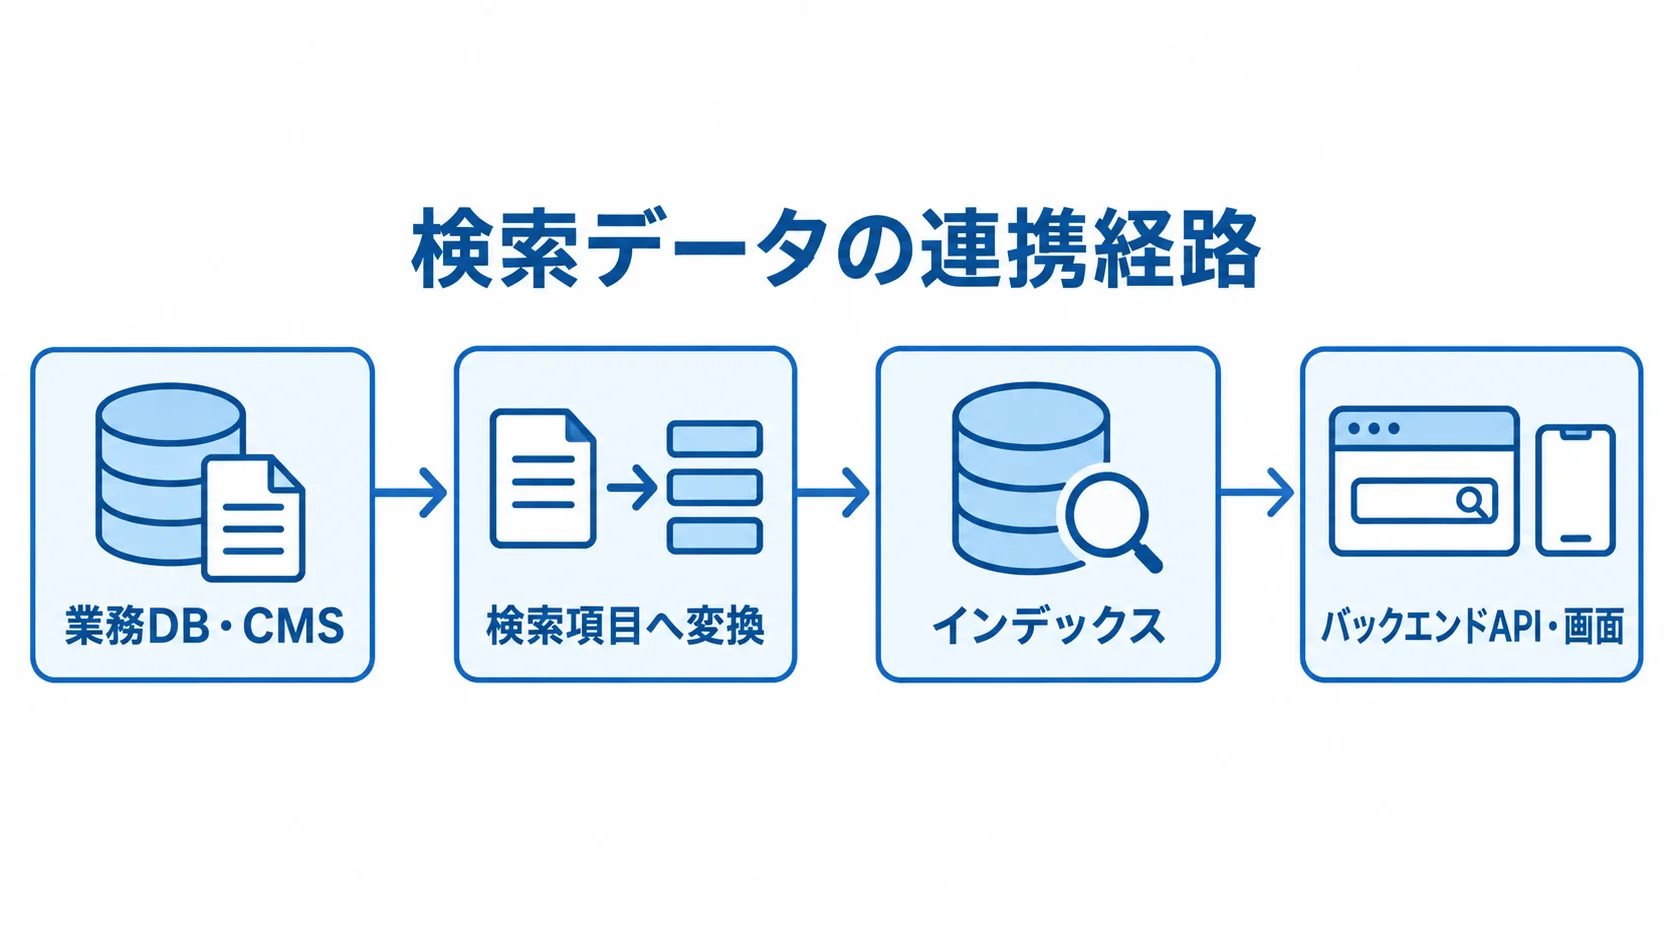
実装の前に、データの取得元、検索への反映時期、結果を見る人を図にしておきます。
構成が複雑になるほど、データ連携と失敗時の復旧が成否を左右します。
業務DB・連携処理・インデックス・画面の分担
基本の流れは、業務DBまたはCMSからデータを取得し、検索項目へ変換してインデックスに登録することです。
- バックエンドAPIで検索を行う
- 検索結果を画面に表示する
初回は全件投入し、その後は更新日時やイベントIDを基に差分同期します。さらに、失敗データの再実行や重複イベントの無害化、削除イベントの処理も組み込みます。
初回投入・差分更新・再インデックスの設計
更新や削除を安全に反映するため、再投入、切り替え、遅延時の扱いを先に決めておきます。
- 再インデックス:項目定義の変更やデータ修復の場面で行う、全件の入れ直し
- 安全な切り替え:新しいインデックスで件数、必須項目、検索結果を検証してから行う切り替え
- 反映遅延:許容できない業務で、更新受付時刻と反映時刻を記録し、「数分以内」などのSLAを決めること
- 削除手順:依頼を受けてから、正本とインデックスの双方から消えるまでの流れを明文化すること
検索APIとフロントエンドの安全な接続
管理用キーはブラウザに埋め込まず、バックエンドで利用者の権限を確認したうえで、必要なフィルターを付けます。
表示用キーについても、対象インデックスと許可する操作を限定します。
検索結果にHTMLが含まれる場合は、画面に描画する前にエスケープかサニタイズを必ず行います。
全文検索・ベクトル検索・ハイブリッド検索の違い
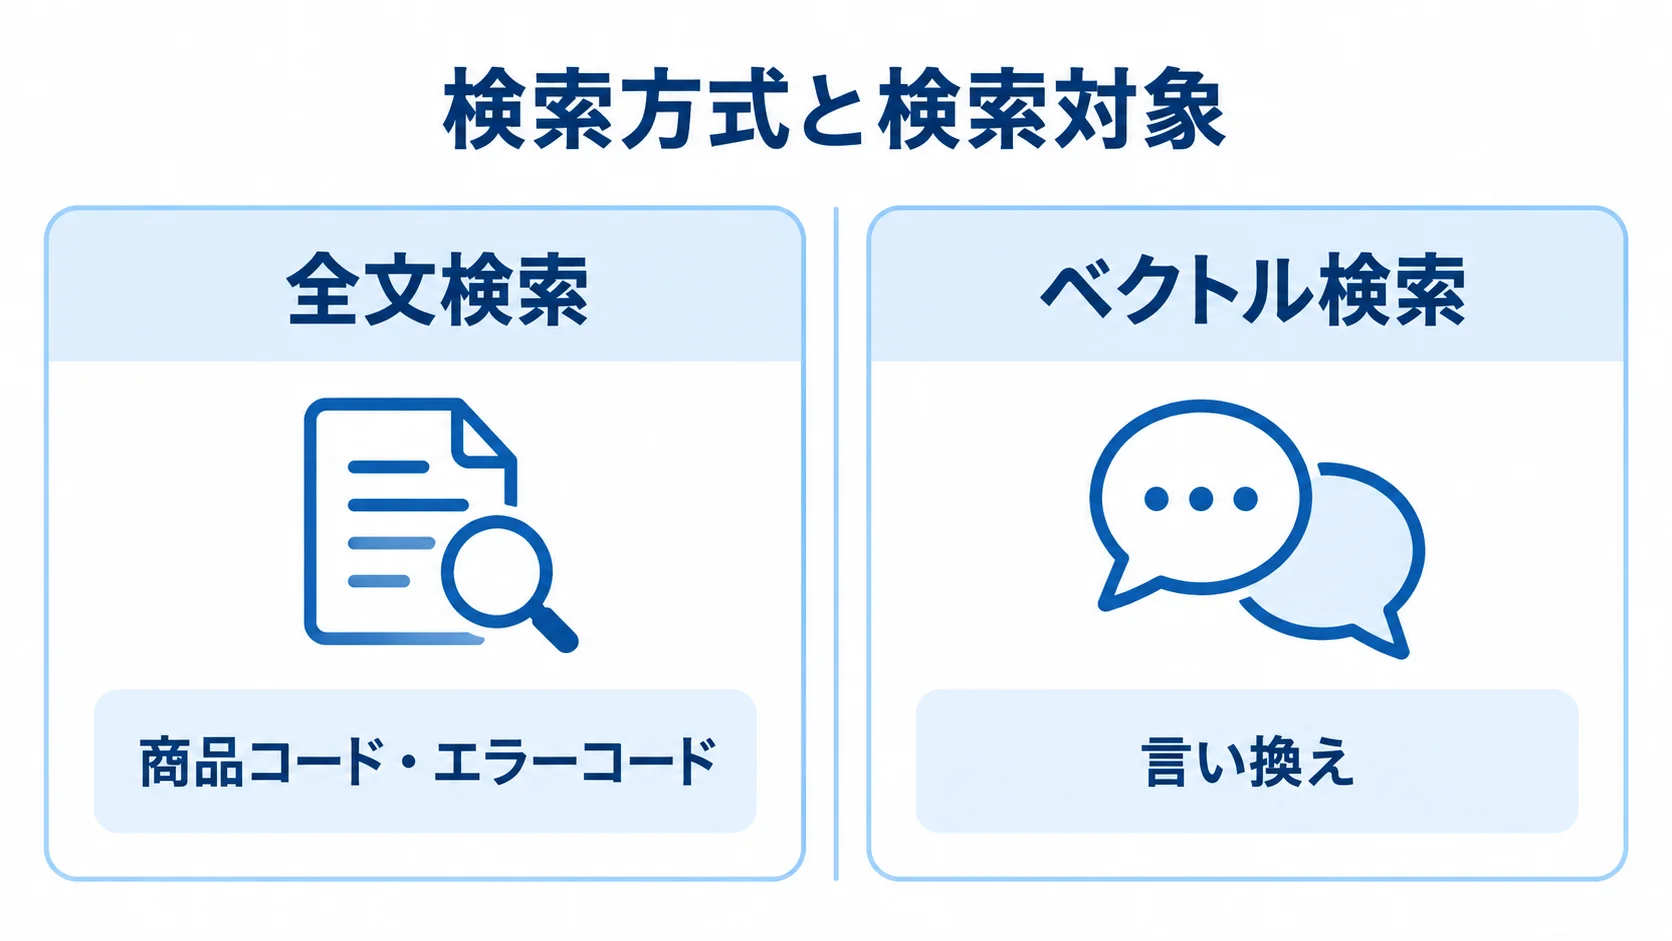
方式は、利用者の言葉とデータの性質に合わせて選びます。
型番やエラーコードは、文字の一致が特に重要です。
意味の近さを無理に足すと、誤った候補が上位に出ることがあります。そのため、代表クエリで正解率と行動を比べて確かめます。
正確な語や固有名詞を探す全文検索
全文検索は、入力された語や近い表記を探す方式です。商品コードや規格番号、エラーコードなど、語が結果の根拠を示しやすい対象に向きます。契約条項のような文書の検索にも、この方式が使えます。
検索語の位置や属性の重要度、誤字の数を、ランキングに反映できます。
同義語に登録する前に、日本語の社内用語や略称の候補を検索ログから洗い出します。
意味の近さを探すベクトル検索
文章や画像を埋め込みベクトルに変換し、表現が違っても意味の近い文書を探す方式です。たとえば、「経費精算の承認が遅い」と「申請の決裁が進まない」のような言い換えを扱う社内検索に向きます。
モデルの選択や生成費用を設計しないと、無関係な結果を返すおそれがあります。さらに、再生成の時期と根拠の表示も決めておく必要があります。
ハイブリッド検索とRAGの導入順
ハイブリッド検索は、キーワード一致と意味の近さを組み合わせる方式です。
公式資料は、キーワードのみを0.0、意味検索のみを1.0とし、その間の比率で混ぜる考え方を示しています(出典: Meilisearch公式Semantic vs hybrid search、2026年8月確認)。
RAGは、検索で見つけた文書を生成AIへ渡す仕組みです。そのため、重複や古い版、権限外の情報を整理し、根拠とアクセスログを残せる状態から始めます。
Meilisearchのシステム開発の進め方
まず検索目的と評価方法を固めます。
小さな用途で成果を確かめてから対象データや利用者を広げると、費用とリスクを抑えて本番へ進めます。
▶ 詳細はこちら:Meilisearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義での検索目的とKPI
「速い検索」という言葉だけでは、要件として使えません。まず利用者と対象、検索後の行動を定義し、さらに許容遅延と閲覧可能項目も決めます。
- 検索指標:ゼロ件率、検索後クリック率、再検索率の設定
- 業務指標:検索経由の購入・申込率や問い合わせ削減数の設定
代表クエリは、少なくとも50件から始めます。
重要業務では200件程度まで増やすと、評価を進めやすくなります。
PoCでの実データと代表クエリによる検証
PoCでは少数のデータだけでなく、表記揺れや型番、略称を含むサンプルを使います。誤字や長文を含む例も加えます。
- 検索品質:上位結果の妥当性、ゼロ件率、絞り込みの動き
- 運用性:更新反映までの時間と、担当者によるランキング調整
既存の検索とも、平均応答時間を比べます。
合格基準を事前に決めておき、未達の場合は本番開発に進まない判断も用意します。
本番移行後のログを使った継続改善
リリース前の準備と公開後の点検を分けて、運用で確認する項目を整理します。
- リリース前:全件投入と差分同期の確認、再実行の手順、バックアップと切り戻し
- 公開後:検索語の分析と、ゼロ件や業務完了を踏まえた同義語・順位の調整
- ログ管理:個人情報が混ざる可能性を踏まえた、保存期間、マスキング、閲覧者の決定
- 月次確認:同期エラーや反映遅延、ゼロ件率、上位結果、脆弱性情報の確認
Meilisearchの開発費用相場とコストの内訳
オープンソースの利用料が無料でも、開発費やインフラ費はかかります。
監視、バックアップ、調整、脆弱性対応にも費用がかかります。
下記の金額は、公式が示す固定の相場ではありません。連携やUI、権限を含む検索システム開発の目安で、データ品質や既存APIによって変わります。
▶ 詳細はこちら:Meilisearchのシステム開発の見積相場や費用/コスト/値段について
規模別の初期開発費の目安
初期費用と期間は、対象件数や検索・連携機能の範囲に応じて、段階的に見積もります。
- 小規模PoC:1データソース、数万件程度で30万〜100万円程度、2〜6週間が目安です。
- 中規模:数万〜数十万件で150万〜500万円程度、1〜3か月程度です。
- 複数システム:テナント分離、監査、認証、移行を含む場合は500万〜1,500万円程度です。
- 大規模:ハイブリッド検索、RAG、高可用性を含む場合は、1,500万〜5,000万円以上になることがあります。
中規模の範囲には、差分同期やサジェスト、絞り込みが含まれます。
ランキング調整やAPI、テストも含まれます。
Cloudの月額料金と開発費の見方
Cloudの月額は、料金モデルや利用状況で変わります。そのため、料金例と変動要因を合わせて確認します。
- 最低料金:公式Pricingは2026年8月時点で月額20ドルからです(出典: Meilisearch公式Pricing、2026年8月確認)。
- 利用ベース:10万ドキュメント・月5万検索の例は月30ドルです。
- リソースベース:0.5 vCPU・1GBメモリとストレージの例は月23ドルです。
- 請求の変動:ドキュメントサイズ、検索量、リージョン、構成で変わるため、円予算には為替変動も含めておく必要があります。
- 課金方式:2025年10月にCPUやメモリ基準の方式が発表され、負荷を予測しやすくなりました。
保守・データ整備・AI利用を含むTCO
インフラ費に加えて、運用やAI検索にかかる継続費用も見積もります。
- セルフホスト:サーバーやディスクなどの基盤費と、監視・バックアップ・更新・障害対応の人件費
- AI検索:埋め込み生成やモデル更新、ベクトル保存に加え、評価クエリの維持と生成AI入力の費用
- 保守の目安:一般的な業務システムでは初期開発費の年15〜20%程度ですが、分析や整備の頻度で変わります。
- 見積比較:初期費用、月額インフラ費、年次保守、追加開発を分けた見積
Cloudとセルフホストの選び方
短期間で検索を立ち上げ、更新やバックアップ、スケールの運用負担を減らしたい場合は、Cloudが向いています。
セルフホストは、閉域網やデータの所在を優先する場合に、既存基盤や細かな構成管理も含めて候補になります。
セルフホストを選ぶ場合は、検索エンジンの管理を自社が担う前提で比較します。
導入速度と運用負担の軽さを重視するCloud
サーバー構築や容量変更、一次対応、バックアップ運用の一部を、サービス側に任せられます。
少人数のチームや、検索を本業としない組織では、担当者の時間を本来の業務に戻せます。
利用リージョンやデータ処理、ログ保存の扱いを確認します。SLAやサポート範囲、障害連絡も確かめます。検索量の増加も、見積もりに含めます。
セルフホストの責任分界と復旧手順
本番環境では、不正アクセスを防ぐ設定と、障害後に復旧するための備えをそろえておきます。
- アクセス保護:専用ユーザー、16バイト以上のmaster key、本番モードの設定と、リバースプロキシ、HTTPS、ファイアウォールの用意
- 復旧準備:スナップショットまたはダンプ、監視、復旧手順の用意
公式ガイドも、root以外のユーザーの利用や保存先の分離、プロキシ、HTTPSを案内しています(出典: Meilisearch公式Running Meilisearch in production、2026年8月確認)。
委託する場合は、更新を判断する人、復旧にかかる時間、設計書やIaCの保有者を契約で決めておきます。
料金ではなく3年間の総保有コストによる判断
初期費や月額リソース費、ストレージを比べます。さらに、検索量の増加やバックアップ、監視にかかる費用も比べます。加えて、障害対応、更新、移行、保守の費用も対象に含めます。
自社運用のサーバー料金だけを見ると安く見えます。ところが、毎月の数時間の確認や深夜の障害対応の人件費まで含めると、差が縮むことがあります。
小さく始めて検索量と利用率を測り、将来の増強条件を見積書に明記すると、予算を説明しやすくなります。
日本語・型番・同義語で検索品質を高める方法
検索品質は、データ項目や利用者の言葉をそろえ、評価を重ねて高めていくものです。導入した時点で自動的に決まるわけではありません。
日本語や型番、略称、旧名称が混在する場合は、自然言語処理に加えて、データの正規化も進めます。
日本語の表記揺れへの対応
「サーバー」と「サーバ」、「申込」と「申し込み」などの違いは、ログや担当者への聞き取りから整理します。「医療機関」と「病院」のような語も、同じ方法で洗い出します。
タイトルやカテゴリ、本文、タグといった属性を定義し、それぞれの重要度も設定します。
似ていても意味が異なる語を同義語にすると、ノイズが増えます。そのため、登録理由と見直し日を管理しておきます。
型番・コードの誤字許容と業務ルール
型番やバーコードは、1文字違うだけで別商品になることがあります。人名や薬品名、契約番号、エラーコードにも同じことが言えます。
誤字許容は全面には適用せず、属性ごとに検証します。たとえば、コードは完全一致を優先し、説明文には誤字許容を使います。
テストには、先頭文字の誤りやハイフン、英数字の大小を含めます。全角半角や空白の有無も確かめます。
代表クエリの評価表による改善の数値化
評価表には、検索語と期待結果、許容順位を書きます。加えて、上位結果やゼロ件、担当者判定、改善メモも記録します。
導入の前後で同じクエリを実行し、上位3件または10件に正解が入る割合を比べます。ゼロ件率やクリック率も、あわせて比べます。
速度が改善しても、目的の商品や文書が見つからなければ成功とはいえません。そのため、妥当性と業務成果を別々に追います。
認証・権限・個人情報を守る運用設計
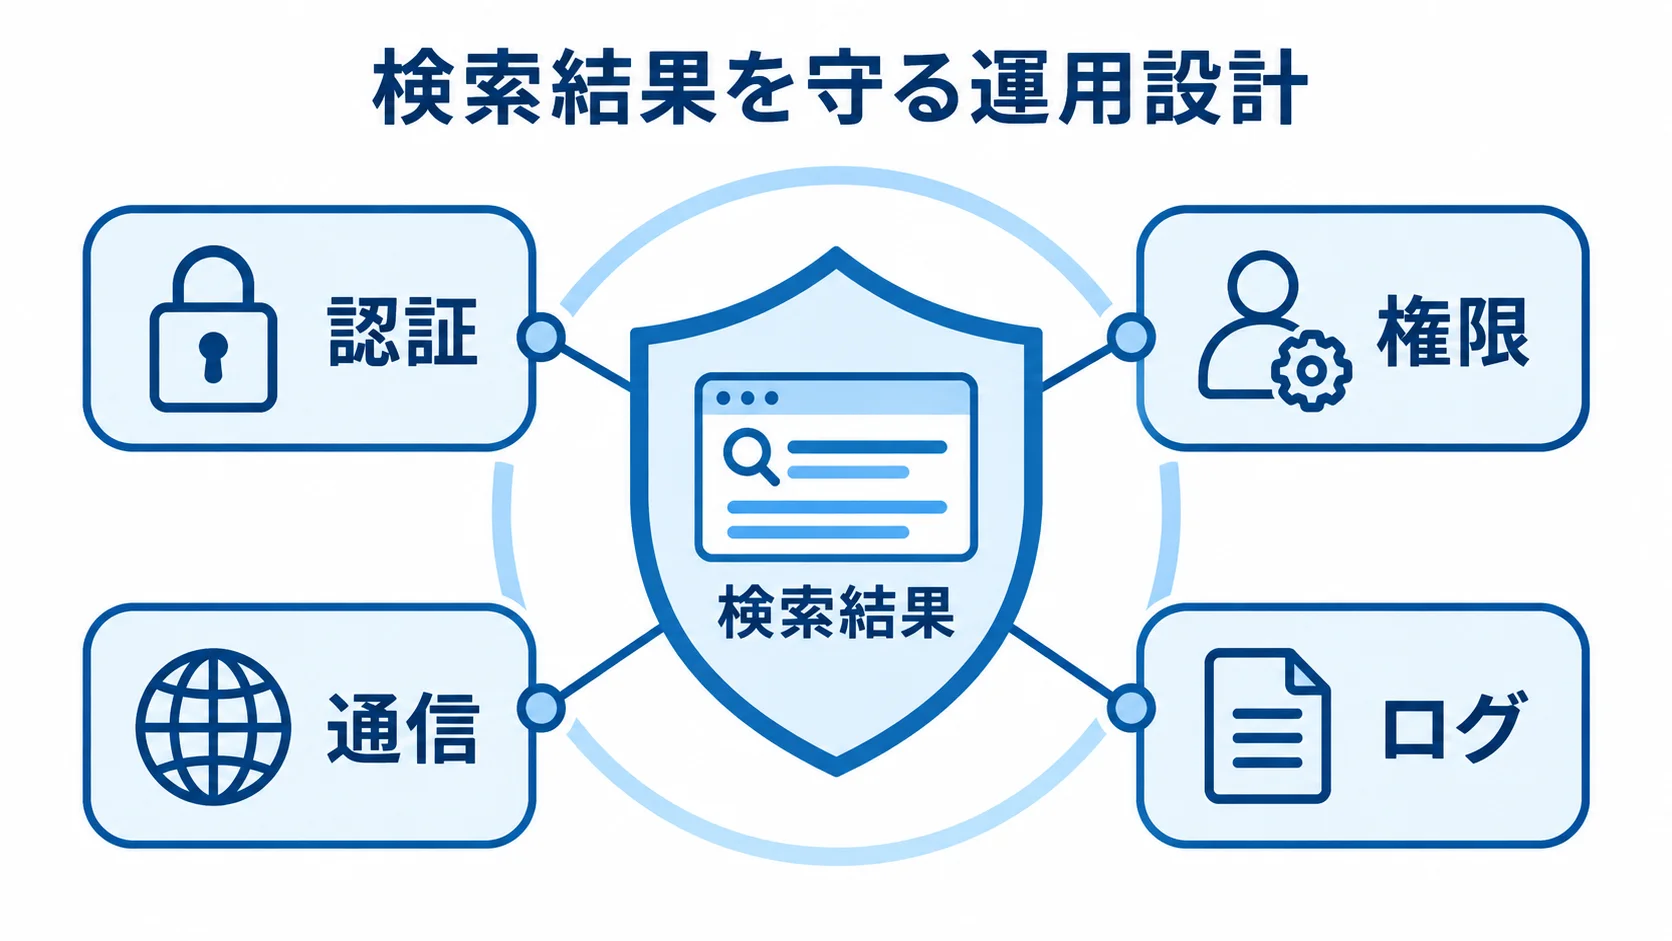
検索インデックスには顧客情報や社内文書、取引情報が入ることがあり、検索結果は文書の内容をそのまま返します。
公開ネットワークに置く場合は、認証や権限、通信の保護を非機能要件に含めます。ログ、削除、委託先の管理も、同じ要件として含めます。
APIキーとテナント単位の絞り込みの違い
master keyは設定情報として安全に保管し、通常の検索リクエストには使いません。
公式ガイドは、管理用・検索用キーと、利用者ごとに条件を制限する短期tenant tokenを説明しています(出典: Meilisearch公式Securing self-hosted Meilisearch、2026年8月確認)。
tenant tokenは検索条件を制限するためのもので、管理操作の認可ではありません。そのため、バックエンドの認可は省かずに行います。
個人情報のインデックス項目と委託先
個人情報を扱う場合は、検索用に保存する範囲と委託先の管理方法を分けて確認します。
- 保存の要否:インデックスに必要か、マスキングや匿名化で代替できるかの検討
- 保存条件:利用目的やアクセス範囲、保存期間、国外移転、バックアップ、削除依頼の整理
個人情報保護委員会の通則編は、委託先の安全管理措置を事前に確認し、契約や監査で取扱状況を把握するよう示しています。再委託についても、報告・承認や監査で確認します(出典: 個人情報保護委員会「個人情報の保護に関する法律についてのガイドライン(通則編)」、2026年8月確認)。
脆弱性対応とバックアップの定例化
2026年1月、セルフホスト版の一定範囲に認証済みSSRFが報告され、v1.34.1以降への更新が案内されました(出典: Meilisearch公式Security update、2026年1月)。
脆弱性を確認する担当者を決め、検証環境での更新や緊急更新の基準、ロールバック方法も決めておきます。
スナップショットまたはダンプを取得し、復旧テストを定期的に行います。
導入事例から学ぶ効果測定の考え方
公開事例は可能性を知る材料になりますが、自社の成果にそのまま当てはめることはできません。条件をそろえて、導入前後を測ります。
公開事例の数値と条件
公開事例には、利用規模や改善指標が事例ごとに異なります。そのため、数値の対象と条件を分けて読みます。
- 書籍検索:検索後の購入率が14%から20%へ上がり、検索経由購入が43%改善した事例です。
- 大規模検索:別の公開事例では、複雑なベクトル検索が多く使われました。
書籍の購入率改善は、特定のサービスやデータ、施策に基づく事例です(出典: Meilisearch公式顧客事例、2023年)。
2026年2月の事例は、数千万件のアセットと月3,500万回の検索を扱いました。そのうち約80%は複雑なベクトル検索でした(出典: Meilisearch公式顧客事例、2026年)。
いずれの事例も成果を保証するものではありません。自社で測るKPIを考える材料として使います。
検索経由の行動まで追う投資効果の説明
ECでは、検索から商品詳細、カート、購入までを追います。社内検索では、文書への到達や問い合わせ削減、作業時間の短縮を見ます。
ゼロ件率が下がっても、クリック後に離脱が続けば品質の課題は残ります。そのため、検索語とクリック結果を記録します。
重要クエリの上位結果を定期的に人が確認すると、数値と現場の実感を結び付けやすくなります。
Meilisearchの開発会社・ベンダーの選び方
検索の経験に加えて、データの棚卸しと同期、UI、権限を設計できるかを確認します。
インフラや保守まで扱えるかも見ます。
更新漏れや権限漏れがあると、本番では使えません。そのため、技術用語の多さより、成果物と検証方法の具体性を見ます。
実績の確認範囲(インデックス設計と同期)
データソース数や件数、更新頻度、検索量について質問します。権限モデルと、Cloudかセルフホストかもあわせてたずねます。
可能であれば、匿名化した構成図や同期失敗時の処理を見せてもらいます。再インデックスの方法や検索評価表も確認します。
公開できない場合でも、課題と解決指標を説明できるかが判断材料になります。
RFPに書く要件・成果物・保守範囲
提案条件をそろえるため、要件、見積もりの区分、契約時の確認事項をRFPに整理します。
- 検索要件:対象データと利用者、検索例、KPIを記載します。反映遅延や権限、ログ、個人情報も含めます。
- 運用条件:検索量や希望環境、納品物、運用体制の明記
- 見積区分:要件定義、データ整備、PoCを分けて見積もってもらいます。連携、画面、テスト、移行、保守も区分ごとに示してもらいます。
- 契約条件:脆弱性対応や再委託、データ削除、ソースコード・IaC・設計書の引き渡しに関する取り決め
- 契約終了時:移行条件をあらかじめ確かめておく項目
▶ 詳細はこちら:Meilisearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Meilisearchのシステム開発の発注/外注/依頼/委託方法について
よくある失敗例と導入前チェックリスト
失敗の多くは、前提の確認が足りないことで起きます。データ、権限、評価、運用の4つを確認しておくと、作り直しを減らせます。
後回しにされたデータ品質
空のタイトルや表記の不統一、未反映の公開終了フラグがあると、ランキング調整だけでは改善しません。古い本文が残っている場合も、データ側の修正が先に必要です。
項目表では、必須項目と正規化の方法を確認します。更新元、削除条件、保持期間もあわせて確かめます。
データ整備は発注者の協力事項として扱い、品質改善を開発会社だけに任せないことが大切です。
後から足す権限と同期の設計変更
後から部署別や顧客別、契約別の制限が必要になることがあります。そのため、文書単位の権限にするか、業務APIで事前に絞り込むかを、早い段階で決めておきます。
更新の失敗や削除漏れ、再インデックス中の切り替えは、実データでテストします。権限と同期も、PoCの段階から含めます。
導入前に用意する5つの資料
PoCと見積もりを比べるために必要な確認事項を、次の5種類の資料に分けて整理します。
- データ項目表:検索対象の項目の整理
- 評価表:代表クエリと期待結果の記録
- 権限表:利用者と権限の関係を示す表
- 連携フロー:データ連携とエラー時の流れを示す図
- 費用・運用一覧:費用と責任範囲のまとめ
各資料には、検索量や文書サイズ、ピーク時間を加えます。さらに、許容遅延とバックアップの保持期間も書き込みます。
よくある質問(FAQ)
導入時によくある疑問に答えます。導入の可否は、データ量や権限、更新頻度、運用体制を確認したうえで判断します。
Meilisearchは無料で使えますか?
自社サーバーでOSS版を運用すれば、ソフトウェア料金を抑えられます。
ただし、サーバーやストレージ、監視にかかる費用は必要です。バックアップや更新、障害対応、開発費も見込んでおきます。
一方で、Cloudは公式Pricingで月額20ドルからです。データ量や検索量で変わるため、総額で見積もります。
日本語のサイトや型番検索に向いていますか?
日本語のサイトや型番検索にも向いていますが、実データでの評価が前提です。表記揺れや略語、型番の記号、全角半角、誤字許容を代表クエリに含めます。
タイトルやコードなど属性ごとにランキングを調整します。誤検索が大きな問題になる型番や薬品名は、完全一致を検討します。
MeilisearchでRAGや生成AI検索はできますか?
RAGや生成AI検索はできますが、インデックスを作るだけで正しい回答が自動的に生成されるわけではありません。
はじめに、重複や古い文書を整理します。そのうえで、検索時と生成時の権限を確認し、根拠文書を表示します。
次に、キーワードまたはハイブリッド検索の取得結果を評価し、必要な範囲へ生成AIを広げます。
既存データベースの検索をMeilisearchへ置き換えられますか?
検索機能だけの置き換えは可能ですが、既存DBを正本として残し、インデックスへ同期する構成が基本です。
DBの更新や削除、権限、トランザクションは移さず、検索に必要な項目だけを連携します。
反映遅延と同期失敗時の復旧方法を決めてから、移行します。
まとめ
MeilisearchはWebや業務アプリへ使いやすい検索を組み込む選択肢です。全文検索やサジェスト、誤字許容に対応します。さらに、絞り込みやランキングも扱えます。
ベクトル検索やハイブリッド検索にも広げられます。一方で、正本同期や品質、権限の設計が欠かせません。個人情報、バックアップ、脆弱性対応も、あわせて設計します。
導入判断で確認する検索目的・データ・権限・TCO
検索対象と利用者を洗い出し、代表クエリとKPIを作って、PoCで検証します。
初期費は小規模PoCの30万〜100万円程度から、大規模な権限・AI・高可用性案件で1,500万〜5,000万円以上まで幅があります。
Cloudやサーバー料金だけでなく、連携やデータ整備、保守、バックアップ、AI利用まで含むTCOで比べます。
最初の一歩となる代表クエリとデータ項目表の作成
検索要件の整理から発注準備、成果の確認まで、次の順で進めます。
- 利用者の検索語を集め、期待結果と閲覧範囲を整理します。
- データ連携、権限、Cloudまたはセルフホスト、運用責任を含むRFPを作ります。
- 安全に必要情報を見つけられることを、速さとともに成功条件にします。
▼関連記事一覧
・Meilisearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Meilisearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Meilisearchのシステム開発の見積相場や費用/コスト/値段について
・Meilisearchのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。