
Meilisearchのシステム開発は、要件整理から定着までの6段階で進めます。段階ごとに成果と判断基準を残して次へ進むと、検索を業務の成果につなげやすくなります。
全体の構成は、完全ガイドの記事で詳しく解説しています。
▼全体ガイドの記事
・Meilisearchのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Meilisearchのシステム開発の全体像
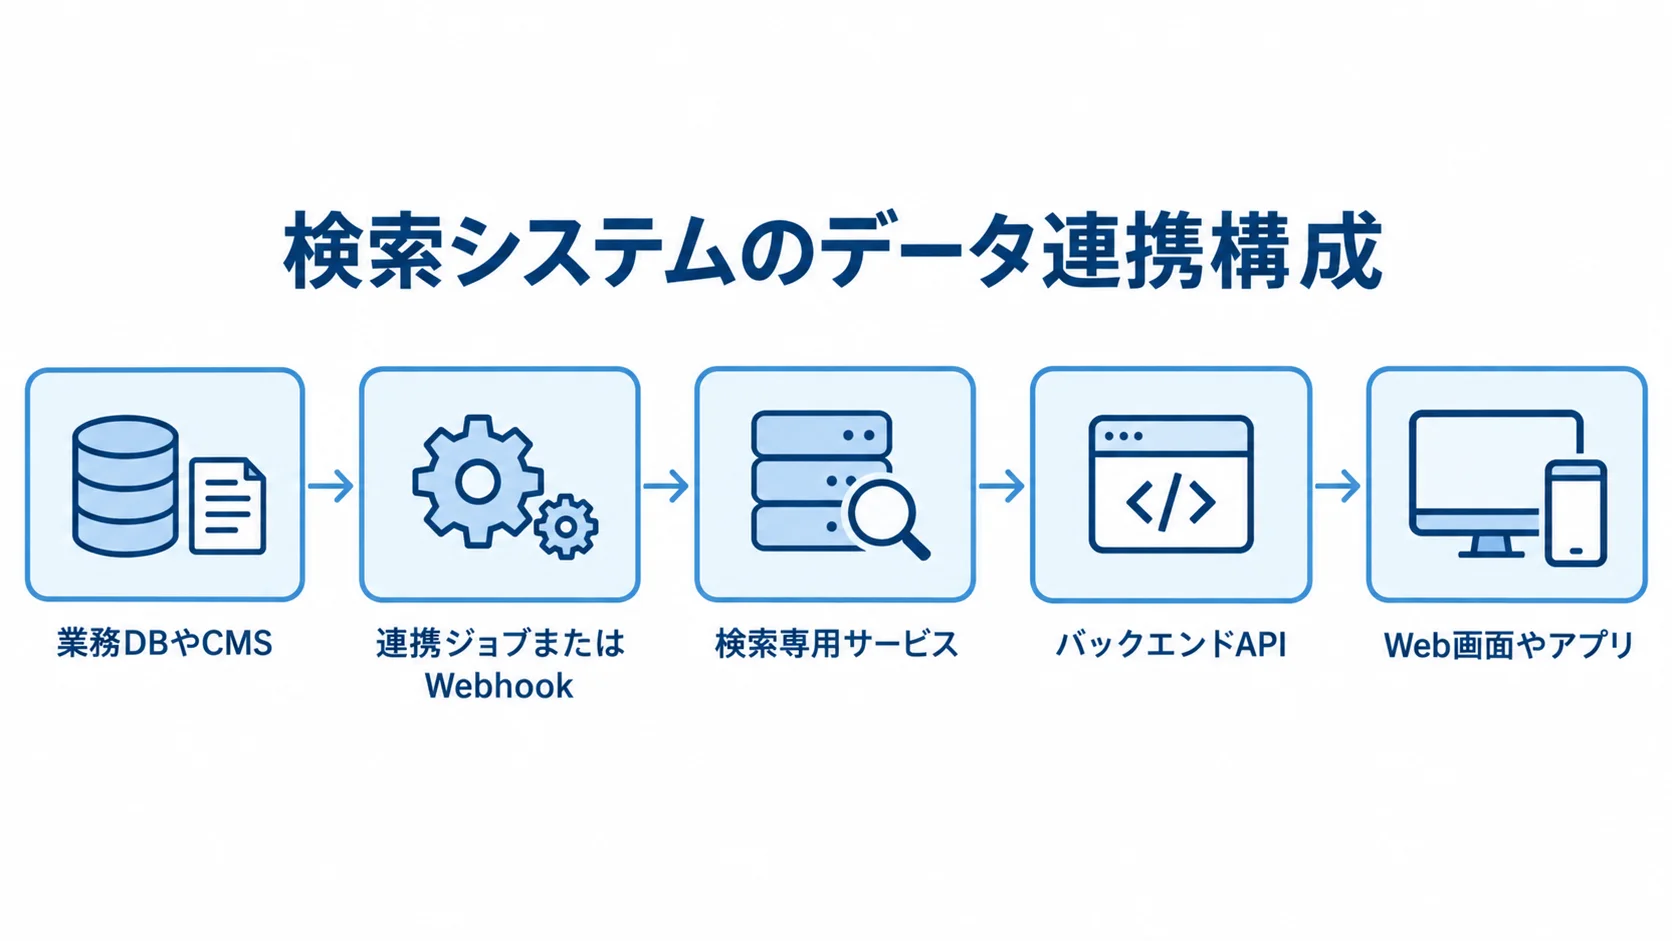
Meilisearchは業務データベースではなく、検索用に整形したドキュメントをインデックスとして保持する検索専用サービスです。
代表的な構成では、業務DBやCMSから連携ジョブまたはWebhookでデータを送り、インデックスを更新します。バックエンドAPIを通じて、Web画面やアプリへ検索結果を返します。
発注側と開発会社は、検索画面より先に、正本、検索結果への反映時期、利用者ごとの表示範囲を決めておく必要があります。
Meilisearchの機能とデータ管理
機能とデータ管理は、次の4点を押さえると全体が見えます。
- 基本の仕組み:検索データをインデックスへ同期し、入力に応じて結果を返す形。
- 検索機能と対象:用途に合わせて、検索機能と対象データを設定できる。
- ランキング:複数の評価基準を組み合わせて、順位を調整できる。
- 正本と更新:正本の管理方法と、インデックスの更新方法の設計。
全文検索やプレフィックス検索、タイプミス許容に加えて、フィルタやファセット、ソートも利用できます。対象は、商品、記事、求人のほか、FAQや部品番号、社内ナレッジです。
ランキングでは、ヒット語数や誤字数、語の近さなどを評価します。たとえば、タイトルや型番を説明文より重く扱えます。
価格や在庫などの正本は既存システムで管理し、検索に必要な項目だけをインデックスに持たせます。
検索結果に古い情報が残らないよう、初回投入、差分更新、削除を設計します。失敗したときに備えて、再試行や再インデックス、ロールバックも決めておきます。
向いている検索と不向きな検索
入力の途中で候補を出したり、検索語の揺れを許容しながら候補を絞り込んだりする検索に向いています。
- EC検索:商品名やブランド、カテゴリに加え、価格や在庫を組み合わせて絞り込みます。
- 社内検索:文書タイトルや部署、文書種別に加え、公開範囲を組み合わせた絞り込み。
日本語の自然文や英数字を含む型番の検索も、代表クエリで設定を調整しながら実用性を検証できます。
複雑な集計、厳密なトランザクション、結果ごとに異なる認可判定は、Meilisearchだけに任せる用途には合いません。権限はバックエンドで確認し、許可された結果だけを返す形にします。
自然文の意味を強く捉える場合は、全文検索とベクトル検索を組み合わせたハイブリッド検索が候補になります。ただし、文書の重複や欠損を解消してから、段階的に導入します。
Meilisearch公式の用語説明でも、ハイブリッド検索は全文検索とベクトル検索を組み合わせる方法とされています(出典: Meilisearch公式Glossary、2026年確認)。
Meilisearchのシステム開発の進め方
開発は、要件整理から定着まで、6つのフェーズに分けて進めます。フェーズ1から3は要件整理、選定、設計開発で、フェーズ4から6はテスト、稼働、定着です。各段階で何を作ったかと判断基準を残し、次の段階へ進む条件を関係者で合意します。
順番を飛ばすと、検索速度は十分でも、商品が上位に出ない、削除した文書が残る、利用者の権限を守れないといった問題が起こり得ます。
フェーズ1:要件整理による検索の目的とKPIの設定
検索の速さだけでは業務の効果を測れないため、「検索を速くする」という技術目標を、業務上の成果に置き換えます。KPIの候補は、業務によって変わります。
- EC:検索後の購入率や商品詳細のクリック率、検索ゼロ件率、再検索率。
- 社内ナレッジ:回答に着くまでの時間、問い合わせ件数、検索後の文書閲覧率。
導入前の現状値は最低1〜2週間分を確認しておき、導入後も同じ定義で比べられるようにします。
次に、データの正本と対象件数、文書の平均サイズ、更新頻度を整理します。削除条件と公開範囲、同義語を決めたうえで、型番や固有名詞の扱いを確認します。既存APIの有無も含め、これらをデータ項目表にまとめます。
検索できる人は、部署や顧客、契約、文書種別ごとに整理し、権限マトリクスにまとめます。この段階で残すものは、目的とKPI、データ項目表、権限マトリクスです。代表クエリ50〜200件と非機能要件も含めて残します。
フェーズ2:Meilisearchと運用方式の選定
製品は機能表だけで比べず、同じデータと代表クエリで比較します。候補には、既存DB検索、Meilisearch、Algolia、Elasticsearch、OpenSearchなどがあります。
- 検索結果:上位5件の妥当性、誤字検索、型番の完全一致。
- 操作性:絞り込み、ゼロ件時の案内、インデックス更新の遅延。
- 運用負荷:運用担当者に必要な作業時間。
検索品質は初期設定よりデータ項目と業務ルールに左右されるため、速度だけでは決めません。
Cloudとセルフホストは、月額料金だけでなく、どこまでを誰が受け持つかも比べます。Cloudの利点は、短期検証を始めやすいこと、バックアップや更新の負担を軽くできること、拡張しやすいことです。
セルフホストは、閉域網やデータ所在地、細かなインフラ制御を重視する場合に向いています。
専用ユーザーやmaster key、リバースプロキシ、HTTPSの設定は、自社または委託先が担います。監視やスナップショット、復旧訓練も、自社か委託先の作業になります。
個人情報や社内機密を扱う場合は、リージョンやDPA、再委託の扱いを確かめます。監査や削除の方法も確認の対象です。
フェーズ3:インデックス、連携、検索APIの設計と開発
ドキュメントはそのまま複製せず、検索画面に必要な項目だけに整形します。たとえば商品なら、商品IDや商品名、ブランド、カテゴリを持たせます。さらに、価格や在庫、検索用の別名、公開状態も入れます。
内部メモや不要な個人情報は、インデックスから除外します。一方で、タイトルや型番のように検索順位を上げたい属性は、先に決めておきます。フィルタやファセット、ソートに使う属性は、設計の早い段階で決めます。
英数字と日本語が混在するデータでは、実データを使って検索語の揺れを確かめます。連携処理では、初回のフル投入と差分更新を分けて設計します。
- 更新連携:登録、更新、削除を、イベントか定期ジョブで処理する。
- 失敗への備え:リトライや重複防止、順序逆転への対応、再実行。
- 監視と切り替え:処理件数を監視し、新インデックスを確認してから切り替える。
大きな設定変更は、新しいインデックスへ投入します。そのうえで、エイリアスや切り替え手順を使い、影響を抑えます。
管理用のAPIキーはフロントへ渡しません。検索は、バックエンドAPIで認証と認可を済ませてから行わせます。
テナントトークンを使う場合でも、管理操作の認可とは別のものとして扱います。
フェーズ4:検索品質、権限、性能のテスト
代表クエリで、期待する文書が上位に出るか、誤字入力でも候補が返るかを確かめます。検索の良し悪しは、画面の見た目よりも、代表クエリの結果に表れるためです。
- 検索内容:型番の完全一致、フィルタ、ソートの動作。
- 評価記録:クエリ、期待する上位結果、実際の順位、ゼロ件時の動作。
- 改善追跡:合否と修正内容、クリック率やゼロ件率を測るイベント。
セキュリティでは、別テナントや非公開の文書が返らないこと、検索用のAPIキーに管理権限がないことを確かめます。
検索結果にHTMLを表示する場合は、適切にエスケープされるかも確かめます。性能では、通常時とピーク時の応答、同時アクセス、更新中の応答を試します。メモリ使用量と障害時の再起動も、試す項目に入ります。
公式の本番デプロイ手順でも、production環境や強いmaster key、HTTPS、バックアップ、障害時の再起動が取り上げられています(出典: Meilisearch公式Deploying Meilisearch、2026年確認)。
フェーズ5:段階的な稼働
本番への切り替えは段階的に行い、比較の結果と運用体制を確かめます。
- 段階導入:社内の一部部署か、会員の一部、読み取り専用の検証画面から始める。
- 並行比較:旧検索と代表クエリの結果の差、応答時間、ゼロ件率、問い合わせ内容を比べる。
- 切り戻し:旧検索へ戻す条件と担当者、判断期限を決め、現場への影響を抑える。
- 運用判定:稼働後の対応体制と確認項目の点検。
- 更新体制:更新の担当窓口と検証環境の用意。
KPIのほか、同期失敗の検知や削除依頼への対応、障害時の連絡先を点検します。バックアップの復旧や脆弱性確認の担当も、決まっているか見ておきます。
セルフホスト版では、2026年1月に認証済みSSRFの修正が案内されました。そのため、計画的な更新が必要です(出典: Meilisearch公式Security Update、2026年1月)。
導入時にバージョンを固定するだけでなく、更新の窓口と検証環境も用意しておきます。
フェーズ6:検索の業務への定着
リリース後も、検索ログと運用状況を定期的に確かめ、改善と復旧に備えます。
- ログの確認と改善:ログをもとに、検索設定やデータを改善する。
- 定期評価:代表クエリを毎月か四半期ごとに再評価し、KPIの変化と施策を記録する。
- 担当者への引き継ぎ:業務担当者が評価できるよう、管理画面や評価シートを渡す。
- 運用記録:運用状況と保守項目を残す。
- バックアップ運用:取得から復旧までの手順を整える。
検索品質は、リリースの日に完成するわけではありません。ゼロ件の語や再検索された語、未クリックの結果を見て、同義語やランキング、データ項目を改善します。利用される絞り込みも、改善の材料になります。
運用記録には、同期失敗件数や反映遅延、ゼロ件率、応答時間を含めます。CPU・メモリ・ストレージの状況も入れます。バックアップの成功や復旧テストに加えて、APIキーを洗い出す作業、脆弱性対応、辞書更新も記録します。
公式では、スナップショットを復旧用、ダンプをバージョン移行用としています。
自社運用では、毎日取得したものを別サーバーに保管し、定期的に復旧テストを行います(出典: Meilisearch公式Backing up Meilisearch data、2026年確認)。
Meilisearchのシステム開発にかかる費用相場
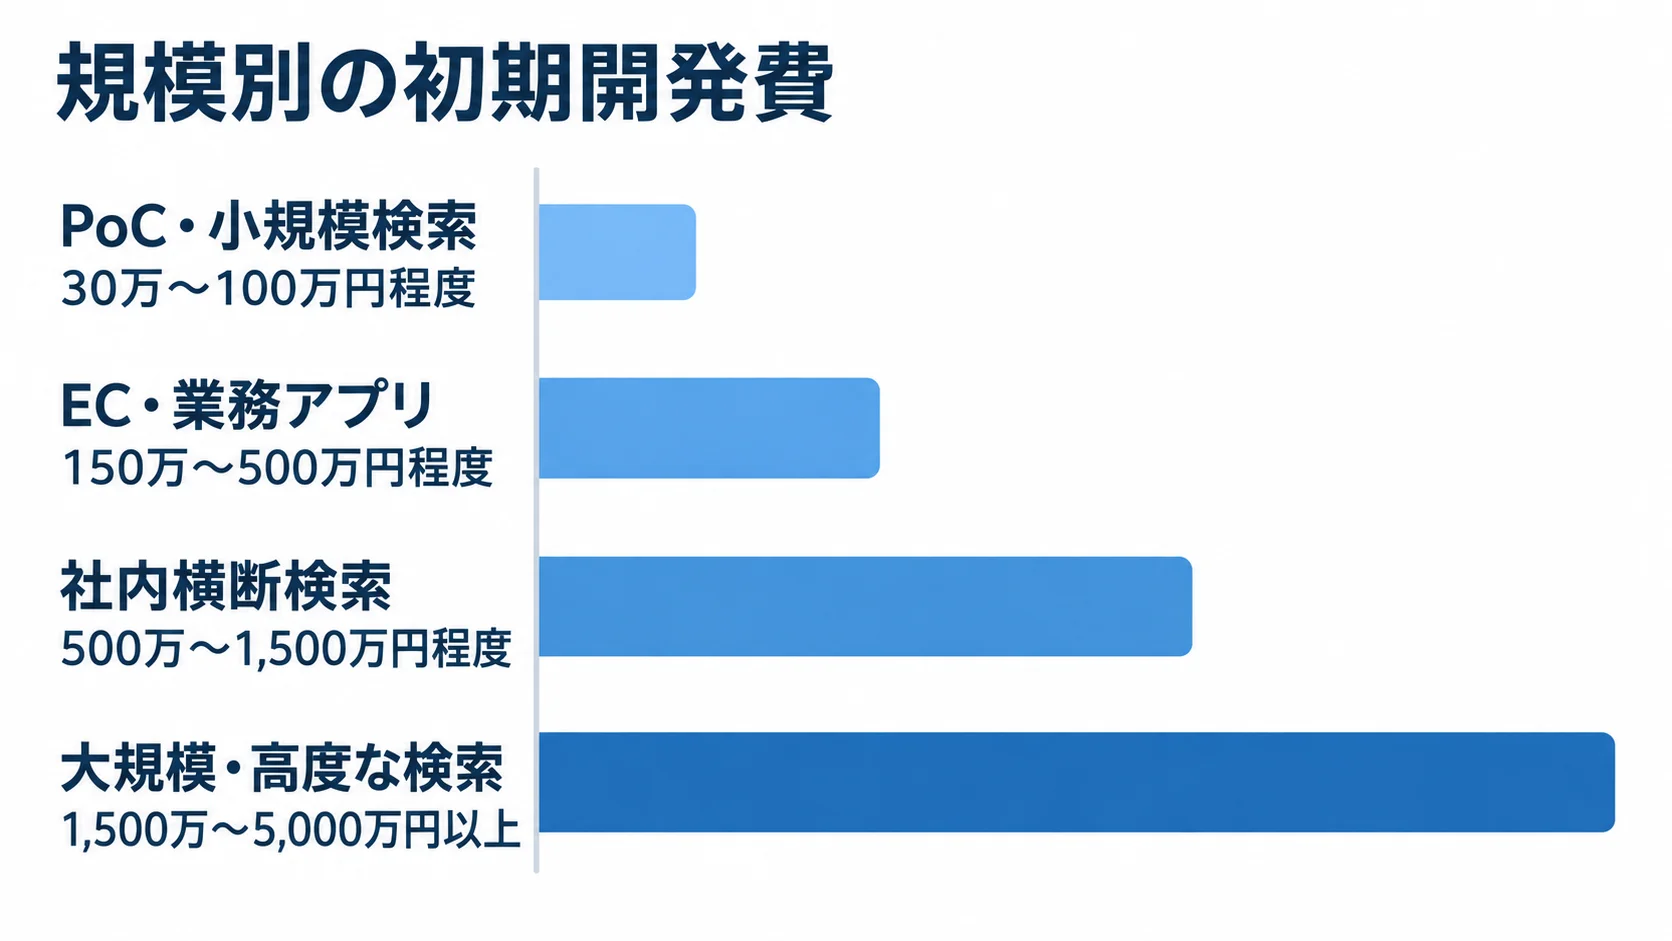
開発費は、ライセンス料やCloud料金とは別に、データの数と品質、連携先の数、検索画面、権限などで変わります。さらに、検索評価やインフラ運用、AI機能の有無も費用に影響します。
ここでの金額は、Meilisearch専用の公的な相場表ではなく、一般的な業務システムの工程と検索連携の実装量から整理した目安です。要件定義を終えた後に、見積もりの幅を狭めていきます。
規模別の初期開発費と期間の目安
想定する検索規模や機能に応じて、初期費用と開発期間の目安を比べます。
- PoC・小規模検索:1データソース・数万件なら30万〜100万円程度、2〜6週間が目安です。環境構築、インデックス、検索UI、基本評価を含みます。
- EC・業務アプリ:数万〜数十万件なら150万〜500万円程度、1〜3か月が目安です。
- 社内横断検索:複数システム、テナント分離、認証、監査ログ、移行、運用設計を含む場合は、500万〜1,500万円程度、3〜6か月を見込むことがあります。
- 大規模・高度な検索:要件が大規模で高度な場合は、1,500万〜5,000万円以上、6〜12か月以上になることがあります。
既存画面でも、データ整形や表示の変更があれば工数が増えます。そのため、検索APIと画面改修の費用を分けて確認します。
ECや業務アプリの目安は、差分同期や絞り込み、サジェストを行う場合のものです。ランキング調整や画面・API、テストも含めて見込んでいます。
大規模・高度な要件には、EmbeddingやLLM連携を含むハイブリッド検索や大規模データ、高可用性が含まれます。負荷試験や複数リージョンも対象になります。
金額は、案件条件から算出した推定レンジです。Meilisearch公式の開発料金ではありません。事業への影響が大きい検索では、データ品質と評価基盤に予算を振り分けると、本番後の手戻りを減らせます。
Cloud料金・インフラ費・保守費の切り分け
Cloudや自社運用、保守、AI機能の費用を分けて見積もると、継続費用を比べられます。
料金は、データ量や検索数、リソース、リージョン、追加機能で変わります。AI費は、Embedding生成と再計算、LLMトークン、再ランキング、評価用データに分けて考えます。
- Cloud:利用量に応じて月額料金が発生します。
- Resource-based pricing:2025年10月発表。CPUとRAMを選び、資源と性能を予算化しやすい方式です。
- Enterprise:専用リソース、SSO SAML・SOC 2、最大99.999%のSLA、シャーディング・レプリケーションを含む個別見積もりです。
- 自社運用:ソフトウェア料金を抑えやすい一方、運用人件費が発生します。
- 保守費:初期費の年15〜20%が目安です。24時間監視などで変動します。
2026年時点の公式Pricingでは、Cloudは月20ドルからです。10万ドキュメント・月5万検索のUsage-basedは月30ドル、0.5 vCPU・1GB RAMとストレージのResource-basedは月23ドルです(出典: Meilisearch公式Pricing、2026年8月確認)。
初期費が3,000万円なら、保守費は年450万〜600万円になります。Cloud・インフラ費は別途かかるため、実際の利用量をもとに試算します。
Meilisearchのシステム開発で見積もりを取るポイント
見積もりは、総額の安さより先に、含まれる作業と別費用の範囲をそろえて比べます。
作業は工程ごとに分けます。要件定義、データクレンジング、連携は、どこまでを誰が受け持つかを書きます。検索APIと画面、認証・権限、テストは、別の作業として並べておきます。移行、監視、保守、引き継ぎまで並べておくと、各社の前提が見えます。
RFPに明記するデータ、検索語、権限、成果物
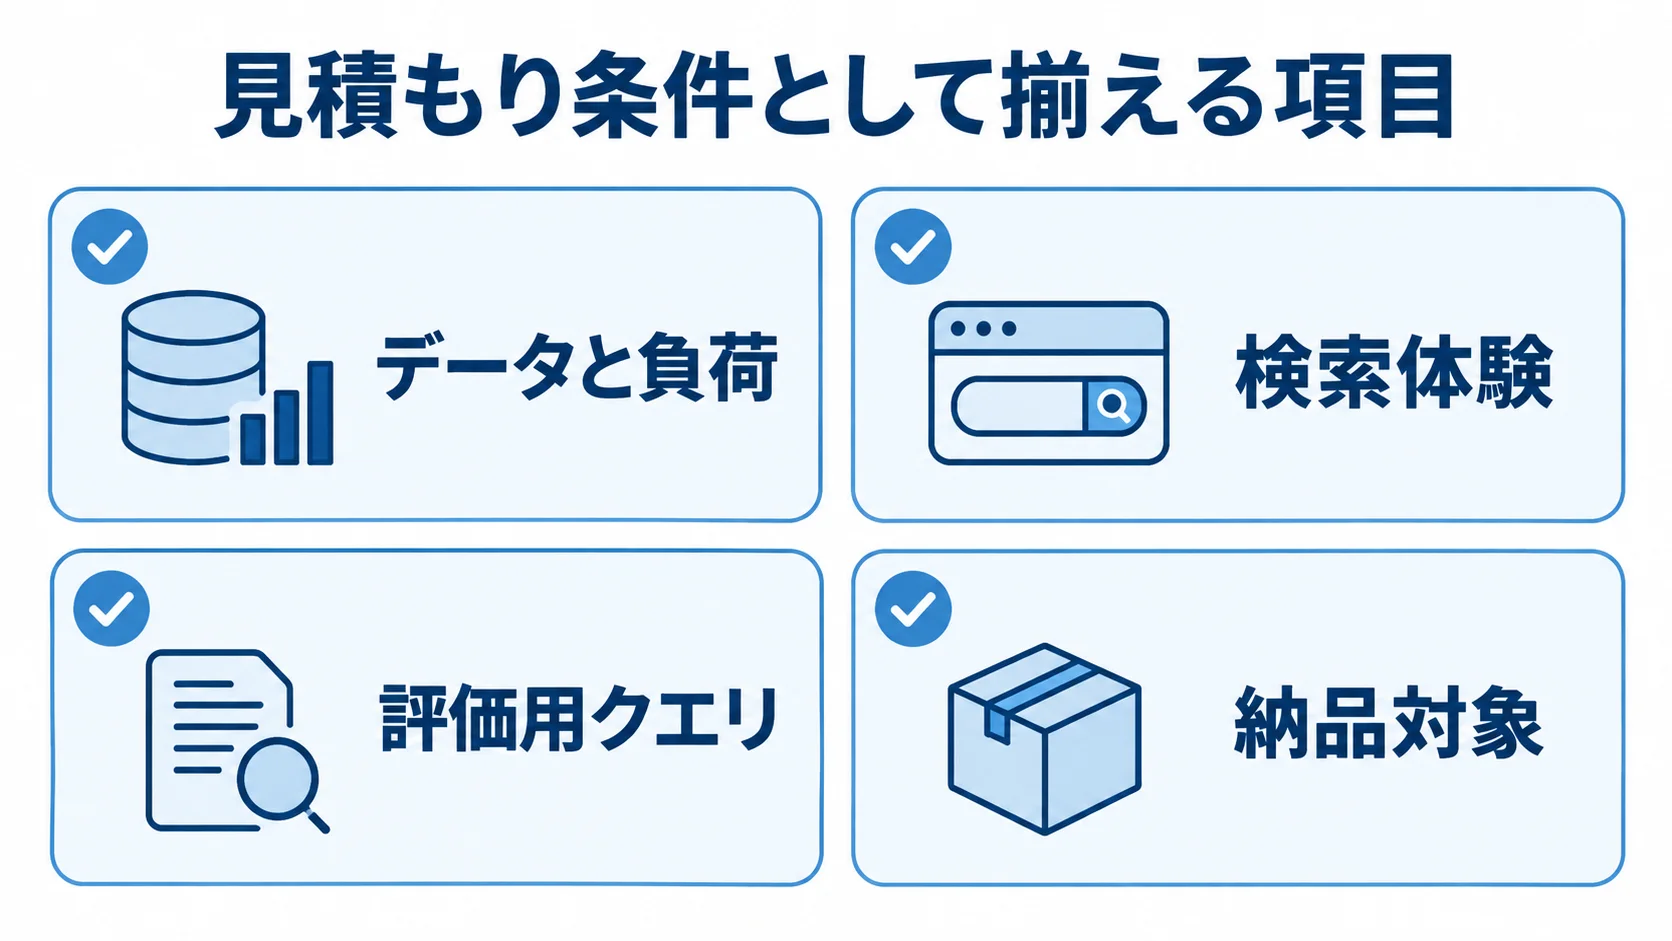
発注前に、見積もりの条件として、次のデータと検索要件をそろえておきます。
- データと負荷:データソース、件数、更新頻度、ピーク時の検索数、平均文書サイズ。
- 検索体験:応答時間、対象画面、フィルタ、同義語、型番、ゼロ件時の動作。
- 評価用クエリ:実際の検索語を優先し、誤字や略語、表記揺れ、存在しない語も含める。
50〜200件程度の代表クエリと期待する結果を渡すと、各社の提案を同じ基準で評価できます。
納品対象に、要件定義書やデータ項目表、インデックス設計書、同期仕様が含まれるかを確認します。API仕様や権限設計、テスト結果も、納品に含まれるかを見ます。
監視設計や復旧手順、運用マニュアルも確認の対象です。ソースコードやIaC、引き継ぎ資料も、対象に入れます。
設定値や同義語、ランキングルール、検索評価データが納品から抜けていると、別の会社へ保守を移しにくくなります。
検索技術だけでなく業務理解と運用体制で比べる開発会社
会社選びでは、検索技術、業務理解、運用体制を、同じ条件で比べます。
- 技術と運用の質問:同期失敗や削除の検知方法、権限フィルタの実装場所、検索品質の評価指標を聞きます。
- 実績と提案:似たデータ量や権限要件の事例、匿名化した設計成果物、PoC期間と合格基準を確認します。
- PoCの判定材料:代表クエリの上位結果、ゼロ件率、検索反映遅延、ピーク時の応答時間を判定に使う。
- 事例の読み方:公式事例の規模を自社にそのまま当てはめず、実データで検証する。
合格基準では、代表クエリの上位結果が業務担当者の評価で一定割合以上になることを定めます。また、ゼロ件率や検索反映の遅延は、現状と比べてどれだけ改善したかを基準にします。
公式のScenario事例では、数千万件規模のアセットと月3,500万回超の検索が紹介されています。そのうち80%がベクトル検索とされています(出典: Meilisearch公式Scenario事例、2026年2月)。
追加費用につながるリスクの洗い出し
データ、AI機能、個人情報の扱いは、追加費用につながりやすい部分です。事前に確認しておきます。
- データ品質と分担:元データの整備範囲と担当を、見積もりに明記する。
- AI検索の追加作業:Embeddingや評価、権限継承などの追加工数を見積もる。
- 個人情報の管理:安全管理措置、再委託の報告・承認、監査、データ削除・返却、国外移転を契約と運用の両面で確認します。
必須項目の欠損や重複、古い公開状態があれば、投入前の整備が必要です。部署名の揺れや削除済みデータの残存がある場合も、投入前に直しておきます。
クレンジングを発注側と開発会社のどちらが担うか、支援範囲とサンプル調査の範囲を、見積もりに記載します。
AI検索では、Embeddingモデルの選定と、文書のベクトル化や再生成が対象になります。さらに、評価や根拠の提示、権限継承、誤回答時の人手確認も含まれます。
生成AIを使えば検索が良くなると決めつけず、まずはキーワード検索のゼロ件率と上位結果を改善します。
よくある質問(FAQ)
費用や期間は案件の条件で変わるため、判断の軸と、発注前に確認する項目を押さえておきます。
Meilisearchは無料なので、開発費も安くできますか?
セルフホストではソフトウェア料金を抑えられますが、開発費や運用費はかかります。
データ整形や同期、検索APIや画面の開発に加えて、認証・権限の設定も必要です。監視やバックアップ、更新、障害対応も、運用として発生します。Cloudを使う場合も、公式料金に加えて初期実装と保守を見積もります。
Meilisearchのシステム開発にはどのくらいかかりますか?
1つのデータソースで検索を試すPoCは2〜6週間、標準的なECや業務アプリの検索は1〜3か月が目安です。
複数システムと権限を含む社内検索は3〜6か月、ハイブリッド検索や高可用性を含む大規模案件は6〜12か月以上かかることがあります。
データを洗い出す作業や発注側の確認が遅れると、期間も延びます。そのため、代表クエリと権限マトリクスは早めに準備しておきます。
Meilisearchは日本語や型番の検索に使えますか?
使えますが、日本語や英数字、型番、略語、表記揺れを含む実データで、導入前に検証します。
商品名や型番を上位に置くランキングの作り方や、同義語辞書、完全一致の優先ルール、誤字許容の範囲を、業務担当者と調整します。
検索語ごとの期待結果を評価表に残します。実装者だけでなく、現場の担当者も合否を判断できるようにしておきます。
社内文書や顧客情報をMeilisearchで検索しても安全ですか?
安全性は、インデックス項目と認証・認可の設計で決まります。ネットワークやログ、バックアップ、委託契約の条件も、安全性に影響します。
管理用のAPIキーはフロントへ出さず、バックエンドで利用者の権限を確かめます。テナントトークンやフィルタも、適切に使います。
個人情報は、検索結果に表示する項目を最小限にします。保存期間や削除、再委託に加えて、国外移転や監査の条件も、事前に確認します。
まとめ
Meilisearchのシステム開発は、要件整理から定着までの6段階で進めます。各段階の判断を飛ばさなければ、検索を業務の成果に結びつけられます。
正本DBとの同期、検索結果の権限、代表クエリでの品質評価は、画面開発と同じ優先度で決めます。Cloudかセルフホストかに応じて、どこまでを誰が受け持つかや、バックアップと更新の運用も決めておきます。
着手時に用意する5つの資料
用意するのは、目的とKPI、データ項目表、代表クエリと期待結果です。加えて、権限マトリクスと運用・復旧チェックリストも必要です。
5つの資料をそろえておくと、開発会社への相談内容とPoCの合格基準を、同じ前提で話せます。
費用は、PoCか標準検索か、複数システム横断か、AI検索かで変わります。比べるときは、開発費、Cloudまたはインフラ費、保守費、AI関連費を分けます。
小さな検証と数字による本番移行の判断
まずは、1つのユースケースで実データを使ったPoCを行います。全データと全機能の移行は、その結果を見てから判断します。
- 小さく試す:1つのユースケースで実データを使い、検索品質、応答時間、同期遅延、権限、運用工数を確認します。
- 自社の数値で判断:公式事例の数値を流用せず、導入前後を同じクエリセットとKPIで比べます。
- 発注先を選ぶ:条件が明確になった段階で相見積もりを取り、成果物と保守体制も含めて決めます。
▼全体ガイドの記事
・Meilisearchのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。