
Milvusのシステムは、データの種類、検索規模、業務との連携範囲から構成方式を選び、PoC、本番化、運用設計の順に進めて組み立てます。
この順で進めると、業務で使える検索基盤につながります。構成方式、開発工程、費用、セキュリティ、委託先の選び方を、発注前に確認しておきたい順にまとめました。
▼関連記事一覧
・Milvusのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Milvusのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Milvusのシステム開発の見積相場や費用/コスト/値段について
・Milvusのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Milvusのシステムの概要
Milvusは、機械学習モデルが作ったベクトルを保存し、距離から似たデータを検索するOSSのベクトルデータベースです。キーワードが完全一致しなくても、文章の意味や画像の特徴が近い情報を探せる点が、一般的なキーワード検索との違いです。
ベクトル検索で変わる点
キーワード検索は、入力した語と文書中の語句が一致するほど結果が出やすい仕組みです。
- 意味の近さで検索:言い換えを近い意味のものとして扱いやすくなります。
- 正式名称が不要:「経費を精算する方法」から「出張費の申請手順」を探せます。
検索対象には、社内規程、製品マニュアル、議事録、契約書、問い合わせ履歴があります。
検索の仕組みでは、まず元データを分割し、Embeddingモデルでベクトル化してMilvusへ格納します。また、質問も同じモデルで変換し、近いチャンクを取得します。
必要に応じて、取得したチャンクをLLMへ渡します。さらに、回答に根拠文書のタイトルや更新日を表示すると、業務で確認しやすいRAGになります。
Milvus単体では業務システムにならない理由
Milvusが主に担当するのは、ベクトルデータの保存と検索です。そのため、Milvus単体では業務システムとして完成しません。
- 文書の取り込み:コネクタ、OCR、PDF抽出を用意します。
- 検索と権限:Embedding、認証、部署別フィルタの設計が要ります。
- 業務アプリ:画面、LLM、監査ログ、評価の仕組みを用意します。
これらを切り分けずに依頼すると、後からデータ整備や権限設計が加わり、費用と期間が膨らみやすくなります。また、元文書とメタデータを正本として保持し、検索インデックスを再構築できる構成にしておきます。
Milvusの種類とシステム構成の比較
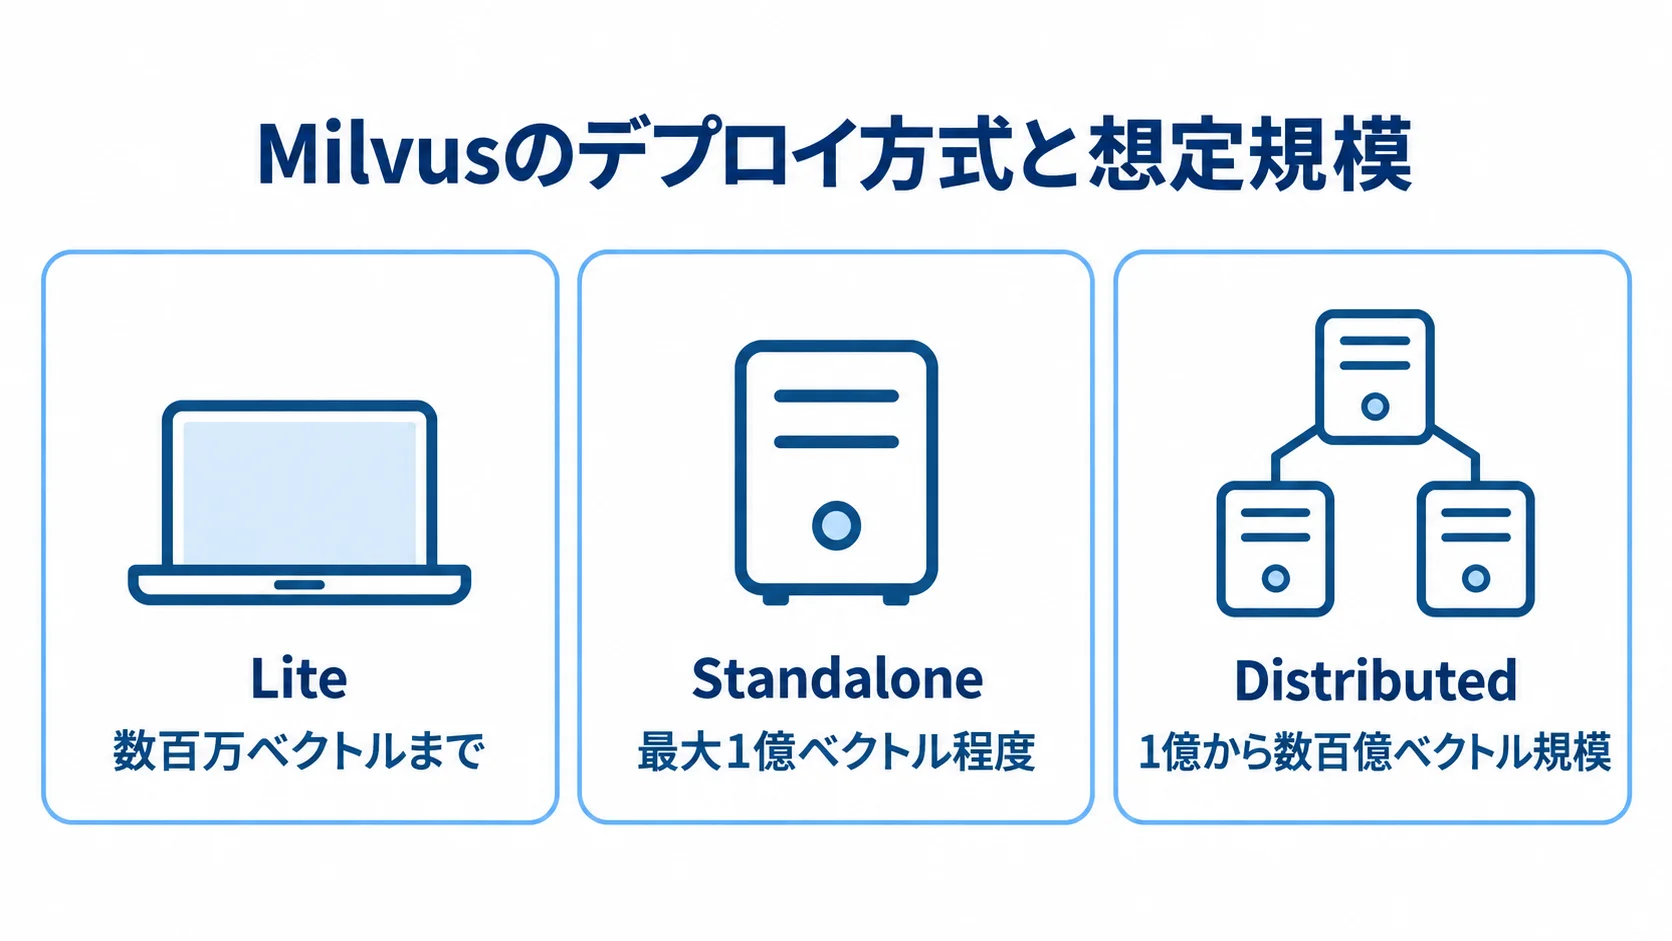
Milvusには、ローカル検証向けのLite、単一サーバーで動かすStandalone、Kubernetes上で分散するDistributedがあります。
公式資料では、Liteは数百万ベクトルまでの小規模用途、Standaloneは十分なマシン資源があれば最大1億ベクトル程度を扱うとされています。Distributedは1億から数百億ベクトル規模を想定します(出典:Milvus公式デプロイ方式ドキュメント、2026年8月確認)。
Milvus Liteの特徴と向いている用途
Milvus LiteはPythonライブラリとして組み込める方式です。
- 検証しやすい:ノートブックや開発端末ですぐ試せます。
- PoCに向く:数百〜数千件の社内文書で検索設定を比較できます。
- 移行に備える:APIを共通化しておくと、検証コードを活用しやすくなります。
PoCでは、チャンク長、Embeddingモデル、検索上位件数を比べます。
一方で、Liteを本番の共有サービスにするのは避けます。本番運用で高可用性や同時アクセスに対応し、バックアップ、アクセス制御、監視を整える段階になったら、本番向けの方式への移行を判断します。
Milvus Standaloneの特徴と向いている条件
Standaloneは、複数のコンポーネントを一つのサーバーで動かします。
- 候補となる条件:Kubernetesの運用チームがない場合や、検索対象が中規模の場合に候補になります。
- 設計を集約:メモリ、CPU、SSD、ストレージ、監視、バックアップをまとめて設計します。
- 初期構築を簡素化:Distributedより構築を簡素化しやすい方式です。
単一サーバーでは、障害がサービス停止につながりやすく、検索ノードだけを増やす拡張も難しくなります。
公式資料では、Standaloneからクラスタへのオンラインアップグレードはできないと案内されています(出典:Milvus公式メインコンポーネント、2026年8月確認)。そのため、将来の拡張条件を定めてから採用します。
Milvus Distributedの特徴と向いている用途
Distributedは、Proxy、Coordinator、Streaming Node、Query Node、Data Nodeなどを分けて構成する方式です。Kubernetes上で個別に増強しやすい点が特徴です。
- 読み取りが多い場合:Query Nodeを調整します。
- 取り込みや作成が多い場合:Streaming NodeやData Nodeを調整します。
Distributedでは、必要な部分を調整し、業務の負荷特性に合わせて設計できます。
構成が高度になるほど専門性が必要です。Kubernetes、etcd、オブジェクトストレージ、WALに加えて、監視と障害復旧の経験も求められます。
Milvus Distributedは、数十億ベクトルという数だけでは選ばず、同時検索数と更新頻度を見たうえで、許容レイテンシ、復旧時間、運用体制も合わせて判断します。
Milvusのシステム開発の進め方
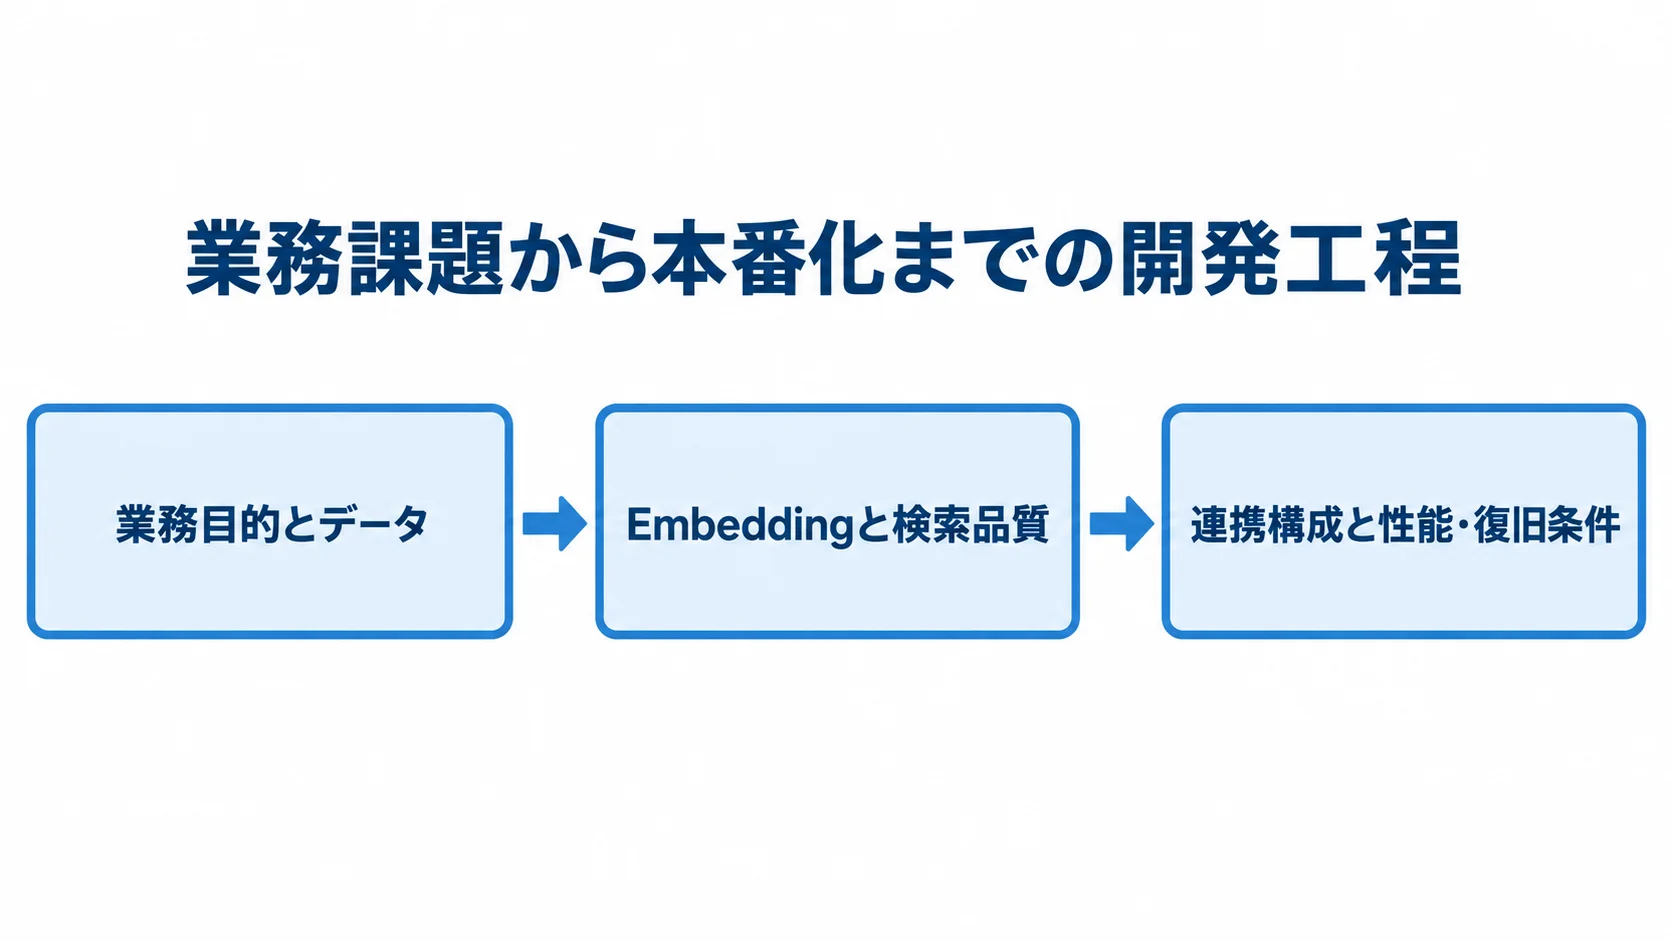
開発は、AIモデルやデータベースを先に決めず、業務課題と評価方法から始めます。RAGでは、回答の自然さだけでなく、根拠を検索できたか、権限外の文書を返さないか、更新情報が反映されたかも測ります。
要件定義での業務目的とデータの整理
業務目的は、KPIとして数値で定めます。たとえば、検索時間を何分短縮するか、一次回答率を何%にするかを決めます。
- KPI:検索時間、問い合わせの一次回答率、推薦のクリック率を定めます。
- 対象データ:PDF、Webページ、議事録、FAQ、業務データを洗い出します。
- 管理情報:所有部署、機密区分、更新頻度、保存期限、利用者を整理します。
評価には、正解の質問と正解文書の組み合わせを少なくとも数十問用意します。固有名詞や略語、表記揺れ、表や画像を含むPDF、古い版まで含めると、実運用に近い評価ができます。
重複データや更新日の欠落、不完全な部署マスタは、Milvusの設定では解消しません。そのため、評価の前にデータを整理しておきます。
PoCでのEmbeddingと検索品質の比較
PoCでは、検索の質に関わる設定と方法を比べます。
- 検索設定:チャンク長とオーバーラップ、Embedding、距離指標、インデックスを比較します。
- 検索方法:メタデータフィルタ、ハイブリッド検索、再ランキングを検証します。
- 評価範囲:全社文書は入れず、代表業務と評価質問に絞って、検索上位に正しい根拠が含まれる割合を測ります。
検索精度は、Milvusの性能だけでは決まりません。たとえば、PDFの文字抽出に失敗していれば、インデックスを変えても改善しません。
PoCでは、表の見出しと数値を同じチャンクに残し、文書IDと版数をメタデータに付けたうえで、質問者の部署で絞る設計も検証します。
本番化での連携・性能・運用の設計
本番化では、連携構成とデータ更新の方法、性能と復旧の条件を定めます。
- 連携設計:ETL、Embedding、Milvusの取り込み側と、検索API以降の利用側を分けます。
- 更新と削除:元データの更新時は差分だけ再Embeddingし、元文書の削除時はチャンク、ベクトル、キャッシュ、会話ログまで追跡して消します。
- 性能試験:検索と更新の性能、復旧にかかる時間を測ります。
試験では、同時検索数、P95・P99レイテンシ、インデックス構築時間、増分更新の遅延、障害時の再開時間を測ります。測った数値は、受け入れ条件と照らして判断します。復元可否、RTO・RPO、権限外データを返さないことも、受け入れ条件に含めます。
StandaloneからDistributedへ移る可能性があるなら、移行手順とデータ形式も確認しておきます。
Milvusのシステム開発費用の相場
開発費は、Milvusのライセンス料だけでは決まりません。公開文書のデモか、機密文書を扱う本番RAGか、既存業務システムと連携するかで変わります。
また、可用性や監査の要否も費用に影響します。ここで示す金額は、公開されているAI開発の目安と業務システムの工数による概算で、Milvus固有の定価ではありません。
▶ 詳細はこちら:Milvusのシステム開発の見積相場や費用/コスト/値段について
技術検証・PoCの費用目安(0〜500万円程度)
技術検証やデモは0〜100万円程度、期間は2〜6週間が目安です。
- 対象データ:公開文書を数百から数千件取り込みます。
- 検証環境:Milvus Liteまたは小規模Standaloneを使います。
- 検証内容:簡易画面と検索評価を行います。
OSSやクラウドの無料枠を使える場合でも、データ整理、Embedding、評価質問の作成、業務部門のレビューには人件費がかかります。
実データを使うPoCは、200〜500万円程度、期間は1〜3か月が目安です。
複数部署の文書や権限フィルタ、回答引用、ログ、負荷試験を含めると、工数はさらに増えます。機密文書の持ち出し審査や既存システム接続は、見積書で別項目に分けてもらいます。
本番RAG・AI検索の費用目安(800〜2,000万円程度)
本番RAGやAI検索は800〜2,000万円程度、期間は3〜6か月が目安です。
- 業務機能:認証、部署・テナント権限、文書更新、管理画面、根拠表示を整えます。
- 運用機能:監視、バックアップ、運用手順、既存システムとのAPI連携を含みます。
- 費用の上振れ:複数領域や低いデータ品質では要件定義・移行費が増えます。
大規模クラスタや複数テナント、閉域網、複数リージョンに加えて、24時間監視や厳格な監査・DRまで必要になると、2,000万円から1億円超となる場合もあります。
これは類似する大規模AI・検索基盤からの推定です。ベクトル数だけで決まらないため、利用者数、検索回数、更新量、P95、RTO・RPOを示して、見積もってもらいます。
ランニングコストは検索量と運用体制で変わる要因
ライセンス料がなくても、運用の形によって費用は発生します。
- 自己運用:サーバー、SSD、Kubernetes、メタデータストア、オブジェクトストレージ、WALが必要です。
- 運用作業:監視、バックアップ、脆弱性・障害対応にも費用がかかります。
- マネージド型:読み書き、保存、転送、監査ログが別課金の場合があります。
公開料金の一例では、1,536次元のベクトル100万件の書き込みが約6ドル、同次元100万件への読み取り100万回が約100ドルです。さらに、1,000万件への読み取り100万回は約300ドル、1億件では約1,160ドルです(出典:マネージドMilvusの公式料金表、2026年8月確認)。
1ドル150円で換算すると、順に約900円、1万5,000円、4万5,000円、17万4,000円になります。ただし、ストレージや転送は別料金で、月額の固定費とは限りません。
Milvusのシステムに必要なセキュリティと運用
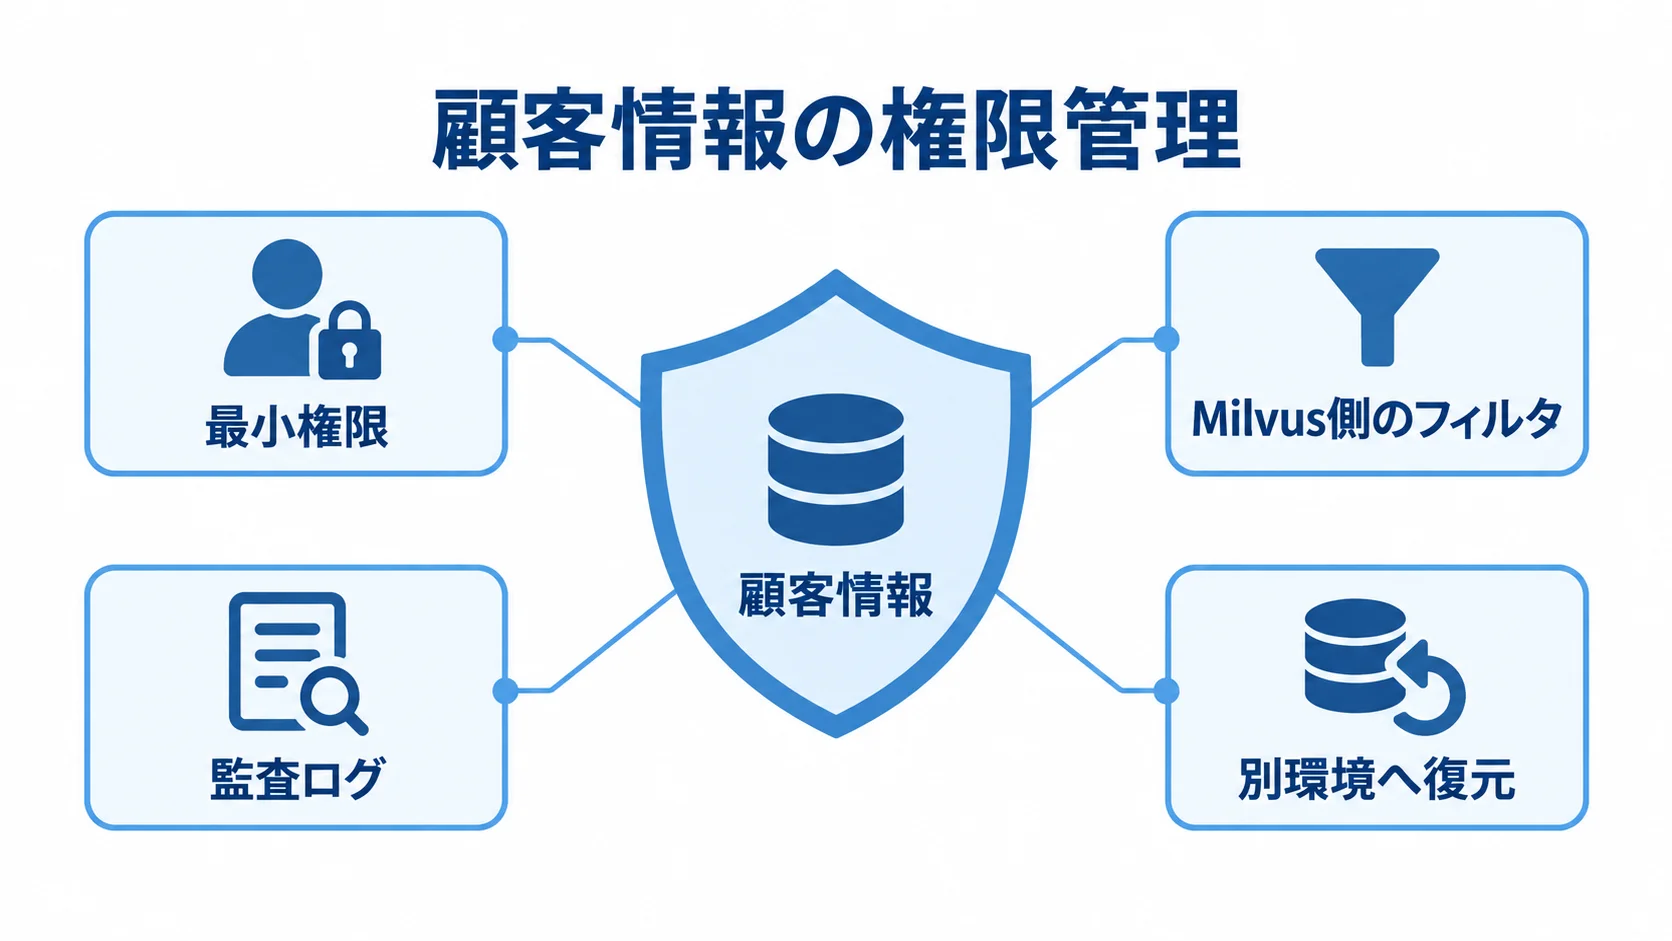
顧客情報や従業員情報、契約書、医療・金融文書を扱う場合、ベクトル化しただけで匿名になるとは限りません。元文書やIDと照合できるなら、利用目的、安全管理、委託先管理を検討します。さらに、保存期限と削除請求への対応も考えます。
AI事業者ガイドライン第1.2版は2026年3月31日に公表されました。安全性、セキュリティ、データアクセス管理、監査などを設計段階から検討する考え方が示されています(出典:経済産業省・総務省「AI事業者ガイドライン」第1.2版、2026年)。
アプリとデータベースの認証・権限管理
Milvusの管理者アカウントは、アプリから直接使わないようにします。
- 最小権限:サービスごとにユーザーとロールを作ります。
- RBAC:ユーザーへロールを付与し、ロールに権限を設定します。
- 通信と保存:TLS、暗号化、秘密情報、IP制限、Private Endpointを考慮します。
- 監査:監査ログの保存期間を要件に含めます。
RBACは、Milvus公式資料が案内する制御方式です(出典:Milvus公式RBACドキュメント、2026年8月確認)。
APIゲートウェイだけで部署を判定すると危険です。そのため、部署IDを付け、Milvus側のフィルタやコレクション分離でも制約をかけます。
部署の異なる評価データで漏えいテストを行い、権限変更や退職者の無効化が、検索結果、キャッシュ、ログに反映される時点も確認します。
バックアップと削除、復元テストの設計
バックアップと削除の対象は、ベクトルに加えて次の範囲まで広がります。
- 復元対象:スキーマ、メタデータ、インデックス、元文書の保存場所を管理します。
- 関連設定:Embeddingの版、ETL、評価データ、アプリ設定も保存します。
- 削除対象:原文、チャンク、ベクトル、キャッシュ、LLM会話ログを一つのデータマップで追跡します。
バックアップ機能を使う場合でも、別環境へ復元して、検索結果と更新時点を確認します。
元文書だけを消しても、ベクトルから内容が再び現れるおそれがあります。そのため、削除完了を監査ログに残し、定期的にサンプル検査を行います。
Milvusの開発会社・ベンダー・サービスの選び方
開発会社やサービスは、Milvusの経験年数だけで選ばないことが大切です。構築、RAGアプリ、業務連携、データ移行、Kubernetes運用、セキュリティ監査には、それぞれ別の専門性が必要です。
提案書では、どこまで担当できるかを確かめます。技術評価、納品・保守範囲、見積内訳も、具体的な内容で示してもらいます。
検索技術とデータ設計の実力の見極め
提案の場では、チャンク分割、Embedding、インデックス、ハイブリッド検索、再ランキングの選び方を聞いておきます。あわせて、日本語の表記揺れや表、PDF、画像、更新履歴を含むデータで評価した経験も確かめます。
検索上位に正解が含まれる割合やP95レイテンシを、数値で報告できるかも尋ねます。一方で、「Milvusを入れれば精度が上がる」とだけ説明する提案には注意が必要です。
精度は、データの重複、版管理、質問設計、Embeddingモデル、メタデータフィルタの組み合わせで変わります。そのため、PoCで仮説を比べ、不採用の方式とその理由も成果物に残せる体制が望ましいです。
契約前に決める納品物と保守範囲
納品範囲と保守条件を契約前に定めます。
- 設計資料:要件定義書、構成図、スキーマ、チャンク設計、インデックス設定を含めます。
- 評価と実装:評価質問・結果、Infrastructure as Code、ソースコード、テスト仕様を含めます。
- 運用資料:監視・復元手順と、サービスを変えてもEmbeddingモデルやLLMを切り替えられるインターフェース、再Embedding手順を含めます。
保守契約では、Milvusや周辺ミドルウェアの更新、脆弱性対応、容量増加を定めます。また、インデックス再構築や障害時の初動、問い合わせ時間、SLA、再委託の有無も明確にします。
初期開発費だけで比べず、3年間のクラウド費、モデル利用料、監視費、保守費、データ追加費を合算して比べます。
作業費と利用料を分けた見積書の比較
複数提案では、要件定義、データ整備、UI、API連携、Milvus構築を分けて記載してもらいます。さらに、Embedding、LLM、テスト、移行、教育、保守も、作業ごとに分けてもらいます。
- 作業費:要件定義から教育・保守までを分けて記載します。
- 利用・運用費:クラウド、ストレージ、外部API、監視、バックアップ、運用工数を含めます。
- 契約条件:評価未達時の追加検証、データ持ち出し、アカウントとコードの所有権、終了時のエクスポート、個人情報の委託先管理を契約前に確認します。
ただし、Milvusのライセンスが無料でも、これらの利用・運用費は無料になりません。契約条件の内容は、口頭ではなく契約書に文言として残しておきます。
業務部門が検証に参加できる計画か、業務上の効果を説明できるかも、長期運用を左右します。
▶ 詳細はこちら:Milvusのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:Milvusのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:Milvusのシステム開発の発注/外注/依頼/委託方法について
Milvusのシステムに関するよくある質問
導入前には、機能に加えて、データ量、更新量、権限、検索品質、運用体制を具体化しておきます。よくある質問への回答は、次のとおりです。
Milvusは無料で使えますか?
OSS版Milvusはライセンス料なしで使えます。ただし、システム全体が無料になるわけではなく、サーバー、ストレージ、監視、バックアップの費用がかかります。
Embedding、LLM、開発・運用の人件費も別途必要です。マネージド型を使う場合は、読み書き、ストレージ、転送、監査ログなどの料金を確認します。
Milvusと一般的なRDB・全文検索はどのように使い分けますか?
Milvusは、意味の近さで検索する処理に向いています。一方で、顧客ID、金額、在庫数、更新日時の厳密な集計やトランザクションの正本には、業務DBを使います。
完全一致や語句の頻度が重要な場合は、全文検索を組み合わせます。ベクトル検索とのハイブリッド検索にすると、固有名詞と文脈の両方を扱いやすくなります。
日本語の社内文書でもMilvusを活用できますか?
活用できます。日本語に対応したEmbeddingモデルを選び、表記揺れや略語、固有名詞、表やPDFの抽出品質を実データで評価します。
チャンクが大きすぎると根拠が埋もれ、小さすぎると文脈が切れます。そのため、複数の設定を評価質問で比べ、回答に正しい根拠が使われた割合も測ります。
Milvusを導入すればLLMの回答精度は必ず上がりますか?
必ず上がるとは限りません。検索対象が古い場合や、チャンクが不適切な場合、権限フィルタがない場合は、Milvusを導入しても誤回答が残ります。
質問に正解文書が存在しない場合も注意が要ります。検索評価、根拠表示、回答不能時の誘導、人手確認を組み合わせ、許容品質を定めます。
まとめ:検索基盤と業務設計を一体で捉えるMilvusのシステム開発の考え方
Milvusは、文章、画像、音声などの意味検索を高速化するベクトルDBです。RAG、社内AI検索、レコメンド、類似画像検索、不正検知などを支えます。
Milvus単体では業務システムになりません。そのため、データ収集やEmbeddingから、検索API、LLM、権限、監査までを一体で設計します。さらに、削除、バックアップ、評価、運用も同じ設計に含めます。
導入前に確認するチェック項目
業務KPIと運用体制に合う構成を選ぶため、確認する項目を次のとおり整理します。
- データ条件:対象量と更新頻度を確認します。
- 性能・復旧:同時検索数、P95・P99、RTO・RPOを定めます。
- 管理要件:保存地域、部署・テナント権限、監査ログ、削除期限を決めます。
- 契約条件:再Embedding、3年間の総額、納品物、保守範囲を確認します。
数十億ベクトルという規模だけでは決めず、Lite、Standalone、Distributed、マネージド型を比べます。
小さく始めて継続的に改善する進め方
検索ログと利用者評価をもとに改善を続けると、業務に定着しやすくなります。
- 定期的に更新:文書、モデル、権限、検索品質を月次や四半期で見直します。
- PoCから拡大:検証で得た結果を踏まえ、対象範囲を段階的に広げます。
- 運用先を選ぶ:構築だけでなく設計、連携、安全管理、運用、終了時の移行を確認します。
高機能を増やす前に、実際の質問へ正しく答えられる範囲を広げます。
代表データと評価質問で、検索品質や権限、更新、復元を検証します。そのうえで段階的に広げると、投資判断の根拠を積み上げられます。
開発会社やサービスは、構築実績だけでなく、データ設計、業務連携、セキュリティ、運用、終了時の移行まで説明できるかを確認します。
▼関連記事一覧
・Milvusのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・Milvusのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・Milvusのシステム開発の見積相場や費用/コスト/値段について
・Milvusのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。