
Milvusのシステム開発は、業務課題とデータを整理し、方式を選び、検索品質や権限を検証してから稼働と定着へ進めることで、業務利用につながります。全体は6つの工程に分かれ、順に進めていきます。
▼全体ガイドの記事
・Milvusのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
Milvusのシステム開発の全体像
Milvusは、ベクトルを保存して似たデータを検索する基盤です。
業務で使うアプリケーションと組み合わせて、システムとして構成します。
文書や画像、利用者の質問をベクトル化し、近い情報を検索します。
RAGでは、その検索結果をLLMへ渡し、参照元を画面に表示します。
業務システムにおけるMilvusの役割
Milvusは意味検索のデータ保管と検索を担います。そのため、周辺機能とデータ処理もあわせて設計します。一体で設計する対象は、元文書の品質、チャンク分割、Embeddingモデル、検索件数、再ランキング、回答評価です。
- 業務機能:文書管理、認証、ワークフロー、画面、LLMへの指示、監査ログ
- 登録処理:ETLによるデータの取り出し、重複や古い情報の整理、チャンク化
- 検索処理:部署・文書種別・公開範囲・更新日・原本IDを付けた登録
質問時は、権限条件を適用したあとに、検索結果をLLMや画面へ渡します。Milvusを入れるだけでは、回答精度が上がるとは限りません。一方で、元文書の品質やチャンク分割などを一体で整えると、精度は高まります。
Milvus Lite・Standalone・Distributedの使い分け
方式の候補は、検証から大規模本番まで、Milvusの利用段階によって変わります。
- Milvus Lite:検証や学習、小規模なベクトル検索向け
- Milvus Standalone:単一マシンで早く本番化したい場合
- Milvus Distributed:高可用性や水平スケールが重要な大規模本番向け
公式資料ではDistributedはKubernetes上で数億から数百億規模を扱う方式です(出典:Milvus公式ドキュメント、2026年)。
Liteと他の方式はAPIを共通化しやすいため、検証後に段階的に移行できます。
方式を決める際は、ベクトル数だけでなく、追加件数や同時検索数を見ます。加えて、許容レイテンシや復旧時間、運用担当者の有無も判断材料になります。
閉域網やデータ保管地域の条件も、方式を選ぶ前に確認します。文書数が少なくても、厳格な部署別の権限や、停止できない窓口があると要件は増えます。さらに、監視、バックアップ、冗長化の要件が先に膨らむこともあります。
Milvusのシステム開発の進め方・流れ
開発は6つのフェーズに分けて進めると、PoCから業務利用へつながります。各工程の成果物と合否基準は、先に決めておきます。
- 業務課題とデータを整理する
- デプロイ方式と検索方式を選ぶ
- 検索品質と権限を組み込んで設計・開発する
- 精度・性能・安全性をテストする
- 段階リリースして稼働する
- 現場の改善と再評価を続ける
完了は、検索や回答が動くことだけでなく、正しい文書を権限どおりに返し、現場の時間を削減できたことを確かめた時点です。
1. 要件整理:業務課題とデータの決定
要件は、Milvusを使うことではなく、改善したい業務から決めます。具体化する項目は、業務目標、検索データ、評価と権限に分けて整理します。
- 業務目標:利用者、対象業務、現状時間、目標値
- 検索データ:対象の形式、更新頻度、原本の保管場所
- 評価と権限:閲覧範囲、正解質問、検索禁止文書
目標の例には、問い合わせの一次回答を30分から10分へ短縮することや、設計書を探す時間を月20時間削減することがあります。
商品候補の閲覧から問い合わせへの転換率を改善する例もあります。
Beekleの公開情報は、モデル選定の前に業務フローや判断基準を整理する考え方を示しています。
例外処理や現場の制約を確認したうえで、動く試作品によって効果を測ります。
正解質問は、最低でも数十問程度を用意します。
権限マスタや文書IDなどが足りない場合は、技術選定より先にデータを整備します。
2. 選定:デプロイ方式と検索方式の比較
要件をもとに、Milvusの各方式やZilliz Cloudなどを比較します。
小規模な検証ではLiteやクラウドの試用で実データを評価し、単一サーバーで運用できる規模ならStandaloneも候補にします。
冗長化や検索・取り込みノードの分離が必要ならDistributedを検討します。加えて、Kubernetesを既に運用しているかも確認します。
人材が不足する場合は、マネージドサービスの支援範囲と自己運用の作業を比べます。
検索方式はMilvusだけに固定せず、組み合わせも含めて比べます。方式ごとに得意な検索対象が異なるためです。
- ベクトル検索:意味の近さを探す
- 全文検索:固有名詞や型番を拾う
- RDB検索:条件を厳密に絞る
これらを組み合わせれば、日本語検索で起きやすい表記揺れや数字の取りこぼしを減らせます。
比較対象には、pgvectorやElasticsearchがあります。
OpenSearchやPinecone、Weaviateも含まれます。
既存技術と運用スキルを評価します。そのうえで、データ主権やロックイン、契約条件も確かめます。
選定の成果物には、候補ごとの採用理由と不採用理由を記載します。
3. 設計・開発:検索品質と権限の組み込み
設計では、検索処理と安全性を一体で考えます。検索の品質と権限も、この段階で組み込みます。決めておく内容は、次の3つに分けられます。
- 構成とデータ:文書保管庫、ETL、チャンク、Embedding、Milvus、API、再ランキング、LLM、画面、監査ログの役割
- 検索品質:元文書とメタデータを別保持し、文書種別ごとにチャンク長・重複幅を正解質問で比較
- 権限と保護:閲覧条件、認証、RBAC、暗号化、秘密情報、削除対象、ログ保管期間
元文書を別に持つと、Embeddingモデルを変更したときに再計算できます。
チャンク長やオーバーラップは、規程、表、議事録、図面ごとに候補を作ります。
閲覧条件には、部署、役職、顧客、案件などを使います。
検索APIには、認証済みユーザーの条件を必ず付与します。
Milvus公式資料のRBACは、ユーザーとロールを作り、権限をロールへ付与する仕組みです。アプリ側の認可と合わせて、多層で検証します。
通信はTLSで保護し、保存先の暗号化と秘密情報の管理も設計します。
削除対象とログ保管期間は、設計書と見積書に含めます。
4. テスト:精度・性能・安全性の測定
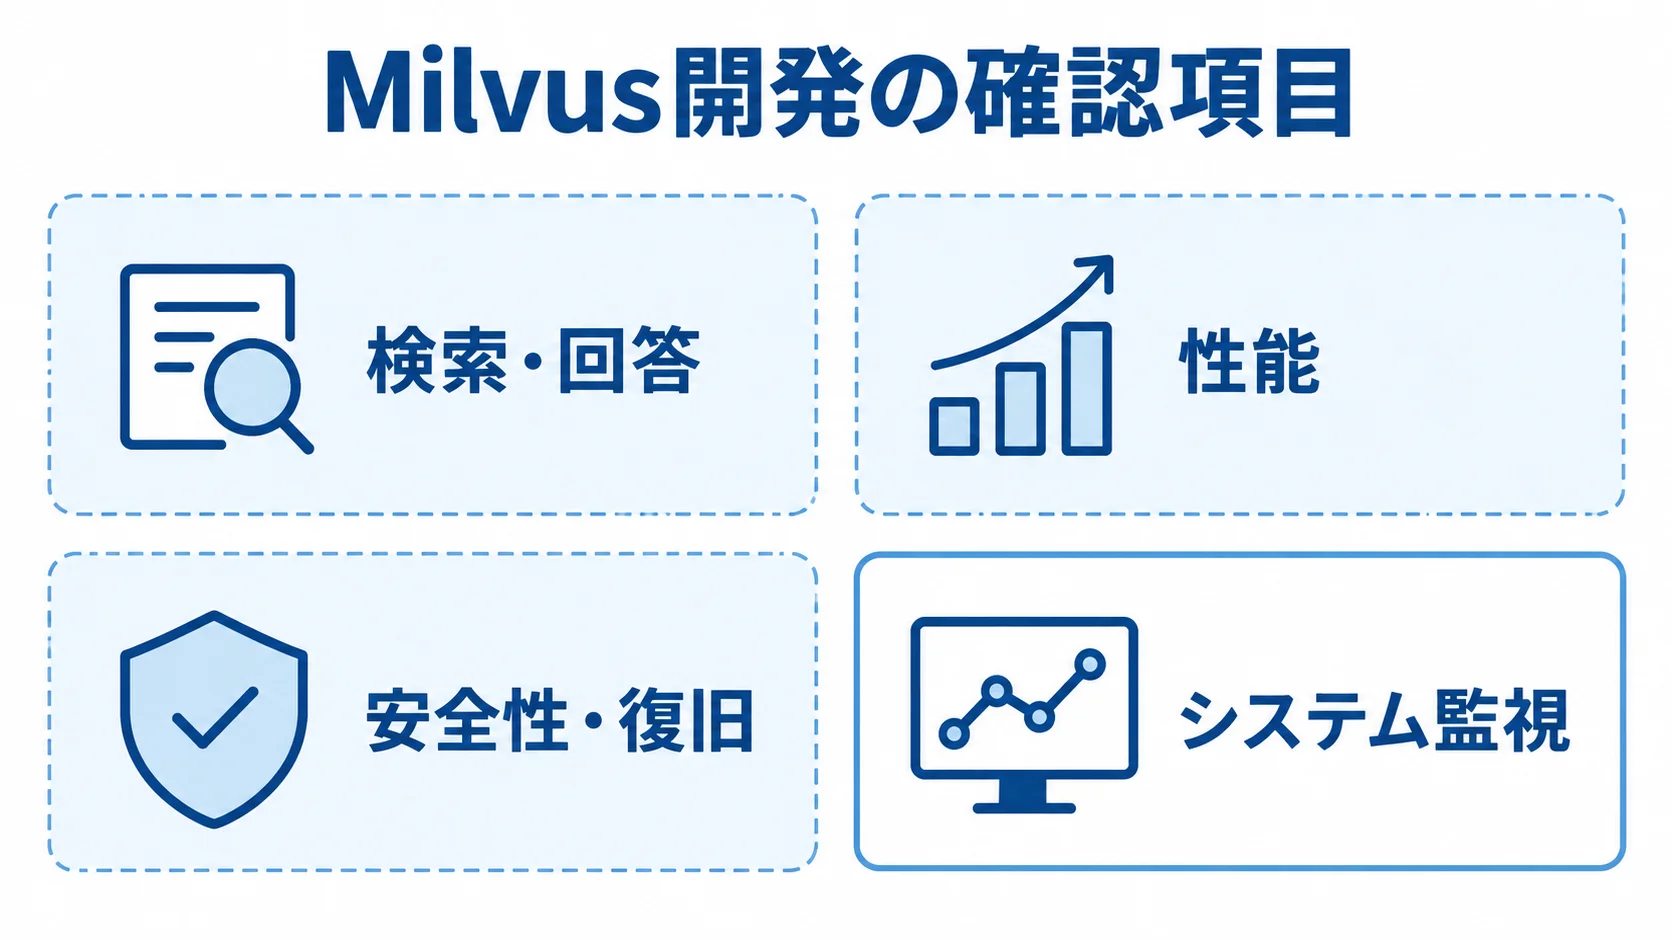
試験は画面だけにとどめず、検索から障害復旧まで分けて行います。合否を測る観点は、あらかじめそろえておきます。
- 検索・回答:正解文書の順位、不要文書、引用妥当性、根拠のない回答の抑止
- 性能:同時検索数、P95・P99、取り込み件数、索引構築時間、増分更新遅延
- 安全性・復旧:誤ったテナントへの検索結果、削除反映、指定したRTO・RPOでの復元
回答品質には、正解例、NG例、情報不足で回答できない例を使います。そのうえで、根拠のない回答を抑止できるかを確かめます。
削除した文書が、ベクトルやキャッシュに残らないことも試します。
走査データ量と返却フィールドは、MilvusやZilliz Cloudの料金に影響します。そのため、負荷試験の結果を月額予算に反映します。
5. 稼働:段階リリースと監視の開始
本番稼働は、部署や文書を限定して始めます。段階リリースと運用で確認する項目も、あわせて決めます。
- 段階リリース:回答を直結させず、参照元と検索スコアを担当者が確認する運用
- 利用状況:問い合わせ数、回答時間、再検索率、修正率、誤回答報告の週次での把握
- システム監視:APIエラー、P95、メモリ・ディスク、索引、取り込み、API費用、権限エラー
目標値を満たした機能から、利用範囲を広げます。
バックアップに加えて、復元訓練の頻度と担当者を決めます。
検索が止まったときに元文書を閲覧する代替手段と、LLMが止まったときの業務手順を用意します。こうした備えにより、システムへの過度な依存を防げます。
6. 定着:現場の改善と再評価の継続
利用者が正しく使えるようにし、回答の誤りや不足を改善へ戻す仕組みを整えます。定着後も、更新は続けます。
- 業務手順:参照文書、回答を採用できる条件、相談先を明記
- 改善管理:現場の意見をチャンク、メタデータ、Embedding、検索条件、プロンプトのどこに反映したかの追跡
- 定期見直し:古い文書の公開終了、権限・モデル変更、精度再測定、KPI確認
文書の更新や組織の変更が続く限り、システムは完成しません。
KPIは、月次または四半期ごとに見直します。
AiSAQ技術は2025年12月、Milvus 2.6.4以降へ統合されたと発表されました。
DRAM使用量を抑えた大規模検索の選択肢です(出典:KIOXIA発表、2025年)。
新機能は、自社データで費用、精度、復旧性を確かめたうえで採用します。
Milvusのシステム開発費用相場とコストの内訳
Milvusの費用は、OSSのライセンス料だけでは判断できません。アプリ開発やデータ整備、Embedding・LLMなどの項目に分けて考えます。
次に示す金額は、Milvus公式の見積もりではなく、公開RAG開発費用やクラウド料金、類似システムの構成から整理した目安です。要件やデータ規模で変わるため、提案時は内訳を確認します。
開発費の目安
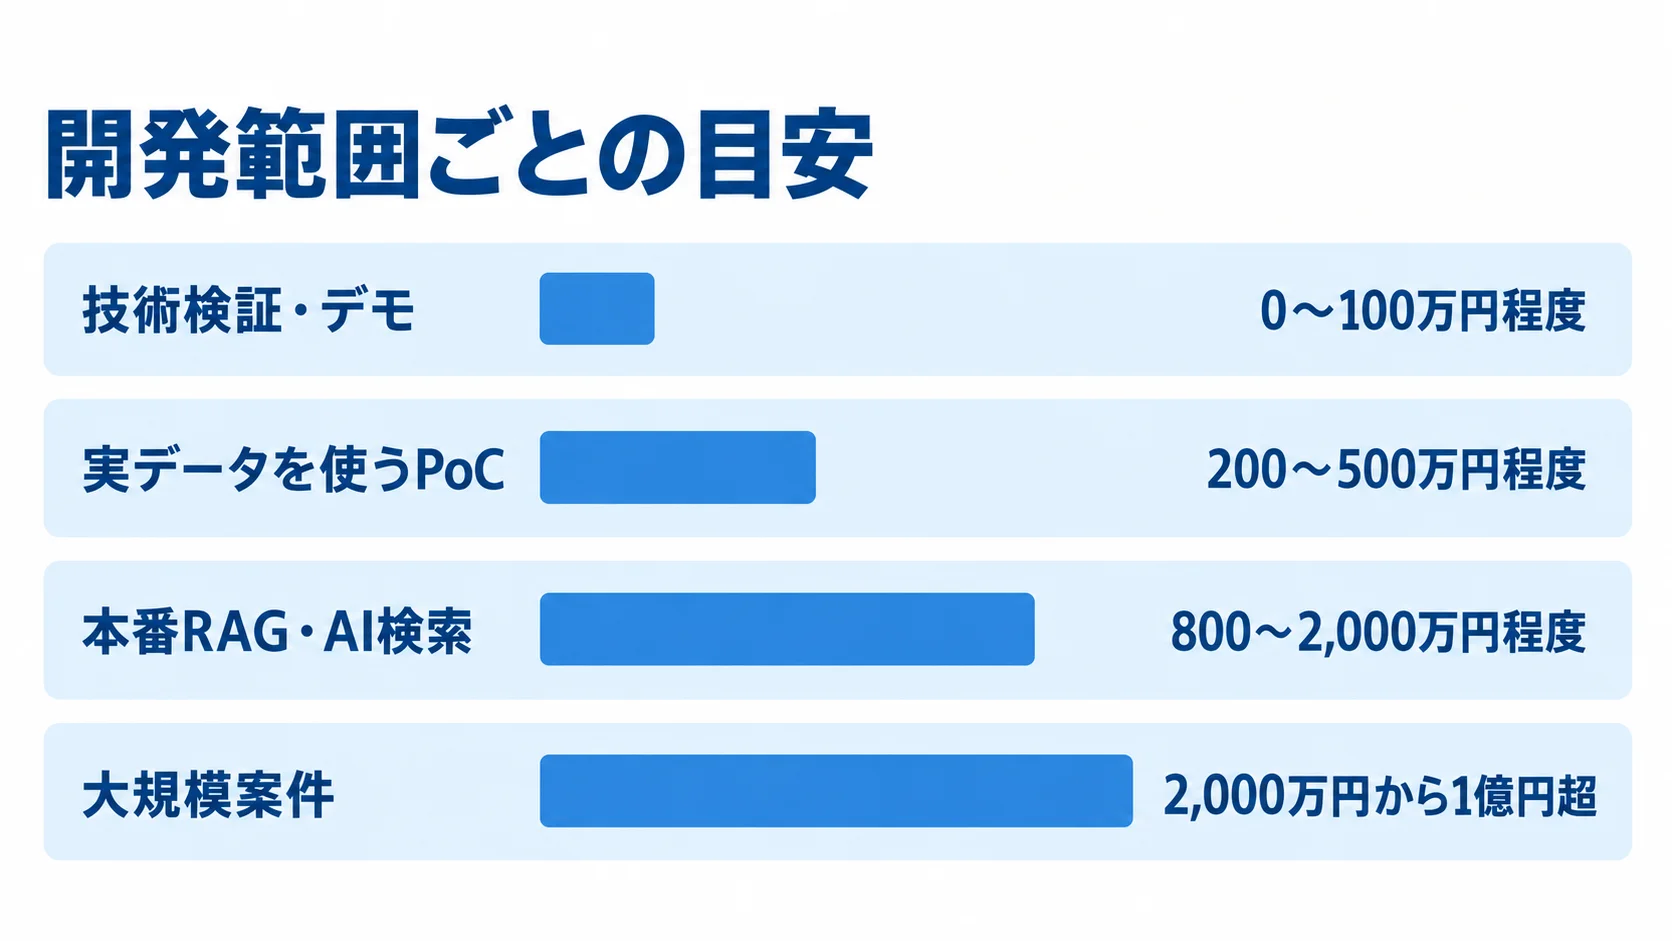
開発範囲ごとの目安は次のとおりです。検証内容と本番要件で費用が変わります。
- 技術検証・デモ:0〜100万円程度、2〜6週間
- 実データを使うPoC:200〜500万円程度
- 本番RAG・AI検索:800〜2,000万円程度
- 大規模案件:2,000万円から1億円超まで幅がある
検証・デモは、公開文書を数百〜数千件取り込み、Liteまたは小規模なStandaloneで検索と回答を試す想定です。
OSSや無料枠を使っても、データ整備やEmbedding、評価質問、画面の試作には人件費がかかります。
Beekleは、複数ケースを含む本格PoCを200〜500万円、本格RAG構築やAIエージェント本番化を800〜2,000万円と案内しています(出典:Beekle公開情報、2026年)。
認証や複数部署の権限、負荷試験などを含めると、費用が上限を超える可能性があります。
大規模案件では、数千万から数十億ベクトル、複数テナント、Kubernetes分散クラスタなどを想定します。
厳格な監査やDRがある場合の金額は、Milvusの定価ではなく、類似する高可用性基盤からの推定です。
基幹システム刷新、データ移行、医療・金融向け審査が加わる場合は、工程と体制を分けて見積もります。
クラウド・Embedding・運用費の考え方
運用費は、自己運用か従量課金かで変わります。内訳は次の4つに分けて見ます。
- 自己運用:Kubernetes・仮想マシン、SSD、オブジェクトストレージ、メタデータストア、監視、バックアップ、障害対応
- 書き込み:Zilliz Cloud Serverlessは従量制で、100万vCUあたり4ドル。1,536次元ベクトル100万件は約6ドル
- 読み取り:1,536次元・対象100万件を100万回読むと約100ドル。同次元で1,000万件は約300ドル、1億件は約1,160ドル
- 追加費:Embedding・LLM、ストレージ、転送、監査ログ、保守範囲
Zilliz Cloudの読み取り額は、検索回数や走査量、返却フィールドなどで変わり、固定月額ではありません(出典:Zilliz Cloud公式、2026年)。
全ベクトル走査では、データが増えるに従って読取費も膨らむ傾向があります。そのため、パーティションキーやフィルタ、返却項目の絞り込みを検討します。
月次予算は、1ユーザー1日あたりの質問数と、1質問あたりのトークン数から試算します。
保守費は、障害対応、アップデート、脆弱性対応、復元、検索品質改善の範囲で変わります。初期開発費の15〜20%は、年間保守費の仮置きにできます。ただし、個別案件の確定額ではありません。
マネージドサービスの支援料とクラウド監視費が重複していないか、契約書で確認します。
Milvusのシステム開発で見積もりを取るポイント
合計額だけでなく、前提条件と納品物をそろえて比べます。データ整理や権限設計などが別契約になると、総額が変わります。
提案依頼書には、対象業務、利用者、データ量を記載します。あわせて、更新頻度と目標精度、P95を書きます。さらに、RTO・RPO、安全要件、将来拡張も含めます。
要件と前提条件の明確化
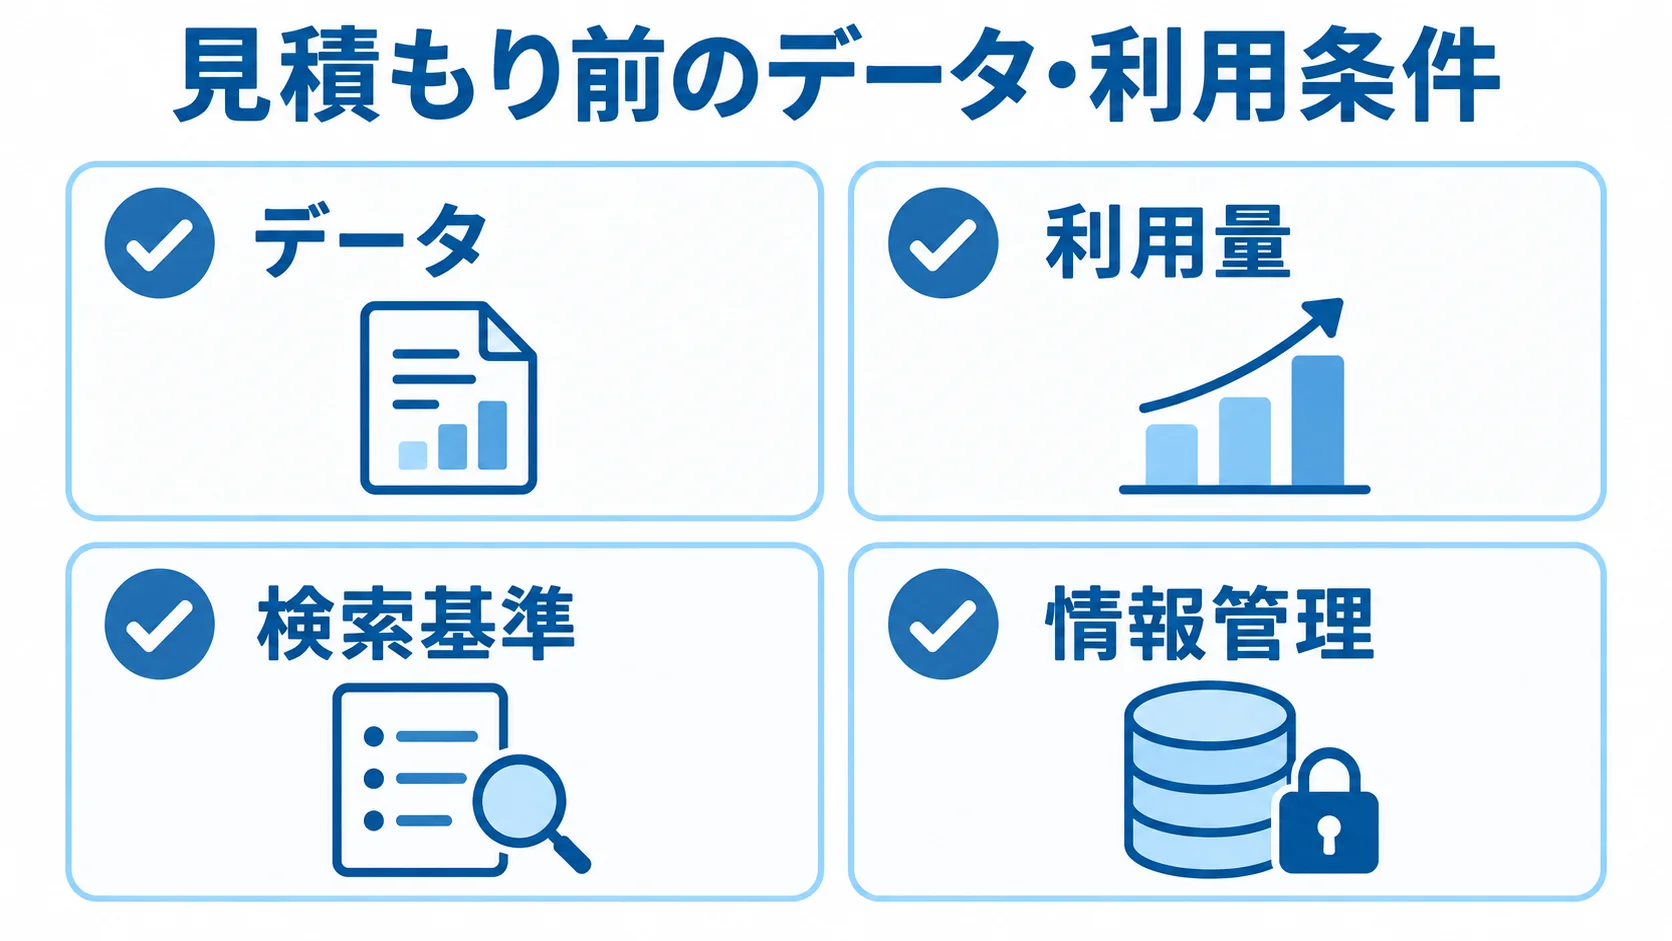
見積もり前に、提示するデータと利用条件を整理します。個人情報や機密情報があれば、保管条件も指定します。
- データ:形式、文書数、平均チャンク数、ベクトル次元
- 利用量:日次の追加・削除件数、同時利用者数、ピーク時間
- 検索基準:検索上位件数と、測定可能な精度指標
- 情報管理:保管地域、暗号化、委託先、ログ、保存期限、削除対応
検索精度は「高精度」と書くだけでなく、正解質問の上位何件以内の命中率や、回答根拠の提示率で定義します。
納品物に、要件定義書や構成図、データスキーマなどが含まれるかを確認します。チャンクやEmbeddingの設定、IaC、ソースコードも対象です。
評価データや試験結果、運用手順などを確認します。バックアップ・復元手順や教育資料も対象です。
評価質問と正解文書がないと、品質を再現しにくくなります。さらに、別の会社へ移る際の比較も難しくなります。
開発会社の実績と体制の比較
Milvusの経験年数に加えて、業務課題を整理し検索品質を測った実績を見ます。相談先の役割も確認します。
- 製品ベンダー:Milvus製品の技術知見
- RAG受託会社:検索やAIエージェントの開発
- SIer:既存業務システムとの接続
- 基盤会社:Kubernetesや閉域網の構築・運用
Zillizは、MilvusとZilliz Cloudの知見を公開しています。Beekleは、Milvusを含むRAGやAIエージェントの受託事例を公開しています。
ただし、業務アプリ全体の担当者は別途確認します。要件整理から定着まで、同じ担当者が続くかも質問します。
データ整理の担当者や、業務部門のレビュー回数を確認します。加えて、再委託の有無と障害窓口、モデルやクラウドの変更可否も尋ねます。
過去事例では、データ量と検索数、達成指標を聞きます。あわせて、運用期間や失敗と改善策も確認します。
2〜3社から同じ前提で見積もりを取り、安さだけでなく品質の検証計画と納品範囲を比べます。
追加費用になりやすいリスク
想定外のデータや運用条件があると作業が増えるため、追加費用の要因は契約前に確認します。
- データ処理:文書種類の増加、PDFや表の抽出難
- 管理情報:不完全な権限マスタ、古い文書の削除ルール不足
- 評価・負荷:正解質問の不足、同時アクセスの増加
契約前に、サンプルデータで抽出品質とチャンク数を確かめます。あわせて、Embedding費用と検索速度も見ます。
未確定の作業は、「別途」とだけ書かず、作業単位と判定条件、追加時の単価または上限を記載します。
PoCの成功条件と本番移行の条件は、分けて設定します。PoCでは精度と利用価値を判断します。
本番では、可用性や監査、バックアップに合格することを求めます。加えて、削除と運用引き継ぎまで確かめます。
過剰なカスタマイズや大規模クラスタは、使われない高額な仕組みを生んだり、ロックインを招いたりする可能性があります。
工程ごとに成果物と中止の判断基準を置きます。目標に届かない場合は、方式や対象業務を見直せる契約にします。
Milvusのシステム開発でよくある質問
費用や構成は、データ量と業務要件によって変わります。導入前に押さえたい判断軸を、質問ごとに見ていきます。
Milvusは無料で業務システムに使えますか?
Milvus OSSにライセンス料がなくても、業務システム全体が無料になるわけではありません。
サーバーやストレージ、監視などの基盤に加え、Embedding、LLM、開発・保守にも費用がかかります。
まずLiteやクラウドの無料枠で検証し、本番の利用量と運用体制を踏まえて総額を見積もります。
ベクトルDBを入れればRAGの回答精度は上がりますか?
ベクトルDBを導入するだけでは、精度は保証されません。複数の設計要素と評価データが結果を左右します。
- 検索前後の処理:文書抽出、チャンク分割、メタデータフィルタ
- 検索・生成:Embedding、ハイブリッド検索、再ランキング、LLMの指示
- 評価:正解質問など評価データの品質
日本語の固有名詞や型番には全文検索を併用します。そのうえで、正解質問を使い、検索結果と回答を別々に測定します。
顧客情報や社内機密をMilvusに保存しても安全ですか?
安全性は、製品名だけでなく、保存の仕方と運用の決め方で変わります。確認する要素は、技術対策、個人情報の扱い、運用条件の3つです。
- 技術対策:保存場所、暗号化、認証、RBAC、アプリ認可、監査ログ、バックアップ、削除手順
- 個人情報:元文書やIDと照合できる場合の個人情報としての扱い、目的と委託先の確認
- 運用条件:保存期限と削除対象の決定、リスク評価と発注条件への反映
ベクトル化しても、匿名になるとは限りません。
経済産業省などは2026年3月31日にAI事業者ガイドライン第1.2版を公開しました。
設計段階では、安全性やデータアクセス管理を確認します。監査と説明可能性も、同じ段階で見ます(出典:経済産業省・IPA・AISI、2026年)。
Milvusのシステム開発にはどのくらいの期間が必要ですか?
期間の目安は、開発段階ごとに異なります。複数部署の権限や基幹連携などで延びる場合があります。
- 簡易デモ:2〜6週間
- 実データを使うPoC:1〜3か月
- 本番RAG・AI検索:3〜6か月
- 複雑な本番計画:条件により6〜18か月程度
延びる要因には、数千万以上のベクトルや高可用性があります。移行や監査が加わる場合も、延長の要因になります。
短縮するには、対象業務とデータを絞り、質問と受け入れ基準を先に用意することが役立ちます。
まとめ
Milvusのシステム開発は、ベクトルDBを設置して終わるものではありません。業務課題とデータを整理し、方式や品質、権限を検証します。そのうえで、性能や復旧、費用を確かめて本番へ進みます。
OSSのライセンス料とは別に、費用を分けて見積もります。アプリ開発やデータ整備、Embedding・LLMなどが対象です。
6フェーズで確認するチェックポイント
各フェーズで決める内容と、次の工程へ進む条件をそろえて確認します。
- 要件整理:KPI、利用者、データ、権限、正解質問の決定
- 選定:更新量、P95、可用性、運用人材、データ主権の比較
- 設計・開発:元データを正本とし、検索構成と監査を分けて設計
- テスト:検索、回答、性能、権限、削除、バックアップの測定
- 稼働・定着:段階リリースと監視、KPIと意見の更新
設計・開発では、チャンクやEmbeddingなどの検索の要素と、監査を分けて設計します。これにより、変更や再評価の対象を追いやすくなります。
最初の準備物
開発会社へ相談する前に、検証に使う情報と判断条件をそろえます。
- 準備物:改善業務1つ、実データ、閲覧権限一覧、正解質問、目標時間・精度
- 相談事項:検証範囲、本番化条件、Milvus採用理由、不採用時との比較
判断材料を段階ごとにそろえることで、過剰な開発や追加費用を抑え、現場で使われるAI検索へ近づけます。
▼全体ガイドの記事
・Milvusのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。