
MLflowの発注は、現状整理、要件定義とPoC、本番構築、テスト、運用引き継ぎの順に進めると、モデルを業務で継続利用できる形になります。発注形態や要件、契約、費用相場、委託先選びは、この流れのなかで順に決めていくものです。
▼全体ガイドの記事
・MLflowのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLflowのシステムを外注する前に知る全体像
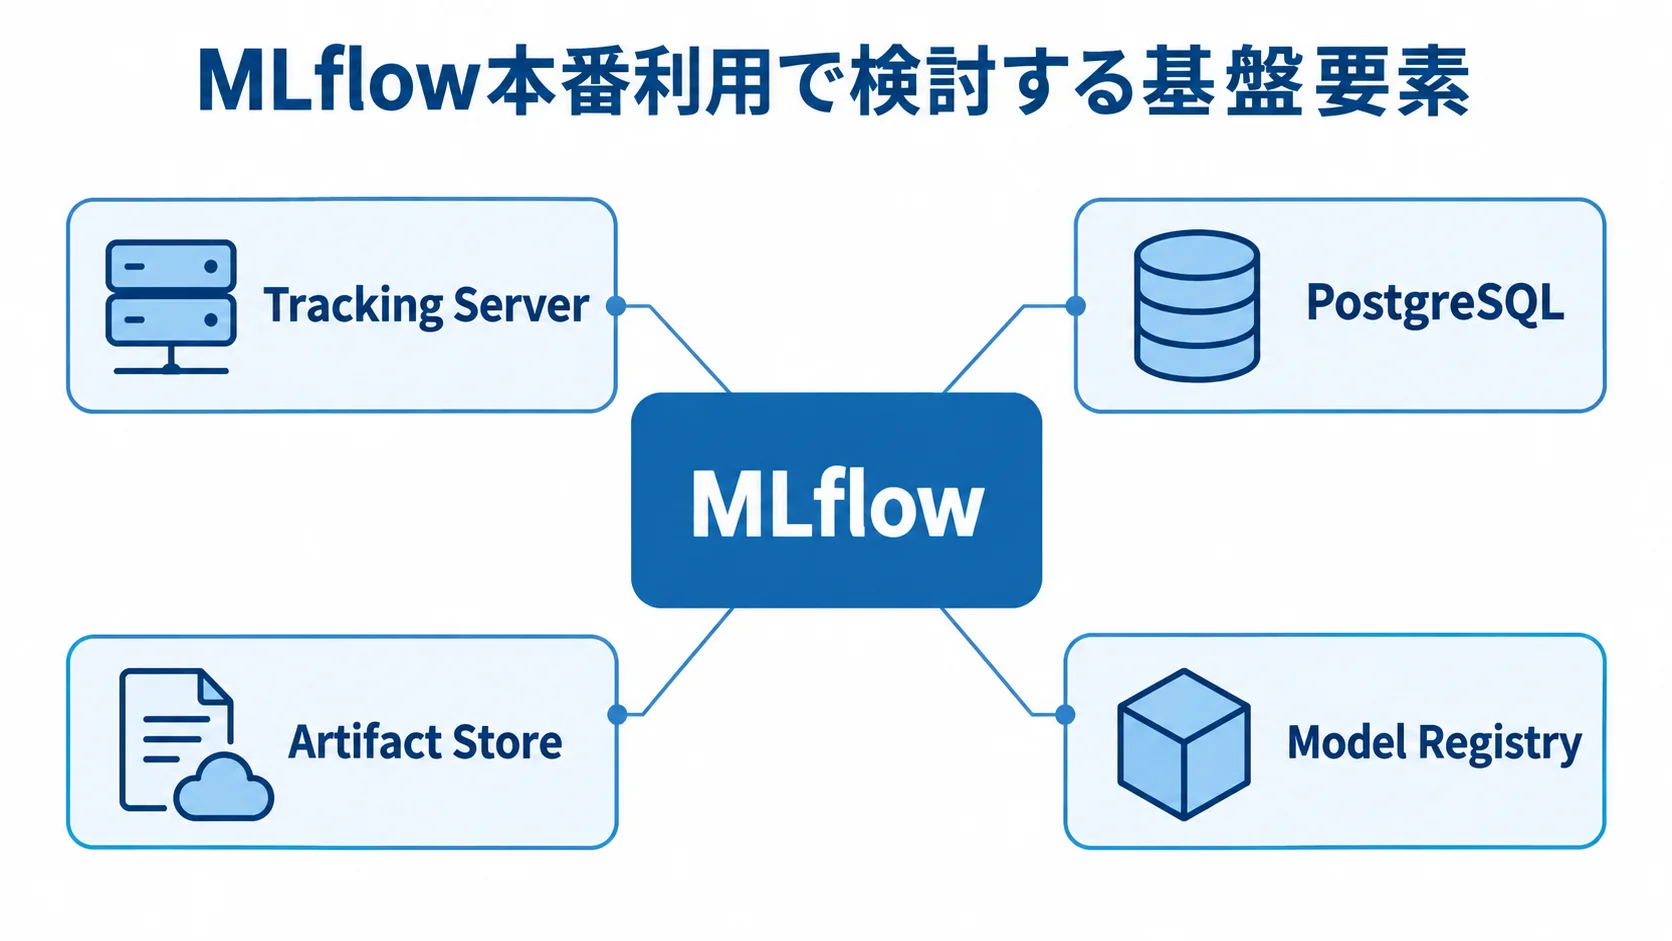
MLflowは、機械学習モデルやLLMアプリを継続して開発・評価・デプロイするためのOSS基盤です。需要予測、異常検知、レコメンド、審査、生成AIを業務で使うための共通管理システムと捉えると、外注の範囲を整理しやすくなります。
インストールだけでは完成しないMLflowの構成
最小構成であれば、学習コードから実験のパラメータ、評価指標、モデル、成果物を記録し、画面で比較できます。一方、複数チームで本番利用するなら、MLflow Tracking Serverが必要です。
メタデータを保存するバックエンドには、PostgreSQLなどがあります。一方、モデルや画像はArtifact Storeに保存します。Artifact Storeには、S3・GCS・Azure Blobなどがあります。加えて、Model Registry、CI/CD、認証、監視、バックアップも検討します。
- 実験管理:パラメータや評価指標を記録し、画面で比較します。
- 本番反映:承認済みモデルを推論へ反映します。
- 復旧:障害時に前のモデルへ戻す手順を整えます。
「MLflowの構築一式」とだけ発注すると、どこまでが成果物なのか分かりにくくなります。各状態で設計、テスト、運用手順が異なるため、状態ごとに範囲を分けて示すことが大切です。
外注の目的はAI開発を本番で回せる状態づくり
導入の目的は、ツールを足すことよりも、学習条件を再現し、業務部門が承認したモデルを安全に使えるようにすることです。そのために、Notebook上のモデルで使ったデータ、コード、環境、パラメータを記録しておきます。
- 比較:実験結果を比べられない課題の解消
- 説明:本番モデルの由来を説明できる状態
- 検知:更新後の精度低下に気付ける状態
- 復旧:推論APIの障害時に戻せる状態
成果指標は、精度だけでなく、たとえば再学習時間や承認からリリースまでの日数、障害復旧時間などで決めておきます。
MLflowの発注形態の選び方
発注形態は、セルフホスト、マネージドサービス、既存基盤と組み合わせるハイブリッド型に分けられます。選ぶ際は、セキュリティ、内製人材、既存クラウド、必要な運用レベルを踏まえて、製品名より運用の負担を比べます。
OSSのセルフホスト型の自由度と運用責任
DockerやKubernetesを使えば、ライセンス費を抑えつつ、クラウドや社内ネットワークに合わせて設計できます。自社の認証基盤やArtifact Store、既存のCI/CDにも組み込みやすい一方、更新やバックアップは自社側の責任になります。
- 更新と保護:MLflowの更新、証明書、脆弱性への対応
- 継続運用:DBのバックアップと障害復旧を担う
公式ドキュメントは、本番のTracking Serverに対して、リバースプロキシやVPNを使ったTLS・HTTPS、認証、許可ホスト、CORSを推奨しています。
MLflow 3.5.0以降にはDNSリバインディングやCORSに関する機能もあります。ただし、ネットワークと権限の設計は別途必要です(出典:MLflow公式Tracking Serverドキュメント、2026年8月確認)。
マネージド型の始めやすさと対応範囲
Amazon SageMaker AI、Azure Machine Learning、Databricksでは、サーバー構築や一部の更新を減らせます。AWSは2025年12月、容量計画なしで自動スケールするサーバーレスMLflow Appを案内し、追加料金なしと説明しました。
サービス制限、対象リージョン、Artifactの保管、学習・推論費、既存環境からの移行は、別途確認が必要です(出典:AWS News Blog、2025年12月)。
- Azureの互換範囲:SDKとCLI、Studioで対応する操作が異なる
- 移行方針:採用するAPIと移行時期をRFPに記載する
Azure Machine Learningでは、MLflow互換ワークスペースで実験、指標、モデル、成果物を追跡できます。
MLprojectファイルのサポートは2026年9月に完全終了する予定とされています(出典:Microsoft Learn、2025年10月更新)。
ハイブリッド型の既存資産と責任分界
既存のKubernetesや社内認証を残しつつ、TrackingとRegistryを共通化できます。また、Artifactは専用のクラウドストレージ、推論は既存のAPI基盤、学習はデータ分析基盤で実行できます。初期投資を生かせる反面、ネットワーク、ストレージ、モデル、パイプラインの保守会社を決めておかないと、障害対応が止まってしまいます。
MLflowの発注・外注の進め方
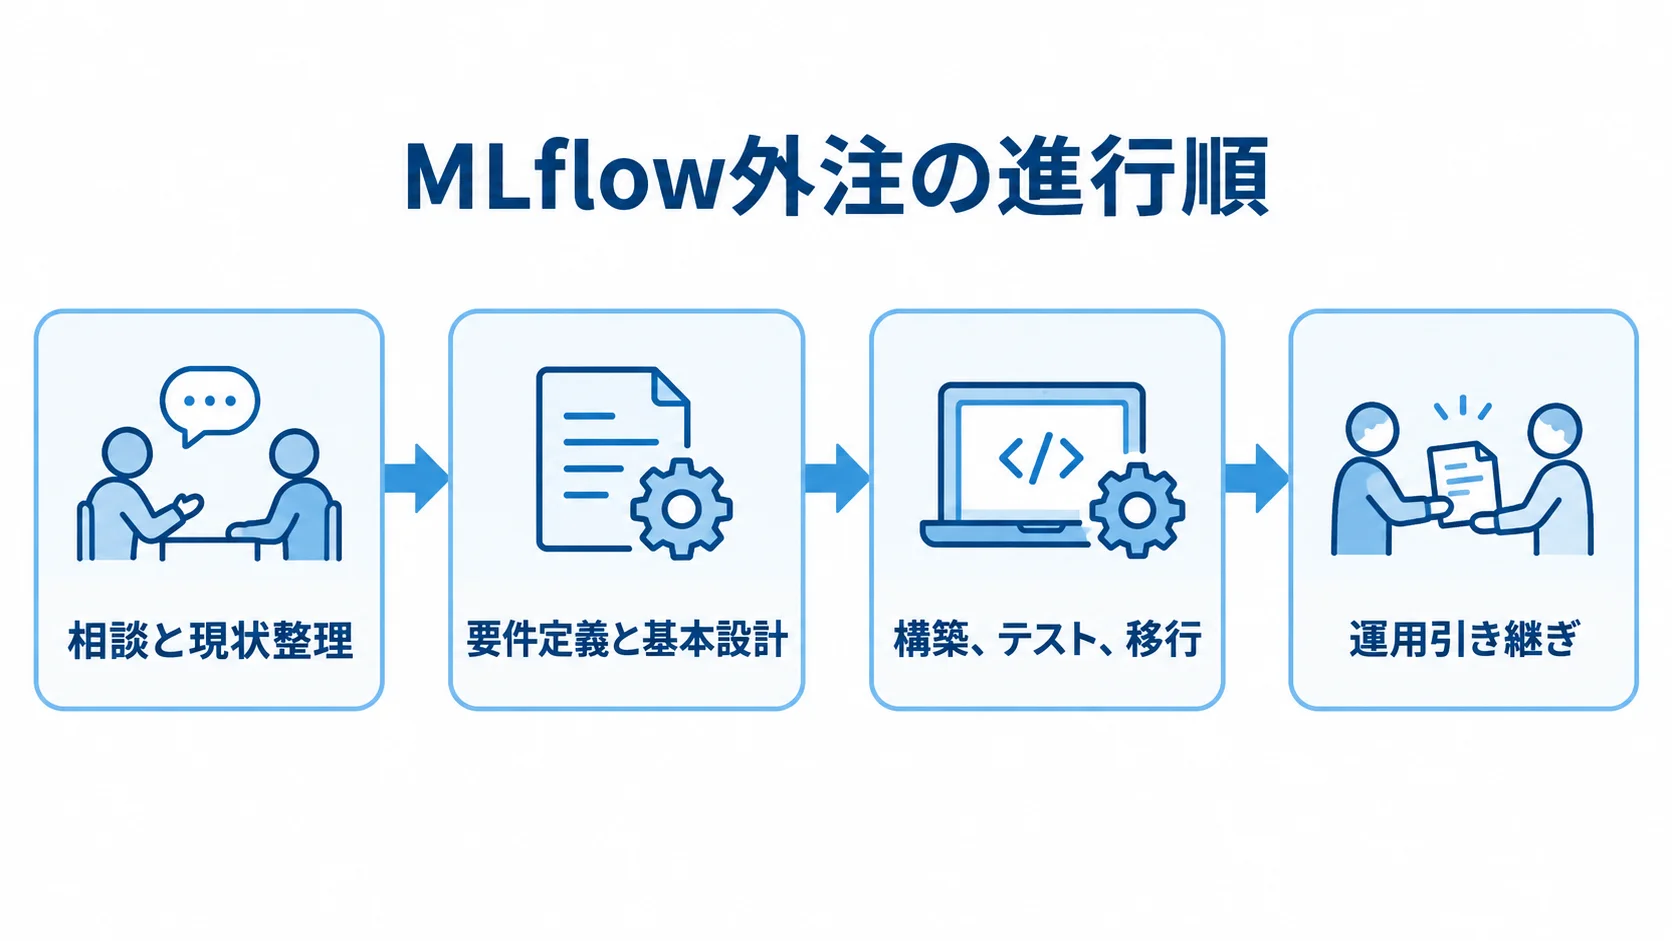
発注から運用引き継ぎまでは、次の順で進めます。
- 相談と現状整理
- 要件定義と基本設計
- 構築、テスト、移行
- 運用引き継ぎ
モデル開発と共通基盤の開発を一度に混ぜると、納期と責任が曖昧になりがちです。そのため、最初はユースケースを1つか2つに絞り、拡張の条件は別に定めます。
最初に行う現状の開発と運用のヒアリング
初回の打ち合わせでは、Notebookや学習スクリプト、Gitの管理状況を確認します。あわせて、データ保存先、モデル配布、推論サービスの扱いを聞いておきます。承認者や、誰がどの頻度でどのデータや指標を使うかも確認しておきます。
- 準備資料:学習コード、モデル形式、データ量を用意しておく
- 利用状況:月間の学習回数とピーク時の推論数を示す
- 未確定事項:分からない項目は、未確定と明記しておく
未確定のまま見積もる項目を一覧にしておくと、後から費用が増えるリスクを抑えられます。
PoCによる価値の確認と本番化の条件
全社の基盤を先に作るよりも、1つの業務課題に絞ってTracking、Registry、評価、推論を試すほうが、発注の判断をしやすくなります。
PoCの完了条件は、同じコードとデータで結果を再現できること、承認者が決まっていること、業務担当者が推論結果を確認できることです。画面が動いただけでは、まだ十分ではありません。
- 精度と応答:目標精度と業務上の応答時間
- 復旧とログ:ロールバックの方法と、個人情報ログの扱い
PoCの設定が、そのまま本番で使えるとは限りません。そのため、本番化の追加作業と費用は、分けて見積もってもらいます。
受け入れテストと引き継ぎの発注範囲
受け入れテストでは、学習記録、モデル登録、承認版のデプロイ、推論を実際に動かして確認します。あわせて、監視アラート、権限拒否、バックアップ復元も確かめます。精度だけでなく、業務が止まらないかも見ます。
- 技術資料:ソース、IaC、環境変数、依存ライブラリを受け取る
- 運用資料:保持ルール、連絡先、リリースと復旧の手順を含める
受け入れ条件には、操作研修と、委託先が関わらなくなった後に自社で更新できる範囲も含めて記録しておきます。
MLflowのRFPと要件整理で決めること
RFPは、発注先が同じ前提で提案と見積もりを出せるようにするための資料です。そのため、用語を並べるよりも、前提をそろえることを重視します。
まず目的、対象業務、現状構成を整理します。あわせて、利用データや必要処理、非機能要件、想定ユーザーも書き出します。
納品物、期限、予算の考え方を分けて書くと、会社ごとの違いが見えます。
モデルのライフサイクルに沿った機能要件
要件には、実験の記録と検索を含めます。記録の中心はパラメータと指標で、データセットやコード版も残します。
さらに、モデルやプロンプトの登録と承認を整理します。推論はバッチとリアルタイムの両方を対象にし、再学習と評価比較も含めます。
- LLMの追跡:入力・出力・プロンプト・モデル・ツール呼び出しを記録する
- LLMの評価:品質・コスト・レイテンシーを評価の対象にする
MLflow 3では、LLMやエージェントのトレースと評価が強化されました。2026年2月のMLflow 3.10.0では、マルチワークスペース、複数ターン評価、トレースのコスト追跡が案内されました。
利用する場合は、OSS版、マネージド版、クラウド側のどれで対応するかを指定し、必須機能と将来機能を分けて書きます(出典:MLflow公式リリースノート、2026年2月・8月確認)。
非機能要件の数値化(可用性・性能・セキュリティ)
可用性は、Tracking Serverや推論APIの稼働時間と許容停止時間で示します。復旧目標時間とバックアップ頻度も、あわせて決めておきます。
性能は、同時利用者数や1日あたりの実験数で示します。Artifact容量の増加、推論の平均・最大応答時間、バッチの締切時刻も、数値で決めておきます。数値の条件がないと、小規模な検証環境を前提に見積もられ、本番化の際に構成が変わることがあります。
- アクセス制御:SSO・RBACと、開発・検証・本番の分離
- データ保護:Artifactへのアクセス経路・Secret Manager・監査ログ・保持期限・個人情報の扱い
Artifactへのアクセスを、Tracking Serverが代理する方式にするか、クライアントが直接アクセスする方式にするかで、認証情報と権限の設計が変わります。
RFPに書き分ける成果物と見積条件
成果物は、要件定義書・構成図・詳細設計から、リポジトリ・コンテナ・IaC・CI/CD定義まで分けて書きます。テスト仕様と運用設計に加えて、監視や教育資料も含めます。バックアップと復元の手順も、このなかに入れます。
- 移行条件:移行対象と欠損時の扱い、照合、切り戻しの条件
- 見積前提:クラウドやリージョン、版、チーム数、環境数
- 未確定項目:質問と仮定、追加費用の条件を分けて記載
データ量やモデル数、連携システム、テストデータを用意する担当者も、見積条件に含めます。
MLflow開発の契約形態と役割分担
要件が固まっている部分と、PoCで検証しながら決める部分は混在します。そのため、要件定義、PoC、本番構築、運用保守を分けて契約すると、変更の影響を管理しやすくなります。
フェーズごとの準委任と請負の使い分け
要件定義や技術検証は成果を固定しにくいため、作業時間と体制を定める準委任が適しています。モデル候補やクラウド構成を比べ、実験結果から次の設計を決める場面でも、準委任を使いやすくなります。
- 準委任:要件定義や技術検証など、結果が未確定の工程に充てる
- 請負:構築、認証、CI/CD、テスト仕様書などを対象に検討できる
請負では、成果物と受け入れ条件を定めます。ただし、AIの精度や業務効果は保証の対象にしにくいため、精度目標、評価データ、責任範囲を分けて記載します。
契約書に入れる知的財産権とOSSの扱い
MLflowはApache 2.0のOSSで、ライセンス料は原則かかりません。ただし、委託先が作る設定、プラグイン、認証プロキシの権利と利用範囲は、別に定めます。パイプライン、IaC、運用資料も、契約で扱いを決めておきます。
MLflowそのものを改造する場合は、改造部分の保守とバージョンアップの方法も確かめておきます。
- 成果物の帰属:コード・モデル・データ・ログ・プロンプトの扱い
- 契約終了:データの返却と削除、秘密保持の取り決め
- 第三者利用:再委託、ライブラリ、クラウド機能の条件
脆弱性が見つかった場合の対応期限も、納品時ではなく契約前に決めておきます。
保守運用の分界点とSLA
問題はMLflowの障害だけでなく、データ連携や学習の停止、Artifactの増加、推論の遅延でも起きます。精度低下やクラウド料金の急増は複数の担当者にまたがるため、一次窓口と切り分けの手順を決めておきます。
- 運用分担:Tracking Server、データパイプライン、推論APIのそれぞれの担当
- SLA:受付、初動、復旧目標、保守時間の取り決め
重大度ごとの連絡方法、モデル更新の承認者、パッチの期限を明記しておきます。再学習や評価データの変更を保守に含めるかどうかは、月額費用との兼ね合いで決めます。
MLflowのシステム開発にかかる費用相場
MLflowのライセンス費用は原則無料ですが、外注費は工数で決まります。その工数は、要件定義、クラウド設計、連携、認証で大きく変わり、テストや教育、保守の工数も加わります。
単体の一律な価格表はほとんどないため、ここでは、MLOps・AI基盤と業務システム開発の相場から組み立てた2026年時点の企画用レンジを示します。要件によって上下する前提で、正式な見積もりの前に使う数字と考えてください。
導入・開発費の幅(300万円台から1億円超)
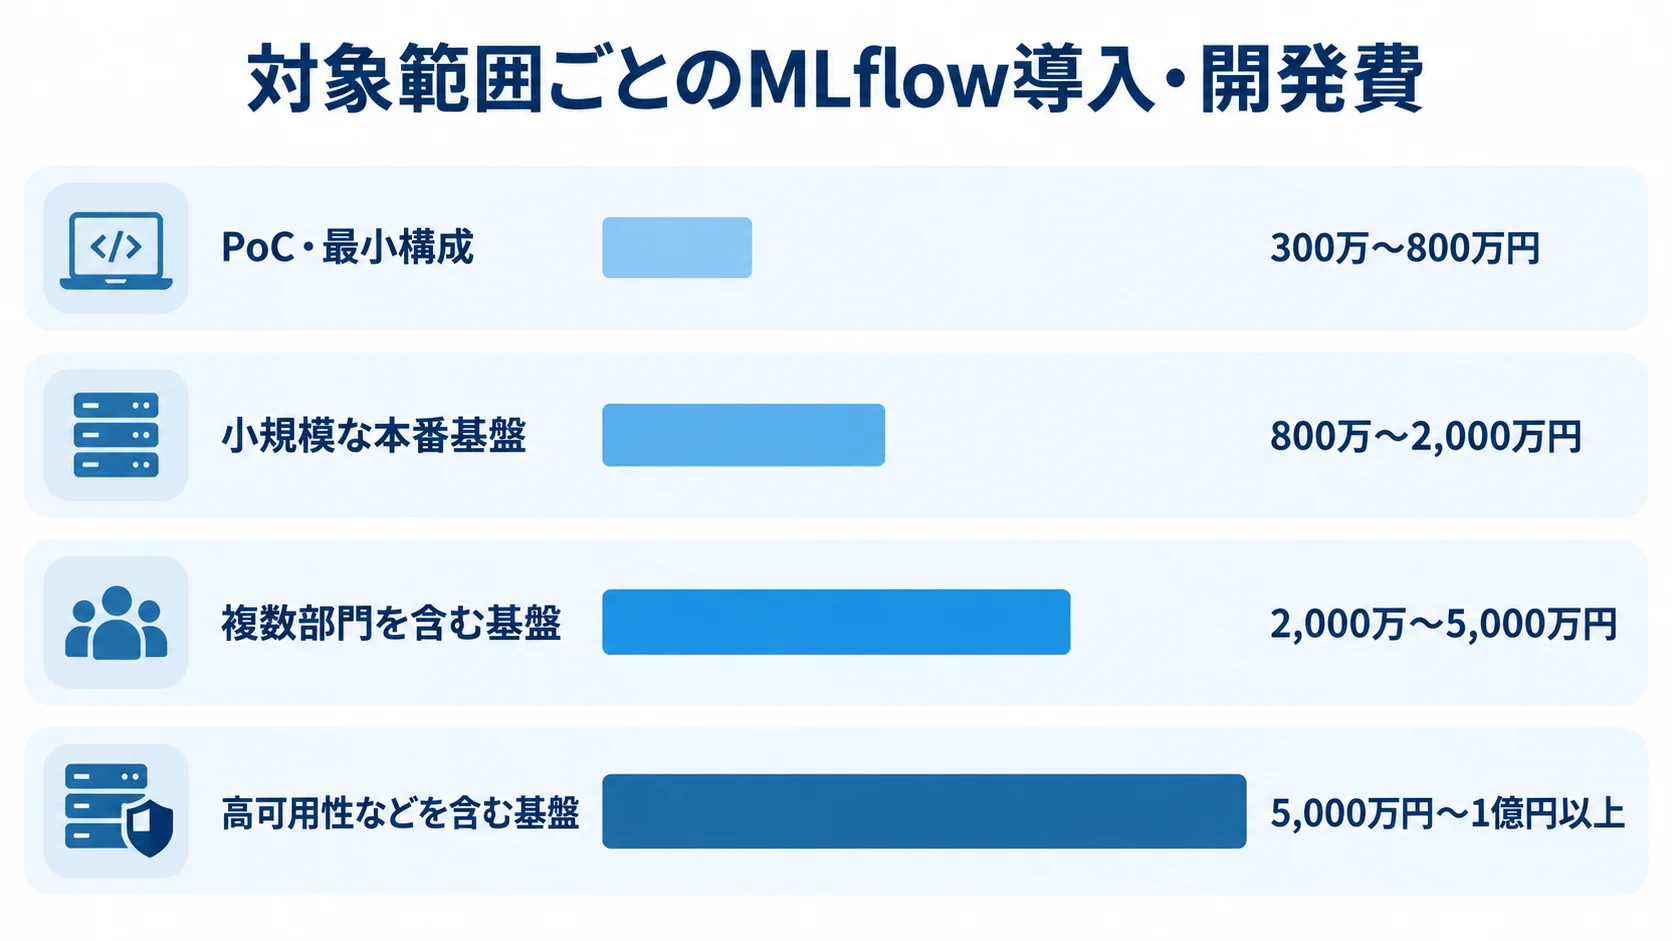
開発費と期間は、対象範囲が広がるほど大きくなります。企画段階では、範囲を次の4段階に分けて目安を立てられます。
- PoC・最小構成:300万〜800万円、1〜3か月
- 小規模な本番基盤:800万〜2,000万円、3〜6か月
- 複数部門を含む基盤:2,000万〜5,000万円、6〜12か月
- 高可用性などを含む基盤:5,000万円〜1億円以上、12か月以上
PoCの範囲は、1〜2チームの実験管理、リモートArtifact Store、基本権限、操作手順に絞って考えます。既存クラウドを使い、推論や自動再学習を含めない場合は、PoC費用が下限に近づきます。
小規模な本番では、PostgreSQL・CI/CD・モデル承認・バッチまたはAPI推論・監視・バックアップが含まれます。
複数部門での利用、SSO・RBAC、業務連携は、規模を左右する要素です。再学習やドリフト監視、監査ログ、移行教育も、規模に影響します。
大規模な基盤は、高可用性やGPU、災害対策を含むほか、マルチクラウドやオンプレ連携、厳格なデータ分離を求められる場合です。これらの金額は、MLflow単体ではなく、AI基盤を業務システムへ組み込む外注費の推定です。
人月と工程内訳による見積もりの確認
総額だけでなく、各職種が工程ごとに何人月入るかと、単価や金額も確かめます。
- PM:月90万〜150万円程度(一般的な業務システム開発の企画目安)
- SE:月65万〜110万円程度(一般的な業務システム開発の企画目安)
- PG:月50万〜90万円程度(一般的な業務システム開発の企画目安)
- テスター:月45万〜80万円程度(一般的な業務システム開発の企画目安)
MLやデータ、クラウド、アプリの各エンジニアの人月も確認します。単価は、専門性や地域、契約条件によって変わります。
工程ごとの金額と工数は、要件定義、設計、構築、連携の順に分けてもらいます。テスト、移行、教育についても、金額と工数を別々に示してもらいます。前提や除外作業、追加変更の単価も確認すると、要件変更の影響を把握できます。
要件定義を急ぐと、スコープが膨らみ、工数と費用が1.3〜1.5倍になる可能性があります。そのため、初期の要件整理にかける費用を削りすぎないことが大切です。
初期費用と分けて見るクラウド費用と保守費用
クラウド費と保守費は、利用条件と含める作業を分けて見積もります。
- クラウド費:Tracking Server・DB・Artifact Store・コンテナ・監視・転送・GPU学習・推論が対象です。
- 軽量な共有構成:月5万〜30万円程度(企画上の目安)
- 中規模構成:月30万〜150万円程度(企画上の目安)
- 保守費:初期開発費の年15〜25%(目安)
AWS公式の例は、10人と40人のチームがそれぞれ160時間利用し、SmallとMediumのTracking Serverを使う条件です。各1GBのメタデータ保存を含めた合計は、262.60米ドルになります(出典:AWS公式SageMaker AI料金ページ、2026年8月確認)。
常時稼働、Artifactの容量、学習や推論、リージョン、転送は別途見積もりになります。GPUや高可用性、常時推論、大容量のArtifactを使う場合は、月150万円を超えることも想定します。
これらは公開価格の平均ではなく、必要なリソースから推定した数字です。利用量の前提を示して、委託先に再計算してもらいます。
問い合わせ、脆弱性対応、更新、再学習、監視当番のうち、どこまでを月額に含め、どこを別料金にするかを分けておきます。料金上限の通知や予算アラートも、あわせて設計します。
MLflowの委託先選定と見積比較のポイント
委託先は、MLflowの担当範囲、見積もりの前提、質問への回答とリスク説明を確かめて選びます。
MLflowのどの範囲を担当したかという実績の確認
実績については、Tracking・Registryだけを担当したのか、推論やデータ連携、CI/CD、認証、監査まで担当したのかを確かめます。可能であれば、匿名化した構成図や体制表、運用後の改善、障害対応の例も見せてもらいます。
- 生成AI案件:トレース、評価、プロンプト、コスト管理の扱い
- 基盤の適合:特定製品だけでなく、既存環境と比べる力
Azure Machine Learningは、ローカルや別クラウドのMLflowコードから接続できます。加えて、クラウドの採用理由を、既存契約、データ所在地、人材、必要機能から説明できるかも確かめます。
金額より前提条件をそろえた見積比較
初期費、クラウド費、保守費、再学習・モデル更新費は、分けて比べます。
要件定義、PoC、本番構築、移行、教育、運用設計のうち、どこまでが見積もりに含まれているかも確かめます。
- 利用前提:チーム数、環境数、Artifact容量、1日あたりの学習回数をそろえる
- 処理条件:推論の利用時間、ユーザー数、必要SLAを記載する
- 提案内容:必須機能、代替案、拡張、除外作業を分ける
監視やバックアップ、受け入れテストが含まれていないために、安く見えることもあります。あわせて、提案書には納期のクリティカルパスも示してもらいます。
質問とリスク説明による提案の質の見極め
良い委託先は、機密性、評価方法、許容遅延、既存境界、権限、障害復旧について質問してきます。
標準機能ではできないことや追加開発、クラウド依存が強まる点も、委託先から説明があります。
- 技術選定:理由、代替案、リスク、PoC項目の説明
- 体制と記録:肩書きだけでなく、設計や運用の担当者が参加し、回答が文書に残るか
判断ゲートと内製化の計画も確かめ、長期の委託体制を見極めます。
MLflow外注で起きやすい失敗と対策
失敗例は、ツールの導入をゴールにしてしまうことや、データとコードの版を残さないことです。本番の推論や監視を後回しにしたり、契約終了後の引き継ぎを決めないままにしたりすることもあります。
原因は技術面だけでなく、発注時に成果物と受け入れ条件が足りないことにもあります。
優先順位と変更手順によるスコープクリープの防止
開発の途中で、別のモデルや別部門、リアルタイム推論を追加したいという要望が出ることがあります。
- 優先順位:必須、できれば欲しい、将来拡張に分ける
- 変更管理:納期、費用、品質への影響の記録と承認
データ移行や周辺連携は、実装よりもテストに時間がかかることがあります。まず、モデル、実験履歴、権限、保持期限を一覧にし、移行できない情報と手作業で補う情報を明確にします。
運用定着と内製化の最初からの設計
MLflowは、データサイエンティストやアプリ開発、業務、インフラの担当者が使い続けることで価値が出ます。
モデル名や実験名、タグ、承認状態、評価指標のルールに加えて、各担当の操作範囲も決めておきます。
- 社内責任者:プロダクト、データ、セキュリティ、運用の責任者を置く
- 運用経験:課題管理、設計レビュー、受け入れ、引き継ぎの経験
担当者向けの研修を行っておくと、外注が終わった後も、更新やモデル追加に対応しやすくなります。
よくある質問
費用や構成は要件によって変わります。自社のデータ、利用者、運用体制を前提に、委託先へ確認してください。
MLflowは無料なので外注費もかかりませんか?
MLflowはOSSのためライセンス費用は原則無料ですが、外注費はかかります。
Tracking ServerやDB、Artifact Storeには費用がかかります。認証、監視、バックアップ、推論、保守にも費用が発生します。
外注費はソフト購入費ではなく、安全に使える状態へ設計・構築・移行する人件費です。
MLflowの発注は最初から本番基盤にするべきですか?
最初から全社の本番基盤にせず、対象業務を絞ったPoCから始めることもできます。そのPoCで、実験記録、モデル承認、推論、監視、ロールバックを確かめ、本番の条件と追加費用を決めます。
ただし、将来の移行を妨げないように、データ、コード、モデルの記録方法を選んでおきます。
MLflowの開発会社は何を基準に選べばよいですか?
MLflowの実績に加えて、データ基盤、推論、クラウド、認証、監視、運用移管の対応範囲を見ます。
工程の内訳や仮定と除外条件、PoCから本番までの体制、契約終了後の引き継ぎ、障害窓口を比べてください。そのうえで、実際に設計を担当する人へ質問するとよいでしょう。
AWSやAzureのマネージドMLflowを選べば外注は不要ですか?
マネージドサービスでサーバー管理の一部は減りますが、業務KPI、データ権限、モデル承認は設計が必要です。
推論連携、監視、費用管理も自社で設計が必要になります。AWSとAzureの機能や契約条件の違いも確かめたうえで、業務に組み込む設計と運用移管を外注するかを判断します。
まとめ
発注するのは、MLflowの導入そのものではなく、モデルを業務で継続利用できるMLOps基盤です。対象業務とKPIを決め、PoC、本番構築、運用保守の範囲を分けてください。
発注前に確認する項目
まず、発注形態とクラウドを確かめます。あわせて、Tracking ServerとArtifact Store、再現性、権限、推論、監視も確認します。
バックアップや費用の前提、成果物、受け入れ条件、契約終了後の引き継ぎも整理しておきます。そのうえで、複数社へ同じRFPを渡し、工程、体制、除外条件、運用責任をそろえて比べます。
最初の相談で伝える内容
MLflowを業務へ組み込む範囲を見極めるために、現在の開発状況、利用目的、希望条件を相談の前に整理しておきます。
- 開発状況:学習コード、データ管理、月間実験回数
- 利用目的:モデルを使う業務と利用者
- 希望条件:希望時期、セキュリティ制約、自社の運用範囲
分からない点は無理に決めず、検証してほしい仮説と、検証後に判断する事項を分けて伝えます。
発注で大切なのは、モデルの価値を再現できる形で業務へ届け、運用を続けられる体制をつくることです。課題と要件を整理したうえで、技術と運用の両方を説明できる委託先へ相談してください。
▼全体ガイドの記事
・MLflowのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。