
MLflowのシステム開発は、管理する情報や導入形態、業務要件を踏まえて構成を選び、実験から本番までをつなぐ取り組みです。これにより、モデルを業務で継続して活用できます。
まず機能と導入形態を見て、次に開発手順と費用、セキュリティ、委託先の選び方へ進みます。詳しくは関連記事もご覧ください。
▼関連記事一覧
・MLflowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・MLflowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・MLflowのシステム開発の見積相場や費用/コスト/値段について
・MLflowのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLflowのシステムの概要
MLflowは、業務でモデルを継続して使うための共通の管理基盤です。AIモデルを作る開発環境そのものとは異なり、実験記録からモデル登録、本番化の判断、推論後の評価までをつなぎます。
MLflowで管理できる情報の範囲
MLflowでは、パラメータや精度などのメトリクス、実行時刻を実行単位で記録できます。コード情報も同じように残せます。さらに、モデルファイルや画像、評価レポートも管理の対象です。
Trackingは、学習や評価の試行を記録し、あとから実験を比べられるようにする仕組みです。記録の対象には、コードのバージョンや成果物も含まれます(出典: MLflow公式ドキュメント「ML Experiment Tracking」、2026年)。
大切なのは、モデルファイルを残すだけでなく、どのデータと設定から結果が生まれたかを後から再現できるようにしておくことです。
MLflowとMLOpsの違い
MLOpsは、データの準備から再学習までの流れを継続して回す考え方や仕組みです。一方、MLflowは実験やモデルの管理、評価、トレースを担う中心的な部品です。
MLOpsを完成させるには、MLflowに加えて周辺の仕組みも必要です。データパイプラインやCI/CD、推論APIを組み合わせると、業務で使い続けられるシステムになります。さらに、監視や承認フローも加えます。
MLflowの主な機能とシステム構成
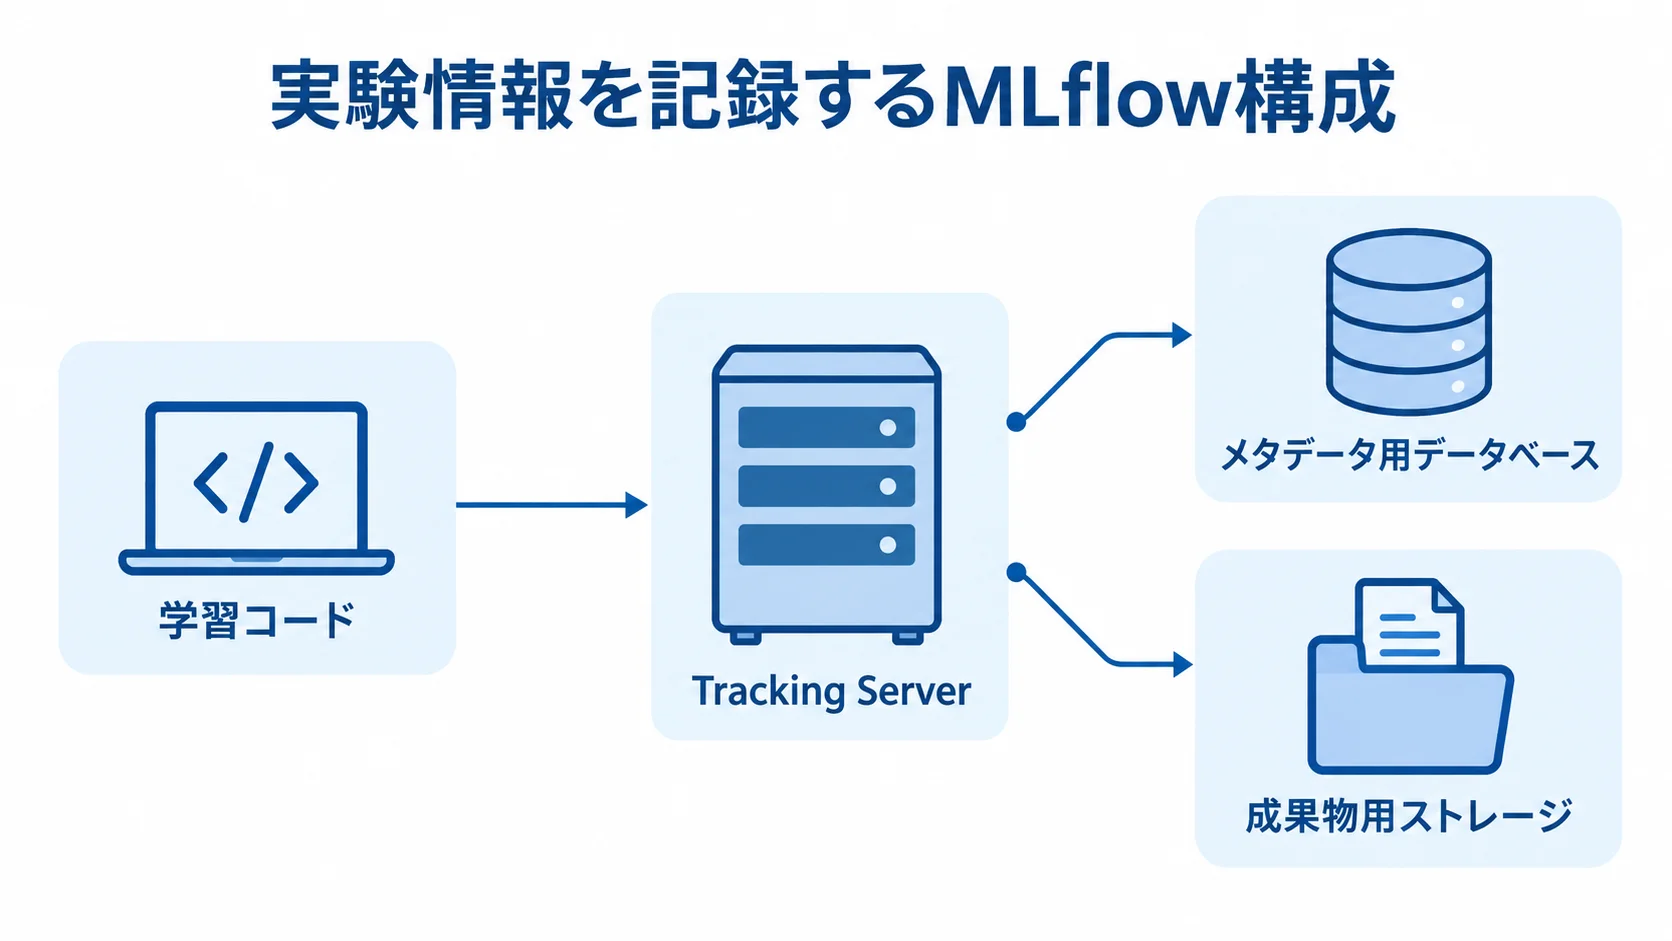
MLflowの構成には、画面のほかに、実験情報を保存する仕組みがあります。学習コードからTracking Serverへ実験情報を送り、メタデータ用データベースと成果物用ストレージへ保存します。
基本の構成では、登録したモデルをCI/CDや推論サービスへ渡します。各部品の責任範囲を分けて考えると、要件定義や見積もりの抜けが出にくくなります。
TrackingとModel Registryが担う役割
実験の再現とモデルの承認では、TrackingとModel Registryが受け持つ情報が異なります。
- Tracking:学習や評価の試行の記録と、複数の実験結果の比較。
- Model Registry:採用候補の版ごとの管理と、検証中や本番承認済みなどの状態の共有。
需要予測の場合は、特徴量の期間やアルゴリズム、ハイパーパラメータを記録できます。さらに、検証期間や誤差、学習データの識別子も残せます。承認履歴を残すことで、個人フォルダから本番へファイルをコピーする運用を避けられます。
Serving・Evaluation・Tracingまで広がる機能
モデルを業務サービスへ届けるには、Serving、Evaluation、Tracingの設定も合わせて確認しておく必要があります。
- Serving:登録モデルを推論APIやバッチ処理へ展開する機能。
- Evaluation・Tracing:機械学習やLLMの評価、処理の追跡に使う機能。
Servingでは、入力スキーマや依存ライブラリを決めます。さらに、CPU・メモリ、タイムアウト、スケール条件も設定します。
MLflow 3系では、LLMやエージェントのトレース、プロンプト管理、生成結果の評価が重視されています。また、公式情報は、MLflow 3をモデル管理に加えて、GenAI開発とトレーシングを主要な利用経路として位置づけています(出典: MLflow公式「MLflow 3」、2025年)。
MLflowのシステムの種類
導入形態は、セルフホスト、マネージドサービス、ハイブリッド構成に分けられます。選ぶときは、データの保管場所やクラウドの運用力、認証要件を照らし合わせます。チーム数や将来の移行方針も判断材料です。
検証環境と本番環境は、同じ形にそろえなくても構いません。用途と運用条件に合わせて、構成を決めます。
セルフホスト型の自由度と運用責任のバランス
セルフホスト型は、仮想サーバーやコンテナ、Kubernetesなどに MLflowを配置し、社内や自社クラウドで管理する方式です。ライセンス費用を抑えやすく、保存先やネットワークも細かく選べます。
一方で、更新やDBのバックアップ、障害対応は自社か委託先が担うことになります。TLSや認証、ストレージのライフサイクル管理も、その担当に含まれます。少人数の検証なら、ローカル保存やDocker Composeで始められます。
複数チームで共有する場合は、本番運用を想定した分離が必要です。
マネージド型とハイブリッド型の使い分け
運用を任せる範囲とデータの保管場所を基準にすると、マネージド型とハイブリッド型の違いが見えてきます。
- マネージド型:パッチ適用や拡張をサービス側に寄せ、モデル開発と業務連携に集中しやすい形。
- ハイブリッド型:管理機能をマネージド環境に置き、データと成果物は自社ストレージ、推論は既存のコンテナ基盤に分けて担う形。
料金例として、Tracking Serverの稼働時間とメタデータ保存量を基準にした課金があります。40人規模と10人規模の2チームがそれぞれ160時間利用する例では、月額262.60米ドルです(出典: 大手クラウド公式料金ページ、2026年)。
成果物ストレージや学習の計算資源は、別途加算されます。さらに、推論や監視、通信費も加算の対象です。
クラウドをまたいで使う場合は、認証や転送費を検証します。また、API互換性やモデル移行も確認します。
MLflow互換の機械学習ワークスペースを使えば、別々の環境にある実験情報を一か所に集約できます(出典: 機械学習プラットフォーム公式ドキュメント、2025年)。
MLflowのシステム開発の進め方
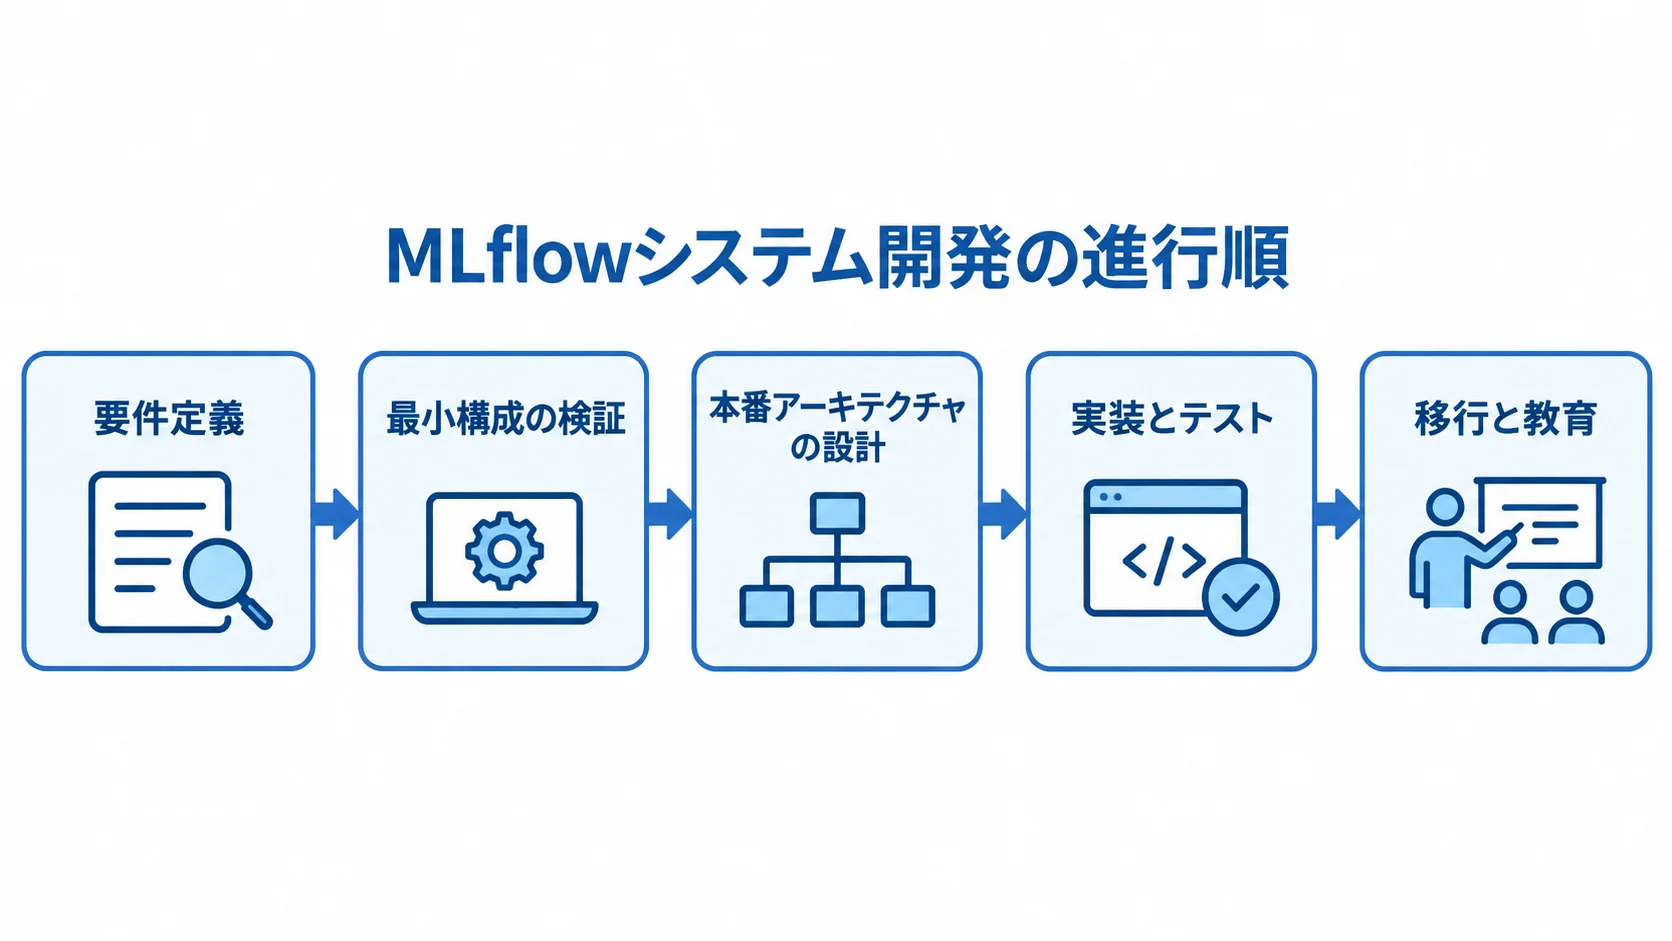
開発では、ツールを入れる前に、AIを使う業務のKPIと本番運用の責任者を決めておきます。段階を分けて進めると、機能を増やしすぎずに効果を判断できます。
- 要件定義
- 最小構成の検証
- 本番アーキテクチャの設計
- 実装とテスト
- 移行と教育
要件定義で決めるAIの成果と運用条件
業務成果の測り方を先に決めておきます。たとえば、予測誤差の改善幅や審査時間の短縮、回答品質の評価方法がこれにあたります。技術指標だけでなく、誤判定による損失も数値で捉えます。
許容レイテンシーや月間処理件数、再学習頻度は、運用の前提として決めます。さらに、障害時に前のモデルへ戻すまでの時間も定めておきます。
保管期間や個人情報の有無は、要件に書き込みます。承認者や、開発・検証・本番の環境分離も要件に記載します。
PoCによる1ユースケースの検証と本番構成への拡張
PoCでは、効果を測りやすい1ユースケースに絞ります。Trackingで実験を比較し、Registryにモデルを登録して、簡単な推論まで通します。
成功条件は、画面が動くことだけでなく、再現性や評価値も含めて決めます。具体的には、同じデータとコードで同じ結果を再現できるか、評価値が合意した基準を超えるか、担当者以外も実験を確認できるかを確かめます。
アクセス量と成果物の容量をもとに、DBやオブジェクトストレージを含む本番構成を見積もります。推論基盤と監視も、見積もりの対象に含めます。
本番化までに整えるCI/CD・監視・教育
本番化では、モデル登録を起点に、テストから承認、デプロイ、ロールバックまでを一続きにつなぎます。監視対象と異常時の通知先も決めます。
- 入力・推論:データ欠損、推論エラー、レイテンシーの監視。
- 品質・容量:精度低下、データドリフト、成果物容量、API利用量の監視。
公開事例では、100を超えるAI・機械学習サービスを支える基盤を約40サービスが使い、平均で1日60万件超を処理しています。
構成では、サービス分離やOAuth 2.0、RBACを組み合わせています。さらに、KubernetesやPrometheus系の監視も用いています(出典: MLflow公式ブログ公開事例、2026年)。
リリース前に、業務担当者もモデルの状態を確認し、承認や再学習を実行できる手順を整えます。教育を省くと、表計算ファイルや個人ノートブックに戻ってしまい、記録が分散します。
MLflowのシステム開発にかかる費用相場
MLflowはApache 2.0のOSSで、ソフトウェアのライセンス費用は原則無料です。ただし、業務で使う場合は、要件定義や環境構築、DBとストレージに費用がかかります。
さらに、認証や監視、CI/CDも対象になります。推論や保守にも費用がかかります。ここに示す金額は、MLflow単体の定価ではなく、MLOps基盤の開発や導入を含めた2026年時点の企画用の金額の幅です。正式な見積もりでは、要件を分解して確認します。
▶ 詳細はこちら:MLflowのシステム開発の見積相場や費用/コスト/値段について
初期開発費の幅(300万円から1億円超まで)
PoCから大規模案件まで、対象の機能と運用要件ごとに、企画用の金額の幅を確認します。
- PoC・小規模導入:300万〜800万円程度、1〜3か月。
- 小規模な本番基盤:800万〜2,000万円程度、3〜6か月。
- 複数部門向け:2,000万〜5,000万円程度、6〜12か月。
- 大規模案件:5,000万円〜1億円超となる可能性があります。
PoCの対象は、1〜2チームのTrackingと成果物ストレージです。基本権限や操作手順も含みます。推論や自動再学習を含めない場合は、下限に寄りやすくなります。
小規模な本番では、DBやバックアップ、CI/CDを含みます。承認やバッチまたはAPI推論、監視も含めます。
複数部門向けでは、SSOやRBAC、複数環境を加えます。連携や再学習、ドリフト監視も含まれます。さらに、監査と移行教育も対象です。
高可用性や規制業務への対応、GPU基盤が必要な場合は、大規模案件になります。災害対策や厳格なデータ分離を求めるときも、大規模案件として扱います。
ランニングコストの幅と、クラウド・運用範囲による違い
月額費用は構成によって変わります。企画の段階では、下に挙げる目安を参考にできます。
- 軽量構成:月5万〜30万円程度から。
- 複数チームなど:月30万〜150万円程度。
- GPU・高負荷推論を常時利用:月150万円を超えることもあります。
軽量構成は、Tracking ServerやDB、成果物ストレージを自社クラウドで運用する場合です。監視も自社クラウドで運用する前提です。
複数チームや高可用性があると、費用が上がります。さらに、常時推論やデータ増加、GPU学習でも費用は膨らみます。
月額は、計算資源や保存量、稼働時間から算出する企画用の推定値です。通信費や保守体制も含めて考えます。平均値を当てはめるものではありません。
保守・運用費は、初期開発費の年15〜25%程度を目安に置く方法もあります。
脆弱性対応だけを含むか、障害対応や再学習まで含むかで、保守費は変わります。評価や問い合わせ、改善開発まで含むかでも違いが出ます。
見積書では、クラウドの従量課金と運用費を分け、再学習回数と成果物の保存年数を明記します。
本番運用で必要なセキュリティと非機能要件
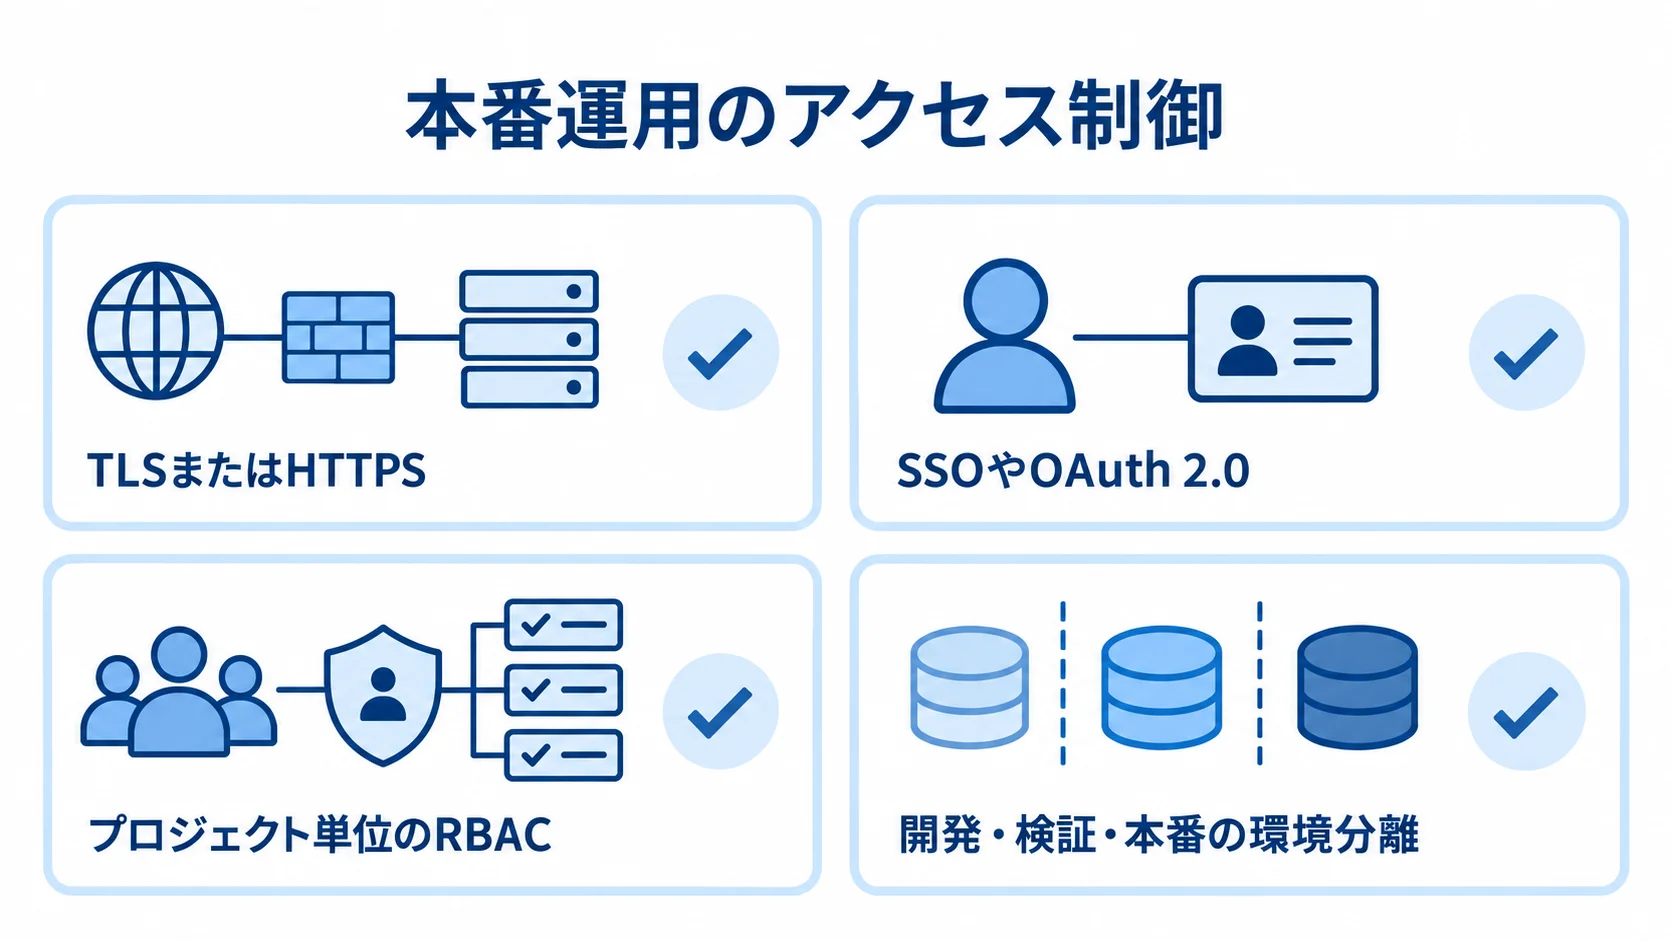
共有基盤や外部向けのサービスでは、機能要件より先に、データとアクセスの境界を決めます。機密情報がログに残ったり、誰でも成果物を取得できたりする状態では、本番で使えません。
基本は、Tracking ServerやDBを一つの権限でまとめて扱わないことです。成果物ストレージや推論サービスも、権限を分けて扱います。
認証・権限・ネットワークを分けた設計
アクセス制御は、接続と利用者権限の観点から設定を決めます。さらに、環境分離やログも確認します。
- 接続と認証:TLSまたはHTTPS、SSOやOAuth 2.0、サービス間認証の設定。
- 権限と保管:プロジェクト単位のRBACと、秘密情報の保管場所。
- 環境分離:開発・検証・本番のネットワーク、アカウント、キー、保持期限の分離。
ストレージでは、読み込みだけを行うサービスと、書き込みを行う学習ジョブ、管理者の操作権限を分けます。
公式資料は、TLSと認証を検討事項に挙げています。さらに、成果物へのアクセス経路やホストのCORS制限も含まれます(出典: MLflow公式「Tracking Server」、2026年)。
社内ネットワークだけで使う場合でも、端末の持ち出しや委託先からの接続を想定します。そのうえで、アクセスログと監査ログを残します。
データガバナンス・可用性・契約の明文化
導入の前に、記録する情報とサービス水準、委託時の契約条件を明確にします。
- データ管理:個人情報や秘密情報を記録しない運用と、保存期間、削除、匿名化、所在、利用許諾、著作権、第三者ライセンスの確認。
- 生成AIの記録:入力、プロンプト、モデル、ツール呼び出し、出力、利用者のフィードバックのうち、記録する範囲。
- 非機能要件:稼働率、復旧時間、バックアップ、リストア訓練、推論遅延、同時実行数、容量、監視、脆弱性対応期限の決定。
- 委託契約:コード、Infrastructure as Code、設定、モデル、データの権利と引き渡し、再委託、終了時の返却、保守の担当範囲の明記。
MLflowの開発会社・ベンダーの選び方
選定では、「MLflowを使える」という説明よりも、モデルが業務へ届くまでの担当範囲を確かめることが大切です。会社名や知名度より、自社の用途と本番責任の分担に照らして比べます。
TrackingとRegistryに加えて、データ連携や推論に対応できるかが判断材料です。さらに、認証や監視、CI/CDまで対応できるかも確かめます。運用教育や内製化支援も、比べるときの観点になります。
MLflowの記載と本番範囲を分けた実績の確認
提案依頼では、公開できる範囲で実績と対応バージョンを確かめます。構築機能と利用チーム数、運用期間も見ておきます。障害対応の経験も確認します。
「AI導入支援」は、モデル開発だけを指す場合もあります。そのため、学習データの更新から、再学習や承認、推論リリース、精度監視、ロールバックまでの流れを図で示してもらうと、対応範囲を比べやすくなります。
工程・成果物・運用費を分けた見積もりの比較
見積もりは工程別に分けて、どの機能が含まれるかを確認します。
- 工程:要件定義、PoC、基本設計、環境構築、連携、テスト、移行、教育、保守。
- 対象機能:Tracking Server、DB、成果物ストレージ、認証、推論、監視。
工数が「一式」と書かれている場合は、対象範囲を質問します。比べるときは、初期費用に加えて、クラウドや再学習、脆弱性対応を含めた5年程度の総保有コストで比べます。問い合わせや追加モデル登録も、同じ枠に入れて比べます。
運用体制と内製化の支援範囲
本番運用の担当者と対応時間を確かめます。契約や内製化支援の範囲も、見ておく必要があります。
- 運用分担:モデル承認、障害切り分け、再学習の担当を、RACIなどで明確にすること。
- 対応条件:24時間監視か平日対応か、重大障害の初動時間と復旧目標の決定。
- 契約・内製化:検証環境、OSS脆弱性対応、設計意図、運用手順、テストデータ、教育、並走期間を、成果物や契約に含めること。
▶ 詳細はこちら:MLflowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:MLflowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:MLflowのシステム開発の発注/外注/依頼/委託方法について
MLflowのシステムに関するよくある質問
導入の検討では、無料で使えるか、自社で運用できるか、既存のクラウドと併用できるかといった疑問が多く出ます。モデル以外の管理範囲も、よく問われます。
MLflowは無料で使えますか?
MLflowのOSS本体は、ライセンス費用なしで利用できます。本番では、サーバーやDB、ストレージが必要です。
ネットワークや認証、監視も欠かせません。さらに、保守と学習・推論の計算資源も必要です。ただし、無料なのはソフトウェアの利用開始までで、業務システム全体の費用が無料になるわけではありません。
MLflowは自社サーバーやオンプレミスで運用できますか?
自社サーバーやオンプレミスで運用できます。DockerやKubernetesにTracking Serverを配置し、社内DBやオブジェクトストレージへ接続する構成が考えられます。
更新やバックアップ、TLS、認証などを自社で担うことになります。障害対応と容量計画も含まれます。そのため、クラウドとの費用だけでなく、運用人員も比べる必要があります。
MLflowは既存のクラウドや機械学習サービスと併用できますか?
併用できます。別環境の学習からTracking APIへ接続したり、既存コンテナ基盤へモデルを展開したりできます。
接続前には、認証とデータ転送を検証します。成果物の保存場所やモデル形式、推論の互換性も確かめます。サービス固有の権限や、移行時のエクスポート手順も確認します。
MLflowで学習データやコードも管理できますか?
MLflowは、学習データを業務DBのように保管する製品ではなく、参照情報を扱う仕組みです。データセットの識別子や版、スキーマを、実験やモデルに関連付けられます。さらに、取得時点やコードのコミット情報も紐づけられます。
実データは専用ストレージやデータ基盤で管理し、MLflowには再現に必要な参照情報と評価結果を残します。個人情報をログや成果物へコピーしないことも、重要です。
MLflowのシステム開発に関するまとめ
MLflowは、実験記録の画面にとどまらず、モデルを本番へ届け、評価し、改善を続けるMLOps基盤です。
OSSのため、無料で試すことはできます。ただし、本番で使うには、データベースや成果物ストレージ、認証を含めて設計する必要があります。さらに、監視やCI/CD、推論、保守も設計の対象です。
導入判断で押さえるポイント
導入の前に、業務KPIと対象用途を決めます。そのうえで、再学習頻度や承認者、許容レイテンシーを定めます。さらに、データ保持期間と障害時の復旧目標も決めておきます。
セルフホスト、マネージド、ハイブリッドを比べ、初期費用とクラウド・運用費を分けて見積もります。PoCの成功条件を本番移行の基準とつなぐと、費用が膨らむことや、PoCで止まることを防ぎやすくなります。
開発会社へ相談する前に準備すること
相談の前に、用意する情報と、提案内容を比べる観点を押さえておきます。
- 事前情報:学習コード、データの種類と量、利用者数、推論方法、既存クラウドの一覧。
- 制約条件:セキュリティ、希望時期、予算上限の条件。
- 相談の起点:業務課題と本番で避けたいリスク。要件が未確定でも、PoCの範囲や優先順位から相談できます。
- 比較の観点:再現性、運用負担、セキュリティ、内製化、5年程度の総コスト。
▼関連記事一覧
・MLflowのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・MLflowのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・MLflowのシステム開発の見積相場や費用/コスト/値段について
・MLflowのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。