
MLflowのシステム開発は、要件整理から定着までの6フェーズで進めます。最初に業務KPIと運用条件を決めておくことが、その出発点になります。
6フェーズを順に踏むと、PoC止まりや予算超過を防ぐ助けになります。
▼全体ガイドの記事
・MLflowのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLflowのシステム開発の全体像
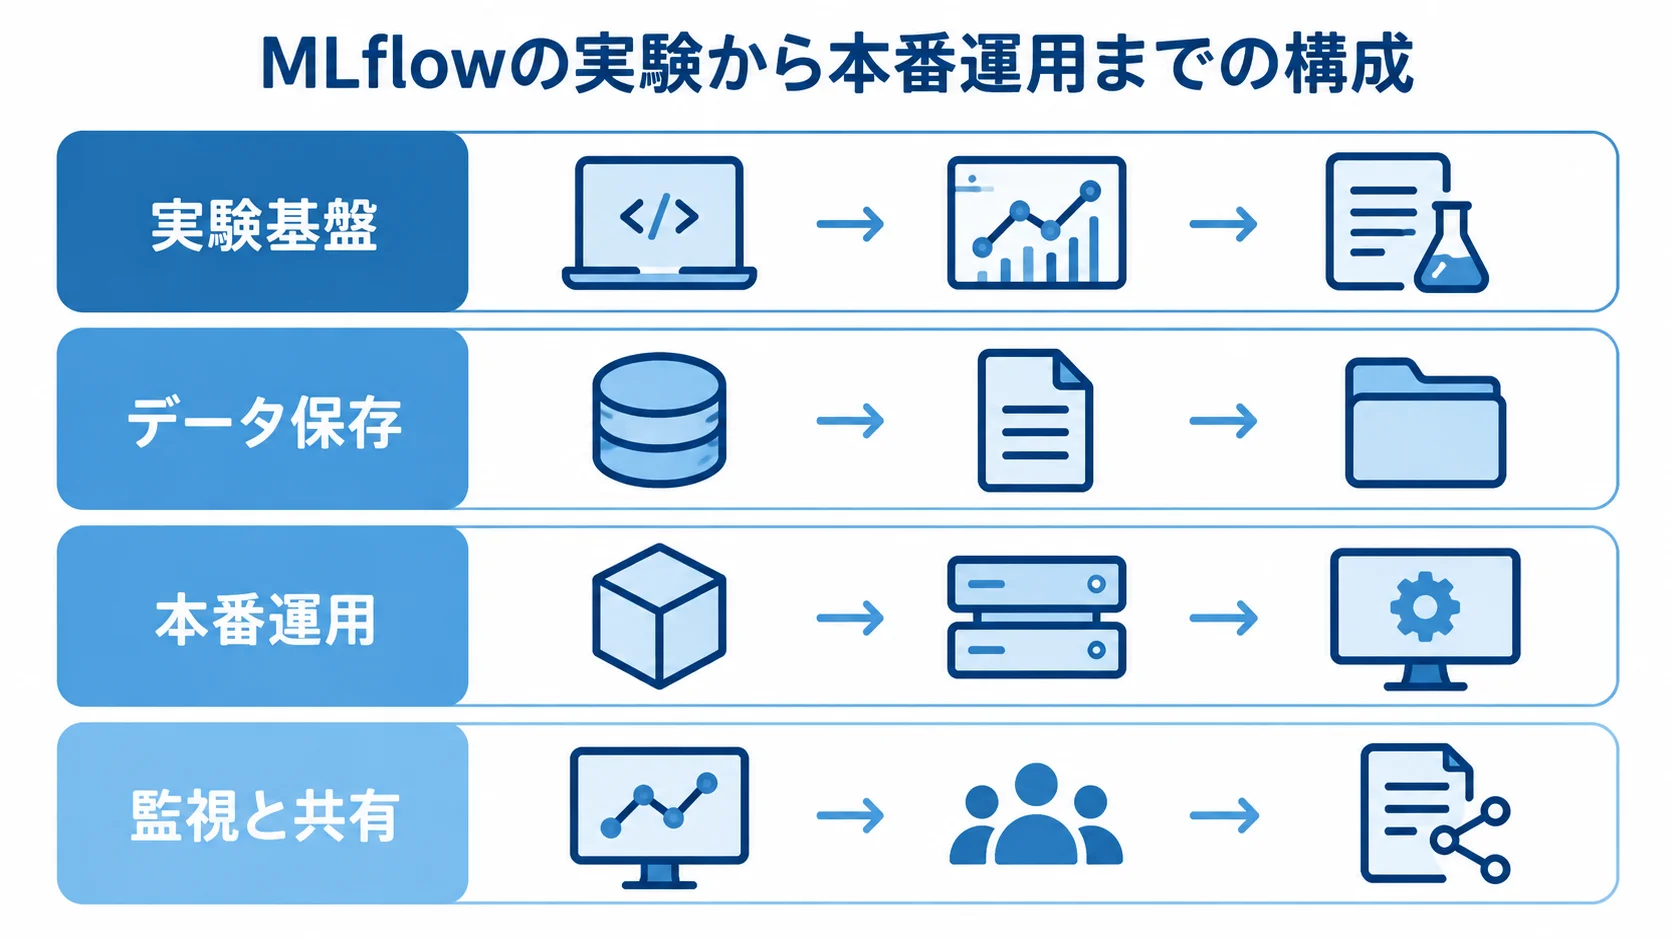
MLflowは、機械学習モデルやLLMアプリの開発・評価・デプロイを支えるOSS基盤です。業務システムそのものを作る製品ではなく、AIを使うシステムのライフサイクルを管理する役割を担います。
TrackingとModel Registryが担う役割
要件整理では、記録対象を再現・比較・承認・監査のどの目的で使うかから決めます。機能の一覧から並べると、目的との対応が抜けやすくなります。
- 実験の記録:Trackingで結果を並べて比べられます。
- モデルの承認:Registryで版と承認状態を管理します。
- 再現性の確保:データ、前処理、環境も結び付けます。
実験の記録では、パラメータとメトリクスを残すのが基本です。コード版、出力ファイル、モデルも対象になります。
Registryでは系譜やタグも管理し、検証済みモデルを本番に昇格させるかを判断します。
Trackingは複数の言語のAPIに対応し、自動ロギングも使えます。対応するAPIは、Python、REST、R、Javaです。
同じモデルを作り直せるよう、学習データの識別子と前処理コードを記録しておきます。依存ライブラリや評価データも残します。推論スキーマと実行環境も、欠かせない記録です。
本番で必要になる構成要素
Artifact Storeには、モデルや画像などの成果物を保存します。保存先にはS3、GCS、Azure Blobなどが使われます。
推論はバッチまたはリアルタイムで行い、精度とデータドリフトも監視します。
小規模な検証は、ローカルのmlrunsやDocker Composeでも始められます。複数チームで共有する本番環境では、保存先と認証を分けて設計します。
MLflow 3系では、ログ済みモデルの検索、LLM・エージェントのトレース、評価機能が拡張されています。
生成AIでは、回答品質に加えて入力やプロンプトを追跡します。使用モデル、ツール呼び出し、評価結果も追跡の対象です。
公式の機能更新を確認し、自社で使う版とクラウド側の対応範囲を固定しておくと、後工程の手戻りを減らせます。
- 実験基盤:学習コードでモデルの実験を行う層
- データ保存:DBはメタデータ、Artifact Storeは成果物を受け持ちます。
- 本番運用:Registry、CI/CD、再学習、推論をつなぐ部分
- 監視と共有:精度やドリフトを見ながら、保存先と認証を分けて扱います。
学習コードやノートブックに加えて、MLflow Tracking ServerとPostgreSQLなどのバックエンドDBも構成します。
実験記録の受け付けは、Tracking Serverが担います。
MLflowのシステム開発の進め方
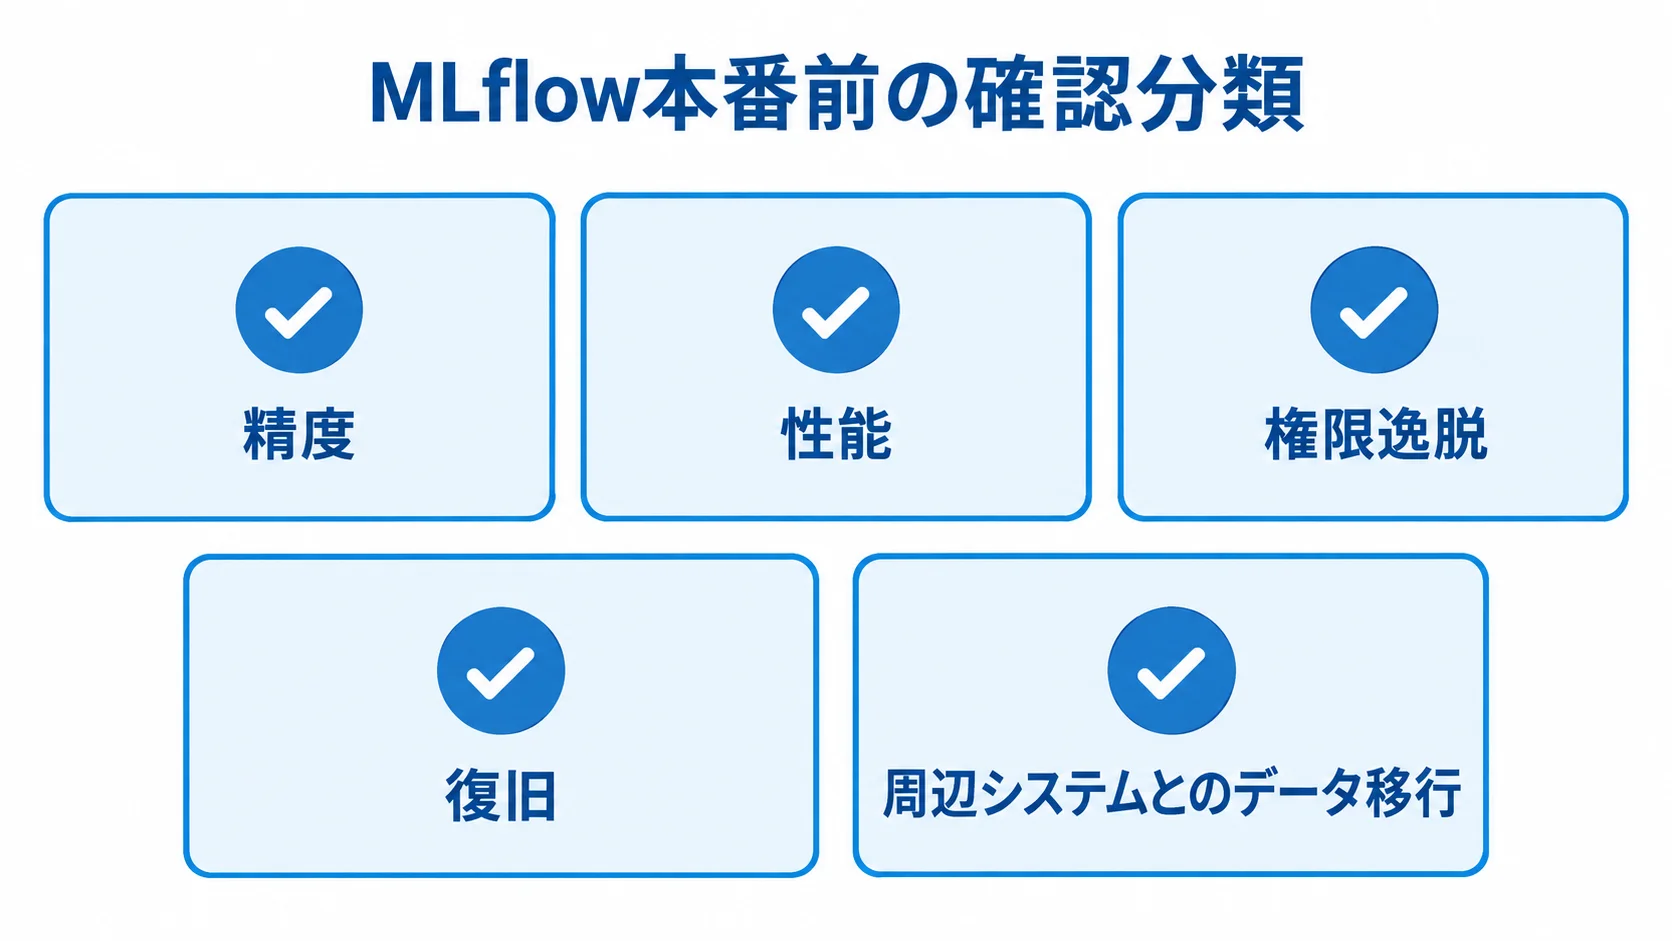
最初に決めるのは、機能の一覧ではなく、AI業務の成果と運用責任です。そのうえで、要件整理から始め、設計・開発とテストを経て、稼働と定着へ進みます。
各フェーズの終了条件を文書にして、次へ進む判断を関係者で共有しておけば、開発会社へ委託する場合でも品質を管理しやすくなります。
1. 要件整理:AIの成果と運用条件
要件整理があいまいなまま見積もると、連携やセキュリティ対応が後から増え、工数が1.3〜1.5倍に膨らむ可能性があります。
確認する項目は、次の4つです。
- 成果指標:ユースケースごとの業務KPI
- 処理条件:1日あたりの件数と許容時間
- 運用条件:再学習の頻度と本番承認者
- 管理項目:利用者・データ・評価・更新契機・連携・監査・担当者を洗い出す
学習データやトレースに個人情報や機密情報を残すかどうかも、早い段階で決めておく必要があります。
たとえば、需要予測では欠品率と在庫金額、異常検知では見逃し率と調査時間をKPIにします。審査なら処理時間と人手確認率、生成AIなら正答率・根拠提示率・有害回答率を定めます。
本番で使えるかどうかは、精度目標と合わせて判断します。その際、1日あたりの処理件数、許容レイテンシー、停止許容時間も決めておきます。
入力データの所在と保持期間、モデル評価指標も、さらに確認しておきます。失敗時に戻す方法、つまりロールバックの手順も、ここで決めます。
2. 選定:セルフホストとマネージドの比較
運用形態は、自社で担える作業と既存環境との適合性をもとに選びます。マネージド環境は構築を短縮しやすい一方で、クラウド固有の権限と料金を確認する必要があります。
機能数より、既存の基盤と接続できるかを見ます。データ基盤、コンテナ基盤、CI/CD、認証基盤が対象です。
Microsoft Learnによると、Azure Machine Learningでは、ローカルや別クラウドでの学習からメトリクスや成果物を追跡できます。
サービスごとに、MLflowの版や対応機能は異なります。そのため、MLflow 3系を使う場合は、採用するAPIが使えるかを検証環境で確かめます。
- セルフホスト:構成と保存場所を柔軟に決められます。
- 自社の運用負担:TLS・認証・DB・バックアップ・更新・障害対応を受け持ちます。
- マネージド:構築を短縮しやすく、権限・料金・API・移行性を見ます。
- 既存環境との互換性:接続性とMLflowの版・機能を検証します。
ここでのセルフホストは、自社クラウドやオンプレミスで運用するMLflow OSSを指します。
マネージド側では、Databricks Managed MLflow、Amazon SageMaker、Azure Machine Learningを比べます。
3. 設計・開発:再現性と権限分離の組み込み
まず、Tracking Serverから推論サービスまでの接続を確定します。
公式資料では、Model RegistryにはDBバックエンドが必要と案内されています。
オブジェクトストレージとメタデータDBは役割が異なるため、それぞれのバックアップと復旧の単位、アクセス権、保持期限を決めます。
開発・検証・本番の環境を分けておくと、手動操作による事故を抑えられます。
学習プログラム用のサービスアカウントと、人がUIで閲覧・承認する権限は分けておきます。MLflow本体は改造せず、認証プロキシや公式APIで拡張します。WebhookやCI/CDを組み合わせると、MLflowの更新に追随できます。さらに、Artifactへの直接アクセス権も決めます。
セキュリティと運用の条件は、次の4つの要点で設計します。
- 環境と昇格:本番への昇格条件をCI/CDに組み込む
- 通信と認証:HTTPS/TLS、SSOまたはOAuth2、RBACの導入
- 保護と監査:ネットワーク、Secret Manager、ログ、脆弱性の管理
- 権限と拡張:Artifact権限の分離と、公式API等による拡張
4. テスト:モデルだけでなく連携と復旧の確認
テストでは、精度だけでなく連携や復旧まで本番前に確かめます。
- ライフサイクル:学習記録からRegistry、本番昇格までの流れ
- 推論と異常系:指定モデルの読み込みと、障害時の動作
- 本番基準:精度・再現性・性能・セキュリティ・運用の検証
- 復旧と連携:バックアップ復元と周辺システム連携の確認
例えば、承認者以外が本番へ昇格できないかを検証します。異常系では、データ欠損やスキーマ変更を試します。また、期限切れモデル、推論タイムアウト、外部サービス停止も対象です。
精度は業務KPIで、性能はピーク時の件数とレイテンシーで確かめます。権限の逸脱や機密情報のログ出力に加えて、アラート通知と一次対応者も検査します。
復旧では、DB、Artifact、設定のバックアップからリストアできるかを確認します。周辺システムとのデータ移行や連携テストを省くと、本番稼働後に停止するリスクが高まります。
5. 稼働:段階リリースと監視の開始
全社展開は急がず、1つの業務や1チームに限り、トラフィックも絞って始めます。新モデルは一部のデータや利用者に適用し、旧モデルと比べます。
精度が基準を満たしていても、推論時間やエラー率が悪化していないかを同時に見ます。入力データの欠損率や利用コストも対象です。
監視の対象には、サーバーの可用性やAPIの応答時間、DBとArtifact Storeの容量を含めます。アクセス権エラーや学習失敗も含みます。さらに、モデル精度、データドリフト、推論結果の偏りも追います。
アラートごとに、誰が何分以内に何を判断するかを決めておきます。運用予定には、月次のコスト確認とモデル更新レビューも入れておきます。
2026年2月公開のMLflow公式事例では、LY Corporationが約40サービスでManaged MLflowを利用しています。日平均で60万超のアクセスを扱っています。
同社は、Kubernetesに加え、OAuth2とRBACで認証を組み、PrometheusとAlertmanagerで監視しています。共有基盤では、認証と監視を後から足せない要件として扱います。
稼働時に押さえる点は、次の4つです。
- 段階リリース:限定範囲での開始と、旧モデルとの比較
- ロールバック:承認済み版へ戻す手順の用意
- 品質と運用の監視:精度、応答、エラー、欠損、費用
- 対応体制:アラートの担当者と判断時間の決定
6. 定着:内製化と改善のサイクル
開発会社からの引き継ぎで終えず、データサイエンティストやアプリ開発者、インフラ担当、業務部門の役割を明確にします。
手順書には、モデル登録から不要Artifactの削除までの作業を書いておきます。研修では、画面操作だけでなく、記録しない情報と本番承認の責任も伝えます。
月次か四半期ごとに、モデル利用率や業務KPI、誤判定コストを見直します。再学習回数、失敗率、クラウド費用、未解決アラートも対象です。
未使用実験の保管や、精度が落ちたモデルの放置を防ぐため、保持期限と廃止基準を決めておきます。版を更新するときは、まず検証環境でRun参照やモデル読み込みを確かめます。推論、権限、監視も確認してから、本番へ反映します。
- 役割と手順:担当の明確化と、登録から障害対応までの文書化
- 研修:画面操作、記録しない情報、承認責任の伝達
- 定期改善:指標の見直しと、保持期限や廃止基準の運用
MLflowのシステム開発にかかる費用相場
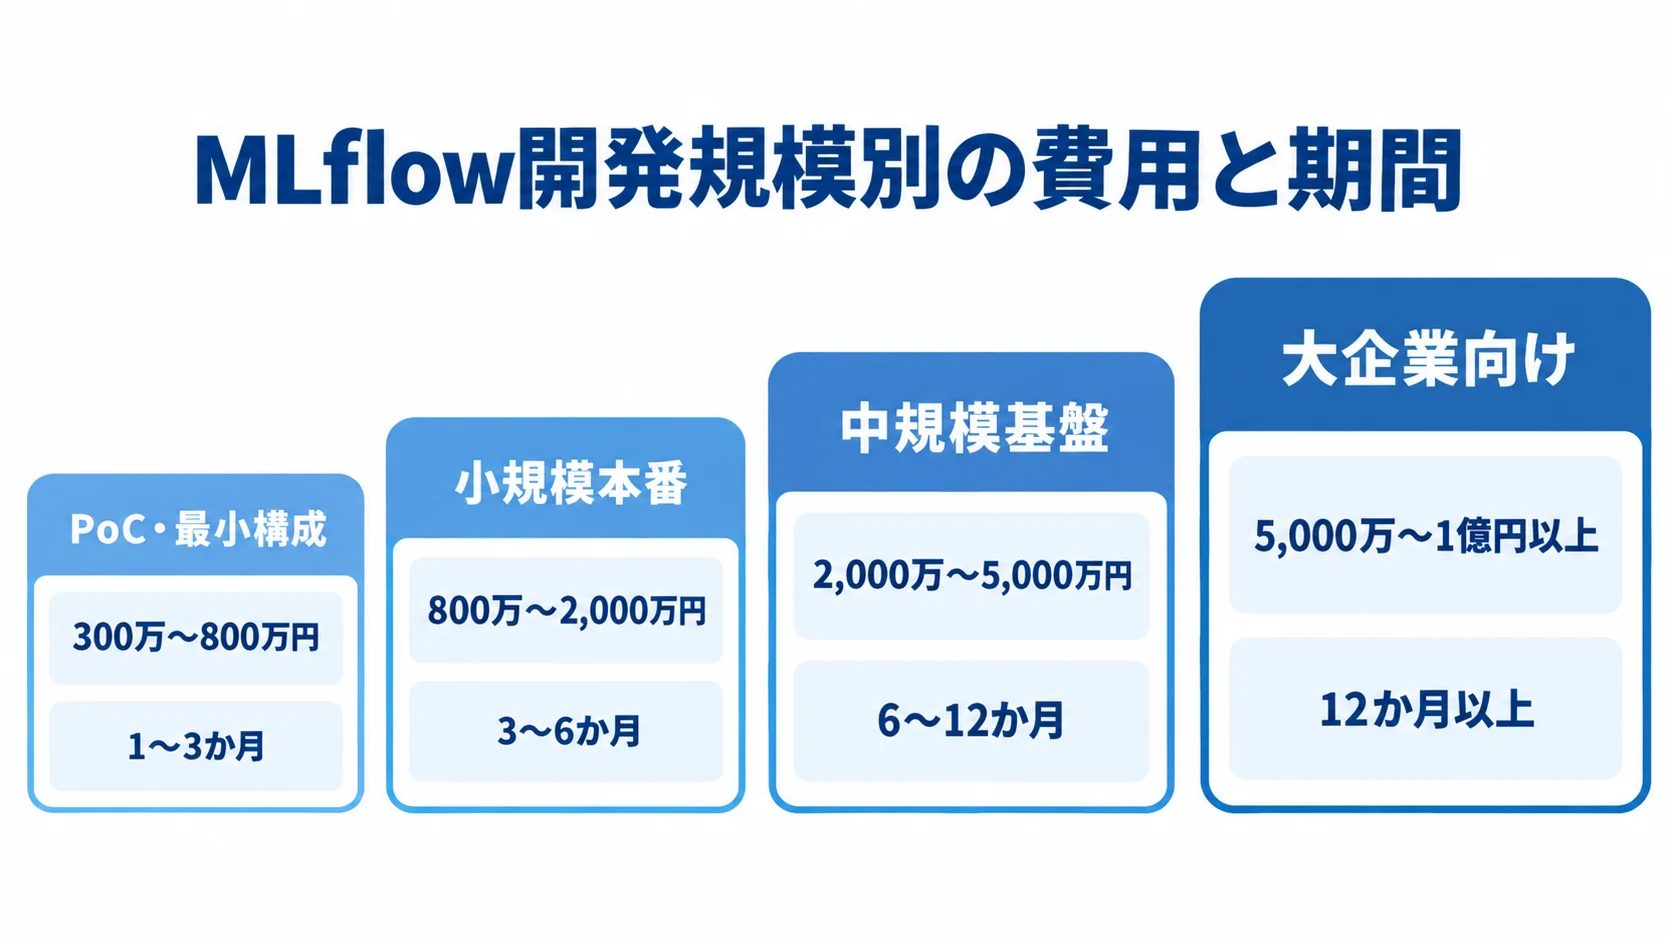
MLflowはApache 2.0のOSSとして利用でき、ライセンス費用は原則無料です。ただし、本番利用には別の費用がかかります。本番利用には、サーバーやDBなどの基盤と、監視・バックアップ・保守、学習・推論の計算資源が必要です。
ここに示すのは、2026年時点の企画用レンジです。リサーチノートの業務システム相場、人月単価、クラウド公式料金をもとにしており、MLflow単体の定価ではありません。
導入・開発費の目安
SSO/RBACや複数環境、業務連携を含めると工数は増えます。再学習やドリフト監視、監査ログ、移行教育まで加えると、さらに増えます。
大企業では、規制業務や高可用性への対応が、費用算定の条件になります。GPU基盤やオンプレミス連携、災害対策も、費用を算定する前提になります。
- PoC・最小構成:300万〜800万円、期間は1〜3か月が目安
- 小規模本番:800万〜2,000万円、期間は3〜6か月が目安
- 中規模基盤:2,000万〜5,000万円、期間は6〜12か月が目安
- 大企業向け:5,000万〜1億円以上、12か月以上のケースもあります
PoCの対象は、1〜2チームのTrackingです。簡易UIやArtifact Storeに加えて、基本権限と操作手順も含めます。
推論サービスや自動再学習は、このPoCには含まれていません。既存のクラウドや認証を使える場合は下限に寄りやすい一方、データ整備や学習コードの改修が多い場合は上限を超える可能性があります。
人件費とクラウド・運用費の考え方
見積もりでは、職種ごとの担当範囲を確かめます。MLflow案件では、PMやSEも見積もりに関わります。
画面開発より体制が複雑になるため、作業ごとに見積もります。
人月単価は、PMが90万〜150万円、SEが65万〜110万円です。PGは50万〜90万円、テスターは45万〜80万円が目安です。
作業は、要件整理、設計、環境構築、パイプライン実装に分けて記載します。テスト、教育、保守も、別の行として書きます。
クラウド費は利用量で大きく変わります。AWS公式のSageMaker料金例では、SmallとMediumのTracking Serverを、それぞれ月160時間稼働させる想定です。
各チームが1GBのメタデータを保存する場合、合計は262.60米ドル/月です。1ドル=150円で機械的に換算すると、約3.9万円/月になります。為替、リージョン、常時稼働は別の条件です。
Artifact Storeや学習・推論エンドポイントも、別料金になります。この例は価格を断定するものではなく、構成を分けて比べるための公式例です。
自社運用の企画用推定は、軽量な共有サーバーやDB、ストレージ、監視の構成で月5万〜30万円です。中規模では月30万〜150万円になります。
GPU学習や高可用性推論、大容量Artifactを常時使う場合は、月150万円超も想定します。ただし、これは公開価格の平均ではなく、リサーチノートに基づく推定です。
初期開発費の15〜25%/年を保守・運用費とする考え方もあります。脆弱性対応や再学習、問い合わせ、クラウド従量課金をどこまで含むかで変わるため、見積もりでは範囲を明記します。
- 対象職種:PM、SE、PG、テスターを見積もりに含める
- 体制:ML、クラウド、セキュリティ、データ基盤の担当も関わる
- AWS料金例:条件により月262.60米ドル、換算すると約3.9万円
- 自社運用費:月5万〜30万円から、月150万円超までの想定
- 保守費:初期開発費の15〜25%/年という考え方
費用が増減する要因
費用に関わる利用条件は、次の4つです。
- 利用規模:利用者数、データ量、Run数、API数
- 運用条件:更新頻度、環境数、可用性、ピーク時間
- 連携と安全性:接続範囲とセキュリティ要件の明確化
- 見積もり範囲:初期費用の除外項目と追加単価の確認
費用は、モデル数よりも利用条件に左右されます。
たとえば、1チームが1モデルを月1回更新する場合と、複数部門が毎日再学習する場合では、設計が異なります。後者は、リアルタイム推論と監査ログも必要な構成です。
そのため、モデル数だけでなく、保持期間やピーク時間も要件書に書いておきます。
データ移行やモデルのラベル整理、学習コードの改修は、初期費用に含まれないことがあります。現場教育や24時間監視、障害時SLAも同様です。見積もりの金額だけで判断せず、含まれる範囲を確かめます。
PoCで本番化を判断する場合は、代表的なデータ量と1か月分の利用量で、試算を依頼します。この試算により、運用費を現実に近づけられます。
MLflowのシステム開発で見積もりを取るポイント
見積もりの範囲は、サーバー構築だけを頼むか、業務要件の整理から本番運用・定着まで頼むかで変わります。RFPには、対象業務とデータの流れを書きます。モデル更新の方法と利用者も、あわせて記します。
既存システムと希望時期を記します。予算上限と、社内で担える作業も加えます。見積もりは、初期構築と継続運用を分けて受け取ります。
RFPに書くべき要件
機能要件では、実験の記録と比較、モデルの登録・承認・昇格を中心に定めます。あわせて、Run、Artifact、データセットの検索と、推論の扱いも要件に含めます。再学習、評価、通知、レポートも、要件として書きます。
非機能要件では、同時利用者数や日次のRun数、Artifact容量を定めます。保存期間やRTO/RPOも、ここに記します。可用性やAPIレイテンシー、監査ログ、暗号化、SSO/RBAC、ネットワーク制限も含めます。
LLMでは、トレースの保存対象と、プロンプトや入力データのマスキングを要件に含めます。評価データの管理と危険回答の検知も入れます。
要件は、主体・条件・判定を一文にまとめると、確認しやすくなります。たとえば、本番承認者だけがproductionへ昇格できる、と定めます。
障害時の条件も同じ書き方で、直前の承認済みモデルへ15分以内に戻せる、学習Runから使用データとコード版を追跡できる、と書きます。
「安全に」「高速に」「柔軟に」のような表現は、会社ごとに解釈が分かれ、見積もりを比べにくくなります。
- 機能要件:記録、比較、昇格、推論、再学習、評価の範囲
- 非機能要件:利用規模、保存、可用性、性能、セキュリティの条件
- LLM要件:トレース、マスキング、評価、危険回答検知の条件
- 受け入れ条件:主体・条件・判定を具体的に書いた基準
開発会社を比較する質問
候補企業への質問は、実績の範囲と運用体制が分かる内容にします。
たとえば、モデル更新を誰が担ったか、クラウドやオンプレミスを選んだ理由を尋ねます。SSO/RBACとArtifact権限をどう分けたか、障害時の復旧訓練をどう行っているかも確かめます。MLflowの更新をどう管理しているかも聞きます。
公開事例がMLOps全般のもので、MLflow自体の実績ではない場合は、その違いを明確にします。
提案書は、作業範囲と体制、前提条件を並べて比べます。成果物と検収基準、日程、追加費用、保守窓口も、同じ表で見ます。
学習データの整備や既存コードの改修は、別途扱いかどうかを確認します。精度保証やクラウド料金、OSSの脆弱性対応、障害対応時間も、同じ観点で確かめます。
同じRFPで複数社から提案を受け、価格だけでなく、終了条件と引き継ぎ方法も比べます。
- 実績範囲:Tracking・Registryから推論・監視までの経験
- 技術運用:権限分離、復旧訓練、更新方法について聞く
- 提案条件:作業範囲、成果物、検収、日程、追加費用の比較
- 契約後:除外項目、終了条件、引き継ぎ方法の確認
契約・権利・保守の分界
利用を終えるときの対応も見通して、契約内容を確かめます。
権利と保守の条件は、次の4つの観点で整理します。
- 成果物の権利:コード、モデル、データ、文書の範囲
- 利用と移管:ライセンス、データ返却、アカウント所有者の確認
- 保守の分界:障害、更新、品質低下などの対象
- 対応条件:一次対応、時間、上限、追加単価の取り決め
開発会社のアカウントにだけ環境やArtifactが残る契約では、将来の移管が難しくなります。
追加で対象になるMLflow本体やプラグイン、設定ファイルは、権利と利用範囲を確かめます。IaCやパイプラインも同様です。
OSSライセンスの遵守に加えて、第三者ライブラリの脆弱性対応も確かめます。再委託と秘密保持も、あわせて確認します。
保守範囲に、サーバー障害やMLflow更新、クラウド仕様変更が含まれるかを定めます。学習失敗、精度低下、データドリフトも対象に入るかを決めておきます。月額費用も、あわせて確認します。
原因別に、一次対応とエスカレーションを決めておきます。たとえば、インフラ障害はインフラ会社が、モデル品質はデータサイエンス担当が、業務判断は利用部門が担います。
MLflowのシステム開発でよくある質問
OSSであることと、本番運用に費用や体制が要らないことは別の話です。業務KPI、データ保護、運用担当者を確かめたうえで、PoCか本番基盤かを判断します。
MLflowは無料で利用できますか?
MLflowはApache 2.0のOSSで、ライセンス費用を抑えて始められます。
本番運用では、サーバーやDB、Artifact Storeなどの基盤に費用がかかります。認証や監視、バックアップ、保守、学習・推論の資源も、費用の対象です。
無料かどうかだけで判断せず、PoCと本番の構成、月額利用量、担当者の工数を分けて予算化すると、今始める範囲を定められます。
AWSやAzureとMLflowを併用できますか?
併用できます。AWSやAzure、Databricksのマネージド環境、自社クラウド上のMLflow OSSから選べます。
まず、利用できる版とAPIを確認します。そのうえで、認証やRegistry、保存先、推論サービスとの接続を見ます。MLflow 3系の機能は、公式資料と検証環境で互換性を確かめます。
非対応の機能は、本番設計の前提に入れないよう注意します。
モデル以外のデータやコードも管理できますか?
管理はできますが、記録の方法と責任の範囲は、あらかじめ設計しておきます。Runには、パラメータやメトリクスに加えて、タグやArtifact、モデルも記録できます。
元データをすべてMLflowへコピーせず、データ基盤のテーブルやファイル版、スナップショットID、ハッシュ値を結び付ける方法が現実的です。
コードはGitのコミットID、環境はコンテナイメージや依存関係の定義で、再現できるようにします。
開発会社へ相談する前に何を準備すればよいですか?
相談前に、対象業務と改善したいKPI、利用者を整理しておきます。データの所在と機密区分、モデル更新の頻度も用意します。既存のクラウドや認証、CI/CDの状況に加えて、希望時期と予算上限、社内の役割もまとめます。
モデルや学習コードがあれば、実験方法と評価指標、再現できない点を共有します。推論方式も伝えます。
RFPを作り、要件整理だけの見積もりと、本番基盤まで含む概算を分けて依頼すると、比べやすくなります。
MLflowのシステム開発の進め方まとめ
MLflow開発では、業務KPI、再現性、モデル承認、推論、監視を、利用者の定着まで一つのライフサイクルとして設計します。セキュリティと費用も、この流れの中で見ていきます。Tracking Serverの構築は、その一部です。
6フェーズの進捗と判断基準の管理
各フェーズで決めた前提は、次の段階が引き継ぎます。そのため、どの段階で何を決め切るかを順に並べます。
- 要件整理:業務KPIと責任者の決定
- 選定:既存環境との互換性の確認
- 設計・開発:DB、Artifact、認証、環境の分離
- テスト:精度に加えた、連携・権限・復旧の確認
- 稼働:段階リリースと監視の開始
- 定着:教育、更新、保守の整備
必要な範囲から段階的に作り、各フェーズの終了条件を合意してから次へ進みます。
導入後に現場で使われなくなる、モデル更新が止まるといった事態を防ぎやすくなります。
最初の一歩:1ユースケースの要件整理
初回は全社基盤を一度に作らず、成果を測りやすい1ユースケースを選びます。
PoCで記録・再現・評価・承認の流れを確かめます。そのうえで、利用者数やモデル数、データ量が広がる場合の見込みを立てます。
複数社へ相談し、自社に必要な範囲と運用体制を含む見積もりを比べます。
▼全体ガイドの記事
・MLflowのシステム開発の完全ガイド
- 小さく検証:成果を測りやすい1ユースケースでのPoC
- 本番要件へ拡張:認証、監視、バックアップ、費用の見込み
- 提案を比較:RFPを使った、複数社の範囲と体制の比較
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。