
MLOps基盤の開発会社は、既存クラウド、業務システムとの連携、運用設計と内製化支援の範囲で比べると選びやすくなります。
取り上げるのは、riplaと5社、計6社です。全体像は、MLOps基盤開発の完全ガイドもご覧ください。
▼全体ガイドの記事
・MLOps基盤開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLOps基盤のパートナー選びが重要な理由
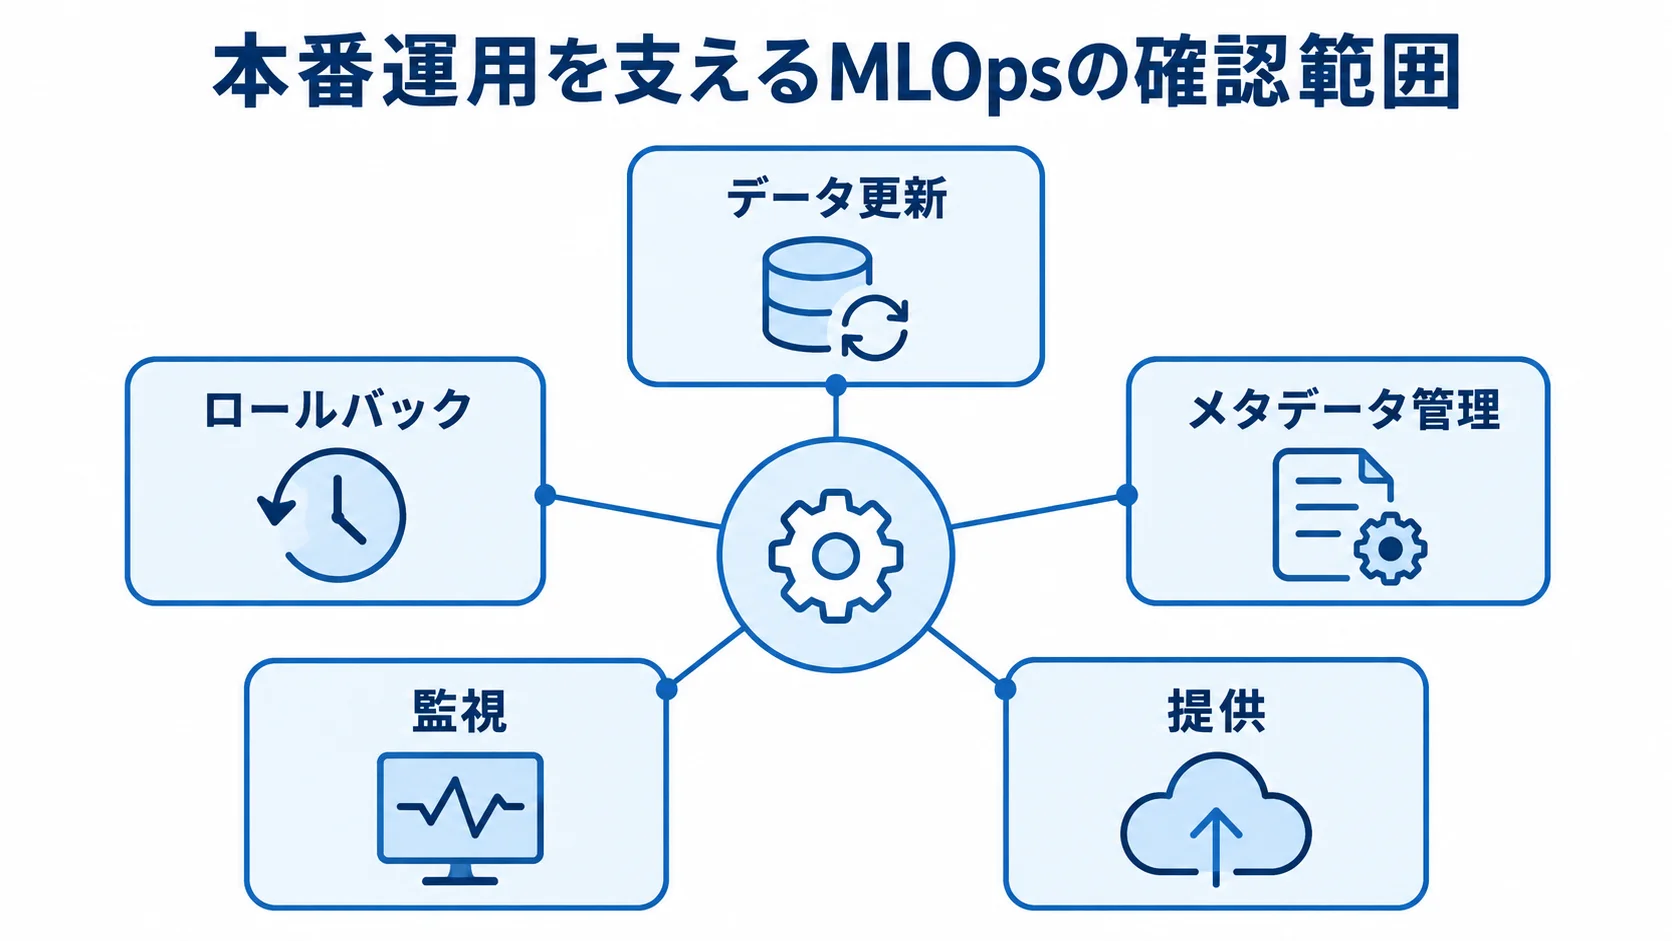
MLOps基盤は、機械学習モデルを改善し続けながら業務で使い続けるための仕組みです。成否はモデルの精度だけでなく、データ更新時の処理、データやコードの追跡、問題が起きたときに安全に戻せるかにも左右されます。
適切なパートナー選定が成否を分ける理由
PoCで高い精度が出ても、本番データでは精度や処理速度を保てないことがあります。原因はモデル自体より、周辺の仕組みにある場合もあります。
精度以外の工程まで見る必要があるのは、MLOpsに含まれる作業が多いためです。Google Cloudは、データ収集と検証、モデル分析に加えて、次の項目もMLOpsに含まれると説明しています(出典: Google Cloud「MLOps: Continuous delivery and automation pipelines in machine learning」、2024年確認)。
- テスト
- メタデータ管理
- 提供
- 監視
提案書に「AIモデルを開発します」とあるだけでは、本番で運用できるかは分かりません。そこで、学習データの版管理やモデルレジストリ、承認の流れを確かめます。推論ログや再学習の条件など、本番運用に関わる項目もあわせて見ておく必要があります。加えて、ドリフト検知、ロールバック、運用の引き継ぎも確かめます。
発注前に確認すべきポイント
発注前は、MLOpsの対象範囲と業務・システムの制約を整理します。
- 対象範囲:モデル数、データ量、更新頻度
- 推論要件:推論の方式、目標レイテンシー、再学習の頻度
- 接続・制約:個人情報の扱い、閉域網、既存DWHやCI/CDとの接続先
納品物として、構成図や運用手順書を含めるかも確かめます。パイプライン定義や監視ダッシュボードなども、同じ観点で確認します。
クラウド製品は標準機能を短期間で使える一方で、サービス設計や料金管理は自社で担う必要があります。
SIerは業務接続や運用設計を任せやすい一方で、利用クラウドや体制を確認する必要があります。加えて、内製化支援と、契約終了時のデータとモデルの持ち出し条件も確かめます。
株式会社ripla|コンサルから開発まで一気通貫で支援
riplaは、コンサルティングから開発まで一気通貫で支援します。IT事業会社として社内DXを進めた経験を活かし、事業成果とシステムの定着を支援します。
営業、顧客、生産、販売管理など、幅広い基幹システムの構築・導入実績があります。また、企業の業務要件に応じて柔軟に対応できる体制です。
特徴と強み
MLOpsでは、どの業務判断を自動化し、結果を誰が確かめ、モデルをどんな条件で更新するかを決めておく必要があります。riplaは、業務要件の整理から設計、開発、導入後の定着まで相談したい企業に向いています。
営業、顧客、販売、生産の既存データにAI・機械学習を組み込む場合、現場の運用を踏まえて基盤の範囲を決めやすくなります。
まず代表モデルで再現性や監視を検証し、利用部門が増えてから共通化する進め方も検討できます。
得意領域・実績
基幹システムとの接続経験があるため、業務データと現場運用をつなぐ相談にも生かせます。
- 業務システム連携:基幹システムとMLOps基盤の接続
- 現場への適用:データの流れや画面、通知まで相談できます。
- 部門間の調整:業務、情報システム、運用担当者をつなぐ橋渡し
問い合わせでは、対象モデルや利用データ、現行クラウドを伝えます。さらに、推論方式と監視KPIも添えます。そのうえで、構成案に加えてPoCから本番へ移す条件と運用分担の提案を受けられます。
人材を補いながら将来内製化したい企業は、設計書、パイプライン、運用手順について、どこまで引き渡すかも確かめます。
Amazon Web Services(AWS)|Amazon SageMaker AIでAWS上の機械学習を統合
Amazon Web Servicesは、AWS上で機械学習の開発から推論、監視までを組み立てられるサービス群を提供します。
SageMaker AIでは、ワークフローとモデルレジストリを組み合わせ、デプロイや監視まで行えます。
AWSを利用している企業や、データ処理と推論をAWSに集約したい企業にとって、比べやすい選択肢です。
特徴と強み
Model Registryを使ったAWSでのモデル運用の特徴を見ていきます。
- モデル管理:Model Registryによるモデルの管理
- 本番連携:承認済みモデルのデプロイやCI/CDへの接続
AWS公式によると、Model Registryでは版や学習指標を管理できます。モデルカードや系譜、承認状態も扱えます(出典: AWS公式「Model Registration Deployment with Model Registry」、2026年確認)。
実験から承認までを、AWSの権限管理やログ基盤と合わせて運用しやすい点が強みです。
サービスを組み合わせると設計の自由度は上がります。一方で、ネットワークやIAM、データ転送は個別に設計する必要があります。ログやGPUの停止設定も、個別に決める必要があります。
AWS公式は、SageMaker Model Monitorの新規顧客受付を2026年7月30日に終了し、既存顧客は継続して利用できると案内しています。そのため、新規案件では代替の監視方法も含めて、最新の仕様を確かめる必要があります。
得意領域・実績
AWSの利用費は、GPUの稼働時間やサーバー構成によって変わります。料金の例を見てみます。
- 開発用GPU:開発環境でml.g4dn.xlargeを月120時間使う例で、88.368ドル(約1.3万円)。
- MLflow Tracking Server:SmallとMediumを各月160時間使う例で、合計262.60ドル(約3.9万円)。
- 常時稼働GPU:ml.g5.24xlargeを4台で30日使う例で、29,374.40ドル(約440.6万円)。
開発環境の自動停止や推論方式によって、費用は変わります(出典: AWS「SageMaker Pricing」、2026年確認、1ドル150円換算)。
問い合わせの際は、AWSアカウントの構成やリージョン、GPUの利用時間を伝えます。加えて、リアルタイム推論の同時実行数や監視・通知方式も共有します。
標準機能とOSSなどで補う範囲を分けたうえで、月額の上限と障害時の復旧手順まで設計できる会社を選びます。
Google Cloud|Vertex AIでデータ分析からモデル運用まで接続
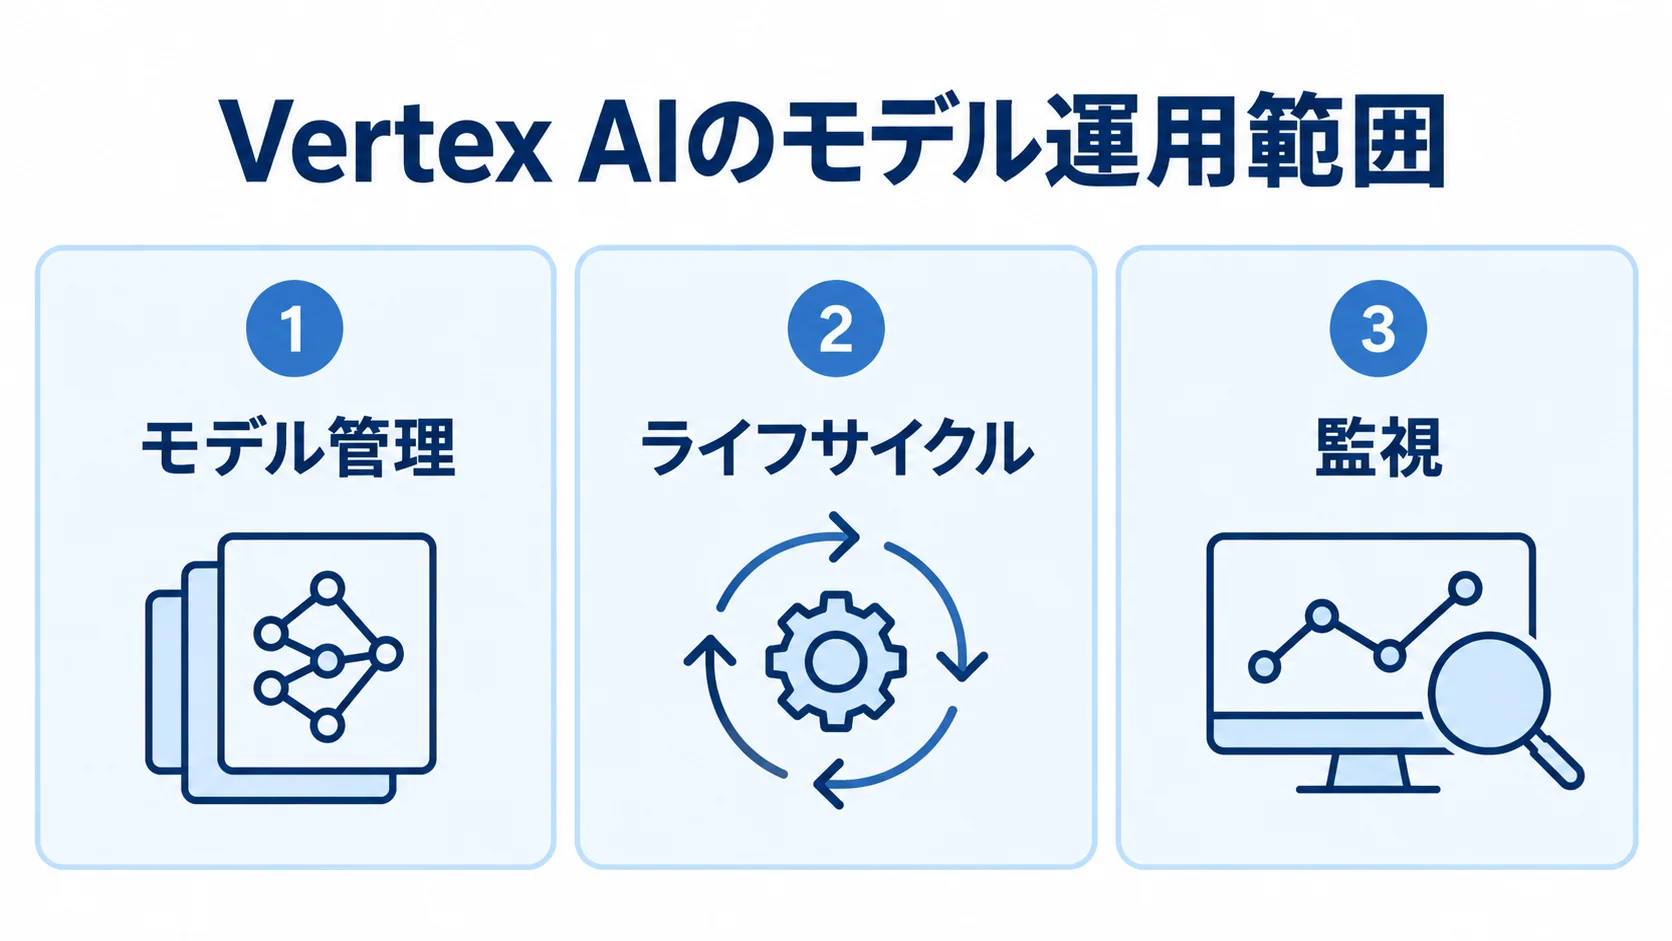
Google Cloudは、BigQueryの分析環境とVertex AIを接続できる基盤です。モデルの学習と評価に加え、登録から推論、監視までを設計しやすい点が特徴です。
分析と機械学習を同じクラウドで行う企業や、予測モデルと生成AIを扱う企業が候補になります。
特徴と強み
Vertex AIでは、モデルを登録したあとの展開や監視も検討できます。
- モデル管理:カスタム、AutoML、BigQuery MLのモデルをまとめて管理。
- ライフサイクル:版、評価、説明可能性、デプロイ状態の追跡
- 監視:オンラインとバッチの推論を継続して確認
Google Cloudの説明では、評価済みのモデルをVertex AI Endpointやバッチ予測へ展開できます。ライフサイクルの整理にも使えます(出典: Google Cloud「Vertex AI Model Registry」、2022年公開情報を2026年確認)。
Google CloudのModel Monitoringは、Vertex AI外部で動くモデルも対象にできる構成が紹介されています。このため、オンラインとバッチ推論を一つの監視設計で考えられます。
BigQueryのデータ品質や特徴量の変化、予測結果、モデル評価について、確認の順番を決めておきます。こうしておくと、モデル登録だけで終わらない基盤になります。
得意領域・実績
BigQueryを中心に、データ分析と機械学習を進めたい企業が候補になります。
- 分析から予測へ:販売、顧客、ログ、センサーデータの利用
- 担当者間の共有:データエンジニアやデータサイエンティスト、開発者が共通基盤を参照し、学習時と推論時の差を管理
- 他クラウドとの比較:AWS・Azureとの転送、リージョン、権限分離、生成AI評価の見積もり
- 移行と構成の確認:モデル・データの移行可否と、サービスの役割を構成図で示してもらうこと
Google Cloudへの統一が、常に最適とは限りません。提案の時点で、BigQueryやVertex AI、Cloud Storageの役割を構成図で説明してもらいます。CI/CDや監視についても同じように示してもらうと、比べやすくなります。
Microsoft|Azure Machine Learningで企業基盤と統合
MicrosoftはAzure Machine Learningで、モデル登録や環境管理を提供します。パイプラインやエンドポイント、監視も含まれます。
Microsoft 365やAzure、Entra IDを利用している企業は、既存基盤と結び付けやすい選択肢です。Azure DevOpsやPower BIを使っている場合も、既存の基盤と結び付けやすくなります。
特徴と強み
レジストリは、ワークスペースをまたいだ資産の共有やMLOpsの追跡に使えます。
- ワークスペース共有:開発、テスト、本番の各環境で、モデルや環境、コンポーネント、データ資産を共有
- 追跡:学習メトリクス、コード、環境、データ、デプロイ先の記録
- 監視:入力分布、学習時と本番時のデータ差、予測品質、レイテンシーを確認し、しきい値で通知
Microsoft Learnでは、学習メトリクスやデプロイ先の追跡について説明されています(出典: Microsoft Learn「Machine learning registries for MLOps」、2026年7月更新)。
監査や環境分離が必要な企業に適しています。正解ラベルがすぐ得られない業務では、データドリフトや欠損率から始めます。推論失敗率や処理時間も見て、後に業務KPIと結び付けます。
得意領域・実績
既存のMicrosoft環境と統合したい企業や、開発環境と本番環境の分離が必要な企業に向く選択肢です。
- 既存基盤:ID管理、ネットワーク、セキュリティ監査、開発環境がMicrosoft中心の企業。
- 環境分離:金融、医療、公共などで開発環境と本番環境を分けたい企業。
- 承認制:モデル昇格を承認制にし、サブスクリプションやワークスペースを活用したい企業。
見積もりでは、Azure Machine Learningのほか、ストレージや計算資源、ネットワークを分けて考えます。監視に加え、Event GridやDevOps・GitHubとの連携費も確認します。
既存契約を活かせる場合でも、GPUの稼働やログの保持期間によって費用は変わります。そのため、開発、検証、本番の3環境で月額の試算を依頼します。
Databricks|MLflowとUnity Catalogでデータ・モデルを統合管理
Databricksはデータレイクハウスを中心に、データエンジニアリングから分析、機械学習、モデル提供までをつなぐ基盤です。
MLflowの実験・評価管理やUnity Catalogの権限・系譜管理、Model Servingを組み合わせて使えます。データとモデルのガバナンスを重視する企業に向いています。
特徴と強み
MLflowは、パラメータや評価指標、成果物を記録します。Unity Catalogと統合したModel Registryでは、モデルのアクセス制御や系譜を管理できます。
Model Servingは、リアルタイムとバッチの推論に対応しています。登録したモデルは、REST APIとして使えます(出典: Databricks公式「MLflow on Databricks」「Model Serving」、2026年確認)。
データ加工から承認、提供までを別製品でつながなくても、データ資産とAI資産の関係を追跡できます。分析チーム間で特徴量やモデルを再利用する場合にも、利用データと本番モデルを確かめやすくなります。
得意領域・実績
Databricksを分析基盤として使う企業や、データウェアハウスと機械学習を別々のチームに分けたくない企業が候補になります。Model Servingは需要に応じて拡張を考えやすい一方で、費用も確かめる必要があります。
- 統合基盤:Databricksを分析基盤として利用する企業。
- チーム連携:データウェアハウスと機械学習を分断したくない企業。
- 費用管理:クラウド計算費とDatabricks利用料を分けて、ワークロードごとに試算
導入時は、Unity Catalogの権限や既存カタログとの関係、MLflowの範囲を確認します。加えて、外部エンドポイントへの移行や、解約時のデータ・モデル出力も確かめます。
全データを移す前に、代表モデルで学習から本番推論までを試します。そのうえで、レイテンシーや再現性を実測します。監査ログや月額費用も、あわせて測ります。
株式会社NTTデータ|業務システムとAI運用をつなぐSIer
NTTデータは、AI実装から商用運用までを対象にしたMLOps導入サービスを公表している国内SIerです。
クラウド製品を自社で選んで組み合わせるよりも、基幹システムや複数ベンダーの調整も含めて相談したい企業の候補です。
特徴と強み
NTTデータは、2020年の発表でMLOps導入サービスの内容を説明しています。
- 開発効率化:AI開発プロセスを効率化するサービスを公表しています。
- 商用運用:予測モデルを自動評価・更新する仕組みを提供すると説明しています。
同社は、OSSとパブリッククラウドのツールチェーンを使い、プロセス1〜6の作業を約250%以上向上させる効果を示しました(出典:NTTデータ「商用AIサービス創出を短期間で実現し、継続的に改善を行うMLOps導入サービスを提供開始」、2020年)。
これは同社が発表した効果で、他社の案件にそのまま当てはまる数値ではありません。
大規模な業務システムにAIを組み込む場合は、モデル性能だけでなく、データ連携やアクセス権の扱いが課題になります。監査ログや障害対応、運用組織との調整も含まれます。
業務の整理から本番稼働後の改善まで、一つの契約や体制で進めたい場合には、SIerの総合力を活かせます。
得意領域・実績
業務システム連携や国内運用を重視する企業では、対応範囲と実績を確かめます。
- 業務連携:基幹業務との連携や部門横断のデータ活用を進めたい企業。
- 国内運用:国内の運用体制や既存ベンダーとの協業が必要な企業。
- 担当分界:NTTデータと、AWS、Google Cloud、Azure、Databricks各社との担当範囲の切り分け
2020年の発表では、よくある3か月のPoCで5回以上のチューニングを可能にすることを狙いとし、3年間で案件への導入件数100件を目指す計画も示されました。現在の提供範囲と実績は、提案の時点で確かめます。
契約書や提案書には、モデルの所有権やソースコードを明記します。パイプライン定義や運用手順書、データ移行も含めて記載します。内製化研修や保守終了時の引き継ぎ条件も、あわせて記載します。
MLOps基盤のパートナーを選ぶポイント
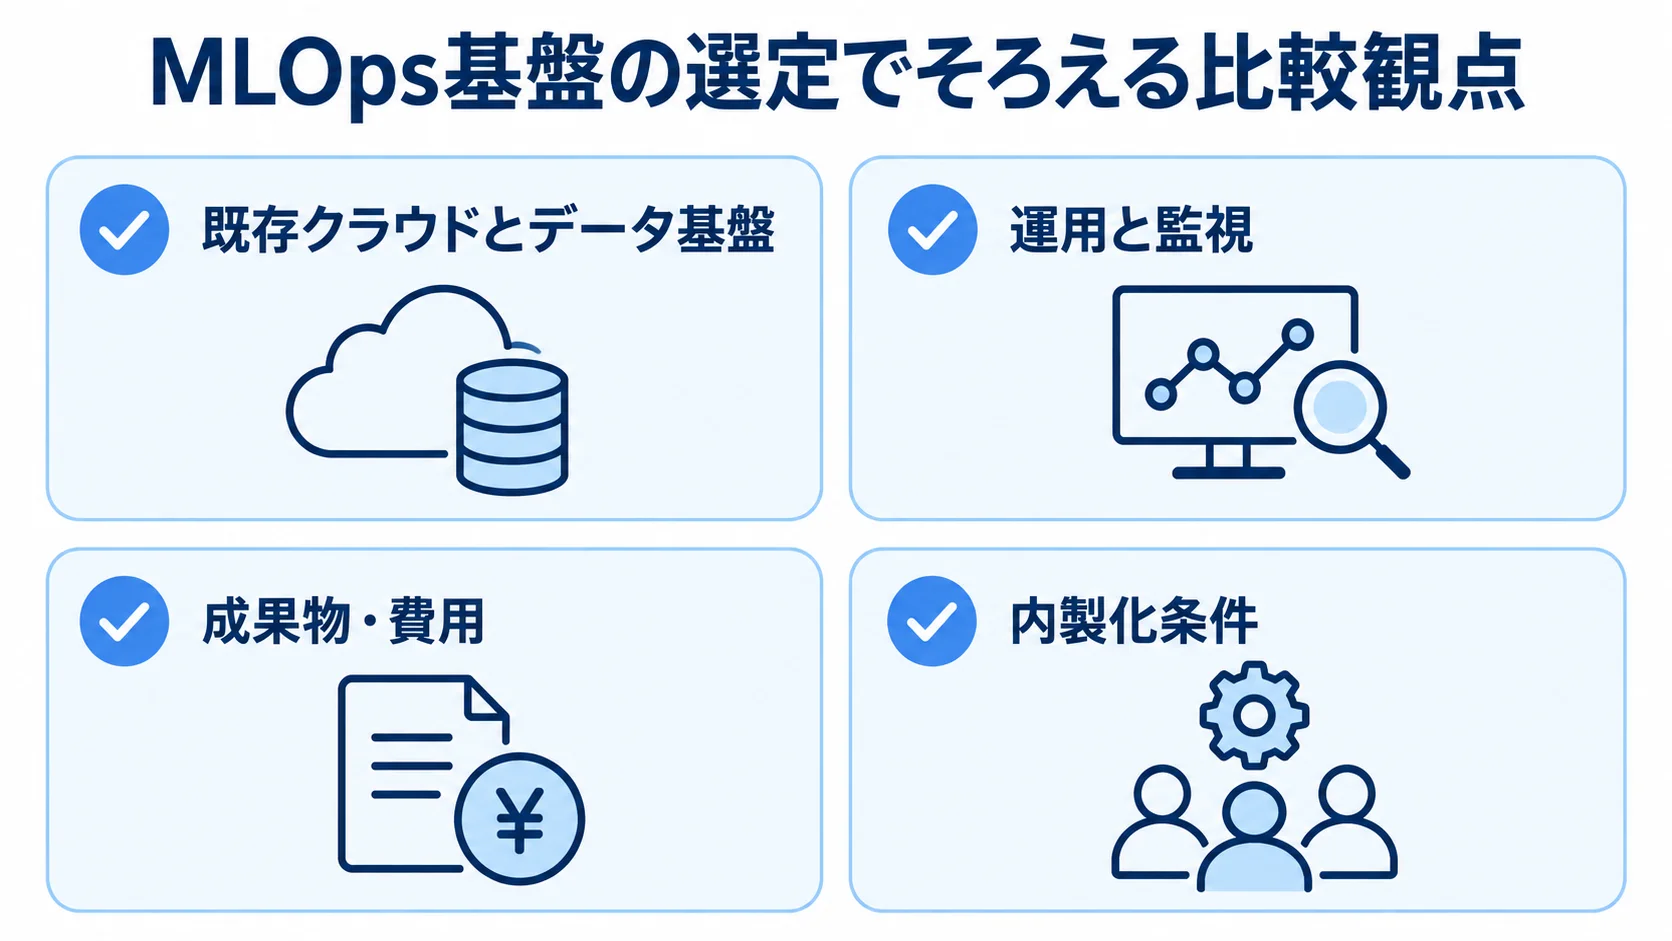
6社は、同じ種類の候補ではありません。AWSやGoogle Cloud、Microsoft、Databricksは、製品や基盤を提供する会社です。
riplaとNTTデータには、業務要件から運用設計まで相談できます。そのうえで、不足する機能を見極めて組み合わせます。
既存クラウドとデータ基盤を起点とした比較
同じモデルとデータを使って、利用中の基盤に近い候補から比べます。
- AWS利用中:候補はSageMaker AI
- BigQuery中心:候補はVertex AI
- Microsoft基盤利用中:候補はAzure Machine Learning
- レイクハウス中心:候補はDatabricks
クラウドが未定の場合は、学習時間や推論レイテンシーを比べます。月額費用や復旧時間、監視項目も見ておきます。データ転送費やGPUの利用可否のほか、リージョンと移行性も確かめます。
モデルとデータの出力方法やAPIの標準性を確かめます。ログの保持期間や権限管理の単位も、あわせて見ておきます。
運用と監視の範囲の数値による確認
「監視対応あり」と書かれているだけでは、何を誰がどの頻度や条件で見るのか分かりません。そこで、数値で測れる項目を決めておきます。
項目には、欠損率やデータ・予測分布、正解ラベル取得後の精度を入れます。推論エラーやレイテンシー、CPU・GPU使用率、費用も項目に加えます。各項目には、しきい値と通知先を決めておきます。
劣化を検知したあと、通知だけにするか、自動で再学習するか、承認後に更新するかによって、設計と、どこまでを誰が受け持つかが変わります。提案書には、現行モデルへのロールバックや学習データの保存期間を記載してもらいます。障害時の手動推論や、再学習のテスト環境も含めてもらいます。
成果物・費用・内製化条件の比較
MLOps基盤の費用は、対象モデル数やデータ量によって変わります。リアルタイム性やセキュリティ、既存連携も影響します。目安は規模ごとに異なります。
- 小規模PoC・最小基盤:500万〜1,500万円、2〜4か月。
- 部門利用の本番基盤:1,500万〜3,000万円、4〜8か月。
- 全社・複数モデル基盤:3,000万円〜1億円以上、9〜18か月。
これらは公的な標準価格ではありません。クラウドやデータ基盤、CI/CD、監視、開発人件費を組み合わせた、編集部による推定です。
初期費用に加えて、クラウドやGPU、ログの費用を分けて見積もります。データ転送やモデル評価、保守人員も、別に見積もる項目です。
要件が不確定な部分には準委任やアジャイルを、確定している範囲には請負を当てるなど、変更リスクを考えて契約方式を選びます。
所有権やソースコード、設計書の扱いを比べます。運用手順や教育、月次レビュー、解約時のデータ削除、移行支援も、同じ観点で比較します。
よくある質問
製品や開発会社、費用、運用体制を検討する際によくある質問に答えます。
MLOps基盤はどこまで作れば完成ですか?
最低限、データやコード、実験条件、モデルの版を追跡できることが必要です。そのうえで、承認済みのモデルを本番に出し、状態を監視できる状態にします。さらに、問題が起きたときに以前のモデルへ戻せる状態も整えます。
推論APIを一度デプロイしただけや、個人のNotebookだけの状態では、継続運用の観点から完成とは言いにくいです。
MLOps基盤の開発会社はどのように比較すればよいですか?
比べる項目は7つで、既存クラウドや業務連携から月額上限まで、同じ基準でそろえます。
製品ベンダーには機能と料金を、SIerには設計から運用、内製化までの範囲を確かめます。同じモデルを使ったPoCや構成図からは、実現性を見られます。
MLOps基盤の開発費用と期間はどのくらいですか?
小規模PoC・最小基盤は500万〜1,500万円で2〜4か月、部門本番基盤は1,500万〜3,000万円で4〜8か月が目安です。
全社・複数モデル基盤は、3,000万円〜1億円以上で9〜18か月になる場合があります。金額はモデル数やデータ整備、既存環境で変わる、編集部推定です。GPUや監視、セキュリティも変動要因になります。
まず1モデルで再現性と監視を検証し、効果と運用負荷を測ってから拡張すると、過剰投資を抑えやすくなります。
まとめ
開発会社は、モデル精度だけでなく、本番運用の設計まで担えるかを見ます。データ検証から再学習、ロールバックまでの流れが含まれるかが、判断の材料になります。
紹介した6社は、クラウド機能を使いたい企業から業務システムを含めて任せたい企業まで、比較の出発点になります。
代表1モデルでの小さな検証
全社共通のFeature Storeやマルチリージョン基盤を先に作らず、代表1モデルで4〜8週間ほど検証します。そのうえで、再現性やデプロイ時間、監視通知を測ります。推論費や現場の削減工数も確かめます。
PoCの成功条件は、精度だけにはしません。担当者が更新できることや、障害時に戻せること、月額費用が予算内に収まることも、あわせて決めておきます。
提案依頼で求める運用成果物
問い合わせの際は、構成図やデータパイプライン、モデルレジストリを納品してもらいます。監視画面や再学習・承認フロー、障害時手順、月額試算、保守分担も、あわせて求めます。
データとモデルの所有権や設計書の引き渡しを確かめます。内製化支援や将来のクラウド移行性も見て、長く使える基盤を選びます。
▼全体ガイドの記事
・MLOps基盤開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。