
MLOps基盤は、データ管理、モデルの再現と承認、本番推論の監視をつなぎ、機械学習を継続して運用するための仕組みです。
基盤の構成と種類、導入、費用、発注先の選び方を、公開料金や公式ガイド(2026年時点)を踏まえ、社内検討やRFP作成に使える観点から取り上げます。
▼関連記事一覧
・MLOps基盤開発の進め方/やり方/流れや方法/手法/工程/手順
・MLOps基盤開発でおすすめの開発会社/ベンダー6選と選び方
・MLOps基盤開発の見積相場や費用/コスト/値段について
・MLOps基盤開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLOps基盤の定義
MLOps基盤は、機械学習のライフサイクルをチームで運用するための共通基盤です。
学習環境や推論APIに限らず、データ、コード、環境、評価結果、本番の承認者を記録します。問題が起きた際には、安全に元の状態へ戻せるように整えておきます。
MLOpsとDevOpsの違い
DevOpsは、アプリケーションのコードをテストしてリリースし、運用で得た情報を次の開発へ戻す考え方です。MLOpsも、自動化と継続的な改善を重視します。
MLOpsでは、コードに加えて学習データ、特徴量、実験条件、モデルの重み、評価指標、推論結果も扱います。データの分布や業務環境が変わると、コードが同じでも予測の品質が落ちるため、これらをあわせて管理する必要があります。
MLOps基盤に必要な主な機能
機械学習のライフサイクルは、データ準備、実験、モデル管理、デプロイ、監視とガバナンスの5つの役割に分かれます。基盤は、この5つを一続きにつなぎ、どの段階で何を記録するかをそろえます。
- データパイプライン:欠損、型、外れ値、スキーマを検査し、データの版を残します。
- 実験管理:コードやデータ、条件、指標を記録し、同じ条件での再実行を可能にします。
- モデルレジストリ:候補モデルの性能と承認状態、依存関係の管理。
- デプロイと推論:オンライン推論、バッチ推論、非同期処理、段階的なリリース。
- 監視とガバナンス:稼働状況、データや予測の変化、精度、公平性の確認。
監視では、レイテンシー、エラー率、リソース使用率のほか、入力や予測の分布、実績ラベル取得後の精度や公平性も見ます。
MLOps基盤が必要な理由
機械学習モデルの価値は、完成したときの精度に加えて、運用中の品質変化にどう備えるかで決まります。
- 本番での品質変化:需要予測は、季節、価格、販促、顧客行動の変化で前提がずれやすい。
- 実験の属人化:個人のPCやNotebookに閉じると、異動やライブラリ更新後に再現できず、調査や再学習も遅れます。
公式のMLOpsアーキテクチャは、データやモデルの検証、メタデータ管理、サービングと監視を組み合わせ、CI/CDと継続学習も含みます。成熟度は、手作業中心のレベル0、パイプライン自動化のレベル1、CI/CDも自動化するレベル2です(出典:クラウド事業者の公式MLOpsアーキテクチャ、2026年8月確認)。
MLOps基盤の全体像と種類
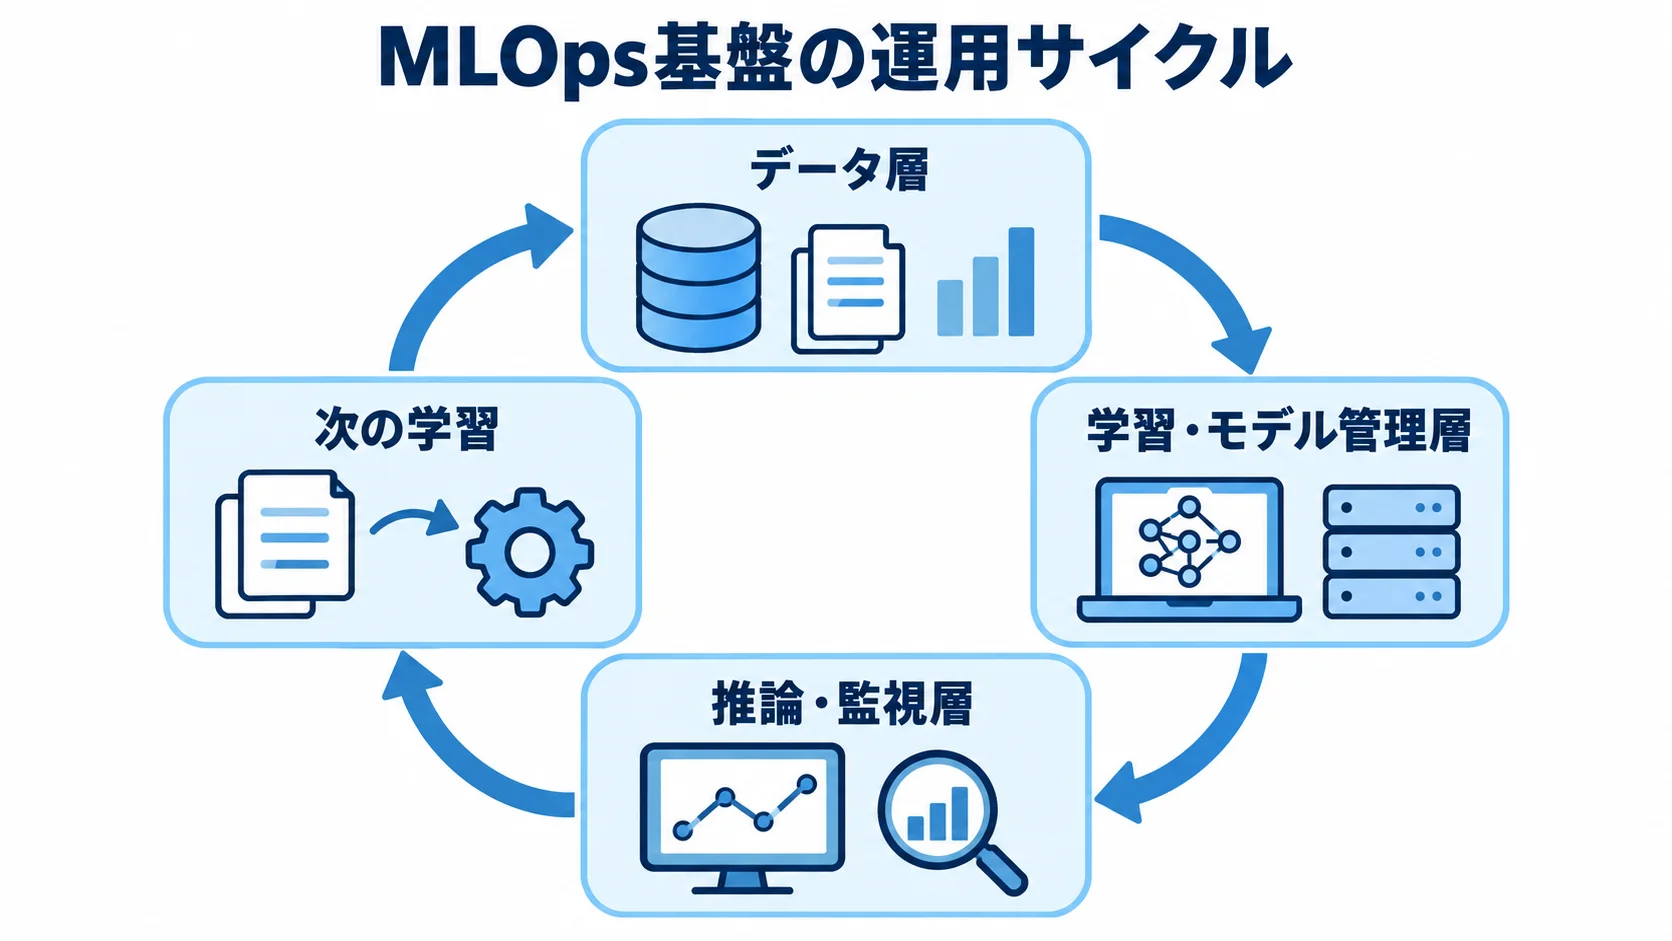
MLOps基盤は、データからモデルを作り、審査を経て推論サービスに出し、監視の結果を次の学習へ戻していく循環です。構成は、モデル数、更新頻度、リアルタイム性、機密性、運用人員に応じて選びます。全機能を最初から載せず、必要な部分から始めます。
データ層で管理する対象
データ層は、業務システム、センサー、ログからデータを取り込み、学習・検証・推論向けに加工します。
品質検査では、欠損や型の誤り、値の範囲を確かめます。重複や到着遅延、個人情報の混入も対象です。また、学習・検証データの作成条件、保存期間、ラベルの根拠も記録しておくと、モデルの判断を説明しやすくなります。
MLOps基盤の種類
構成を選ぶときは、運用人材や既存環境との接続を比べます。データの所在、移植性、費用の見通しも判断材料になります。代表的な種類は次のとおりで、特徴がそれぞれ異なります。
- マネージド・クラウド型:学習、モデル管理、推論、監視を早く組み立てられる。
- OSS・コンテナ型:オンプレミスやマルチクラウドで自由度が高い。
- データ基盤一体型:分析と機械学習の系譜を統合しやすい。
- 専用設計型:閉域網や既存基幹との複雑な連携に向く。
OSS型は、アップデートや脆弱性対応が必要です。また、クラウドの標準機能とOSSを組み合わせるハイブリッド構成も選べます。
将来の移行に備えるには、学習コード、モデル形式、メタデータ、監視ログを外へ出せるかを確認します。そうすると、特定の環境への依存を抑えられます。
学習・モデル管理層で管理する対象
学習・モデル管理層では、実験の条件と成果物を履歴として結び付けます。データの版、特徴量の生成、アルゴリズム、ハイパーパラメータを記録し、評価、実行環境、作成者もあわせて残します。
モデルレジストリでは、開発中、検証済み、本番承認済み、停止などの状態を管理します。また、再現には、モデルファイルに加えて、データやコード、ライブラリの版も残す必要があります。版が異なると結果が変わるため、系譜を追います。
さらに、生成AIでは、プロンプトや検索文書、埋め込みを管理します。評価用の質問と安全性の判定も対象です。
推論・監視層の確認項目
業務の許容時間やデータ量に合わせて、応答の返し方を選びます。
- オンライン推論:要求ごとに結果を返す。
- バッチ推論:データをまとめて処理する。
- 非同期推論:結果を待たずに要求を受け付ける。
新旧モデルは、カナリアリリースやA/Bテストで比べてから、全量へ切り替えます。障害時に直前のモデルへ戻すロールバック手順も、デプロイ機能と同じレベルで準備します。
監視では、エラー率と応答時間に加えて、入力の分布、予測の偏り、実績値との差も見ます。なお、公式資料は、ドリフト、データ品質、性能を分けて、基準データやしきい値アラートで確認する考え方を示しています(出典:モデル監視の公式ドキュメント、2026年確認)。
MLOps基盤の導入・開発の進め方
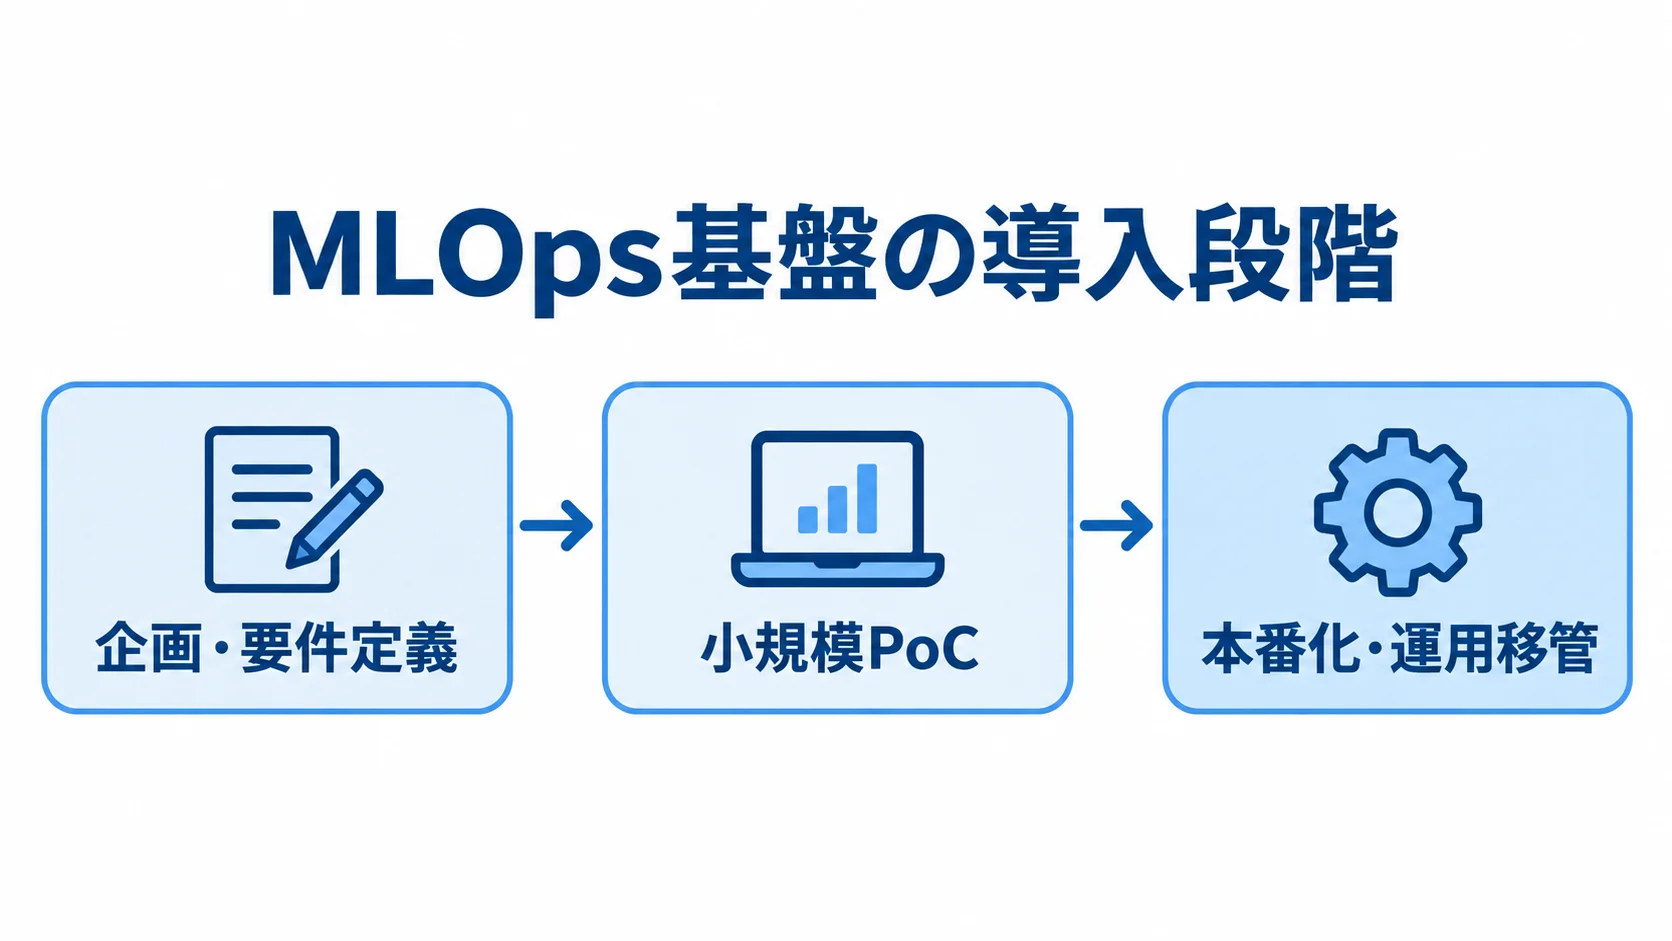
導入は、ツール選びからではなく、業務KPIと失敗の条件を定めるところから始めます。代表モデルで検証し、再現性、デプロイ時間、アラート、月額費用を測ってから、対象を広げます。
企画・要件定義で決める項目
まず、モデルの精度を業務成果に翻訳して考えます。企画・要件定義では、その業務KPIとデータ・機能要件を整理します。
- 業務KPI:誤検知率、見逃し率、レイテンシー、1,000件あたりの推論費、再学習頻度。
- データ要件:所在、更新頻度、ラベル作成、個人情報・機微情報、保存期間、利用目的、接続方式。
- 優先度:必須のMUST、希望するWANT、将来検討に分けます。
また、削減できる作業時間や、売上・損失への影響も測ります。精度が1ポイント上がっても、応答が遅く担当者が使わなければ、価値にはなりません。
優先度を分けずに全社向けの機能を盛り込むと、費用と期間が膨らみやすくなります。
小規模PoCの検証項目
代表1モデルを選び、4〜8週間を目安に工程を一周させます。PoCでは次の流れを動かし、精度以外の運用性も確かめます。
- データの取り込みと前処理
- 学習・評価の実施とモデルの登録
- 手動承認付きのデプロイと基本監視
同じデータとコードから結果を再現できるか、更新時間を測れるか、担当者以外も運用できるかを確認します。
終了条件には、再実行できる学習とデプロイ、評価基準を下回るモデルを止める仕組み、監視アラート後の調査手順を置きます。加えて、開発環境の自動停止で予算上限を守れるかも確かめます。
技術検証と並行して、運用担当者が手順書を使えるかも見ておきます。
本番化・運用移管で整える項目
本番化から運用移管までに整える内容を、環境、再学習、監視、承認に分けて確認します。
- 本番環境:環境の分離、権限、秘密情報、ログ、承認フローの整備。
- リリース前:データ品質、性能、負荷、復旧、ロールバック、個人情報のテスト。
- 再学習:定期実行に加え、ドリフト、ラベルの蓄積、業務イベントを契機にする。
- 運用レビュー:精度、ドリフト、推論費、レイテンシー、インシデント、更新履歴の月次確認。
自動再学習でも、評価やデータ品質を見ずに本番へ出すと、誤ったデータを学んだモデルが連鎖的にリリースされます。このため、自動化と人の承認の境界を明確にしておきます。
MLOps基盤の費用相場とコスト内訳
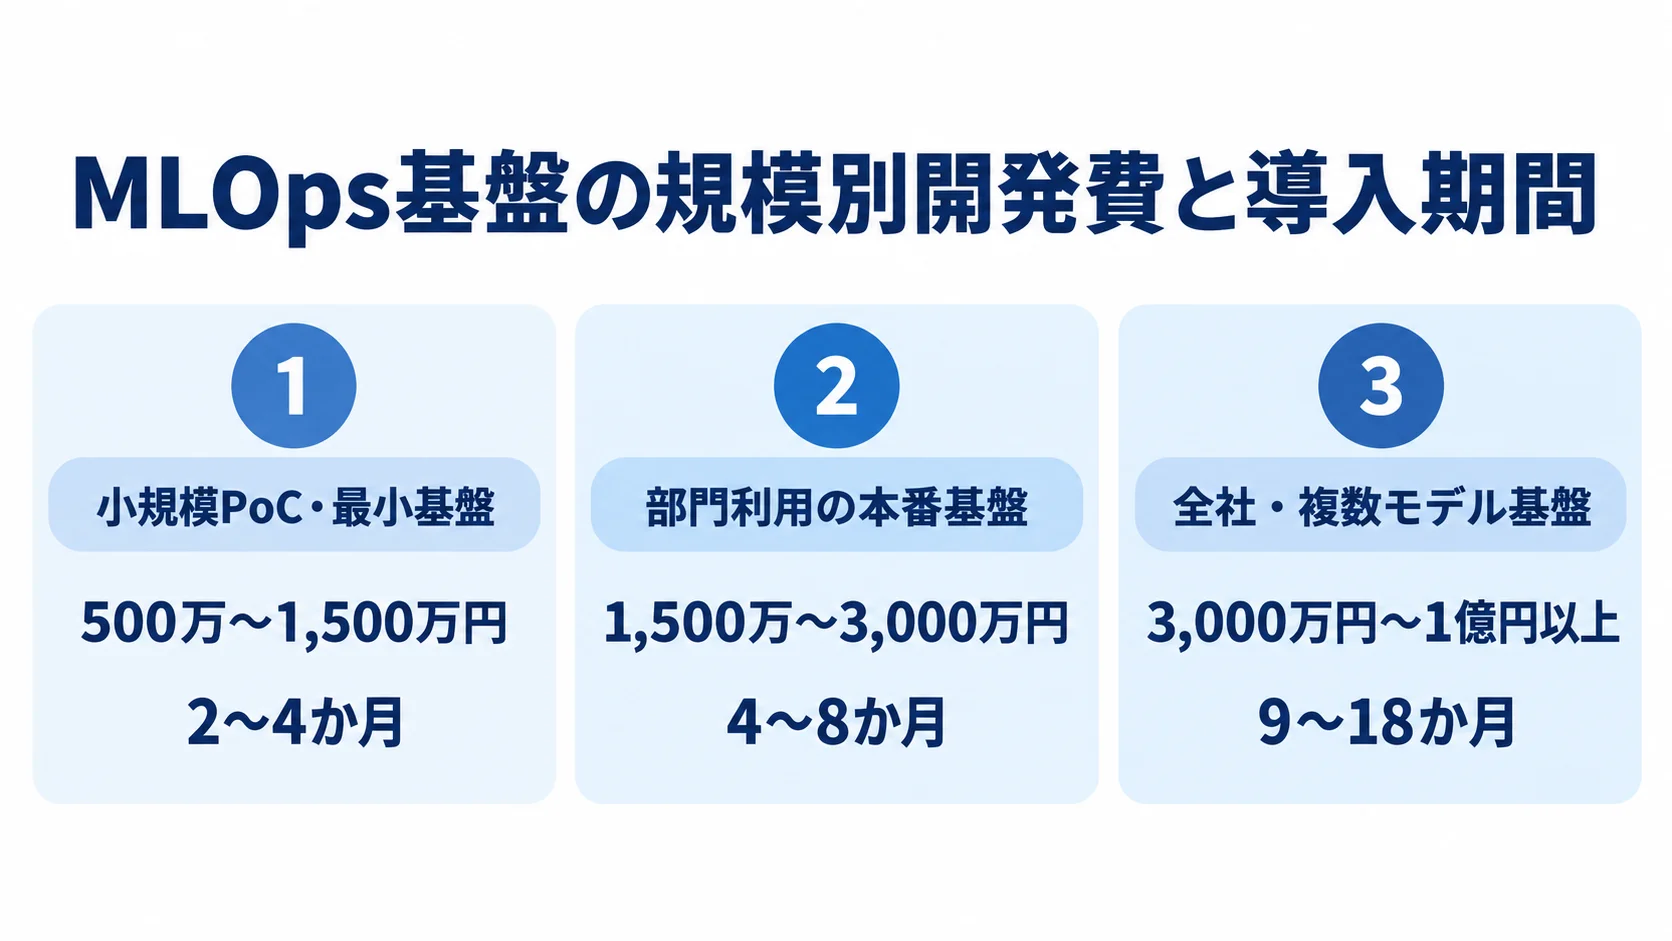
MLOps基盤に国内で一律の標準価格はありません。費用は、データ量、モデル数、GPUの利用時間、推論方式で変わります。
さらに、可用性、既存連携、監視・セキュリティの範囲も費用に響きます。そのため、開発費とクラウド・運用費を分けて考えます。
以下の開発費は、公開されたMLOps単体の統計ではなく、構成要素から算出した編集部推定です。
▶ 詳細はこちら:MLOps基盤開発の見積相場や費用/コスト/値段について
規模別の開発費の目安
開発範囲の規模に応じて、費用と導入期間が変わります。
- 小規模PoC・最小基盤:500万〜1,500万円、2〜4か月。
- 部門利用の本番基盤:1,500万〜3,000万円、4〜8か月。
- 全社・複数モデル基盤:3,000万円〜1億円以上、9〜18か月。
小規模の場合は、既存クラウドで1モデルを対象に、学習パイプライン、モデルレジストリ、手動承認付きデプロイ、基本監視を扱います。目的は、再現性と運用方法の確認です。
部門本番では、複数環境とデータ検証、CI/CD・継続学習、オンライン推論を含みます。さらに、ドリフト監視、アクセス制御、監査ログ、既存基盤との連携も対象になります。
全社基盤で、セルフサービス、GPU最適化、複数リージョン、厳格な承認、24時間運用まで含めると、設計と移行の工数が増える場合があります。
クラウド・運用費の月額目安
クラウドと監視の月額目安は、規模や稼働条件によって異なります。
- 小規模:10万〜50万円。
- 部門本番:50万〜300万円。
- 高負荷構成:GPU常時稼働、大量推論、複数リージョンでは300万円超の場合があります。
保守人件費、モデル改善、アノテーション、業務側の検証費は含みません。GPU費は利用時間と台数で変わるため、開発時だけの起動と本番の常時稼働を分けて試算します。
2026年確認の公式料金例では、GPUを月120時間使う開発環境は88.368米ドル、約1.3万円です。実験管理サーバーを月160時間使う例は合計262.60米ドル、約3.9万円です。GPUを4台で30日稼働させる例は29,374.40米ドル、約440.6万円です。
なお、米ドルは1ドル=150円で概算した参考値です。リージョン、為替、割引、ストレージ、転送、監視は別途です(出典:クラウド事業者の公式料金表、2026年8月確認)。
見積書の記載項目
見積書では、開発作業を分けたうえで、対象範囲、前提のデータ量、モデル数を記載します。さらに、期間、納品物、対象外も書きます。項目別にすると、追加費用が発生しやすい箇所を把握できます。
- 要件定義・設計:要件整理とアーキテクチャ設計。
- データ・モデル:データ整備・連携、学習パイプライン・モデル管理。
- 推論・運用:推論アプリ連携、監視・セキュリティ。
- 移行・支援:テスト・移行、教育・保守。
初期費用のほか、月額の費用も並べます。月額では、推論エンドポイントとストレージの費用が対象です。ほかの項目も月額の対象です。
- ログ・転送
- 監視
- バックアップ
- ライセンス
- 運用人員
自動停止、予算アラート、部門別タグ、バッチ推論への切り替え条件を要件化すると、稼働後の予算超過を抑えやすくなります。
MLOps基盤の開発会社・ベンダーの選び方
発注先は、AIモデルの開発力に加えて、データから運用までを仕組みとして作れるかで比べます。マネージド基盤、データ基盤一体型、OSS・コンテナによる専用設計など、提供者ごとに得意な領域が異なります。
実績の確認方法
判断材料にしたいのは、「AIの実績」の有無よりも、本番稼働まで届いた経験です。そのうえで、データ品質検査、モデルレジストリの有無を確認します。さらに、再学習、ロールバック、稼働後の監視・障害対応も見ます。
可能であれば、構成図のほか、監視画面、アラートから復旧までの手順、納品パイプラインのサンプルを見せてもらいます。
事例では、業界やモデルに加えて、データ量、更新頻度、推論方式を確認します。SLA、体制、導入後の改善指標も見ます。業務課題が違っていても、更新頻度や機微情報、基幹連携の難しさが近いかを見ます。
技術力と運用力の見極め方
見るべきは、機能の数よりも、既存基盤との接続と再現性、移植性です。さらに、監視や監査ログ、権限、障害復旧の備えも見ます。構築と運用の担当者は異なる場合があるため、手順書、教育、相談窓口、夜間対応、SLAの有無も見ます。
コード、データ、モデル、実験履歴の所有者と、他環境へのエクスポートの可否を確認します。契約終了時のデータ返却や削除の形式も、確認事項です。
特定のサービスに依存する場合も、学習コード、モデル形式、メタデータ、監視ログを移行できる出口を設計すると、将来の選択肢を残せます。
提案依頼書の記載項目
各社が同じ前提で提案と見積もりを出せるよう、RFPには目的・対象から検証・移管まで、次の5つの観点で条件を書きます。
- 目的・対象:対象モデル、業務目的、データ量、更新頻度。
- 推論・運用:方式、許容レイテンシー、月間要求数、再学習条件、監視項目。
- 管理条件:ログ保持、個人情報、データ所在、費用上限、保守範囲。
- 成果物:構成図、データフロー、パイプライン、モデルレジストリ、監視画面。
- 検証・移管:テスト結果、手順書、障害連絡網、費用試算、内製化計画。
未決の事項は、「提案してほしい前提」として分けて書きます。本番後の再学習の判断者、しきい値の変更の可否、障害時に旧モデルへ戻す所要時間も質問しておくと、提案の実効性を見極めやすくなります。
▶ 詳細はこちら:MLOps基盤開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:MLOps基盤開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:MLOps基盤開発の発注/外注/依頼/委託方法について
セキュリティ・法規制・ガバナンスの考え方
MLOpsでは、APIだけでなく、学習データやラベル、特徴量、モデルも管理対象になります。プロンプトやRAGのデータ、推論ログ、クラウドの権限、CI/CDの秘密情報も含まれます。
役割ごとに必要最小限の権限を設計します。そのうえで、開発者が本番データへ直接アクセスしない仕組みも検討します。
学習データと個人情報の保護
学習の前に、利用目的と取得時の説明、同意や契約を確認します。委託先、保存場所と期間、削除方法も確かめます。
匿名化や仮名化の後も、再識別の可能性が残る場合があります。そのため、項目の削減、アクセス制限、ログ記録、持ち出し審査を組み合わせます。
本番ログに入力や生成結果を保存する場合は、記録する項目とマスキングの方針を決めます。評価用データと本番データは分けておきます。再学習データの承認や、第三者へ渡す範囲も契約で明確にします。
監査・説明可能性の記録項目
監査と説明に必要な記録は、再現履歴と利用判断に分けて残します。
- 再現履歴:データ版、学習コード、実行環境、モデル版、評価指標。
- 利用履歴:承認者、リリース日時、推論時の入力・結果、変更履歴。
- モデルの説明:用途、限界、想定外の利用、性能のばらつき。
判断に使ったモデルが後から分からないと、事故の調査や顧客への説明ができません。モデルカードやリスク評価票に、情報を記載します。
国内でAIを事業に組み込む場合は、2025年3月28日公表のAI事業者ガイドライン第1.1版などを確認します。そのうえで、人間による監督、透明性、プライバシー、安全性、セキュリティ、検証可能性を業務要件に反映します(出典:経済産業省のAI事業者ガイドライン、2025年3月)。
生成AIのMLOpsで追加される項目
生成AIでは、従来の精度に加えて、出力の正確性や安全性を評価します。そのため、MLOpsには5つの項目が追加されます。
- 出力評価:プロンプト、検索結果、参照文書、正確性、根拠性、有害性。
- 安全性:個人情報の露出と、拒否すべき質問への応答の確認。
- RAGの版管理:文書の更新・分割・埋め込み・検索順位を追跡し、モデル変更と分けます。
- 人の確認:重要業務でサンプルを確かめ、しきい値未満なら停止して、危険な回答を人へ引き継ぐ。
- フィードバック:利用者の声を再評価に戻し、MLOpsの循環に組み込みます。
よくある失敗例と導入効果を測るKPI
失敗は、機能の不足よりも、目的と運用のずれから起きがちです。導入前に、自動化と人の承認の範囲、効果を測る数値を決めておくと、基盤が使われない事態を防ぐ助けになります。
いきなり全社共通基盤を作る失敗
多数のモデル、複数チームのセルフサービス、Feature Store、マルチリージョン、24時間運用を最初から含めると、完成前に要件が変わる可能性があります。
代表モデルで再現性、承認、監視、復旧を検証し、利用するチームが増えた段階で共通化すると、実際の利用に合わせて投資できます。
精度だけを監視する失敗
本番では、正解ラベルをすぐに得られない場合があります。そのため、精度だけを見ていると、劣化を見逃すおそれがあります。
欠損率や型エラー率、分布の変化、予測の偏りを監視します。レイテンシー、エラー率、推論費も見ます。ラベルが揃ったら、実績ベースの性能を確認します。
導入効果を測るKPI
技術、業務、費用のKPIを組み合わせると、基盤の運用効果と事業への影響を追えます。
- 技術:再現成功率、学習からデプロイまでの時間、承認待ち、失敗率、ロールバック、アラート検知、再学習完了時間。
- 業務:誤検知対応工数、処理時間、予測を使う意思決定の割合、売上や損失への影響。
- 費用:モデル1,000件あたりの推論費、アイドル時間、GPU利用率、ログ・ストレージ増加率。
導入直後にすべての数値を改善できなくても、現状の値を測れること自体が成果です。月次で数値を比べ、モデルやデータの変更と結び付けると、継続投資を判断しやすくなります。
MLOps基盤についてよくある質問
MLOps基盤は、費用や体制、データ管理にも関わります。導入前によく寄せられる疑問を、次に取り上げます。
MLOps基盤は小規模なチームでも必要ですか?
モデルが一つでも、再現性、承認、監視、ロールバックの最小限の機能を整える価値があります。大規模な基盤は必ずしも必要ではなく、既存のクラウドやOSSで履歴を残すところから始められます。
パッケージとスクラッチ開発はどちらが良いですか?
短期間で標準機能を使うなら、マネージドサービスや既存パッケージが候補になります。データの所在、ネットワーク分離、基幹連携、独自の承認が厳しい場合は、専用設計が選択肢になります。
二者択一とは限らず、標準の学習・推論機能と専用のデータ連携・監査を組み合わせる方法もあります。
MLOps基盤の費用を抑える方法はありますか?
代表1モデルで始め、開発環境は自動停止にして、GPUは実験時だけ起動します。バッチ推論とオンライン推論を使い分けることも、不要な稼働費を抑える方法です。
ログやデータの保存期間、監視の頻度、可用性は業務の重要度に合わせます。初期費用だけでなく、月額の上限と費用アラートも要件に含めます。
再学習は自動化すべきですか?
再学習そのものは自動化できますが、本番反映まで無人にするかは、業務リスクで判断します。
データ品質、評価指標、ドリフト、費用、説明可能性を確認し、条件を満たすモデルだけを承認すると、安全性と更新の速さを両立しやすくなります。
まとめ
MLOps基盤は、まずデータ、実験、モデルを記録して管理する土台です。その上で、デプロイ、推論、監視、再学習をつなぎ、モデルを本番で使い続けられるようにします。精度だけでなく、再現性、ドリフト、レイテンシー、推論費、監査、復旧も要件に含めます。
まず作るべき最小基盤
全社共通の大規模基盤を急がず、代表1モデルで、データ検査、実験履歴、承認、デプロイ、監視、旧モデルへの復旧を一周させます。
PoCで運用の現実を把握し、チームやモデルが増えた段階で共通化すると、過剰投資や使われない機能を減らせます。
発注前に決める項目
発注前に決めるのは、対象モデル、業務KPI、データ量と更新頻度、推論方式です。さらに、監視、セキュリティ、費用上限、成果物、保守範囲も整理します。
提案では、継続改善の体制、費用の可視化、障害復旧、内製化と移行のしやすさを確認します。MLOps基盤は、導入後も業務の変化に合わせて改善する仕組みです。
▼関連記事一覧
・MLOps基盤開発の進め方/やり方/流れや方法/手法/工程/手順
・MLOps基盤開発でおすすめの開発会社/ベンダー6選と選び方
・MLOps基盤開発の見積相場や費用/コスト/値段について
・MLOps基盤開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。