
MLOps基盤開発は、業務課題とKPIを整理し、代表モデルで検証してから段階的に展開する順で進めます。この順に進めると、過剰投資を防ぎながら運用に定着させられます。
基盤の全体像を押さえると、フェーズごとに何を決めればよいかが見えてきます。
▼全体ガイドの記事
・MLOps基盤開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLOps基盤の全体像
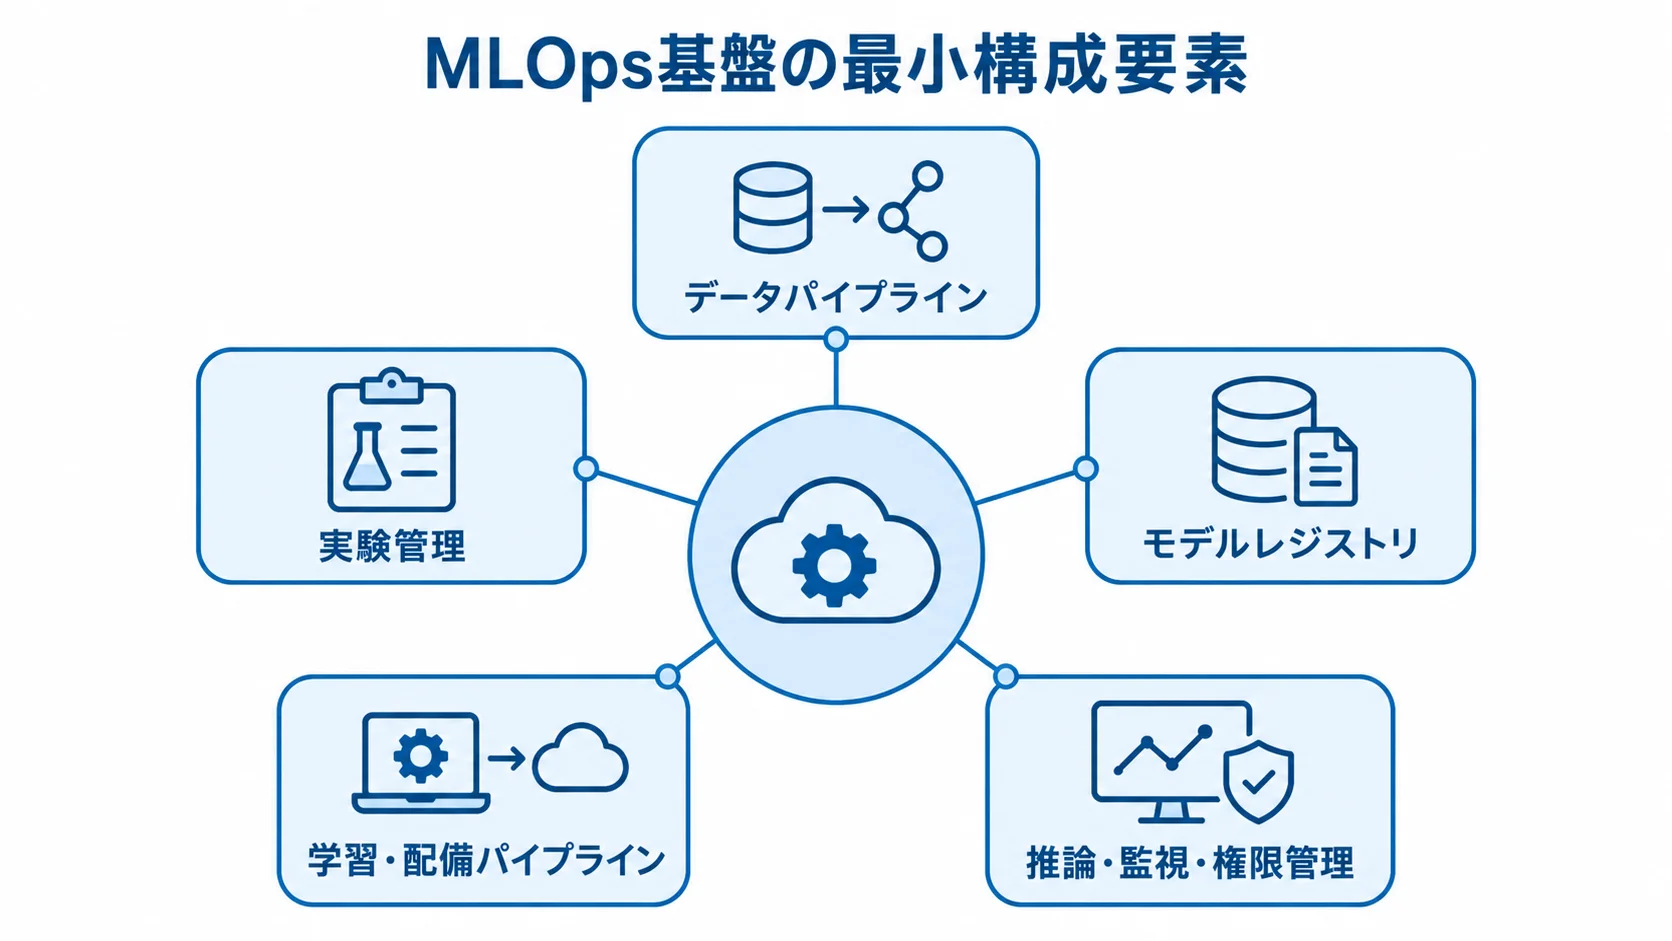
MLOps基盤は、データの取り込みから再学習までを継続的に管理・自動化する仕組みで、学習、評価、承認を中心に、デプロイ、推論、監視も一つの流れとして扱います。単独のモデルやJupyter Notebook、推論APIだけでは、データとモデルの履歴を追跡できないため、実務上のMLOps基盤とは呼びにくいです。
モデル開発と運用をつなぐ役割
通常のアプリケーションでは、主にソースコードと実行環境をテストしてリリースします。一方で、機械学習では、同じコードでも学習データが変わればモデルの挙動が変わります。そのため、情報を記録し、同じ条件で再現できる状態を作っておく必要があります。
- データ:スキーマ、欠損、特徴量、学習に使った入力の記録
- 実験:評価指標と条件の保存
- モデル:版の情報と実行環境の記録
- 運用工程:検証、テスト、分析、サービング、監視の一連の流れ
Google Cloudの公式アーキテクチャは、データ検証やテストから、メタデータ管理、サービング、監視までを示しています。さらに、CI・CDと継続トレーニング(CT)も含まれます。
出典は、Google Cloudの「MLOps: Continuous delivery and automation pipelines in machine learning」(2024年のレビュー)です。
MLOpsは、機械学習システムを継続運用するための開発・運用方法で、ツールの名前ではありません。
最低限そろえる構成要素
最小構成では、継続運用に必要な機能を次のようにそろえます。
- データパイプライン:取り込み、加工、スキーマ検証の処理
- 実験管理:ハイパーパラメータ、使用データ、コード、評価結果の保存
- モデルレジストリ:性能、承認状態、依存ライブラリ、作成者の記録
- 学習・配備パイプライン:学習とデプロイの手順の管理
- 推論・監視・権限管理:本番稼働とアクセスの管理
モデルレジストリには、学習データとの系譜も持たせます。たとえば、最初は1モデルで、誰がどのデータとコードを使い、どの評価結果を根拠にどの環境へ出したかを追跡します。
全社展開を見据える場合でも、Feature Store、マルチリージョン、セルフサービス環境を一度に作る必要はありません。そのうえで、必要な共通機能を見極めれば、過剰投資を防げます。
精度以外のKPI
本番運用では、精度だけを追うと判断を誤ります。そのため、業務への影響も含めたKPIを設定します。
- 処理性能:推論レイテンシーとエラー率の測定
- 運用費:1,000件あたりの推論費の確認
- 更新効率:再学習時間と、更新からリリースまでの時間の測定
- 業務効果:誤検知による損失と担当者の削減工数の把握
たとえば、需要予測では平均絶対誤差に加えて、欠品率や在庫金額も評価します。予測作成にかかる時間も、あわせて見ます。
MLOps基盤開発の進め方(6フェーズ)
開発は6つのフェーズで進めます。各フェーズで成果物と判断基準を決めておくと、精度だけで判断したり、運用費を見ないまま本番に入ったりするリスクを抑えられます。
- 業務目的と対象モデルの整理
- サービス、技術、開発会社の選定
- 再現性と監査性を備えた設計・開発
- データ、モデル、運用のテスト
- 監視と費用管理の開始
- 利用部門と運用担当者への定着
フェーズ1:要件整理と業務目的・対象モデルの決定
最初に決めるのは、機能よりも解決すべき業務課題です。要件整理では、次の項目をそろえます。
- 業務と利用者:対象業務、利用者、予測や生成の出力、判断を担う人、接続点
- データとモデル:入力、モデル数、学習の頻度、データの所在、ラベルの作り方
- 性能と運用:精度、処理時間、同時実行数、稼働時間帯、更新頻度、代替運用
- 制約と費用:オンライン・バッチ推論、SLA、保存期間、個人情報、運用担当、費用上限
許容できる誤りや、現行DWH・ETLとの連携も確認しておきます。要件の膨張を防ぐため、MUSTとWANTを分け、初回は1モデル・1業務に絞ります。
業務フローやデータ項目一覧、KPI定義を文書にまとめます。現状課題、対象範囲、非機能要件も書き出し、選定や見積もりの共通の前提にします。
フェーズ2:クラウド・製品・開発会社の選定
選定では、機能の数よりも既存環境との接続と運用責任を比べます。そのうえで、クラウドやデータ基盤に合うサービスを候補にします。
- AWS利用中:候補はAmazon SageMaker AI
- BigQuery中心:候補はVertex AI
- Microsoft 365やEntra IDと統合:候補はAzure Machine Learning
- データレイクハウス中心:候補はDatabricks
オンプレミスや閉域網、複雑な基幹接続がある場合は、国内SIerの設計・移行・運用体制も比べます。
候補先には、同じ条件で、構成図、採用サービス、データとモデルの移行方法を示してもらいます。あわせて、監視画面と障害時のロールバックも確認します。
各社には、1か月の費用試算、運用分担表、内製化支援の範囲も依頼します。
実績は、AI開発の件数よりも、継続学習や運用移管まで扱ったかで確認します。モデルレジストリ、ドリフト監視、SLAの実績も見ます。
特定のベンダーに依存する場合は、契約前に、コード、データ、モデルの所有権とエクスポート方法を確かめます。
フェーズ3:設計・開発での再現性と監査性の確保
設計・開発では、次のように再現性と監査性を組み込みます。
- 環境・版管理:開発・検証・本番の分離と、データや特徴量、コード、コンテナ、モデル、設定値の版管理
- データ検証:スキーマ、欠損、外れ値、値の範囲の確認と、条件外のときの学習停止と通知
- 学習と承認:準備から特徴量生成、学習、評価、登録、承認、デプロイまでの手順の定義
- 安全な配備:一括切り替えのほか、カナリア、A/Bテスト、失敗時のロールバックの想定
- 生成AI・RAG:プロンプト、参照文書、埋め込み、評価データ、安全性評価の追跡
モデルレジストリの状態と権限を連動させることで、承認前のモデルが本番に出ないようにします。
成果物は、アーキテクチャ図、データフロー、リポジトリです。そのうえで、パイプライン定義や権限一覧、モデル台帳、運用設計書も含めます。
フェーズ4:データ・モデル・運用のテスト
アプリケーションの単体テストだけでは確認しきれません。そのため、データやモデル、運用まで一連の流れで検証します。
- データ:スキーマ変更、欠損率、学習時と推論時の差異
- モデルとAPI:性能、互換性、処理時間、負荷の確認
- 運用:権限、監査ログ、障害復旧の確認
新モデルは全体の精度が高くても、特定の顧客層だけ性能が落ちることがあります。そのため、データをセグメントごとに分けて評価します。
受け入れテストでは、業務担当者が想定した判断に使えるかを見ます。学習の再実行や、基準に届かない場合のデプロイ停止も確認します。
承認者の記録と旧モデルへの切り戻しをテストし、監視アラートや再学習の起動も対象にします。個人情報のマスキングとログ保存期間も含めます。
合格基準は、運用の行動まで具体的に決めます。たとえば、15分以内のアラート確認や、30分以内の旧モデルへの復帰を定めます。
フェーズ5:稼働後の監視と費用管理
稼働後は、インフラの監視とモデルの監視を分けて考えます。そのうえで、運用で確認する項目と対応を整理します。
- インフラ:CPU・GPU使用率、メモリ、レイテンシー、エラー率、キュー、エンドポイント稼働状況
- モデル:入力・予測の分布、データ品質、正解データがあれば精度・再現率
- 対応手順:通知先、一次対応者、エスカレーション、暫定対応、ロールバック条件
- 費用管理:開発環境停止、GPU時間制限、タグ別予算集計、予算アラート
- 推論方式:業務要件に合わせた、バッチとオンラインの使い分け
Azure Machine Learningの公式資料は、データや予測のドリフト、データ品質、モデル性能などを監視の信号として整理しています。
出典は、Microsoft Learnの資料「Model monitoring in production」で、2026年8月の確認です。
運用を始める時点では、重要度の高い特徴量に絞ります。また、監視の頻度は、日次・週次・月次から妥当なものを選びます。
フェーズ6:定着に向けた利用部門と運用担当の育成
基盤を定着させるには、責任分界と運用レビュー、実地での引き継ぎが欠かせません。
- 責任分界:データ品質の一次担当、モデル承認者、監視担当、業務判断者、ベンダー対応時間の整理
- 月次レビュー:精度、ドリフト、推論費、再学習回数、障害、手動作業時間の確認
- 内製化:担当者によるモデル登録、実行、監視、障害対応、費用確認の操作
- 引き継ぎ:模擬障害を行い、担当者だけで復旧できるかの確認
- 機能拡張:利用モデルや部門が増えてからの、共通テンプレートやセルフサービス機能の追加
月次レビューで出た改善テーマは、次のスプリントにつなげます。手順書の納品だけでは、引き継ぎを終えたことにはなりません。
MLOps基盤開発の費用相場とコスト内訳
MLOps基盤は複数の機能で構成されるため、単一の定価では比較できません。ここで示す開発費は、クラウド利用料とAI・業務システム開発の要素をもとにした編集部の推定で、公的な標準価格ではありません。
費用は、モデル数やデータ量、リアルタイム性によって変わります。既存環境や規制要件、運用体制でも変わるため、見積もりでは前提条件も確認します。
初期開発費の目安(500万円〜1億円以上)
初期費用は、PoCから全社基盤まで、どこまでの機能と運用範囲を作るかで開きます。そのため、規模ごとの費用と期間を並べて比べます。
- 小規模PoC・最小基盤:500万〜1,500万円、2〜4か月。
- 部門本番:1,500万〜3,000万円、4〜8か月。
- 全社・複数モデル:3,000万円〜1億円以上、9〜18か月の可能性。
PoCでは、既存のクラウド上に1モデルの学習パイプラインとレジストリを置きます。手動承認付きの配備と基本監視も整えます。再現性と手順を作りながら、KPIと月額費用を実測する段階です。
部門本番には、複数環境とデータ検証、CI/CDとCT(継続トレーニング)が含まれます。さらに、オンライン推論やドリフト監視、IAMと監査ログも含まれます。DWHや業務システムとの連携も入ります。
全社基盤で複数チームのセルフサービスを扱い、Feature StoreやマルチリージョンやGPU最適化まで行うと、要件が増えます。加えて、厳格な承認や24時間運用も、人員と費用を押し上げます。
クラウド利用料を左右する稼働時間とGPU
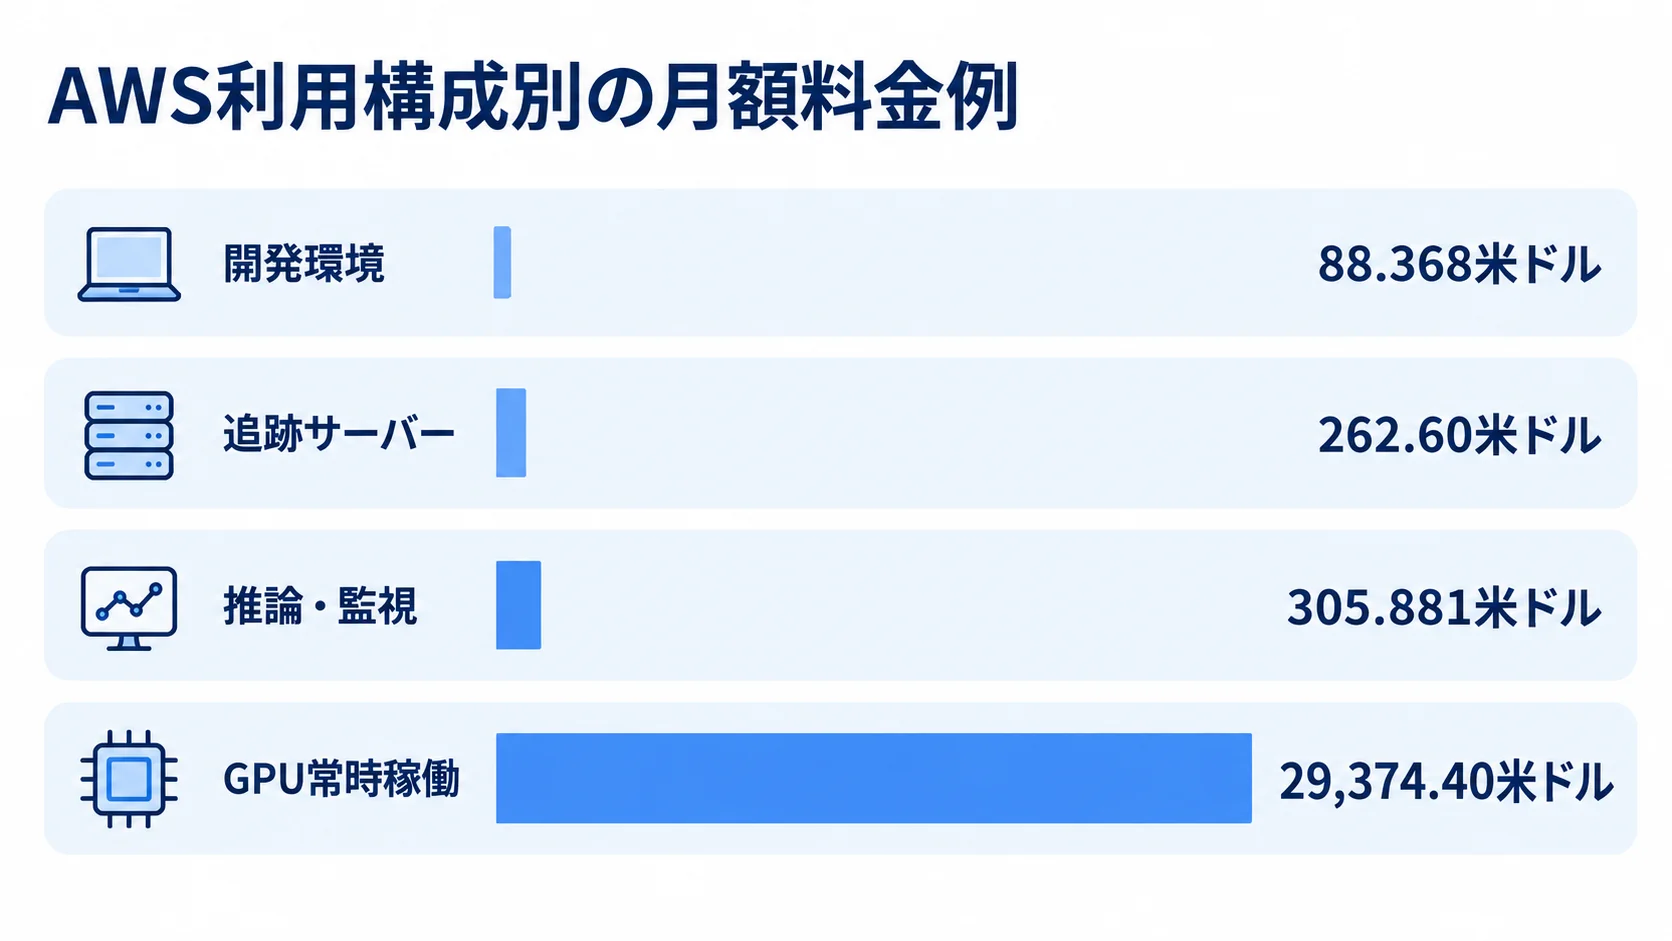
AWSの料金例を、開発・追跡・推論・GPU常時稼働の構成ごとに比べると、稼働規模による差が見えてきます。
クラウド費は、計算資源とGPU、ストレージ、データ処理・転送の費用を積み上げて決まります。さらに、推論や監視、ログ、モデル評価も積み上がります。
- 開発環境:ml.g4dn.xlargeを月120時間使うと88.368米ドル。
- 追跡サーバー:MLflow Tracking Serverは月額262.60米ドルの例。
- 推論・監視:ml.c5.xlarge 2台でリアルタイム推論を行い、監視も含めた例は月305.881米ドル。
- GPU常時稼働:ml.g5.24xlarge 4台を30日使う例は29,374.40米ドル。
料金例の出典は、AWS「SageMaker Pricing」(2026年8月確認)です。
1ドル150円の仮換算では、上から順に約1.3万円、約3.9万円、約4.6万円、約440.6万円です。
リージョンや為替、契約割引、周辺サービスの費用は、この例とは別に見る必要があります。GPUの例には、設計やデータ準備、人件費も含まれていません。アノテーションやアプリ連携も、この例には入っていません。
AWS事例では、Forethought Technologiesがマルチモデルエンドポイントで最大66%削減しました。また、サーバーレス推論では、関連クラウド費を約80%削減しました(出典: AWS「Forethought Technologies case study」、2026年確認)。
どちらも、モデルやトラフィックが異なる企業にそのまま当てはまる数字ではありません。
規模ごとの月額費用の目安(10万円〜300万円超)
月額費用の目安と、運用費を抑える方法を整理します。
- 小規模:クラウド・監視費は月10万〜50万円。
- 部門本番:月50万〜300万円が目安。
- 高負荷:GPU常時稼働などで月300万円超の可能性。
- 稼働の調整:開発環境停止、スポット・予約、推論方式の検討。
- 共有・保存:複数モデルの共有、ログ保存期間の見直し。
保守担当者やデータ品質対応の人件費は、別に計上されます。見積書では、開発費と運用費を分けたうえで、通常月や繁忙月、再学習月、障害時の増分も示してもらいます。
不要なデータの複製も削減の対象です。そのうえで、停止時の売上への影響や復旧時間、監視漏れによる誤判定の損失まで含めて、総保有コストを比べます。
MLOps基盤の見積もりで確認するポイント
金額だけで比べると、監視や運用移管が抜けた提案を見落とすことがあります。そのため、提案依頼書に条件を明記し、同じ前提で比べます。
提案依頼書には、対象モデル、データ量、更新頻度を書きます。推論方式、環境数、SLAも記載します。
そのうえで、監視項目とログ保持、セキュリティ、費用上限を含めます。成果物や保守範囲も入れます。
作業範囲と成果物の項目別の分け方
見積項目と成果物を分けておくと、作業範囲の抜けを見つけやすくなります。設計から保守まで、項目ごとに確かめます。
- 設計・連携:要件、アーキテクチャ、データ整備・連携。
- 機械学習基盤:学習パイプライン、実験管理、モデルレジストリ。
- 本番化:推論環境、CI/CD・CT、監視・アラート。
- 移行・運用:権限・監査、テスト、移行、教育、保守。
各項目について、対象外と前提条件、担当者を記載してもらいます。あわせて、納品物と検収条件も示してもらいます。
「監視対応」は、測定内容と間隔、閾値を確認します。そのうえで、通知先と通知後の対応まで確かめます。
成果物には、構成図、データフロー、データ項目・品質ルールを含めます。パイプライン定義やモデル台帳、評価レポートも求めます。
監視ダッシュボードやアラート一覧、ロールバック手順も求めます。権限一覧や運用手順書、費用試算、テスト結果も、あわせて出してもらいます。
引き渡し対象には、ソースコードに加えて、設定値やコンテナ定義を含めます。CI/CD設定、モデルとデータの対応関係も対象にします。
運用体制と保守費の初期確認
障害や精度の劣化に備えて、運用体制と保守範囲、ガバナンスを契約前に確かめます。
- 担当分担:データ品質、モデル承認、監視、業務判断、ベンダー対応時間
- 保守範囲:問い合わせ、障害・脆弱性対応、クラウド設定変更
- 継続支援:再学習、監視変更、月次報告、定例会、内製化支援
- 情報管理:利用目的、同意、匿名化、委託先、データ所在、ログ、保存、削除
担当はRACI形式などで整理しておきます。あわせて、保守費の対象と追加費用の条件も明確にします。
データの所在やアクセスログ、保存期間、削除方法も整理します。国内案件では、経済産業省・総務省のAI事業者ガイドライン第1.1版(2025年3月公表)などを参照します。
モデルの安全性と透明性、説明責任、セキュリティは、自社のリスクに合わせて具体化します。
複数社の提案の比べ方(同じ検証条件)
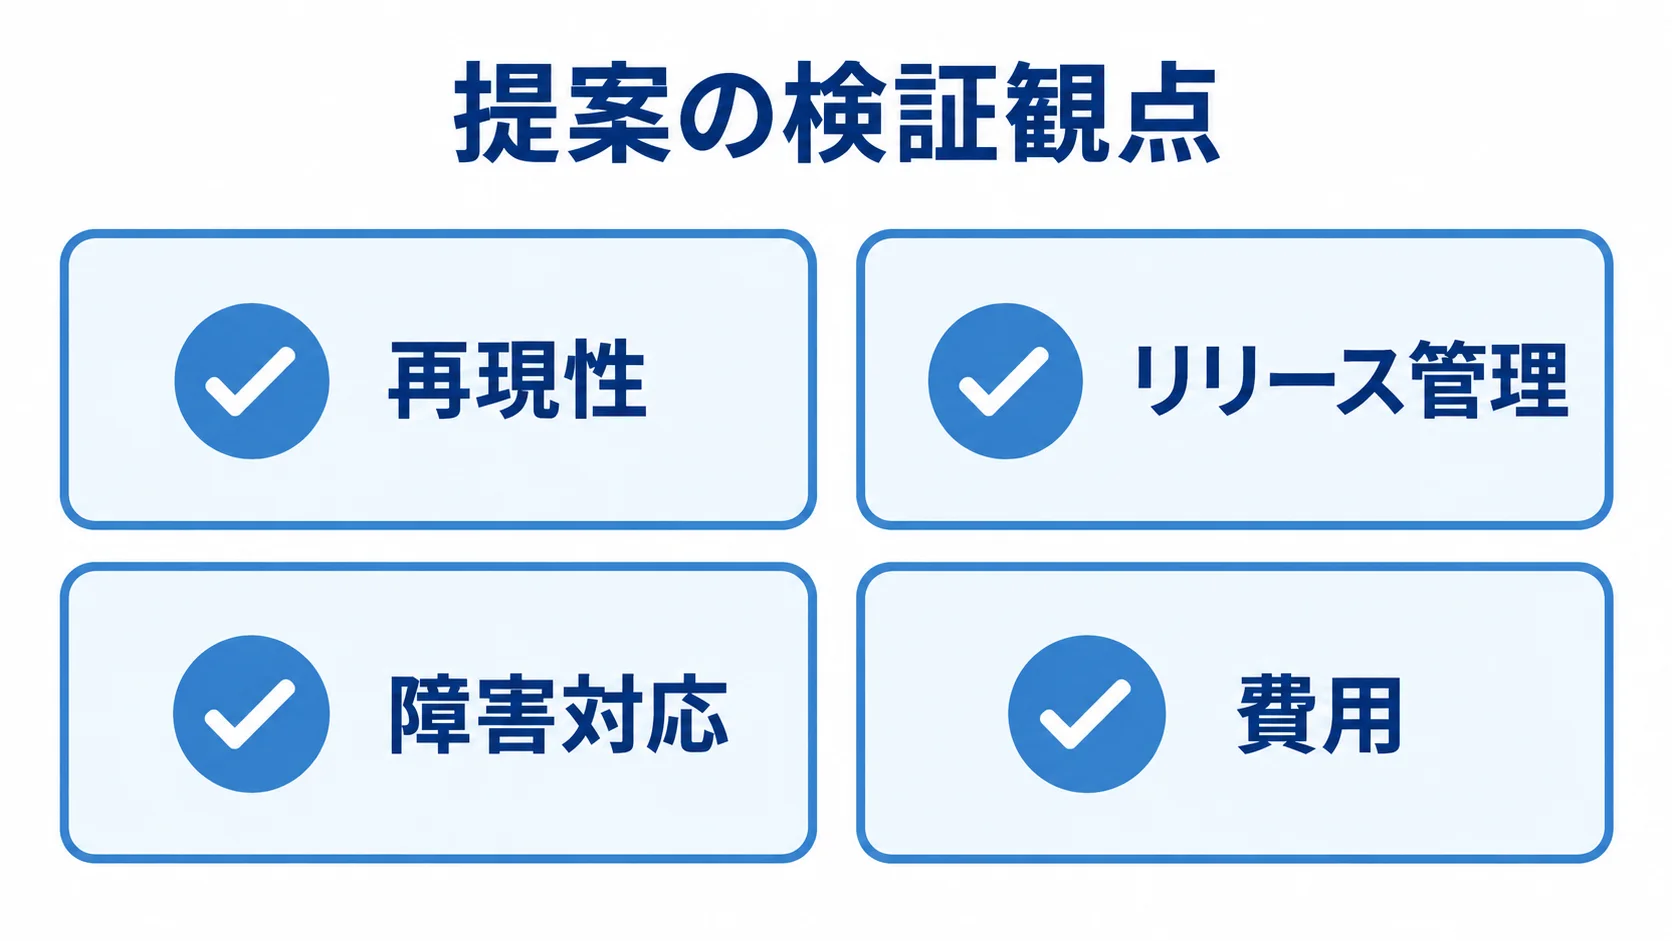
候補会社には、同じサンプルデータか仕様を渡し、代表モデルで短期検証を依頼します。精度だけでなく、運用性も評価します。
- 再現性:データを使った処理を再実行できるか
- リリース管理:モデル承認とデプロイを追跡できるか
- 障害対応:監視アラートとロールバックが機能するか
- 費用:毎月いくらかかるかを把握できるか
既存顧客の社名や導入件数を見ても、自社で再現できるとは限りません。データ量やレイテンシー、規制、運用体制の前提と、検証結果を合わせて見ます。
要件が固まった部分は請負、探索や変更が多い部分は準委任・アジャイルに分けるやり方もあります。
全社基盤を一括で固めると、要件変更が費用に響きます。そこで、小さな範囲で完了条件を決め、本番化の判断ゲートを設けます。
実測したKPIと運用費は、次フェーズの見積もりに反映します。検証結果は、段階的な発注判断にも使えます。
MLOps基盤開発でよくある質問
MLOps基盤は技術だけでなく、データ管理や業務運用、費用、組織体制にも関わります。そのため、発注前によく挙がる疑問も押さえておきます。
MLOps基盤は小規模に始めても問題ありませんか?
問題ありません。最初は1モデル・1業務に絞り、データとモデルの再現性と承認、デプロイを検証します。基本監視とロールバックも確かめます。
Feature Storeやマルチリージョンなどは、利用チームやモデル数が増え、共通化の効果が見えてから追加します。
クラウドとオンプレミスのどちらが向いていますか?
判断の材料は、既存クラウドやデータ所在、閉域網です。加えて、GPUの必要量や社内人材、規制要件も見ます。要件によって、適した構成は異なります。
- クラウド:マネージドサービスで短期導入しやすい一方、従量課金とロックインの管理を要します。
- オンプレミス:データやネットワークを制御しやすい一方で、GPU調達や保守、更新、監視を担う体制が欠かせません。
クラウドとオンプレミスは、二者択一で考える必要はありません。データは既存環境に置き、学習や推論はクラウドで行う構成も、要件に合わせて検討できます。
再学習は自動化すればよいですか?
再学習を自動化するなら、起動条件と本番反映の安全策を先に定めておきます。
- 起動条件:ドリフト検知、一定期間の経過、正解データの蓄積
- データと性能:データの検証と、ベースラインとの性能比較
- 配信管理:セグメント別評価と承認、カナリア配信、ロールバック
- 人の確認:重要業務での担当者による確認
ドリフトだけを条件に自動でリリースすると、品質の悪いデータでモデルを更新してしまう危険があります。
開発会社に見積もりを依頼するとき何を渡せばよいですか?
見積もりでは、業務やデータ、運用、予算の前提が分かる情報を共有します。
- 業務:仕事の流れ、対象モデル、利用者、目標KPI
- データと処理:項目と量、更新頻度、推論方式
- 環境と運用:既存システム、セキュリティ制約、運用体制
- 時期と費用:希望時期と予算上限
要件定義書がなくても、現状のNotebookやサンプルデータ、画面、手作業の手順を共有できます。困っている事象も伝えれば、要件整理から支援を受けられます。
機密データを渡す場合は、秘密保持契約、匿名化、持ち出し範囲を先に確認します。
MLOps基盤開発の進め方・費用・見積もりのまとめ
MLOps基盤は、要件整理と選定から始め、設計開発とテストを経て、稼働と定着へ進みます。各段階で、判断基準と成果物を確かめます。
まず業務KPIと対象モデルを絞り、最小構成で実証します。実証の対象は、データ・コード・モデルの再現性と承認です。デプロイや監視、ロールバックも見ます。
発注判断での精度・費用・運用の評価
発注前には、初期開発費と月額のクラウド・監視費を、規模に応じて把握しておきます。
- 初期開発費(編集部推定):小規模PoCは500万〜1,500万円、部門本番は1,500万〜3,000万円。
- 全社・複数モデル:初期費用は3,000万円〜1億円以上。
- 月額のクラウド・監視費:小規模は10万〜50万円、部門本番は50万〜300万円。
- 高負荷の運用:GPU常時稼働や大量推論では、月300万円超も想定。
いずれも固定価格ではありません。金額を見るときは、モデル数やデータ量、稼働時間を前提条件として確認します。既存環境や保守体制、対象外も合わせて見ます。
代表1モデルの検証計画
代表モデル1つを4〜8週間の小規模検証にかけ、運用の実態を四つの面から測ります。
- 運用品質:再現性、デプロイ時間、監視アラート。
- 運用負荷:月額費用と担当者の作業時間。
- 構成提案:構成図、パイプライン、モデルレジストリ。
- 本番運用:監視画面、手順書、SLA、費用試算。
候補会社には、これらの測定項目を含む提案を依頼します。実測値をもとに、全社基盤へ広げるか、対象を絞って運用するかを判断できます。
▼全体ガイドの記事
・MLOps基盤開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。