
MLOpsのシステム開発は、要件を整理して方式を選び、設計・開発とテストを経てから段階的に稼働させ、運用に定着させる順で進めると、本番で安全に改善を続けられます。最初は1業務・1モデルのMVPから始め、検証を重ねて対象を広げていきます。
▼全体ガイドの記事
・MLOpsのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLOpsのシステムの全体像
MLOpsは、DevOpsの考え方を機械学習のライフサイクルに広げた運用方法です。
通常のアプリ開発ではソースコードが主な変更管理の対象ですが、MLOpsではデータや学習条件、モデルに加えて、評価結果や推論ログも管理します。
MLOpsのシステムは、業務データを受け取り、予測結果を業務画面やAPI、バッチへ返す一連の基盤です。
予測結果を監視しながら、モデルを安全に更新します。
データから廃止までを管理するライフサイクル
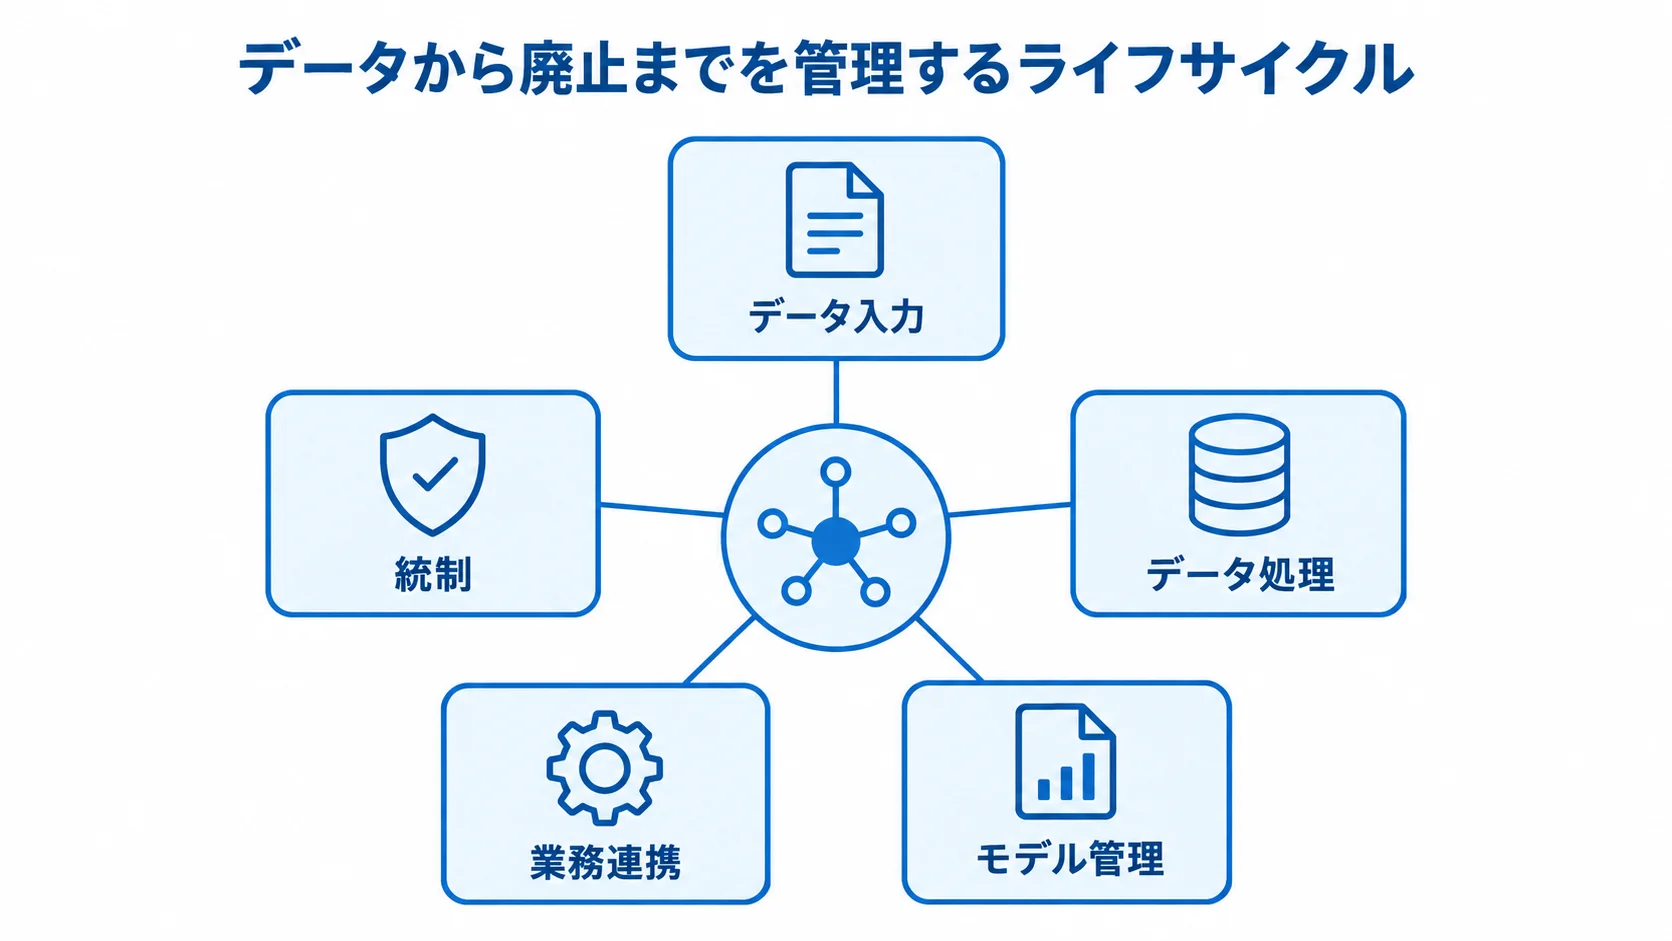
データの入力からモデルの廃止まで、5つの領域がつながって運用を支えます。領域ごとの担当は、次の一覧のとおりです。
- データ入力:業務データベース、IoT、Webログ
- データ処理:データレイク、DWH、ETL、特徴量生成
- モデル管理:実験管理、モデルレジストリ、学習環境
- 業務連携:推論APIまたはバッチ、監視・通知
- 統制:権限管理、監査ログ
モデルを登録するときは、学習データの版、コードのコミット、ハイパーパラメータを紐付けておきます。
評価指標や承認者、リリース日時も記録しておくと、そのモデルの変更履歴を後から追えます。
AWSのSageMaker Projectsは、データ準備から学習、評価を経て、デプロイや監視・更新までをパイプラインで管理します。コードリポジトリや再現性、作ったものの共有も支援する構成が、公式の資料で示されています。
出典は、Amazon Web Services公式の「What is a SageMaker AI Project?」「MLOps Automation With SageMaker Projects」で、2026年に確認しました。
業務KPIと運用KPIによる評価
モデルの精度に加えて、業務成果と運用状況を測る指標も、発注側と開発会社で決めておきます。
- 需要予測:欠品率、在庫金額
- 画像検査:見逃し率、検査時間
- 不正検知:検知率、誤検知の確認工数
- 運用:再学習から反映までの時間、推論レイテンシ、稼働率
- データと費用:欠損率、ドリフト対応時間、月間クラウド費用
正解率やF1値、平均絶対誤差は精度の指標で、業務への効果までは判断できません。そのため、どの業務をどこまで改善すれば投資を回収できるのかを、導入前に決めておく必要があります。特に、精度が高くても現場の判断に使われなければ、成功とはいえません。
MLOpsのシステム開発の進め方(6フェーズ)
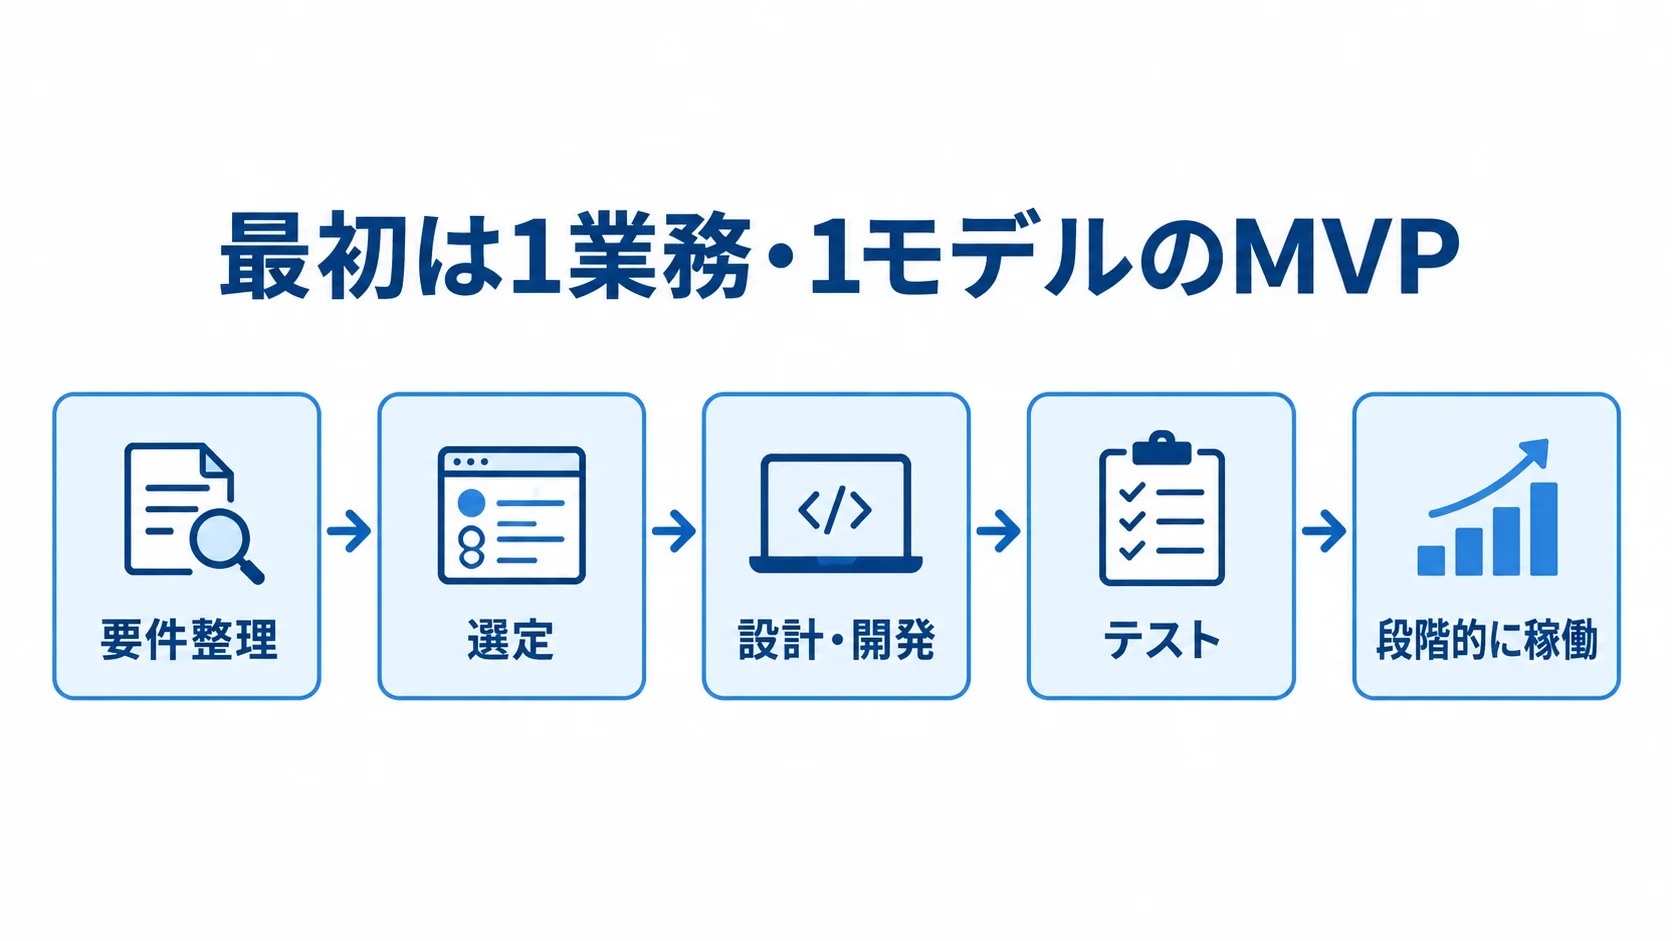
開発は6段階で進みます。まず要件整理で対象業務と受入条件を決め、続けて方式を選びます。各段階で何を決め、何を確かめるかを、順に見ていきます。
先にツールを導入すると、使われない機能が残ったり、本番データで動かないモデルができたりします。そこで、最初は1業務・1モデルのMVPを作り、シャドー運用と限定リリースでリスクを確かめます。問題がなければ、次はモデル数や利用部門を広げます。
フェーズ1:要件整理による対象業務と受入条件の決定
まずは、業務上の課題と利用場面を明確にします。
- 利用者:営業担当、工場など誰が使うか
- 業務目的:翌月需要の確認、異常候補の当日確認など
- 業務フロー:入力データ、出力、意思決定、許容時間
- 受入条件:予測誤差、推論時間、月間再学習回数
- 停止時対応:モデル停止時に戻す手作業
要件を確認する際は、ユースケースを1つに絞り、データの所有者と利用目的をはっきりさせます。
個人情報や機密情報、学習データの権利、正解ラベルの取得時期も確かめます。
誤判定時の責任者と代替手順を決めておかないと、追加データや画面変更が連鎖します。
要件を詰める工程を縮めると、スコープクリープや追加費用につながります。
フェーズ2:クラウド・OSS・スクラッチからの方式選定
各方式について、標準機能に含まれる範囲と、運用を担う人材を比べます。
- マネージドクラウド:短期導入と標準化に向く
- OSS構成:可搬性と細かな制御に優れる
- ハイブリッド:独自業務ロジックと標準サービスを分ける
比べる際は、データ準備から推論、ロールバックまで、各工程で標準機能がどこまで対応しているかを見ます。
クラウドの場合は、固有のAPIと料金、リージョン、データ移行を確認します。
MLflowやKubeflow、Kubernetesなどを使うOSSでは、更新や障害対応を担う人員が必要です。認証や監視も、自社で受け持つ範囲に入ります。
対応クラウドやオンプレミス接続の可否は、同じ質問票で確認します。OSSの扱い、IaCでの引渡し、移行性も合わせて確かめます。説明可能性や24時間対応は比較の対象に含め、SLAと保守範囲も比べます。
提案内容が、再学習の実行者や承認者、停止時に戻すモデルまで答えられるものかを確認します。
フェーズ3:データ・モデル・パイプラインの設計と開発
業務システムとの接続も含めて、データの流れを先に設計しておきます。
- 取得と検査:入力元、欠損・異常値の確認場所
- 特徴量:更新頻度と学習・本番データの分離
- 推論:オンラインまたはバッチで業務へ返す
- 保護:スキーマ変更の検知、個人情報のマスキング・匿名化
データセットの版や特徴量定義、学習パラメータを追跡できるようにします。モデルと評価レポートも、それらに紐付けておきます。
CI/CDではコードを検査し、CT(継続的学習)では新しいモデルを自動で作成できます。ただし、評価基準を満たさないモデルは、自動で本番へ出さない設計にします。
承認済みのモデルはレジストリから配備し、カナリアリリースやシャドー運用で既存モデルと比べます。この比較によって、モデル更新時の事故を抑えられます。
フェーズ4:精度だけでなく非機能と運用のテスト
テストでは、機能と品質に加えて、連携や性能、安全性、復旧まで確かめます。
- 品質と精度:データ品質、モデル評価、セグメント別の偏り
- 連携と性能:API・バッチ連携、性能テスト
- 安全性:セキュリティ、障害復旧
- 受入判定:精度、遅延、品質アラート、監査ログの条件
精度は平均値だけでなく、地域や商品ごとの偏りも確かめます。顧客属性や時間帯による偏りも見ます。
本番データの欠損や分布の変化、ラベルの遅延で精度が下がるため、実環境に近いデータを使います。
基準を下回ればリリースを止め、遅延が超えた場合は旧モデルへ戻す条件を、あらかじめ決めておきます。
品質アラートが出たときの学習中断や、監査ログの保管年数も、受入時に確かめます。
誤りを報告する画面や窓口も、テストの対象に含めます。
復旧は手順書に沿って試し、再実行とロールバック、手動業務への切り替えを確かめます。そうしておくと、経験頼みの復旧を避けられます。
フェーズ5:シャドー運用から段階的な稼働まで
最初は、予測を業務判断に反映させず、シャドー運用で結果を確かめます。
- 推論時間と欠損率:処理と入力データの状態
- 結果の妥当性:予測と既存業務との差分
- 現場負担:確認にかかる負荷
実際の入力でモデルを動かし、結果は参考値として保存します。また、既存の判断には影響させません。
一定期間の確認後、問題がなければ、対象ユーザーや拠点を絞ってカナリアリリースに進みます。
本番では、稼働率やレイテンシ、入力分布を監視し、予測の偏りや精度、推論コストも見ていきます。
正解ラベルが後から決まる業務では、データ品質と予測分布を先に見ておき、ラベルの取得後にモデル品質を測ります。
AWSの事例では、Volkswagenの複数拠点・複数用途を支える標準基盤が紹介されています(出典:AWS for Industries「How Volkswagen and AWS built end-to-end MLOps for Digital Production Platform」、2025年)。
Volkswagenの事例は、データとモデルの品質に加えて、バイアスや説明可能性などを監視する考え方も示しています。
フェーズ6:再学習と改善の現場への定着
モデルを放置しないために、再学習を検討する条件と承認の流れを決めておきます。
- データドリフト:一定値を超えたとき
- 業務KPI:2週連続で基準を下回ったとき
- 業務変更:制度や商品構成が変わったとき
アラートが出ても自動では公開せず、原因調査とデータ確認を行ったうえで、評価と承認を経ます。
承認のあとは、段階リリースと効果測定を行い、変更の影響を確かめます。
日次・週次・月次の点検や、アラートの優先度、連絡先を文書にまとめます。
復旧目標と廃止条件も、同じ文書に書いておきます。
引き渡しを受けるものは、ソースコードとIaC、パイプライン定義、環境変数の管理方法です。モデル一覧とデータ辞書、評価レポートも受け取ります。障害対応手順も、引き渡しの対象です。
自社運用へ移す場合は並走期間を設けます。担当者が再学習とロールバックを実行できるようになってから、契約を切り替えます。
MLOpsのシステム開発の費用相場とコスト内訳
MLOps一式の公開された標準価格は少ないため、ここでは前提を付けた概算を示します。
概算は、業務システムの人月相場、必要な機能範囲、公開クラウド料金をもとにしています。
金額は、データ整備の量や既存モデルの有無、モデル数で変わります。GPUの利用や個人情報・監査の要件、24時間運用の有無でも変動します。
見積書では、初期開発費と月額クラウド費、保守費を分けて示してもらいます。単一の金額だけで比べず、前提を揃えて見ることが大切です。
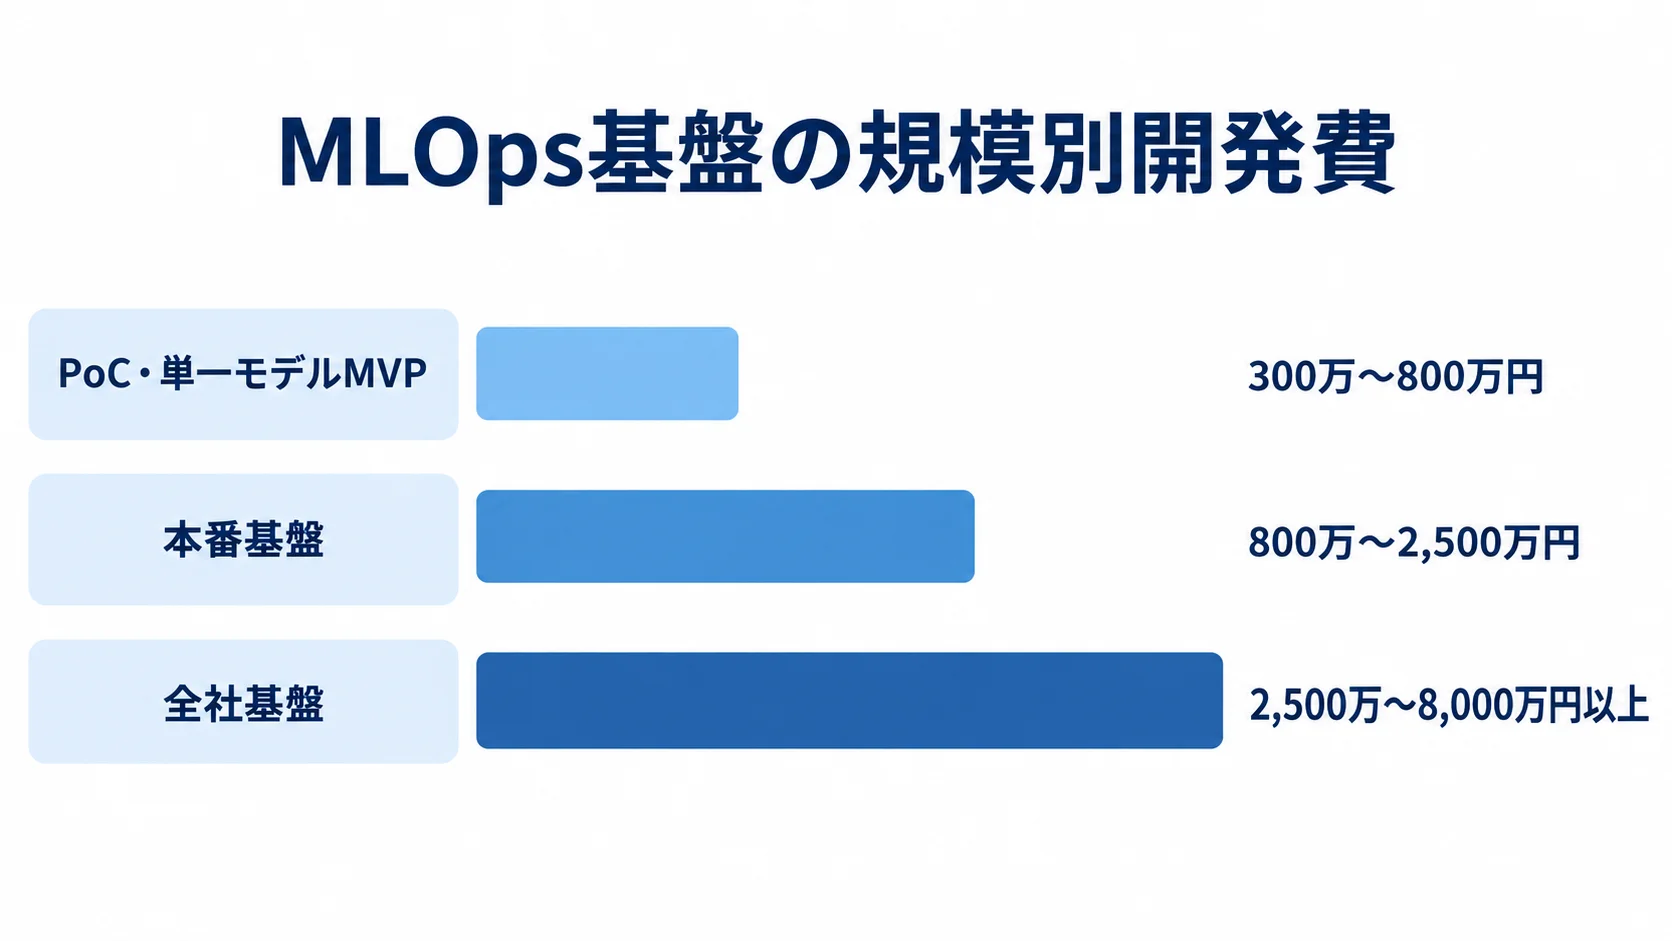
規模別の開発費の幅(300万円〜8,000万円以上)
費用と期間は、機能範囲と運用規模に分けて見積もります。
- PoC・単一モデルMVP:300万〜800万円、2〜4か月程度
- 本番基盤:800万〜2,500万円、4〜9か月程度
- 全社基盤:2,500万〜8,000万円以上、9〜18か月程度
PoCは既存データを使い、バッチ推論と簡易登録を前提とします。手動承認と最低限のログも、その範囲に含めます。
本番基盤は、データ連携と学習・評価・登録・デプロイの自動化を含みます。加えて、モデル監視と権限、監査ログも対象になり、CI/CDや1〜3モデルの運用も前提に入ります。
複数部門・複数モデルにまたがる全社基盤は、この規模になる可能性があります。その範囲には、GPUやマルチアカウント、災害対策、厳格な承認、SLAが含まれることもあります。
これは、リサーチノートに基づく推定で、特定企業の定価ではありません。2026年の業務システム相場を当てはめると、PM・上級MLエンジニアは1人月90万〜150万円です。
SE・データエンジニアは1人月65万〜110万円、実装・テスト担当は1人月50万〜90万円程度です。
たとえば、PoCを4〜8人月、人月単価を80万〜120万円とすると、320万〜960万円になります。この試算には、データ整備費やクラウド費、管理費を加えて考えます。
クラウド費と保守費の利用量・運用範囲による変動
月々の費用には、計算資源のほかに、データや運用サービスの費用も含まれます。
- クラウド利用:学習・推論、GPU、ストレージ、転送、DWH
- 運用基盤:ログ、監視、バックアップ、通知、外部API
- 保守:再学習、ドリフト調査、更新、脆弱性対応、問い合わせ
SageMaker AIは、学習やTracking Server、リアルタイム推論などを利用量に応じて課金します。バッチ変換やサーバーレス推論も対象です(出典:Amazon Web Services公式「SageMaker AI pricing」、2026年確認)。
見積の条件には、学習回数と処理時間を入れます。推論リクエスト数とエンドポイントの稼働時間も、条件に含めます。
保守費は、初期開発費の年間15〜25%が目安です。ただし、含む運用範囲によって月額は変わります。リサーチノートにある月額30万〜200万円程度には、クラウド費が含まれるとは限りません。
保守契約とクラウド請求は、分けて確認します。
監視を削ると、そのぶん調査や手作業に費用がかかる場合があります。
MLOpsのシステム開発で見積もりを取る際のポイント
見積もりは、ツールの数ではなく、変更管理と運用責任の範囲で比べます。「MLOps基盤一式」は会社ごとに前提が異なり、安い提案の中には、必要な機能が入っていない場合もあります。
RFPでは、モデル数やデータソース、推論方式を具体的に書きます。目標KPIとセキュリティ、稼働時間、引渡し物も示し、各社が同じ条件で見積もれるようにします。
見積依頼前のデータ・モデル・運用の前提の共有
依頼資料では、業務とデータの条件をそろえ、各社に同じ内容を伝えます。
- 業務:目的、利用者、対象業務、現行フロー
- データとモデル:ソース、更新頻度、量、欠損、既存モデル
- 推論と目標:オンライン・バッチ、モデル数、精度・遅延・可用性
- 環境と安全:環境分離、個人情報、暗号化、最小権限、監査ログ
- 復旧:バックアップと障害時の復旧目標
設計書のほか、データ辞書や特徴量定義を確認します。
コードとIaCも対象です。
CI/CD・CTやレジストリ運用の内容も確かめます。
評価レポート、監視画面、テスト結果も含めます。
手順書と教育記録のほか、再委託範囲も確認します。OSSライセンスやデータ・モデルの権利も、あわせて確かめます。契約終了時のデータ削除と移行方法は、見積の段階で質問しておくと、交渉が安定します。
複数社の同じ評価軸による比較と担当範囲の確認
各社に同じデータと業務シナリオを示し、提案範囲と担当責任を比べます。
- 提案範囲:「含む」「オプション」「対象外」に分類
- 担当範囲:データ連携、IAM、ネットワーク、モデル評価
- 障害・費用:一次対応とクラウド請求の担当者
開発、基盤、運用をそれぞれ別の会社が担う場合は、作業ごとの責任者を一覧にします。SIerがクラウドの標準機能を使う場合も、障害時の連絡先を契約書に書いておきます。
類似業界の連携や本番運用、監視の実績を確かめます。セキュリティ審査や定着支援の実績も聞きます。また、何モデルを何拠点で運用し、誰が再学習やロールバックを担ったかも質問します。
稼働後の改善KPIも聞いておきます。
非公開の実績は、匿名の構成図や手順例で判断できます。
安さだけでなく将来の変更と撤退までの確認
初期費用の内訳を確認し、対象範囲を調整して、過不足を避けます。
- 安価な提案:監視、テスト、データ整備、教育、保守、クラウド費
- 高額な提案:高性能GPU、過剰な冗長化、全社機能
- 範囲調整:1モデルのMVPへ分割し、受入条件を保つ
要件整理を削ると後工程の工数が増えます。そのため、削る場合は対象を絞ります。
クラウドに依存する場合は、モデルや特徴量の出力形式を確認します。学習履歴やログの出力形式も確かめます。
別の環境で再現できるかも確かめます。
会社の体制や料金は変わり得ますし、法令や社内規程も変わることがあります。
将来の変更費用と撤退条件も含めると、初期費用だけでは見えない総保有コストを比べられます。
MLOpsのシステム開発でよくある質問
MLOpsは、データやモデル、業務運用の変更を安全に管理する仕組みです。発注前や社内検討でよく出る質問に、実務上の判断基準で答えます。
MLOpsのシステムはPoCから始めるべきですか?
はい。まずは1業務・1モデルのPoCまたはMVPから始めるのが現実的です。
- PoC・MVPの範囲:精度に加え、データ品質検査や登録、承認、推論、監視、ロールバックを含め、本番化を判断する
- 全社基盤:先に構築する場合も、代表ユースケースでシャドー運用してから拡張する
既存のAIモデルがあればMLOpsだけを導入できますか?
導入はできます。ただし、再現条件とデータ履歴を確認できることが前提です。
- 現状の洗い出し:コード、学習データ、前処理、依存ライブラリ、評価指標、推論形式を一覧にする
- 導入開始:レジストリ登録と本番推論のテストから始める
- 履歴が不明な場合:自動再学習へ進まず、再現できる学習手順の作成を見積もる
クラウドとOSSのどちらを選べばよいですか?
重視する導入速度や標準化、可搬性、制御範囲によって選びます。運用に充てられる人員も、判断材料になります。
- クラウド:短期導入、標準化、少人数運用を重視
- OSS・ハイブリッド:可搬性、既存Kubernetes、細かな制御を重視
比較には初期構築費のほかに、運用の人員も含めます。更新や障害対応、パッチ、監視、移行が、その対象です。こうした人員を含めた総保有コストで判断します。
MLOpsのセキュリティと法務で何を確認しますか?
技術対策やデータの扱い、委託条件、保存と削除のルールを確認します。
- 技術対策:最小権限、暗号化、環境分離、監査ログ、秘密情報管理
- 運用対策:脆弱性対応、保存期間、削除方法
- データ利用:目的、委託・第三者提供、契約条件
AI事業者ガイドライン第1.2版は2026年3月31日に示されており、社内のガバナンスやリスク管理と照らし合わせます(出典:経済産業省「AI事業者ガイドライン検討会」、2026年)。
個人データを学習に使う場合は、個人情報保護委員会のガイドラインやQ&Aを確かめ、利用目的と照らし合わせます。委託契約の内容も確認したうえで、必要に応じて匿名化や仮名化を検討します。
MLOpsのシステム開発のまとめ(小さく始めて運用まで設計)
MLOpsは、モデルの精度向上だけでなく、運用まで含めて考えるプロジェクトです。要件の段階で業務KPIと受入条件を決め、方式を選ぶ際に運用責任を確かめます。
設計・開発では、データやコード、モデルを再現できるようにします。テストで精度と非機能を検証したうえで、シャドー運用から段階的に稼働させます。その後、再学習や監視、ロールバックを回せる状態を目指します。
最初の1業務で決めるKPIと変更管理
開始時は代表的な1業務を選び、改善するKPIとデータの所在を確かめます。
- 対象業務:利用者と許容できる誤判定
- 運用条件:再学習の条件、障害時の代替手順
- 計画:PoCと本番機能を分け、引渡し・教育を含める
これらをもとに見積もりを分けたうえで、開発会社や基盤ベンダーに同じ条件で相談します。
運用を開発担当者だけに任せず、引渡しと教育まで計画しておくと、継続した利用につながります。
機能・運用・クラウドを分けた費用の比較
開発費の推定レンジは、規模によって異なります。
- 小規模PoC:300万〜800万円
- 本番基盤:800万〜2,500万円
- 複数モデルの全社基盤:2,500万〜8,000万円以上
金額は、データ整備やGPU、監査によって変わります。さらに、24時間運用や再学習、クラウドの従量課金でも変わります。金額だけでなく、前提条件と担当範囲を比べ、段階的に広げられる提案を選びます。
▼全体ガイドの記事
・MLOpsのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。