
MLOpsのシステムは、データ準備、モデル管理、本番運用をつなぎ、AIを業務で継続して使うための基盤です。
必要な機能、導入の進め方、費用と運用の判断材料を押さえたうえで、技術選択や開発会社の選び方も確認できます。各テーマの詳しい内容は、関連記事でご覧いただけます。
▼関連記事一覧
・MLOpsのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・MLOpsのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・MLOpsのシステム開発の見積相場や費用/コスト/値段について
・MLOpsのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
MLOpsのシステムの定義
MLOpsのシステムは、機械学習のライフサイクルを再現可能かつ安全に管理する業務基盤です。具体的には、データとコード、承認者、本番反映の時刻、異常時に戻せるモデル版を追跡します。
AIモデルを本番業務で使い続けるための運用基盤
通常のソフトウェアと機械学習では、管理の方法が異なります。機械学習では、コードに加えてデータや学習済みモデルも管理の対象になるためです。
- 通常のソフトウェア:ソースコードの管理とテストが中心で、リリース後は障害や性能を監視します。
- 機械学習の変動:同じコードでも、データの期間、欠損、特徴量の計算方法で結果が変わります。
- 管理対象:学習済みモデルを中心に、データセットから推論ログまでが管理の対象になります。
- 需要予測:予測値を画面に表示するにとどまらず、業務の中で動かし続けることが求められます。
- 業務での運用:販売実績や休日情報の更新、再学習条件、誤差監視、通知、切り戻しを一本でつなぐと、安定して使えます。
DevOpsや通常のAI開発との管理対象の違い
DevOpsとMLOpsでは、管理する対象と本番後に扱う範囲が異なります。そのため、MLOpsのシステムは単独のAIツールではありません。業務部門、データエンジニア、インフラ担当、セキュリティ担当が変更履歴を共有し、同じ内容を確認できるようにします。
- DevOps:開発と運用をつなぎ、コードの変更を短いサイクルで安全に届ける取り組みです。
- MLOps:コードに加え、データとモデルの変更も一体で扱うのが特徴です。
- 通常のAI開発:モデル作成と精度検証の段階で終わる場合があります。
- MLOpsの運用範囲:本番後の精度劣化やデータドリフト、再学習、承認、廃止までを設計の範囲に含めます。
- 既存基盤との接続:販売、生産、顧客、IoT、ログの各基盤を、APIやバッチで接続します。
MLOpsのシステムに必要な機能と構成
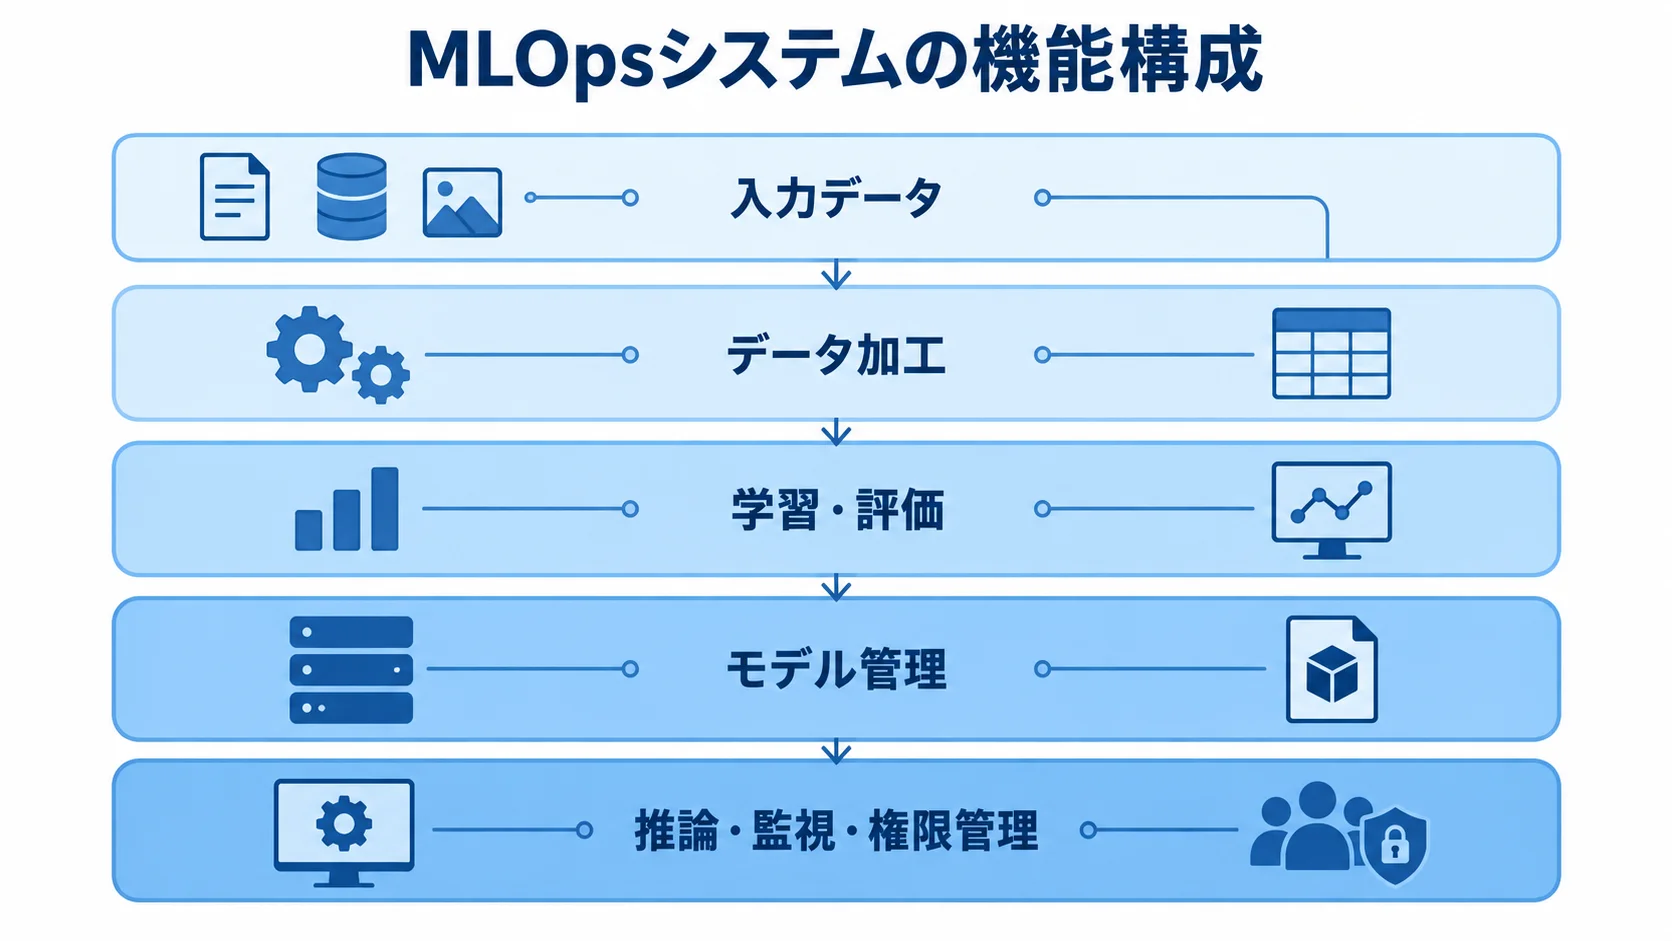
典型的な構成は、データの準備から学習・評価、モデル管理、推論、監視、権限管理へと段階をつないだものです。
対象業務のリスクと運用頻度に合わせて、機能を段階的に選びます。
データ収集・品質検査・特徴量管理
業務データは、学習と推論で同じルールを使えるように取り込みます。取り込む前に、データの置き場所と品質を確かめておきます。
- 対象データ:データベースやファイル、センサー、業務ログの置き場所と更新頻度を確かめます。
- 品質項目:欠損率や重複、異常値、個人情報の有無を調べ、その検査の履歴を残しておきます。
特徴量は、モデルが予測に使う入力値です。
学習時と本番時で計算が別々だと値がずれ、精度が不安定になります。そこで、計算式や対象期間、更新時刻、欠損時の扱いを共通部品として管理すると、再現性と保守性が高まります。
実験管理・モデルレジストリ・自動化パイプライン
モデルを作ってから本番へ出すまでを支えるのは、次の3つの仕組みです。
- 実験管理:データ版とソースコードのコミット、ハイパーパラメータ、評価指標を、生成されたモデルとひも付けた記録
- モデルレジストリ:モデルを開発中、検証済み、本番承認済み、廃止といった状態で管理する仕組み
- 自動化パイプライン:データ検査から前処理、学習、評価、登録、デプロイまでを順番に実行する一連の処理
承認者と変更理由も記録しておくと、精度が良かったモデルを同じ条件で再現しやすくなります。
パイプラインでは、評価指標が基準を下回れば自動で止め、基準を満たした場合も人の承認を経てから本番へ出します。なお、業務の重要度に応じて、自動化と人の判断を組み合わせます。
推論連携・監視・通知・ロールバック
推論方式には、画面やAPIから一件ずつ呼び出すオンライン方式と、夜間などにまとめて処理するバッチ方式があります。たとえば、審査や異常検知はオンライン、翌日の在庫計画や顧客リスト作成はバッチが向くなど、締め時間と許容遅延で選びます。
監視では、正解率に加えて、入力分布のデータドリフト、予測結果のモデルドリフト、遅延を見ます。残りは、入力の質、運用の状態、費用に関わる項目です。
- エラー率:処理が失敗した割合
- 欠損率:入力に値が無い割合
- 利用量:利用の件数や回数
- 計算費用:計算資源にかかる費用
通知先や調査手順、旧モデルへ戻す条件は、あらかじめ決めておきます。
MLOpsのシステムを導入するメリットと限界
MLOpsは、導入するだけで成果が出る仕組みではなく、AIの成果を支える基盤です。
データ品質や業務フロー、責任者、評価指標が曖昧なまま基盤を作ると、使われないパイプラインが増えかねません。そこで、メリットと限界を把握したうえで、導入範囲を決めます。
再現性とリリース速度の向上
導入効果は、検証時とモデル更新時の運用の中で確認できます。
- 再現性:データやコードの版、評価結果、承認履歴を残しておけば、担当者が異動しても同じ条件で検証し直せます。
- 展開の効率:モデル更新の手作業が減り、複数のモデルや業務拠点へ広げやすくなります。
段階リリースやシャドー運用では、新旧モデルの結果と業務への影響を比べたうえで切り替えられます。
2025年に公開された事例では、6アカウント、5工場、8ユースケース、16人のデータサイエンティストを支える標準構成が示されています(出典: 製造業向けクラウド基盤公式事例、2025年)。
基盤だけでは残るデータ品質と業務課題
MLOpsは、品質の低いデータを自動で正す仕組みではありません。たとえば、欠損の原因が入力手順にあるなら、業務側の改善が必要です。
評価指標が業務成果と結び付いていないと、精度が上がっても売上や工数、歩留まりが変わらない場合があります。
担当者がいない状態で自動再学習を回すと、異常なデータを学習して性能が落ちるおそれがあります。だからこそ、データ品質の確認、本番承認、障害時の判断を誰が受け持つかを決め、自動化してよい範囲と合わせておく必要があります。
MLOpsのシステムの種類と技術選択
技術を選ぶときは、機能の多さだけでなく、既存のデータ基盤との接続、運用人材、移行性、監査要件、推論遅延、利用量を比べます。1モデルのバッチ予測のように対象が絞られている場合は、管理対象を絞るほうが適切なこともあります。
マネージドクラウド型の短期導入と標準化
サービス固有の設定や従量課金の仕組みを理解しておく必要があります。学習、モデル登録、推論、監視、パイプラインを組み合わせることで、初期構築を抑えつつ、権限管理やログ、スケール機能を標準化できます。
クラウド上にデータ基盤がある企業や、複数のモデルへ早く広げたい企業に合っています。ただし、データ転送、常時稼働の推論環境、高性能な学習資源、ログ保管は、初期費用とは別の月額負担になる点に注意が必要です。
将来の移行に備えて、モデル形式やデータ出力、パイプライン定義、IaCの引き渡し条件を確かめておきます。
OSSとコンテナ基盤の可搬性と細かな制御
OSSでは、実験管理、パイプライン、コンテナ、コンテナオーケストレーション、ワークフロー管理、監視を、用途に応じて選びます。
特定サービスへの依存を抑えられ、オンプレミスとクラウドをまたぐ構成や、独自の承認フローを実装しやすい方式です。
一方で、認証やアップグレード、脆弱性対応、障害復旧、監視設計は、自社か委託先が担うことになります。そこで、ライセンスや保守状況、人材、複数の部品ごとの担当範囲を確かめ、導入費だけでなく総保有コストで判断します。
ハイブリッド型と既存資産の活用
既存のデータウェアハウスや業務APIを活用し、不足しているモデル登録、評価、監視、承認を追加する方式です。たとえば、機密データを社内に置いて学習だけをクラウドで実行すると、性能と統制を両立できます。
独自実装を増やしすぎると、担当者への依存や更新費用の増大につながります。そこで、差別化する業務ロジックは独自に作り、学習管理、デプロイ、監視といった一般的な機能には標準部品を使うと、変更に対応しやすくなります。
MLOpsのシステム開発の進め方
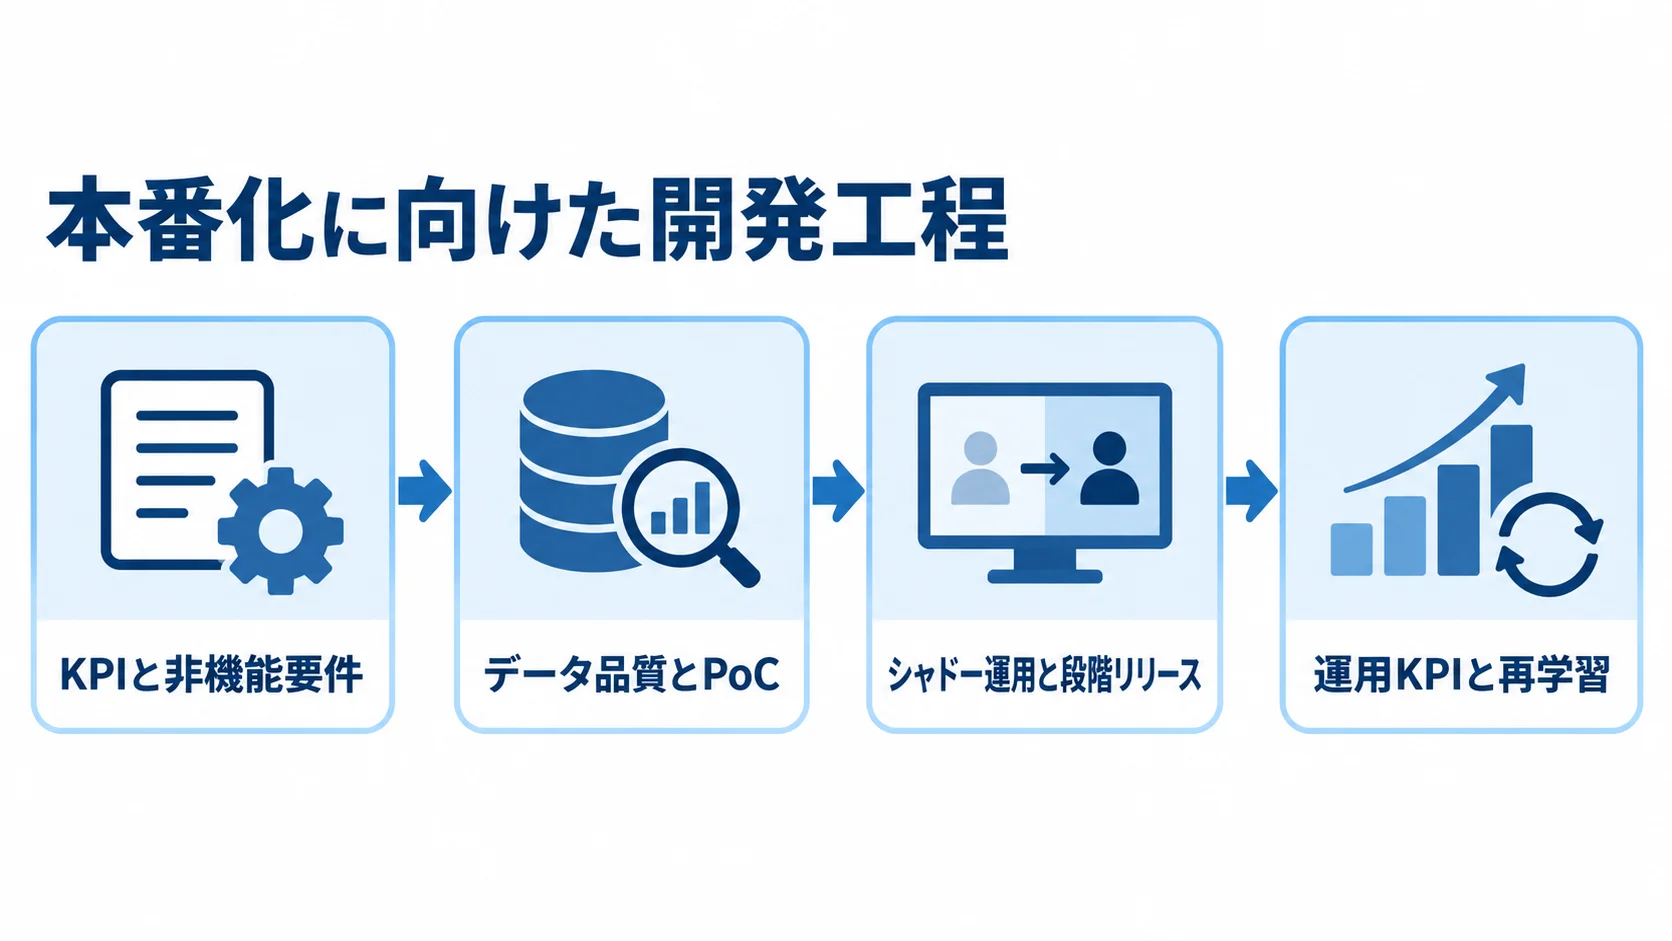
まずは、全社共通の基盤から作るのではなく、代表的な1業務・1モデルで本番化の条件を確かめます。そのうえで、企画、データ検証、最小パイプラインの順に進め、各段階を業務KPIで判定します。
- シャドー運用:新モデルを業務に反映せず、本番データで新旧の差を確かめる段階
- 段階リリース:対象を一部から広げ、業務への影響を見る段階
- 継続監視:運用の状態を追い、結果を次の判断に生かす段階
▶ 詳細はこちら:MLOpsのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
要件定義でのKPIと非機能要件
「何を予測するか」より先に、「業務の何を改善するか」を定めます。たとえば、予測誤差を何%下げるか、検査時間を何分短縮するか、再学習から本番反映まで何時間以内に行うかを決めます。
精度、処理時間、可用性、費用、説明可能性を受入条件とします。そのうえで、保存期間やアクセス権限、暗号化も定めておきます。
- 監査ログ:操作や判断の記録の残し方
- 障害時の復旧時間:障害から戻るまでの許容時間
- 国外移転:データを国外へ移す場合の扱い
- 再委託:委託先からさらに委託する場合の扱い
- ソースコードやIaCの引き渡し:発注側へ渡す条件
要件定義を省くと、開発の途中で対象データや監視範囲が増え、追加費用や納期の遅れにつながります。
データ品質の確認と小さなPoC
まず、データの所在と利用権限を洗い出し、学習期間の偏り、正解ラベルの信頼性、推論時にも同じ項目を取得できるかを確かめます。必要なデータが足りなければ、モデルの高度化より収集の改善を先に進めます。
PoCでは、精度の最高値だけでなく、学習や推論の時間、欠損時の挙動、説明のしやすさ、現場が結果を受け入れられるかも確かめます。
終了条件を「精度が出た」ではなく「本番データで再現でき、業務担当者が利用手順を理解した」と定めると、本番化を判断しやすくなります。
パイプラインの構築と、シャドー運用から段階リリースまで
本番化では、データ検査から前処理、学習、評価、モデル登録、承認、デプロイまでを一つのパイプラインにまとめます。新モデルはまだ業務に反映せず、本番データで旧モデルとの差や遅延を確かめるシャドー運用から始めます。
問題がなければ、対象部署や一定割合のリクエストに新モデルを使うカナリアリリースへ進みます。評価指標やエラー率が基準を下回った場合は自動で停止し、承認済みの旧モデルへ戻します。
リリース手順だけでなく、モデルを戻す手順も実際にテストしておきます。
運用KPIに基づく再学習と改善
精度が下がったときだけでなく、入力の分布や業務ルールが変わったとき、推論費用が増えたときにも見直します。再学習のきっかけは、月次などの定期実行と、ドリフト検知などのイベント実行に分けて考えます。
再学習後は、過去と直近の両方で評価し、特定の部署や顧客だけに不利な結果が出ていないかを確かめます。問い合わせや手動修正も記録し、次の評価データに反映します。
MLOpsは一度作って終わりのものではなく、業務、データ、モデルの変更を継続して扱う仕組みです。
MLOpsのシステムの費用相場とコスト内訳
MLOps一式として公開されている価格は多くなく、費用はデータ量、モデル数、GPU、既存基盤との連携、個人情報や監査、24時間運用の有無で変わります。ここで示す数字は、一般的な人月単価と公開クラウド料金の例に基づく概算です。
▶ 詳細はこちら:MLOpsのシステム開発の見積相場や費用/コスト/値段について
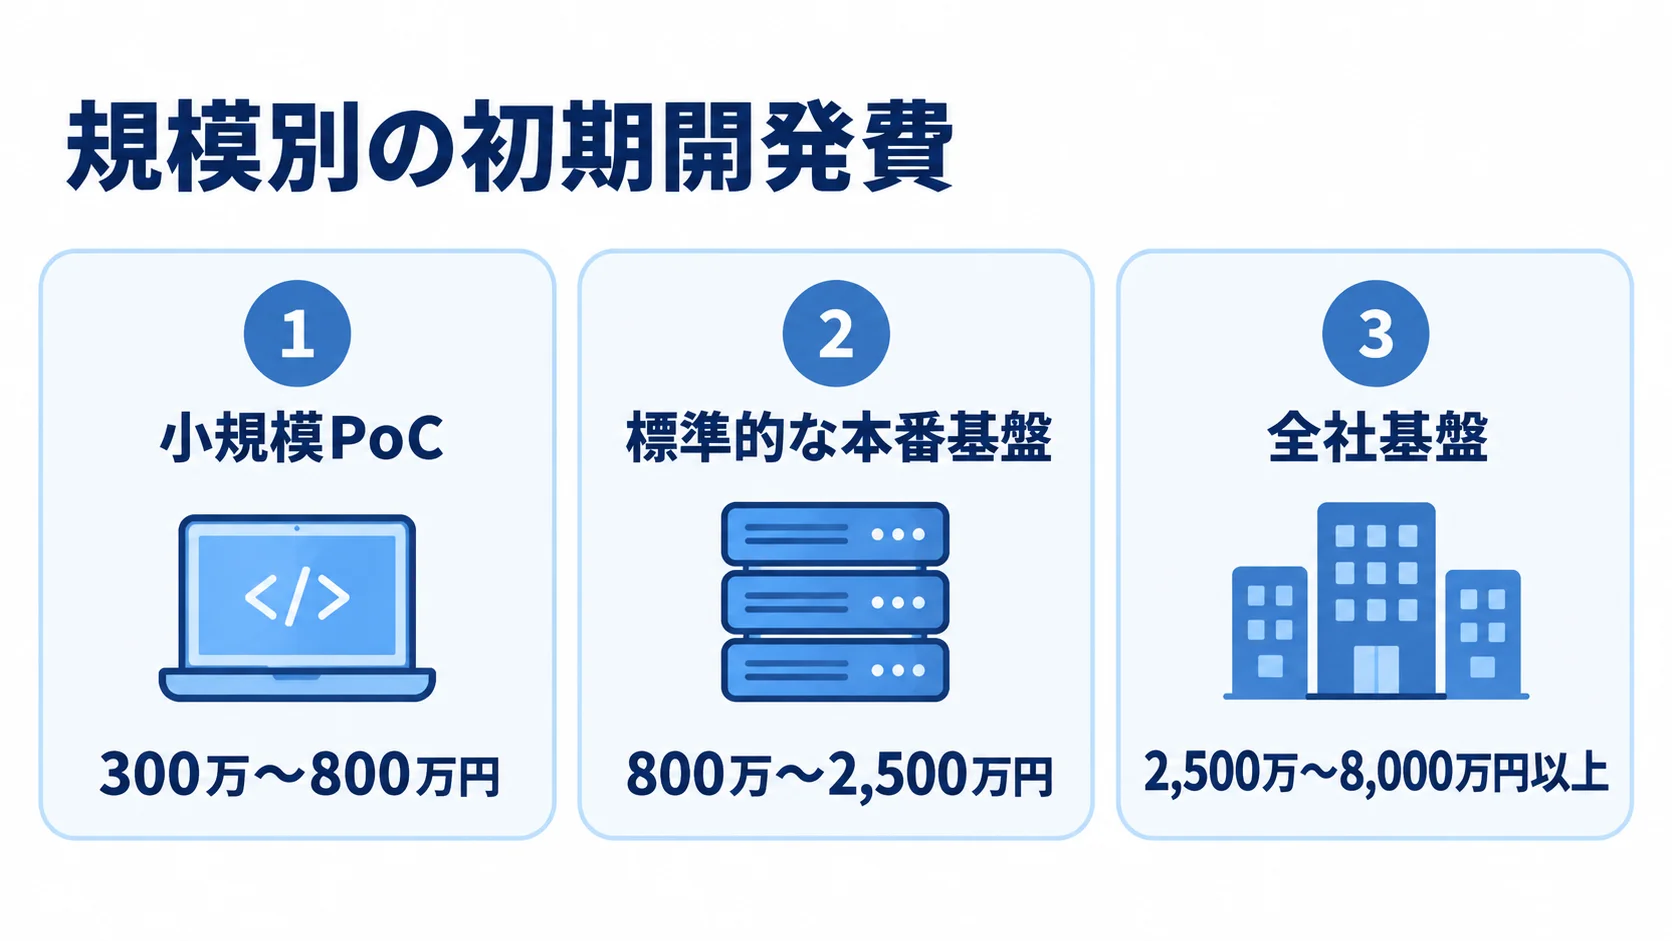
規模別の初期開発費の目安
既存データを使う単一モデルの小規模PoCは、300万〜800万円、2〜4か月が目安です。バッチ推論、簡易なモデル登録、手動承認、最低限のログに絞り、本番監視や自動再学習を省いた場合の価格帯です。
データ連携、自動化、モデル監視、権限、監査ログを含み、1〜3モデルを扱う標準的な本番基盤は、800万〜2,500万円、4〜9か月が目安です。
複数部門・拠点、GPU、災害対策、SLA、厳格な監査を含む全社基盤は、2,500万〜8,000万円以上、9〜18か月となる場合があります。
見積の内訳(データ・構築・実装・テスト)
内訳の目安は、要件定義とデータ調査が15〜25%、設計と環境構築が20〜30%です。さらに、パイプライン・API・画面実装は30〜45%、テスト・評価・セキュリティは15〜25%が目安になります。
比率は案件ごとに変わるため、どの作業が見積に含まれるかを確かめることが欠かせません。月あたりの目安は、PMや上級MLエンジニアが月90万〜150万円、データ・システムエンジニアが月65万〜110万円、実装・テストが月50万〜90万円程度です。
4〜8人月のPoCなら、人件費だけで320万〜960万円となります。このほかに、データ整備やクラウド、管理費が加わります。
クラウド・保守・再学習の費用
保守費とクラウド費は、含まれる作業や利用量を分けて確かめます。
- 運用保守費:目安は、初期開発費の年間15〜25%、または月額30万〜200万円程度です。
- 変動要因:再学習回数やモデル追加、アラート調査、脆弱性対応、問い合わせ、夜間対応の量によって変わります。
- 契約確認:開発費と保守費を分けて、保守に含む作業時間と追加作業単価を記載します。
- クラウド料金:学習、推論、ストレージ、ログ、データ転送、監視の費用に分かれます。
たとえば、2026年の公式料金例では、月160時間の実験管理サーバーは262.60米ドルです。リアルタイム推論と監視は月305.881米ドル、サーバーレス推論は月40.16米ドルです(出典: 主要クラウドの公式料金ページ、2026年)。
料金は、リージョンやインスタンス、負荷、保存量によって変わります。そのため、日本円の固定価格として扱わず、利用量の前提とともに見積もります。
MLOpsのシステム運用・監視・セキュリティ
本番運用では、モデルの精度を毎日確かめられないこともあります。そこで、正解データがすぐには得られない場合は、入力分布や欠損、予測値の偏り、処理遅延、エラー率などの代理指標を監視します。正解データがそろった時点で、精度を検証します。
精度・データ・性能・費用の監視項目
監視では、次のとおり項目を分けて確かめます。
- 精度:正解ラベルがあれば、正解率や適合率、再現率、誤差を見ます。
- データ:欠損率や異常値、カテゴリの増減、分布の変化を追います。
- 性能:推論のレイテンシやスループット、タイムアウト、稼働率。
- 費用:学習と推論の回数、計算資源、ストレージ、ログ量の追跡が対象です。
アラートには、重大度と対応時間を設定しておきます。たとえば、入力が届かなければ処理を止め、軽微な分布変化は翌営業日に調べるなど、緊急度に応じて対応を分けます。
通知に加えて、原因の調査に必要なデータ版、モデル版、処理IDを、ログからたどれるようにしておきます。
初期段階で組み込む最小権限・暗号化・監査証跡
情報の管理では、扱うデータ、アクセス権限、監査証跡を合わせて設計します。
- データの範囲:顧客、従業員、設備、取引の情報が含まれることがあります。
- データの扱い:利用目的や取得元、保存期間、委託先、国外移転を整理し、開発環境へのコピーは最小限に抑えます。
- アクセス権限:開発者、運用者、承認者の権限を分けて、不要な権限は削除します。
- 監査証跡:学習データの版、評価結果、承認者、リリース時刻、監視結果を、記録として残します。
2026年3月31日公表のAI事業者ガイドライン第1.2版は、AIのリスク把握、対策、説明責任の考え方を示しています(出典: 総務省・経済産業省「AI事業者ガイドライン」第1.2版、2026年)。
個人情報の利用目的と対応関係
個人情報を使うときは、法務と確かめる項目を次のとおり整理します。
- 利用目的:個人情報を使う目的
- 本人への案内:通知や公表の方法
- 提供と委託:委託や第三者提供の有無
- 安全管理:必要な安全管理措置の内容
- 削除方針:データを削除する方針
個人情報保護委員会はFAQで、複数人の情報から生成した学習済みパラメータについて見解を示しています。
特定の個人との対応関係が排斥されていれば、個人情報には当たらないと考えられるとしています(出典: 個人情報保護委員会「個人情報保護法ガイドラインQ&A」)。
判断は、元データや照合情報の管理の仕方によって変わるため、モデルだけで一律に決めません。
MLOpsのシステム開発会社・ベンダーの選び方
MLOpsという言葉を使うかどうかより、業務データを本番で扱い、モデル更新後まで担えるかを見ます。開発実績だけでなく、監視や障害対応、セキュリティ、契約終了時の引き渡しも比べます。
本番運用と既存システム連携の実績
提案を見るときは、精度やデモだけでなく、データ連携、学習頻度、承認を確かめます。
- 推論:本番で予測結果を返す処理
- 監視:精度や遅延の状態を追う仕組み
- ドリフト検知:入力や結果の傾きを見つける方法
- 再学習:新しいデータでモデルを作り直すこと
- ロールバック:前の承認済みモデルへ戻す操作
発注側は、類似システムで稼働後のアラートと対応方法を質問しておきます。
モデル単体の開発と、本番業務につないだ基盤の実績は、分けて見ます。データウェアハウスや業務APIとつないだ経験があるかどうかで、PoC止まりの提案を見分けられます。
- 認証・認可:利用者ごとに権限を分けた経験
- 監査ログ:操作の記録を残した経験
- 性能試験:負荷をかけて処理能力を確かめた経験
- 障害訓練:障害時の切り戻しを実際に試した経験
クラウド・OSS・移行性の同条件での評価
対応クラウドやオンプレミス、OSSを確かめます。
- コンテナ化:コンテナで動かせる構成
- モデル形式:学習済みモデルを別の環境で使える形式
- データ移行:データを別の環境へ移す手順
- ログ形式:ログを別の仕組みで読める形式
特定のサービス専用か、標準APIやコンテナで移行できるかによって、将来の選択肢が変わります。
学習と本番環境の分離、最小権限、脆弱性対応を比べます。
- バックアップ:データを複製して保管する方法
- 災害復旧:障害や災害のあとに業務を戻す手順
- 性能試験:負荷をかけて処理能力を確かめる試験
RFPには、モデル版、評価指標、推論遅延を明記します。
- 監視:何を見張り、どこまで追うかの要件
- 通知:誰にどの方法で知らせるかの要件
- ロールバック:前のモデルへ戻す条件と手順
- 費用上限:利用料の上限を定める要件
各社から同じ粒度で回答を受け取ると、提案を比べやすくなります。
運用体制と契約の責任分界
委託の範囲は、障害時の担当と、成果物の引き渡し条件に分けて決めます。
- 運用担当:実装は開発会社、基盤の提供はクラウド事業者が行い、発注者はデータと業務判断を担います。
- 障害対応:一次窓口、アラート調査、再学習の承認、モデル廃止のそれぞれに担当を割り当てます。
- 連絡体制:セキュリティパッチや費用超過が起きたときの連絡先を、責任分界表に記します。
- 引き渡し対象:ソースコード、パイプライン、IaC、モデル、学習データのメタデータ、手順書、監視設定が対象になるかを確かめます。
- 契約条件:再委託や、データの利用目的、契約終了後の削除・返却、移行支援、保守SLAを契約に明記します。
▶ 詳細はこちら:MLOpsのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:MLOpsのシステム開発の発注/外注/依頼/委託方法について
MLOpsのシステム開発で起こりやすい失敗と対策
目的、データ、責任者、運用費用を決めないまま構築を始めると、失敗の原因になりがちです。代表的な失敗のパターンを把握し、要件や契約に反映しておきます。
PoCの成功と本番稼働の取り違え
整えた検証データで精度が出ても、本番では入力の遅延や欠損、業務ルールの変更が起こります。そのため、PoCの段階から、本番データの取得、推論時間、現場の確認手順、監視、旧モデルへの復旧を確かめておく必要があります。
本番化に必要な追加作業は、見積に含めておきます。
監視と再学習の自動化の行き過ぎ
アラートが多すぎると、担当者が見なくなってしまいます。そこで、重要度と対応時間、担当部署を決め、検知後に調べられる情報を記録しておきます。
再学習では、データの変化を検証したうえで、承認なしに本番モデルが置き換わらない仕組みにします。
クラウド費用と運用担当者の後回し
学習回数やGPUの稼働、推論リクエスト、ログ保管量が増えると、初期見積の外で月額費用が膨らみます。そこで、月間の利用上限や予算アラート、不要な環境の停止、モデル別の配賦を設計しておきます。
開発費、クラウド費、保守費は分けて管理します。教育と引き継ぎも成果物に含め、手順書、障害訓練、再学習演習、ロールバック、権限申請を実際に試しておきます。
よくある質問(FAQ)
MLOpsのシステムを検討する際に、特に多い質問へ回答します。費用や導入時期は、対象のモデル数と運用要件で変わるため、自社の前提を当てはめて確かめてください。
MLOpsのシステムは小規模なAI導入にも必要ですか?
毎月の再学習や業務判断への影響がなく、検証だけで終わるのであれば、大規模な基盤は不要です。一方で、本番で利用するなら、小規模でもデータ版の管理、最低限のログ、モデルの承認、障害時の切り戻しを用意します。
まずはバッチ推論と手動承認から始め、利用が増えた段階で自動化を広げるのが現実的です。
マネージドクラウドとOSSはどちらが良いですか?
短期導入や標準化、負担軽減を優先するなら、マネージドクラウドが適しています。一方、可搬性や細かな制御、既存オンプレミスとの統合を優先するなら、OSSが候補になります。
データの所在や人材、移行要件、利用量、監査要件を比べます。学習・推論・監視で方式を分けるハイブリッドという選び方もあります。
MLOpsのシステム開発は何から始めればよいですか?
まず、1業務の改善KPI、利用データ、利用者、許容遅延、精度が落ちたときの担当者を整理します。そのうえで、データ品質を調べ、1モデルのPoCとシャドー運用を行います。
本番化で得た運用要件を全社共通の基盤に反映してから段階的に進めると、過剰な投資を抑えられます。
学習データに個人情報が含まれる場合はどうしますか?
利用目的や取得方法、本人への通知・公表、委託先、第三者提供、安全管理、保存期間を確かめ、必要に応じて匿名化や仮名化を検討します。
学習済みモデルだけでなく、元データや特徴量、ログ、バックアップ、照合情報も管理の対象になります。法的な該当性はデータと運用によって変わるため、法務や専門家に確認してから本番で使います。
まとめ
MLOpsは、データ準備から学習、評価、承認までを継続して管理し、AIモデルを本番業務で使うための基盤です。
- デプロイ:承認したモデルを本番へ出す
- 推論:本番で予測結果を返す
- 監視:精度や遅延の状態を追う
- 再学習:新しいデータでモデルを作り直す
- 廃止:役目を終えたモデルを止める
コードに加えて、データや特徴量、モデル、評価結果、推論ログの変更も管理します。
1業務・1モデルでの本番運用の条件確認
費用は小規模PoCで300万〜800万円、標準的な本番基盤で800万〜2,500万円、複数部門の全社基盤で2,500万〜8,000万円以上が目安です。
データ連携、GPU、監査、SLA、保守、従量課金を分けて見積もり、その前提を明記します。
業務KPI・データ品質・責任分界の事前決定
精度だけでなく、業務効果や遅延、費用、説明可能性、障害時の復旧を受入条件にします。そのうえで、シャドー運用と段階リリースで影響を抑え、監視、再学習、ロールバックを試してから対象を広げます。
▼関連記事一覧
・MLOpsのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・MLOpsのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・MLOpsのシステム開発の見積相場や費用/コスト/値段について
・MLOpsのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。