
OpenSearchのシステムは、用途と運用条件に合わせて段階的に構築します。業務検索やログ分析、セキュリティ分析、AI検索に対応し、目的に合う検索基盤を目指します。
システムの種類、開発の進め方、費用と導入形態、性能・運用、ベンダー選びの順に見ていきます。
▼関連記事一覧
・OpenSearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・OpenSearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・OpenSearchのシステム開発の見積相場や費用/コスト/値段について
・OpenSearchのシステム開発の発注/外注/依頼/委託方法について
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
OpenSearchのシステムの全体像
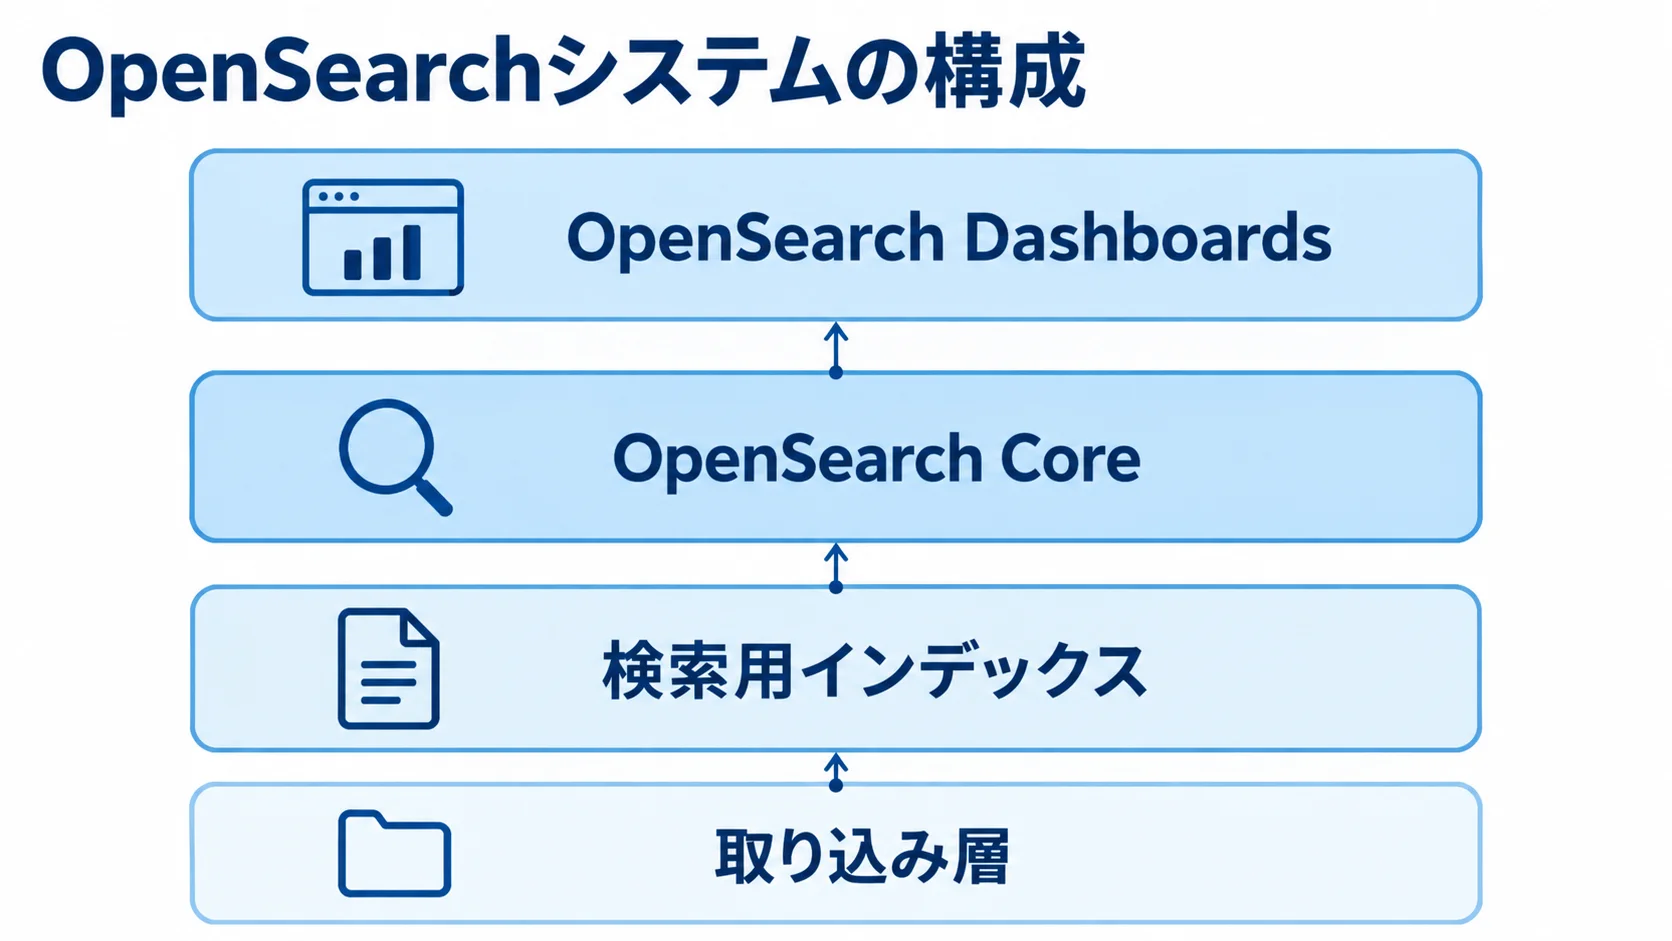
OpenSearchは、Apache Luceneを基盤とするApache License 2.0の検索・分析スイートです。JSON形式のドキュメントをインデックスに登録して、キーワード検索、集計、時系列分析、ダッシュボード表示を高速に実行できます。
さらに、2026年時点ではベクトル検索やニューラル検索も同じ基盤に組み込めます。検索機能とAI活用を別々に作らず、共通のデータ基盤として設計できる点が特徴です。
検索エンジンとダッシュボードが中心
OpenSearch Coreは、ドキュメントの登録、インデックス作成、検索、集計、ランキング処理を担います。
OpenSearch Dashboardsは、検索結果やログをグラフ・表・時系列で可視化する画面です。
たとえば、検索画面を業務アプリに埋め込む場合はCoreのAPIを利用し、運用担当者がログを調べる場合はDashboardsを使います。利用者ごとに入口を分けられます。
取り込み層と検索用インデックスの役割分担
データの取り込みと整合性の維持は、別々の役割として捉えます。取り込み元から検索用インデックスまでは、次の4つの要素が分担します。
- 取り込み元:業務データベース、SaaS、アプリケーション
- 取り込み層:Data Prepper、Fluent Bit、Logstashなどで変換・分割し、OpenSearchへ登録する役割
- 同期:元データとの再同期、更新・削除の反映、失敗時の再送
- 再インデックス:手順を決めて行い、データ不整合を防ぎます。
OpenSearchは、検索・分析用の派生インデックスとして使い、業務トランザクションの正本は別に置く設計が一般的です。この役割分担が、本番運用でのデータ不整合の防止に役立ちます。
既存の検索基盤からの移行と互換性の確認
Elasticsearch系から移行するなら、本番の前にAPI、クライアントライブラリ、プラグインの互換性を検証します。アナライザー、テンプレート、スナップショットも確認の対象です。
名称が似ていても、バージョンや利用している機能によっては、そのまま移せないことがあります。
移行前に、対象のインデックス数、総データ量、ピーク時の検索数を整理します。そのうえで、許容停止時間と1日あたりの取り込み量も確認し、検証環境で再インデックスと差分同期を試してから本番を切り替えます。
OpenSearchのシステムの種類
OpenSearchの設計は、データを何のために検索・分析するかで変わります。用途が違えば、必要なインデックスやシャード、監視項目も異なります。
検索・分析の対象は、次の4つの領域に分けて考えられます。
- 業務検索:検索結果の正確さを優先する
- ログ分析:取り込み量や保持期間を基準に設計する
- セキュリティ分析:不審なアクセスや権限逸脱の検知
- AI検索:キーワード検索と組み合わせ、用途とデータに応じて使い分ける
Web検索・業務検索システム
商品や文書を検索するシステムです。FAQや社内ナレッジなどを探す用途にも使われます。
文字列一致に加え、形態素解析、同義語、表記揺れへの対応を組み合わせます。そのうえで、カテゴリーや価格帯、日付による絞り込みや入力候補、ランキング調整も使います。
日本語では、固有名詞や略語、送り仮名の扱いによって、検索の使い心地が大きく変わります。そのため、実際の検索語と期待する結果を集めた評価データを、最初に用意します。
ログ分析・オブザーバビリティシステム
アプリケーションやサーバー、ネットワークのログを集め、障害調査や性能分析に使います。認証や監査のログも対象です。
エラー率や応答時間、特定ユーザーの操作を、ダッシュボードで確認できます。リリース前後の変化も見られます。
ログは日々増えていきます。そこで、直近のデータは高速なHot領域に置き、参照頻度が下がったデータをUltraWarmやCold相当の低コスト領域へ移します。これにより、費用と調査性の両立を図れます。
セキュリティ分析システム
認証ログやWAF、ネットワークのイベントを横断して検索します。エンドポイントの記録も、検索の対象に含まれます。これにより、不審なアクセスや権限逸脱を検知できます。
検知ルールとアラート、相関分析を使うと、ログ照合の時間を短縮できます。調査用ダッシュボードも、この作業を支えます。
法令や業界規制への適合は、OpenSearchの機能だけで自動的に保証されるものではありません。そのため、保存期間と対象ログ、閲覧者を運用規程に定めます。証跡の改ざん防止やインシデント対応についても、同じ規程で決めておきます。
ベクトル検索・RAGシステム
RAGの検索設計では、検索機能の組み合わせと権限の反映を確かめます。
- ベクトル検索:文書を埋め込みベクトルに変換し、意味の近い情報を検索する
- 公式機能:ベクトル・セマンティック・ハイブリッド・マルチモーダル検索とRAG(出典:OpenSearch公式ドキュメント、2026年)
- 検索の組み合わせ:キーワード検索は製品番号など、ベクトル検索は言い換えなどに向き、併用が使いやすい傾向です。
- 権限反映:回答生成の前に、所属・役職・案件権限を検索結果に反映する
OpenSearchのシステム開発の進め方
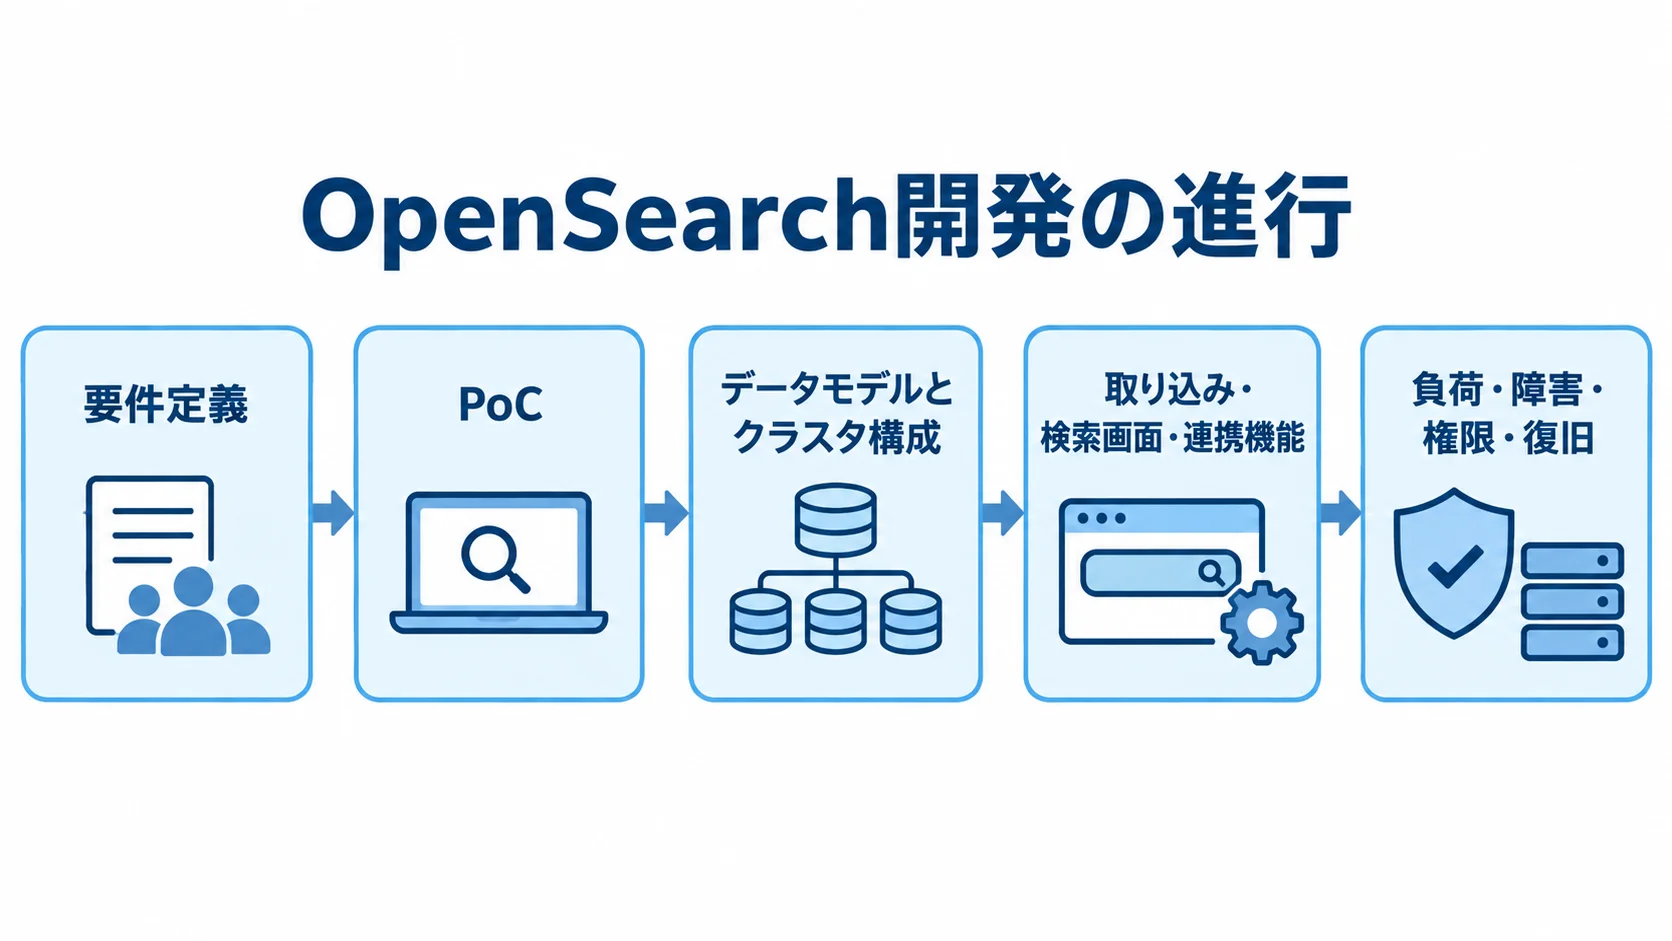
開発は、業務の目的と評価指標から逆算して進めます。クラスタの構築は、その後の工程で行います。
KPIは領域ごとに異なります。検索では検索精度とP95応答時間、ログでは取り込み遅延と調査時間、RAGでは正しい文書を取得できる割合と権限逸脱ゼロを使います。
まずPoCで小さく検証し、データモデルと非機能要件が固まってから本番構築に進みます。こうすると、過剰なカスタマイズを防げます。
要件定義での目的・データ・KPIの決定
要件定義では、誰がどのデータを、どの画面やAPIから、どのくらいの速さで検索するかを整理します。データ量は月間と日次で把握し、そのうえで、1秒あたりの取り込み件数やピーク時の検索数、同時利用者数を数値にします。
更新・削除の頻度と保存期間を決め、許容停止時間とRTO・RPOも定めます。正本データの所在や個人情報の有無を確認します。データ所在地や閲覧権限、監査ログの要否も、決めておく項目です。
要件が曖昧なまま進めると、後の工程でノードの追加や設計変更が起きやすくなります。
PoCでの検索精度と性能の実データ検証
PoCでは、代表データだけでなく、欠損や表記揺れ、長文を含むサンプルを用意します。さらに、更新済みデータや削除対象も含めます。検索語ごとに期待する上位結果を定め、適合率・再現率や業務担当者の評価で精度を確認します。
性能は平均値だけでなく、P95・P99の応答時間を測ります。加えて、同時検索数と取り込み遅延も見ます。再インデックス時間と障害時の復旧時間も、測定の対象です。
OpenSearch公式は、ハイブリッド検索の最適な設定がデータや利用者の行動で変わるため、クエリセットと正解判定による評価が必要だと説明しています(出典:OpenSearch公式ドキュメント、2026年)。
データモデルとクラスタ構成の設計
まず、インデックス名、マッピング、アナライザーを設計します。同義語とエイリアスも、設計の対象です。レプリカ数とシャード数、ロール分担も決めます。
シャードが多すぎると管理負荷が増え、少なすぎると負荷を分散できません。設計では、データ量に加えて、クエリの種類とノードのメモリを考慮します。さらに、インデックスの増加頻度や将来の増加率も見込みます。
ログでは、日付単位のインデックスとISMによるローテーションを使います。業務検索では、再インデックス中も参照できるよう、エイリアスを切り替える設計にします。こうすると、変更時も検索を止めずに済みます。
取り込み・検索画面・連携機能の実装
データの取り込み、変換、登録、更新、削除、再送までを、一連のパイプラインとして作ります。監視では、成功件数に加えて失敗件数と遅延を見ます。重複やスキーマ変更も、見逃さないようにします。
検索画面には、キーワード入力と絞り込みを用意します。並び順やサジェスト、ゼロ件時の案内も備えます。管理者向けには、マッピングや検索ログを確認できる画面を設けます。
RAGでは、チャンク分割と埋め込み生成を、検索処理の一部として実装します。引用元の表示や回答の根拠確認、権限フィルターも、同じ流れに組み込みます。
負荷・障害・権限・復旧のテストと運用への移行
本番に移す前に、負荷や障害時の動作、データ復元、権限と削除の反映を確認します。
- 負荷・障害:ピーク負荷、ノード停止、ネットワーク切断を想定して検証
- データ復旧:取り込み遅延、バックアップ復元、再インデックスを試す
- 権限・削除:権限のない検索の防止と、削除依頼の反映確認
OpenSearch Securityでは、クラスタとインデックスの単位でアクセス制御を設計できます。ドキュメントやフィールドの単位でも設定できます。
適切な権限管理には、OpenSearch Securityの設定だけでは足りません(出典:OpenSearch公式セキュリティドキュメント、2026年)。
監視項目とアラートの閾値を決め、担当者へ引き継いでからリリースします。引き継ぎには、一次対応とエスカレーションの流れを含めます。バージョンアップや復旧手順も、引き継ぎの対象です。
OpenSearchのシステム開発費用と月額料金の相場
OpenSearch自体はオープンソースで使えますが、システム全体の費用が無料になるわけではありません。
費用は、開発・導入の費用と、運用に関わる費用に分けて考えます。運用に関わる費用には、クラウドやサーバーの利用料、データ転送・ストレージの料金などが含まれます。監視・バックアップ、保守・障害対応も、この中に入ります。
以下は、公開されている一般的な業務システムの価格帯に、OpenSearch固有のデータ連携や検索チューニングの工数を加えた推定です。市場全体の統計ではないため、データ量や非機能要件を含めた個別の見積もりが必要です。
▶ 詳細はこちら:OpenSearchのシステム開発の見積相場や費用/コスト/値段について
初期開発・導入費の幅(100万円から1億円超)
規模や含める機能によって、初期費用の目安は次のように変わります。
- PoC・MVP:技術検証は100万〜300万円、社内検索・小規模ログ基盤のMVPは300万〜1,000万円程度
- 本番:複数DB・SaaS連携、権限、監査、可用性、運用設計を含めると、1,000万〜3,000万円程度
- 大規模:大規模データ、高可用性、複数リージョン、RAG、移行を含むと、3,000万円〜1億円超になることがあります
- 期間:PoCは2〜6週間、MVPは1〜3か月、本番連携は3〜6か月、大規模案件は6〜12か月以上の目安
- 費用配分:要件定義・企画10〜15%、設計25〜35%、実装30〜40%、テスト15〜20%、移行・教育5〜10%程度
検索精度の改善やデータクレンジングに加えて、移行元との互換性調査、24時間監視、厳格なRTO・RPOが加わると、設計・検証・運用準備の比率が高くなります。
基盤の月額費用と構成・保持期間による違い
月額料金の公式例と試算には、次のような幅があります。
- 本番構成例:3 AZ、データノード3台、クラスターマネージャー3台、UltraWarm 2台、EBS等の構成で月1,604.83米ドル
- 別のMulti-AZ構成:月8,772.84〜13,241.34米ドルの例があり、月100万円台になることもあります。
試算用に1米ドル=150円で換算すると、約24万円です。
この金額には、リージョン、為替、税が含まれません。さらに、データ転送や監視、サポートの費用と、開発会社の保守費も含まれません(出典:クラウドサービス公式料金ページ、2026年)。
OpenSearch Serverlessのような従量型では、検索・取り込みのコンピュート単位やストレージ、データソース側の料金を確認します。一方で、専用クラスタではインスタンスとEBSを土台に、スナップショットや転送、監視、バックアップの費用を積み上げます。
ログの保持期間は無制限にせず、Hot・Warm・Coldの階層を設計します。アクセス頻度が下がったデータを低コスト領域へ移すと、検索性を保ったままTCO(総所有コスト)を抑えられます。
開発費と運用費を分けた見積もりの比較
見積書では、初期開発費と月額基盤費を分けて確認します。保守費や監視費も、別の項目として見ます。障害対応の時間帯やバージョンアップ、バックアップ復元試験、追加データ連携も、内訳に分けてもらいます。
検索機能の追加は都度見積もるのか、一定範囲の改善を月額に含むのかを確認します。監視や再インデックスが発注者側に残ると、社内人件費を含めた総額が高くなる可能性があります。
OpenSearchの導入形態の選び方
導入形態には、マネージドサービス、セルフマネージドのクラウド・Kubernetes、オンプレミス、それらを組み合わせるハイブリッドがあります。
選ぶときは、運用負荷やカスタマイズ性を見ます。データ所在地、将来の移行性、費用の予測しやすさも、判断材料になります。
オープンソースだからといって自社サーバーで運用すると決める前に、障害対応とアップグレードを誰が担うかを明確にします。
運用負荷を下げたい場合のマネージドサービス
マネージドサービスでは、クラスタ作成やパッチ、監視連携、スケールの仕組みを利用でき、ノードの一部管理も含まれます。少人数の情シスで検索基盤を持つ場合や、短期間でPoCから本番へ移行したい場合に向きます。
インスタンスやOCU、ストレージのほか、転送、バックアップ、サポートの料金体系を理解しておきます。特定のクラウドやサービスに依存した場合は、移行手順も確認します。データ所在地や契約上の責任分界も、確かめておきます。
高度な制御が必要な場合のセルフマネージド
セルフマネージドでは、運用の担当範囲が次のように広がります。
- OS・コンテナ・Kubernetes:管理を自社で行う
- OpenSearchのバージョン:自社で扱う
- 証明書・ノード障害:自社または委託先が対応する
- スナップショット・容量計画:担当範囲に入る
独自プラグインが必要な場合や、厳格なネットワーク分離、細かなチューニングが求められる場合に適します。社内規程に沿った配置が必要なときも、この形態が合います。
一方で、運用担当者の採用や教育、夜間対応には人件費がかかります。さらに、アップグレードの検証や脆弱性対応も、人手を要する作業です。
そのため、セルフマネージドは、基盤費だけで比べると判断を誤りやすい形態です。
データの性質と運用体制で使い分けるハイブリッド
機密性の高いデータは社内環境に置き、公開情報や大量ログはマネージド環境に置くなど、データの性質に応じて分ける方法もあります。
ただし、ネットワーク接続や認証、データ同期の仕組みが複雑になります。障害時の切り分けや監視画面、契約責任の整理も、手間がかかります。
保存先、切断時の検索継続、復旧後の差分反映は、設計書に明記します。
OpenSearchの性能・セキュリティ・運用で注意する点
導入後に問題になりやすいのは、データ量の増加や検索クエリの偏りです。権限漏れや未検証のバックアップ復元、削除反映の遅延も、見落としやすい点です。
非機能要件は測れる形にし、運用で確認する項目をテスト計画へつなげます。公式のセキュリティ機能や最新のAI検索機能も、実データと業務の流れで検証します。
シャード・マッピング・クエリを一体で考える性能設計
応答時間を改善するには、ノードを追加するほかに、検索対象のフィールドやanalyzedとkeywordの使い分けを見直します。不要な_sourceの削減やフィルター条件、集計頻度も調整します。
シャードサイズとレプリカ数は、あわせて調整します。検索と書き込みが同じ時間帯に集中するなら、取り込みのバルクサイズや更新頻度を変えます。
性能試験では、開発環境の平均値ではなく、本番を想定したデータ量で測ります。見る指標は、P95とP99、スループット、エラー率です。
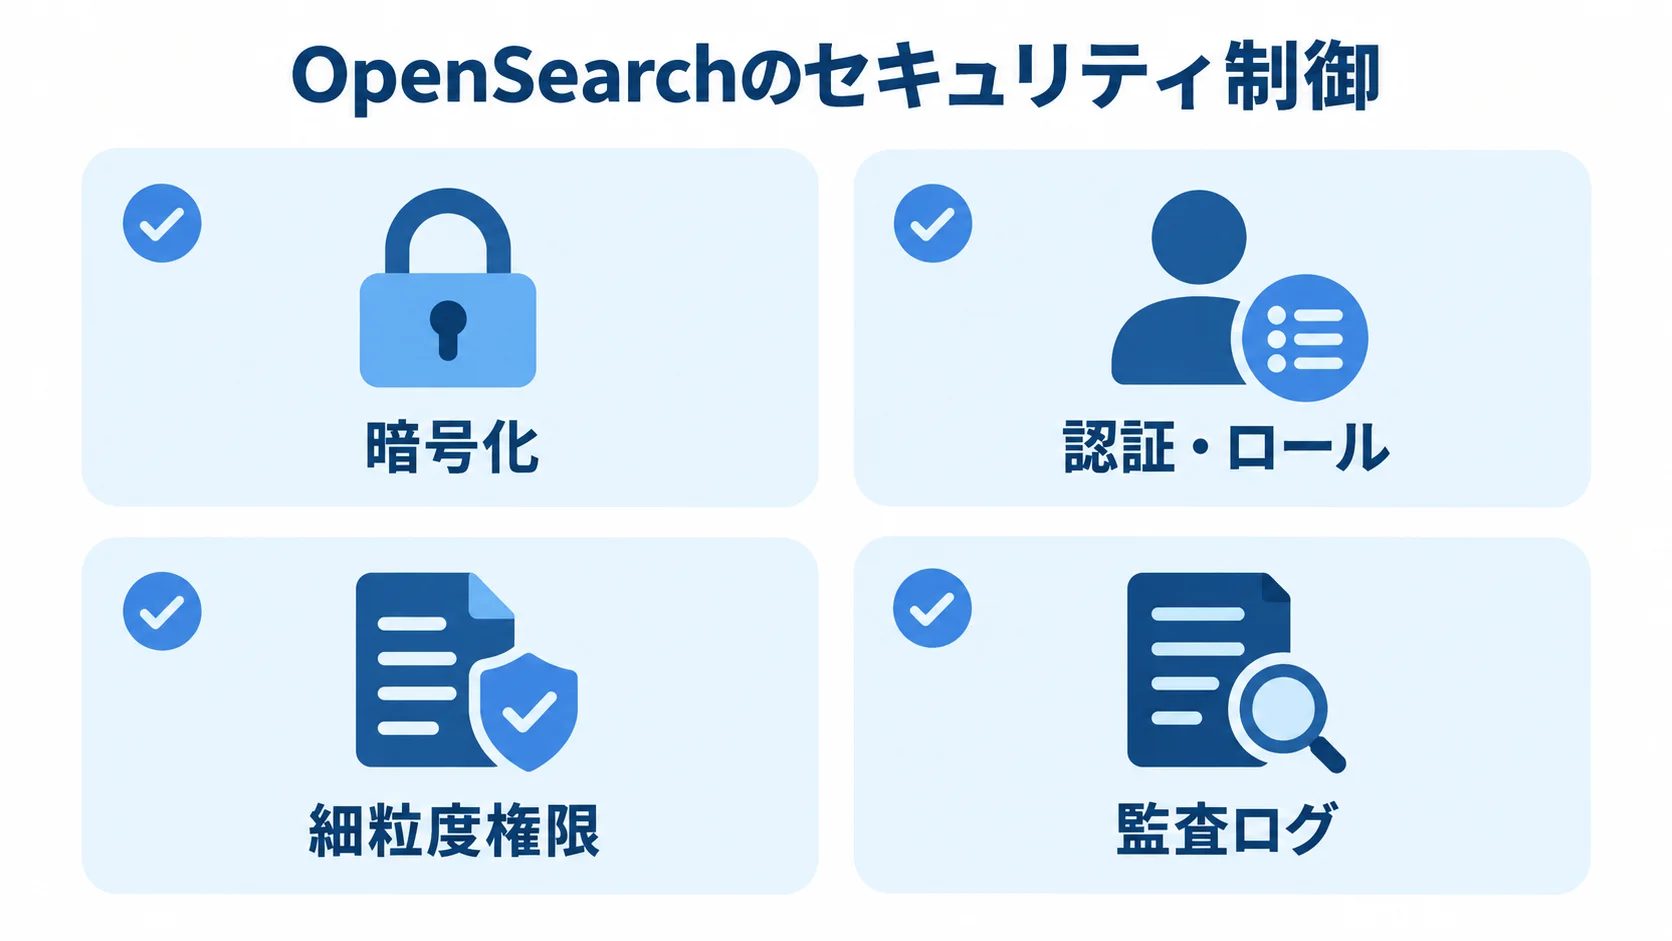
暗号化・認証・細粒度権限・監査ログの設計
セキュリティは、次の制御を分けて設計します。
- 暗号化:通信と保存データの保護
- 認証・ロール:利用者認証とロール別の権限設定
- 細粒度権限:OpenSearch Securityの機能の確認
- 監査ログ:対象イベントと記録方法の決定
OpenSearch Securityでは、クラスタからフィールドまでの単位で権限を設定できます。フィールドマスキングにも対応します(出典:OpenSearch公式セキュリティドキュメント、2026年)。
監査ログは、初期状態で無効になっている場合があります。そのため、対象イベント、保管先、保存期間を要件に含めます。改ざん防止や閲覧権限、ログに含まれる個人情報の扱いも、要件として定めます。
RAGでは、検索の前に権限をかけるか、取得後に除外するかを明確にします。生成AIに機密文書が渡らないことも、テストで確かめます。
監視・バックアップ・アップグレードの運用設計
運用手順が担当者の経験に頼りきりだと、夜間の障害や担当の異動時に復旧できなくなるおそれがあります。手順書や設定も含めて、次の運用項目を整えます。
- 監視:状態、JVMメモリ、CPU、ディスク、シャードの偏り、検索・書き込みの拒否、取り込み遅延、バックログ、アラート件数
- バックアップ:復元時間と復元後の整合性の定期的な試験
- アップグレード:プラグイン、クライアント、マッピング、スナップショットの互換性確認と、ロールバック手順・メンテナンス時間の用意
- 引き継ぎ資料:IaC、設定、ダッシュボード、アラート定義、手順書を納品物に含める
OpenSearchの開発会社・ベンダーの選び方
開発会社を見るときは、検索画面だけでなく、データ設計や取り込み、関連度チューニングへの対応も確認します。シャード設計や移行、監視、セキュリティへの対応も対象です。運用の引き継ぎまで含めて見ます。
得意な領域は会社ごとに異なり、マネージドサービスやクラウド構築、検索品質、AI検索などが例です。自社の課題をデータと運用を含むシステム要件として説明し、同じ条件で比べます。
類似用途と移行・運用の実績
導入社数や検索エンジンの利用年数だけでなく、事例の中身を見ます。自社に近いデータ量や取り込み頻度を扱った事例かを確認します。検索方式や保持期間、可用性の条件も、事例と照らし合わせます。
既存の基盤から移行する場合は、差分同期や切り戻し、停止時間について質問します。互換性の問題も、必ず尋ねておきます。
RAGでは、評価用クエリと正解データを使った検証を確認します。引用元の表示や権限付き検索、誤回答の抑制を、どのように検証したかも尋ねます。
見積もりの前提と納品物の比較
見積もりを頼む前に、対象データの種類と件数、日次の増加量を整理します。ピークRPSや検索画面数、連携先、権限を、前提としてそろえます。保管場所や保持期間、RTO・RPO、移行元、希望時期も伝えます。
提案書は、工程ごとに分けてもらいます。要件定義からPoC、設計、構築、データ連携、画面開発までを、段階ごとに示してもらいます。テストや移行、教育、保守は、別の項目として並べてもらいます。
納品物は、ソースコードだけでなく、IaCやマッピング、アナライザーまで明記してもらいます。ダッシュボードやテスト結果、監視設定に加え、復旧手順と運用引き継ぎ資料も含めます。
リリース後の支援体制と責任分界
契約後の支援と責任分界は、障害対応から契約終了時まで、次の点を確認します。
- 支援体制:問い合わせ窓口、監視時間、夜間・休日対応、障害時の初動、復旧目標、脆弱性・更新対応、検索精度の改善範囲。
- 責任分界:クラスタ障害は基盤側、取り込み遅延は連携側、検索の違和感は業務・検索調整の担当へ割り当てる
- 契約終了時:設定やデータを持ち出せるか、別環境へ移行できるかの確認
▶ 詳細はこちら:OpenSearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
▶ 詳細はこちら:OpenSearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
▶ 詳細はこちら:OpenSearchのシステム開発の発注/外注/依頼/委託方法について
OpenSearchのシステム開発でよくある質問
導入前に特に質問されやすいのは、費用、正本データとの関係、AI検索の使い分け、既存基盤からの移行の4点です。これらを確認しておくと、提案内容を比べやすくなります。
OpenSearchは無料で使えるため、開発費も無料ですか?
無料ではありません。ソフトウェアを無償で使えても、サーバーやクラウド、ストレージの費用がかかります。データ転送や監視、バックアップ、開発、保守の費用も、発生します。
PoCは100万〜300万円程度、本番連携は1,000万〜3,000万円程度が、推定の目安になります。金額は、データ量や検索数、権限によって大きく変わります。移行や可用性の条件も、影響します。
OpenSearchを業務データベースの代わりに使えますか?
基本は、検索・分析用の派生インデックスとして使うことです。正本をOpenSearchだけに置くと、更新の整合性、障害復旧、削除反映の設計が難しくなります。
業務データベースや基幹システムを正本にして、必要なデータをOpenSearchへ同期する構成が安全です。ただし、用途によっては、検索基盤として十分な役割を担えます。そのうえで、保存すべきデータと再構築できるデータを分けて定義します。
RAGではキーワード検索とベクトル検索のどちらを使うべきですか?
多くの業務では、キーワード検索とベクトル検索を組み合わせるハイブリッド検索を検討します。製品番号や契約番号、固有名詞にはキーワード検索が、言い換えや自然文の質問にはベクトル検索が向いています。
重み付けに決まった正解はありません。業務データや利用者の検索語、評価用クエリで品質を測ったうえで、権限フィルターや引用元表示も含めて採用するかを判断します。
既存の検索システムから移行する場合に最初に何を確認しますか?
まずは、移行元のバージョンやAPI、クライアント、プラグインを確認します。アナライザーやインデックス数、データ量も、確かめておきます。日次の増加量やピーク時の検索数、許容停止時間も、確認項目です。
全件再インデックス、差分同期、切り替え、切り戻しを、検証環境で試します。互換性があっても、検索順位やエラー処理が変わる可能性があります。そのため、業務担当者による検索結果の受け入れ確認も必要です。
まとめ:要件と運用から逆算するOpenSearchのシステム開発
OpenSearchのシステムは、業務検索やログ分析、セキュリティ分析に使えるほか、ベクトル検索やRAGまで広げられる柔軟な基盤です。
検索精度やP95応答時間、取り込み遅延を、要件として数値で決めます。保持期間や可用性、権限、監査、復旧も、数値や条件で示します。それらをPoCで確かめます。
開発費と基盤の月額費を分けたうえで、データ量と運用体制を含むTCOで判断すると、導入後に想定外のコストを抑えやすくなります。
導入前に確認したい要点
まず、OpenSearchを正本データベースにするか、検索・分析用の派生インデックスにするかを決めます。次に、Web検索、ログ、セキュリティ、RAGのうち優先する用途を定め、代表データで精度と性能を測ります。
その後、マネージドかセルフマネージドかを、運用人材やデータ所在地、カスタマイズ性、費用で比べます。ベンダーには、取り込みや設計、移行、監視、復旧、引き継ぎを含む提案を依頼します。
最初の一歩となる検索要件とデータ一覧の作成
大規模な本番環境をすぐに発注せず、まずは検索要件とデータ一覧を作ります。検索語や期待する結果、データ項目、更新・削除ルールを整理します。
月間データ量や保持期間、利用者の権限も、同じ一覧に書き込みます。これにより、必要な構成と見積もりの前提が見えてきます。
OpenSearchは機能の幅が広いため、目的と運用条件に合う範囲から段階的に始めると、使われ続けるシステムにつながります。
▼関連記事一覧
・OpenSearchのシステム開発の進め方/やり方/流れや方法/手法/工程/手順
・OpenSearchのシステム開発でおすすめの開発会社/ベンダー6選と選び方
・OpenSearchのシステム開発の見積相場や費用/コスト/値段について
・OpenSearchのシステム開発の発注/外注/依頼/委託方法について
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。