
OpenSearchのシステム開発は、要件整理、構成選定、設計・検証、運用改善の順に進めると、検索や分析を業務成果につなげられます。
開発は6つのフェーズに分けて進めます。費用は規模によって幅が大きく、見積もりでは前提をそろえて比べることが大切です。
▼全体ガイドの記事
・OpenSearchのシステム開発の完全ガイド
・業務システム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「業務システム開発の完全ガイドブック」で詳しく解説しています。
・スクラッチシステム開発を依頼する会社の選び方やRFPの作り方については、無料ホワイトペーパー「スクラッチシステム開発の完全ガイドブック」で詳しく解説しています。
OpenSearchのシステム開発の概要
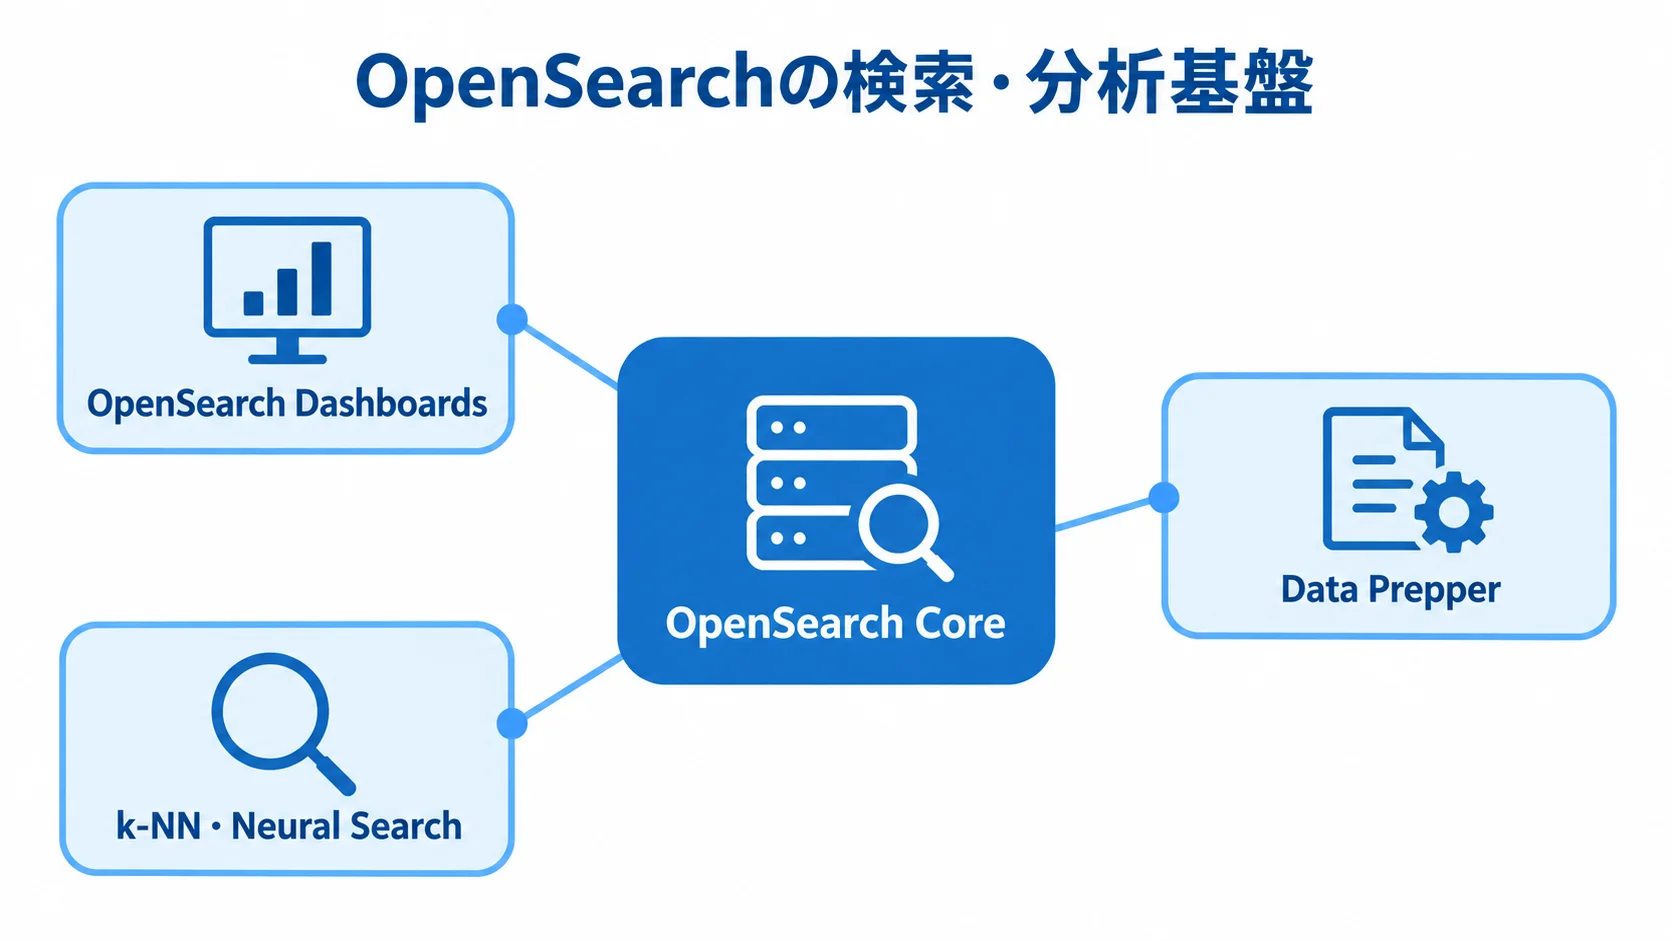
OpenSearchのシステム開発では、業務データやログを検索・分析しやすい形で蓄積し、業務アプリやダッシュボードから使える状態にします。OpenSearch Coreを基盤に、可視化にはOpenSearch Dashboards、取り込みや変換にはData Prepperを使います。さらに、k-NNやNeural Searchなどのプラグインも、目的に応じて組み合わせます。
検索・ログ分析・AI検索を一つの基盤で扱う構成
OpenSearchは、商品、文書、FAQ、社内ナレッジの全文検索に加え、アプリケーションログや監査ログの時系列分析にも使えます。文書をベクトル化すると、キーワード検索と意味検索を組み合わせたハイブリッド検索にも対応できます。
導入の目的は、問い合わせの自己解決率向上、障害調査の短縮、生成AIが使う文書の適切な取得といった業務成果に置きます。用途によって設計の重点は異なるため、用途ごとに次の要件を定めます。
- Web検索:同義語、表記揺れ、絞り込み、サジェスト、ランキング
- ログ分析:取り込み遅延、保持期間、アラート、ダッシュボード
- RAG:利用者の権限を検索結果に反映して、権限外文書の混入を防ぐ
正本データベースと検索用インデックスの分離
多くの業務システムでは、注文や顧客情報の正本を業務DBやSaaSに置き、OpenSearchを検索用の派生インデックスとして使います。
たとえば、Data Prepper、Fluent Bit、Logstashなどの取り込み層で同期すると、検索用マッピングの変更と業務データの整合性を分けて扱えます。
一方で、同期遅延、重複登録、更新・削除の反映漏れ、障害後の再構築が課題になります。そのため要件整理の段階で、許容遅延、再送方法、削除期限、全件再インデックスの所要時間、復旧時の業務影響を決めておきます。
OpenSearchのシステム開発の6フェーズの進め方
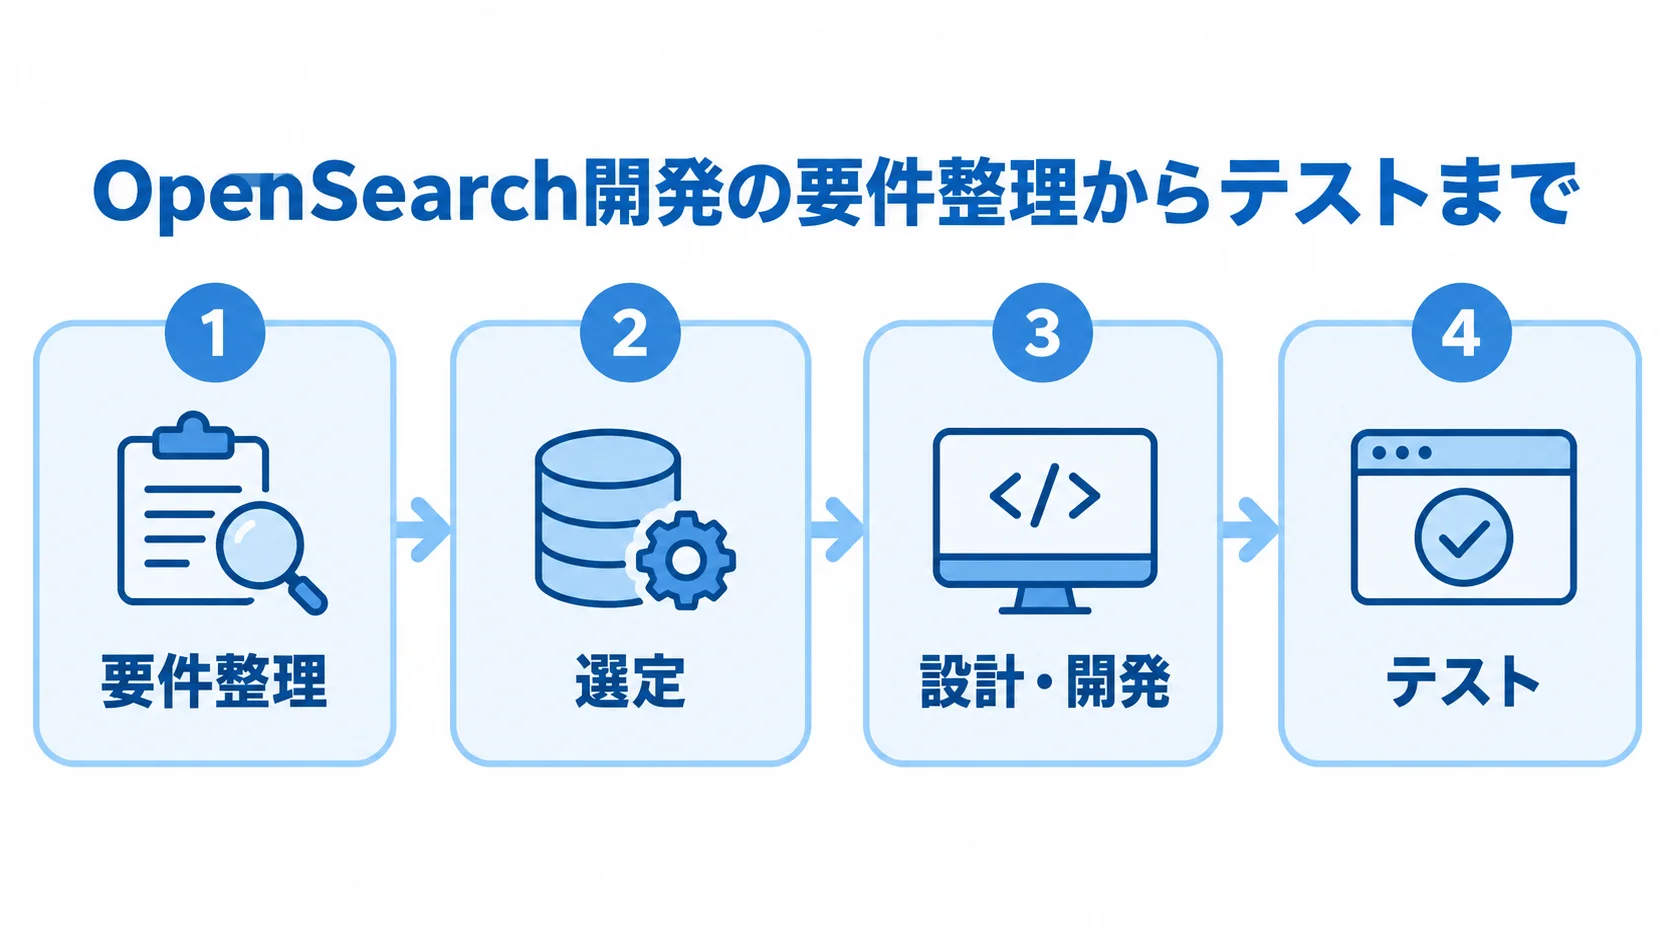
いきなりクラスタや画面を構築すると、後からデータモデルや権限を見直すことになりがちです。そのため、小規模なPoCでも本番運用を想定し、各段階で判断基準と成果物を決めます。
フェーズ1:要件整理による業務課題とKPIの決定
目的は、測定できるKPIに置き換えておきます。「高速に検索したい」のままでは測れないため、検索結果の上位10件に正解が含まれる割合、検索のP95応答時間、ログ取り込み遅延を数値で定義します。ログ調査時間、監査・脅威検知、RAG回答品質も、KPIの候補になります。
まず、データの種類、1日あたりの取り込み量、ピーク時の検索数を洗い出します。あわせて、次の条件も確かめます。
- 同時利用者数
- 更新・削除頻度
- 保持期間
- 個人情報の有無
OpenSearchの設定で直せないものとして、表記揺れ、欠損、重複、古いマスタがあります。そこで、発注者側のデータ整備範囲も合意しておきます。
要件定義書には、目的、対象業務、データ項目、KPI、非機能要件、対象外範囲をまとめます。次の要件も記載します。
- 継続性:可用性、RTO、RPO、バックアップ、復旧
- 統制:アクセス権、監査ログ、データ削除、データ所在地
- 運用:運用時間、バージョンアップ方針
フェーズ2:選定でのクラウド・マネージド・自社運用の比較
AWSを主要基盤として運用負担を下げたい場合は、Amazon OpenSearch Serviceが候補になります。マルチクラウドや請求の予測しやすさを重視する場合は、Aivenなども比較します。
プラグイン制約を避けたい場合や、独自ネットワーク・データ所在地の要件がある場合は、セルフマネージドも選択肢になります。社内にKubernetes運用の人材がいるかも、判断材料です。
Elasticsearchから移行する場合は、利用中のAPIやクライアント、プラグインを洗い出します。アナライザー、テンプレート、スナップショット形式も、一覧にしておきます。
各要素が対象バージョンで動くかは、実データで検証します。代表クエリと障害復旧も試し、互換性の説明だけで決めないことが大切です。
比較表には次の条件を含めます。PoCの速さだけで選ぶと、本番の監査や障害対応の段階で移行費用が発生することがあります。
- サービス条件:対応リージョン、SLA、認証方式、サポート時間
- 統制・保護:文書・フィールド権限、監査ログ、バックアップ
- 費用・移行:課金単位、データ転送費、解約時のデータ持ち出し
フェーズ3:設計・開発での検索品質と運用性の作り込み
設計では、入力元から検索画面までのデータの流れと、検索品質・クラスタ・セキュリティの要件を決めます。OpenSearchのデータは、業務アプリ、Dashboards、BI、AIアプリケーションから検索されます。
- データ連携:業務DBやSaaSから取り込み層を経てOpenSearchへ登録
- 登録処理:再送、重複排除、失敗レコード隔離、スロットリング、バックプレッシャー
- 検索設計:フィールド型、textとkeyword、形態素解析、同義語、表記揺れ、ランキング、フィルター
再送などの登録処理を用意して、一時停止や急増によってクラスタが不安定になるのを防ぎます。
日本語検索では、実際の検索語と正解文書で評価データを作ります。設定変更の前後で正解率とゼロ件率を比べ、設定値は評価結果とともに管理します。
クラスタ設計では、データノード、クラスターマネージャー、レプリカ、シャード、ストレージ、可用性ゾーン、インデックスのライフサイクルを決めます。
AWSの指針は、Javaヒープ1GiBあたり25シャード以下を初期目安とし、ワークロードに応じた調整を示しています(出典:AWS「Operational best practices for Amazon OpenSearch Service」)。
ただし、この値は万能ではないため、負荷試験を優先して確かめます。シャード数だけでなく、シャードサイズも重視し、実際のワークロードで調整します。
セキュリティでは、TLS、認証、RBACを中心に設計し、ほかに次の項目も決めます。
- 文書・フィールド単位の制御
- 監査ログ
- 暗号化
- 秘密情報の管理
ただし、Security機能は法令適合を保証するものではありません。また、個人情報の利用目的、委託先管理、保存期間、削除証跡、漏えい時の対応も、業務要件として定めます。
Security機能では、ユーザーやロールに応じて、見せてよい文書やフィールドを絞れます。
フェーズ4:テストでの性能・障害・権限の検証
画面が表示されるかだけでは、本番で必要な速さや復旧力、アクセス制御は確かめられません。そのため、検証は機能・性能・障害・権限の4つの面に分けて行います。
- 機能:登録、更新、削除、検索、絞り込み、同義語、権限、エラー時の再送
- 性能:本番相当のデータ・クエリでP50・P95、スループット、遅延、CPU、JVMヒープ、ディスクを測定
- 障害:ノード・取り込み元停止、ネットワーク遅延、容量不足、誤マッピング、バックアップ復元
- 権限:別部署文書、機密フィールド、監査ログへの不正アクセスを確認
障害試験では、復旧時間、読み取り専用への切り替え、未取り込みデータの再送も記録します。受け入れ基準は、要件定義のKPIに対応させます。
基準にはP95応答時間、評価データの正解率、削除依頼から検索結果に反映するまでの時間、RTO内の復旧などを設定します。また、テストデータ、日時、条件、結果、未解決の制約も納品物に残します。
フェーズ5:稼働での切り替えと監視
稼働前には、切り替え方式を決めておきます。主な選択肢は次のとおりです。
既存基盤から移行する場合は、ダウンタイム、再インデックス、クエリ互換性、ロールバック条件を文書に残しておきます。
- 並行稼働:新旧の検索結果を比べてから切り替える方式
- 全件投入・差分同期:全件投入の後に差分を同期して移す方法
- 段階展開:利用者を段階的に増やしていく進め方
本番では、検索エラー、P95レイテンシ、取り込み遅延、未処理件数、ディスク、JVMメモリを監視します。シャードの偏りやノード状態、バックアップ結果、監査ログの欠落も確認します。
AWSは、検索・インデックスのスローログ、エラーログ、監査ログをCloudWatch Logsへ発行し、アラームを設定するよう推奨しています(出典:AWS「Operational best practices for Amazon OpenSearch Service」)。
稼働の判定は、チェックシートで行います。チェックシートでは、監視通知先と夜間の一次対応、障害連絡を確かめます。加えて、バックアップ復元、バージョン更新の承認者、変更管理も同じシートで押さえます。未完了の項目がある場合は、暫定運用と期限を記録します。
フェーズ6:定着での検索品質と運用の改善
稼働後は、検索ログや運用状況を分析し、継続的に見直します。
- 検索改善:ゼロ件語や再検索語の分析に基づく、同義語・ランキング・マッピングの見直し
- 運用引き継ぎ:インデックス、再構築、権限、復元、障害連絡、コスト確認の手順の共有
- ログ運用:誤検知率や調査時間の確認、未使用ダッシュボードや保持価値の低いログの見直し
IaCや設定、クエリ、ダッシュボード定義は、リポジトリで管理します。テスト結果と既知の制約は文書に残し、特定の担当者だけが把握する状態を避けます。
定着を測るKPIには、検索利用率、自己解決率、検索経由のコンバージョンがあります。運用面では、ログ調査時間やアラート対応時間、取り込み失敗率を見ます。さらに、月額基盤費など、コストに関わる指標も候補になります。毎月または四半期ごとに見直し、改善の優先順位を決めます。
OpenSearchのシステム開発費用と相場
開発費は、画面数より、データ連携や検索精度の調整で大きく変わります。移行や非機能要件、運用体制も、費用を左右します。なお、国内のOpenSearch開発費について、公的な平均統計は確認できません。
ここでの金額は、業務システムの一般的な価格帯と、OpenSearch固有の構築・連携工数を合わせた推定です。正式な見積もりでは、データ量と性能要件を個別に分けて確認してください。
規模別の初期開発・導入費の幅
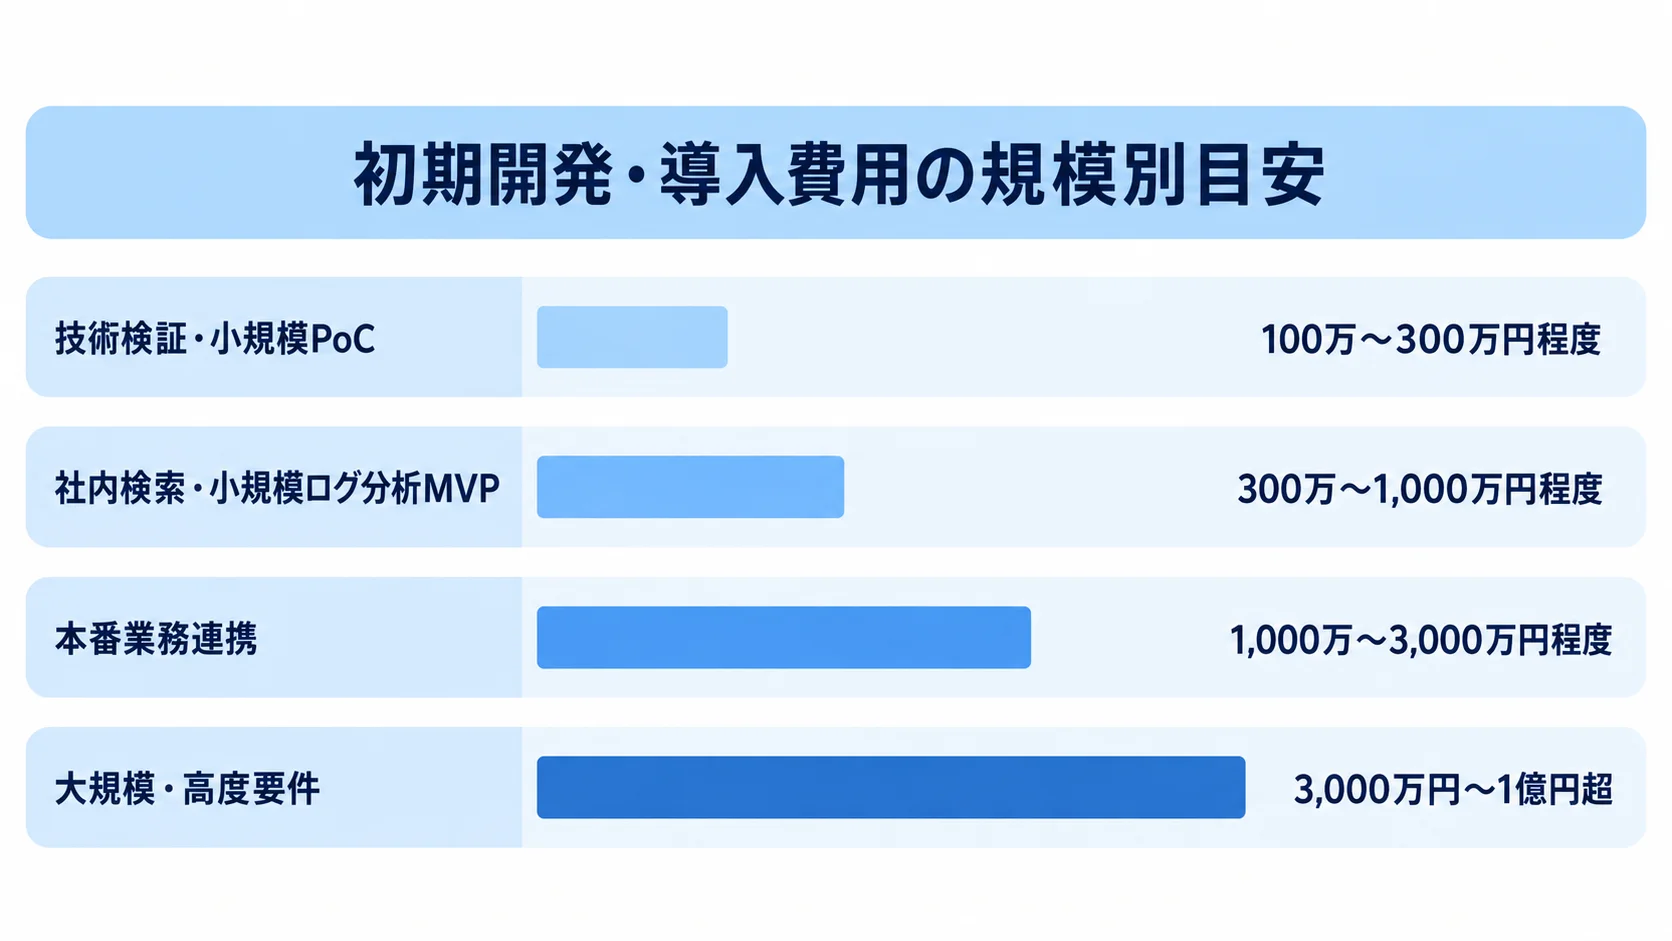
規模別の費用目安は、構成と作業範囲で変わります。以下の金額は市場統計ではなく、類似システムからの推定です。
- 技術検証・小規模PoC:代表データ、精度・性能確認、サービス比較を含み100万〜300万円程度
- 社内検索・小規模ログ分析MVP:取り込み、インデックス設計、基本権限、検索画面、監視を含み300万〜1,000万円程度
- 本番業務連携:複数DB・SaaS、高可用性、監査、削除連携、運用設計で1,000万〜3,000万円程度
- 大規模・高度要件:複数リージョン・数TB以上・細粒度権限・RAG・移行・厳格なRTO/RPO・24時間運用で3,000万円〜1億円超も
期間は、PoCが2〜6週間、MVPが1〜3か月、本番業務システム連携が3〜6か月、大規模移行やAI検索が6〜12か月以上です。
要件定義を省くと、後工程でのマッピングや権限のやり直しが重なり、費用と期間が膨らみます。
基盤の月額費用を、クラウド料金・保守・監視に分けた内訳
オープンソースのソフトウェアを使っても、システム全体の費用はかかります。月額費用は、次の内訳に分けて確認します。
- 基盤費:インスタンス、ストレージ、転送、スナップショット、監視、ログ保管
- 運用費:サポート、障害対応、更新、検索品質改善
- 利用方式:AWSのマネージドクラスターとServerlessでは課金単位が異なる
- 保管・プラン:ログの階層化や保持期間、サービスプランで費用が変わる
Serverlessは、コンピュートとストレージを分けて課金します(出典:AWS「Amazon OpenSearch Service Pricing」)。
AWSの料金例は、米国東部(バージニア北部)の構成です。データノード3台、クラスターマネージャー3台、UltraWarmノード2台、EBSなどを含み、月額1,604.83米ドルです。
1ドル=150円で単純換算すると、約24万円です。これは特定リージョンのインフラ料金で、為替や税は含みません。転送や監視、開発会社の保守費も、この金額には含まれていません。
別のMulti-AZ構成例は、月額8,772.84〜13,241.34米ドルです。可用性とデータ複製によって差が出ます。
ログや時系列データは、Hot、UltraWarm、Coldの階層化と保持期間によって、TCOが変わります。低頻度のデータを安価な層へ移し、ISMでロールオーバー、スナップショット、削除を自動化すれば、高性能ストレージを抑えられます。
Aivenの公開ページでは、Free、Developer(月40米ドル)、Startup(月90米ドルから)、Business(月275米ドルから)のプランが示されています。実額は、性能、可用性、データ量、サポート範囲で変わります。
開発費の10〜20%程度を目安にした保守費のたたき台
初期検討では、保守費を開発費の年間10〜20%程度として試算できます。これは一般的な業務システムの目安で、OpenSearch運用の市場統計ではありません。
月次の設定確認だけにするか、24時間365日の監視や障害の一次対応まで含めるかで、費用は変わります。検索精度の改善や再構築、セキュリティパッチ、バージョンアップも、含めるかで差が出ます。保守範囲は、対象、作業、契約条件に分けて確認します。
- 対象:クラウド基盤、クラスタ、取り込みパイプライン、検索アプリ、Dashboards、AI連携
- 作業:稼働監視に検索結果の調査や同義語追加が含まれるか
- 契約条件:対応時間、月間作業時間、緊急対応、訪問、SLA、更新費
OpenSearchのシステム開発で見積もりを取る際のポイント
画面数や開発人数だけで比べると、判断を誤ることがあります。まず、データ量と取り込み方式、検索品質の前提をそろえます。そのうえで、非機能要件、移行、運用引き継ぎも同じ条件にし、含まれる作業と別費用の作業を確認します。
データ量・性能・保持期間の数値による提示
依頼書には、データ量や性能条件を具体的な数字で記載します。
- データ量:初期量、1日あたりの増加量、1件あたりの平均サイズ、更新・削除件数
- 利用負荷:1時間あたりのピーク取り込み量、ピーク検索数、同時利用者数
- 性能・継続性:保持期間、P95・P99、検索応答、取り込み遅延、再インデックス、復旧、RTO・RPO、可用性、バックアップ世代数
未確定なら、最小・標準・最大の3パターンを提示します。本番の1%しかないサンプルではシャード数や容量を過小評価するため、データの代表性も説明します。
性能は平均値ではなくP95やP99で示します。これにより、検索は速くても取り込みが遅い場合や、平常時は速くてもピーク時に失敗する場合を見分けられます。数値をそろえておけば、各社の構成と金額を同じ土台で比べられます。
納品物と運用引き継ぎの見積もり項目
提案書を見るときは、次の納品物が見積もりに含まれているかを確かめます。
- 設計資料:要件定義書、構成図、データマッピング、アナライザー・同義語設定
- 実装資産:インデックステンプレート、IaC、取り込み設定、検索クエリ、ダッシュボード
- 運用資料:監視アラーム、テスト結果、復旧・運用手順、教育資料
画面上の変更だけで、再現できるコードや変更履歴が残らない提案には注意が必要です。
納品後に、インデックス追加やマッピング変更を誰が担うかも確認します。検索品質の評価や障害の切り分けも、担当を決めておきます。
引き継ぎの回数や操作演習、問い合わせ先が明確であれば、初期費用だけでなく総保有コストで比べられます。サポート時間と初年度保守も、あわせて確認します。
発注先の検索技術と業務運用の両面での評価
検索基盤と業務運用を支える実績・設計力を、次の観点で確認します。
- 経験:OpenSearchのバージョン・プラグイン、クラウド・Kubernetes運用、Elasticsearch移行、検索品質評価
- 基盤運用:シャード設計、マッピング、同義語、再送、削除連携、復旧試験を説明できるか
- セキュリティ:TLS、RBAC、文書・フィールド制御、監査ログ、暗号化、秘密情報、ログ保存、削除証跡
検索基盤の長期運用力は、画面制作の実績とは別に確認する必要があります。
OpenSearchの公式監査ログは、アクセスやセキュリティイベントを追跡できます。ただし、デフォルトでは無効になっています。
見積もりには、監査ログの要件を明記し、設定、保管先、閲覧権限も書き添えておきます(出典:OpenSearch公式ドキュメント「Audit logs」)。
事例の数字は、自社の目標としてではなく、設計論点を探す材料として見ます。OpenSearch公式のAtlassian事例は、300超のクラスタと2,000超のノードを示しています。文書数は200億超、可用性は99.99%です。
大規模事例をそのまま再現せず、自社の可用性やデータ量に合わせ、検索数や運用体制も含めて見積もります。
OpenSearchのシステム開発でよくある質問
導入可否は、ライセンス以外の要素も含めて判断します。データの機密性と運用人材を踏まえ、検索品質、可用性、将来の拡張性も合わせて見ます。
OpenSearchは無料で利用できますか?
ソフトウェア自体はApache License 2.0のオープンソースです。一方で、システムを運用するには費用がかかります。
サーバーやストレージ、転送の費用がかかるほか、監視やバックアップ、保守も必要です。セキュリティ対応と開発人件費も、見込んでおく必要があります。
セルフマネージドでは基盤運用の負担が増えます。一方、マネージドサービスでは、料金とサポート範囲を確認します。
ElasticsearchからOpenSearchへ移行できますか?
移行の可能性はありますが、互換性を前提にはできません。まず、利用中のバージョンやクライアント、プラグインを洗い出します。アナライザー、テンプレート、スナップショット、クエリも、対象に含めます。
代表データで再インデックスと検索結果を検証し、停止時間、差分同期、ロールバック、移行後の性能・費用をPoCで確認してから本番計画を決めます。
OpenSearchで社内文書のRAGを構築できますか?
構築できます。文書を分割して埋め込みベクトルを作り、キーワード検索とベクトル検索で関連文書を取得して生成AIへ渡します。
最優先の設計は、公開範囲や所属を検索結果に反映し、削除済み文書や権限変更前の情報を回答に使わせないことです。
回答の正確さに加え、根拠文書の提示、監査ログ、再現性も受け入れ基準に含めます。
開発会社へ依頼するのはどの段階がよいですか?
目的と対象データが見えた段階で、早めに相談できます。要件が固まっていなくても、短期のアセスメントやPoCを使えば、データ量と検索品質を確かめられます。性能やクラウド構成、移行難易度も、同じ場で確認できます。
提案書には、特定の製品を先に決めず、複数の案と、PoC後に本番へ進む条件を明記してもらうとよいです。
OpenSearchのシステム開発の成功の鍵は、段階検証と運用設計
6つのフェーズは、要件整理から始まります。選定、設計・開発を経て、テストへ進みます。その後は、稼働と定着まで続きます。業務KPIとデータの正本を決め、PoCで検索品質、性能、取り込み遅延、権限を検証します。
本番では、監視、復旧、削除、バージョンアップまで含めて運用します。
発注前に確認するチェック項目
発注前には、目的とKPI、データ量と増加量、ピーク検索数、保持期間を確かめます。あわせて押さえておく項目は、検索品質の評価方法と取り込み・削除連携です。
クラスタ構成と可用性、RTO・RPOに加えて、権限や監査ログ、バックアップも確認します。移行方法、テスト条件、納品物、保守範囲も、見積もりの前提に含めます。金額だけでなく、前提条件をそろえて比べます。
公式事例に大規模クラスタやAI検索の実績があっても、自社が同じ規模を必要とするとは限りません。必要な性能と可用性を測ったうえで、データ保持の階層化やマネージドサービスも含めて、無理のない構成を検討します。
代表データを使ったPoCからの開始
大規模な本番基盤をすぐ作らず、代表データと実際の検索語を使うPoCから始めると、自社業務への適合を判断できます。PoCでは、本番移行を判断するための材料をそろえます。
- 検証結果:性能測定、検索品質評価
- 計画材料:構成候補、月額基盤費の試算、移行・運用上の課題
- 移行条件:本番移行の条件
成果を左右するのは技術選定だけでなく、業務課題とデータを定義し、運用できる仕組みとして定着させることです。
社内だけで要件整理が難しい場合は、検索基盤、データ連携、セキュリティ、業務運用を横断して相談できる開発会社へ、具体的なデータ量とKPIを添えて相談します。
▼全体ガイドの記事
・OpenSearchのシステム開発の完全ガイド
▼RFP作成前に読みたい無料ホワイトペーパー
・業務システム開発の完全ガイドブック
・スクラッチシステム開発の完全ガイドブック
・【2026年最新版】AI駆動開発の完全ガイドブック
会社紹介
株式会社riplaでは、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを、構想策定・要件定義から開発・改善まで一気通貫で支援。事業会社でIT・DXを経験したプロフェッショナルによる高い要件定義力・システム設計力を活かし、事業成果の最大化に伴走します。

また、当社独自の開発テンプレート「Boxシリーズ」による標準機能の高速開発と、AI駆動開発の独自フレームワーク「GoDD」による独自機能のAI実装を組み合わせることで、低コスト・短期間で開発を実現いたします。

もし、システム開発やプロダクト開発に関するご要望がございましたら、お気軽にお問い合わせください。
・サービス概要資料のURLはこちら >>>
・お問合せページのURLはこちら >>>
・お役立ち資料のURLはこちら >>>


株式会社ripla 代表取締役CEOとして、システムパッケージ活用、システム開発、データ分析、生成AI活用、SaaS開発、アプリ開発、EC構築など、幅広い領域で企業のDX推進と事業成長を支援している。事業会社でIT・DXを経験したプロフェッショナルが集う株式会社riplaにおいて、お客様の事業・ユーザー・業務に最適化したオーダーメイド型システムを構想策定・要件定義から開発・改善まで一気通貫で支援し、単なるシステム納品にとどまらず、クライアントと同じ目線で事業成果の最大化に向けた伴走支援を行う。早稲田大学卒業後、ラクスル株式会社、LINEヤフー株式会社にて事業開発やDX推進などに従事した後、株式会社riplaを創業。